Пять этапов, четыре артефакта: что Telli.sh на самом деле делает с записью встречи
Подробный разбор всего конвейера Telli.sh: живая запись или загрузка аудио, ИИ-транскрибация встреч с определением говорящих, перевод встреч в реальном времени на 44 целевых языка, ИИ-резюме в 10 форматах и заметка, которой можно поделиться. С честными ограничениями, точными ценами и разбором того, чего на самом деле требует точность транскрибации.
Восемь человек стоят в комнате. Один объясняет, почему миграция сдвинулась. Двое слушают вполуха. Кто-то сзади произносит фразу, которая станет важной через три недели, и никто её не записывает.
Это сырьё. Этот текст — о том, что наша система с ним делает, этап за этапом: от момента, когда аудио начинает течь, до момента, когда вы вставляете ссылку в канал.
Это обзор продукта от команды, которая создаёт Telli.sh. В нём прослеживается путь аудио от записи или загрузки через расшифровку, перевод и доработку к заметке, которой можно поделиться; по ходу указаны модели, ограничения и цены.
Коротко:
- Запись проходит пять этапов обработки и оставляет четыре отдельно сохранённых артефакта: сырую расшифровку, карту говорящих, очищенный сценарий и по одному резюме на каждый применённый формат.
- Определение говорящих работает на
pyannote/speaker-diarization-community-1— по фрагментам, с переносом голосовых эмбеддингов вперёд, чтобы один и тот же человек сохранял одну и ту же метку с пятой минуты по пятидесятую.- Перевод принимает 44 языковых кода; сам интерфейс существует на 15 языках; резюме доступны в 10 встроенных форматах плюс любые пользовательские, задаваемые названием, инструкцией и списком разделов.
- Смотрите текущие тарифы: месячная и годовая оплата, минуты и функции планов. Они могут меняться; валюту, налоги и условия проверяйте при оплате. Статья не является расчётом счёта.
Изображение: Klean Denmark, «Daily sprint meeting», Wikimedia Commons, CC BY-SA 2.0. Ровно та разновидность встреч, ради которой весь этот конвейер и существует.
Аудио входит двумя путями, и это не одно и то же
Точек входа ровно две, и различие между ними определяет всё, что происходит дальше.
Первая — живая запись. Браузер открывает AudioContext с жёстко заданной частотой дискретизации 16 000 Гц, загружает AudioWorklet и буферизует вход микрофона блоками по 4096 отсчётов: на 16 кГц это один пакет каждые 256 миллисекунд. Каждый блок переводится из 32-битного float в 16-битный целочисленный PCM и уходит по WebSocket на /ws/audio/{sessionId}. Второй сокет, /ws/session/{id}, несёт канал управления: смену языка, обновление контекста, команду SUMMARIZE и команду FINISH, которая закрывает сессию и записывает заметку.
Вторая — загрузка файла. Вы кладёте запись в окно загрузки, она уходит потоком в POST /upload, а ответ приходит построчным JSON — потоком, а не крутящимся индикатором, — чтобы интерфейс показывал реальный прогресс по названным шагам, а не выдуманный процент. Жёсткие ограничения стоит назвать честно: 500 МБ на файл, и селектор принимает только audio/*. Если встреча заперта внутри MP4-записи экрана, аудиодорожку придётся извлечь заранее. Сегодня мы этого за вас не делаем.
Оба пути сходятся в один ствол обработки. С первого этапа живая запись и загруженный файл обрабатываются одинаково.
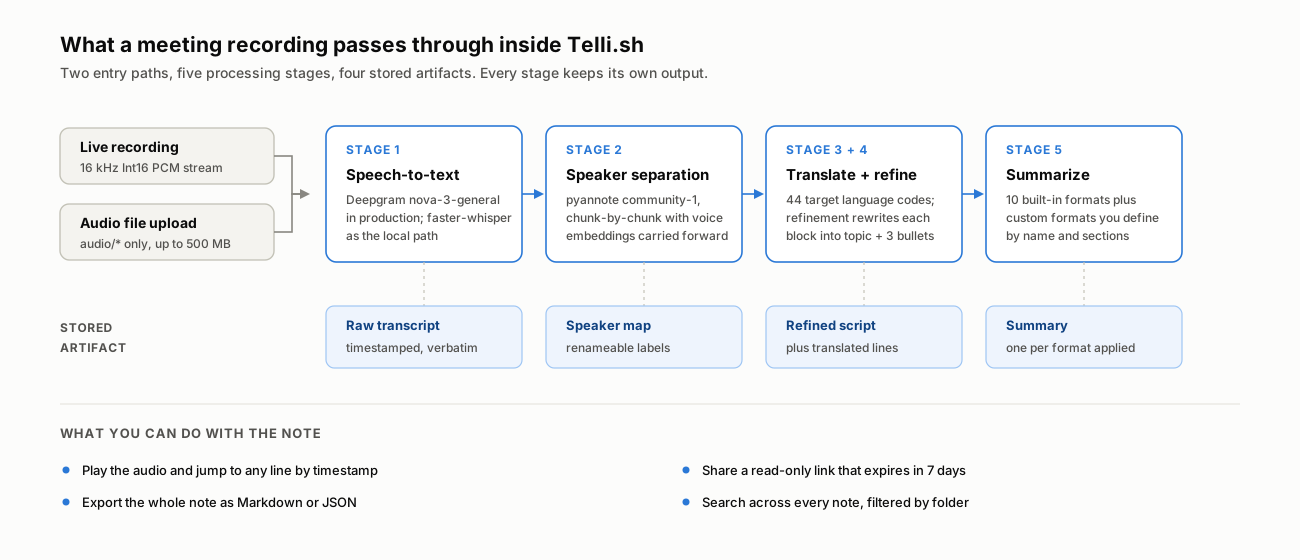
Каждый этап сохраняет собственный вывод. Следующий этап ничего не перезаписывает.
Этапы 1 и 2: услышать слова, а потом выяснить, чьи они
Первым работает распознавание речи. В продакшене и пакетный, и потоковый путь используют модель Deepgram nova-3-general; в кодовой базе есть также полностью локальный путь на faster-whisper для self-hosted развёртываний, включаемый одной настройкой провайдера. Этот выбор значит меньше, чем принято думать, и причину мы разбирали подробно: лучшие речевые модели в независимых рейтингах сегодня укладываются примерно в 1,5 процентных пункта по частоте словесных ошибок. Движок больше не то место, где живёт разница в качестве.
Она живёт в определении говорящих.
Диаризация работает на pyannote/speaker-diarization-community-1. Деталь реализации, которая действительно важна, — как система обходится с длинными записями. Вместо того чтобы диаризовать файл целиком за один проход, конвейер обрабатывает аудио фрагментами и назначает говорящих сразу после каждого фрагмента, но при этом ведёт накопительный словарь голосовых эмбеддингов по каждому говорящему и переопределяет их относительно этого накопленного набора на каждом следующем фрагменте. Именно этот механизм не даёт случиться классическому сбою, когда в двухчасовой записи один и тот же человек тихо превращается из SPEAKER_00 в SPEAKER_03, а потом в SPEAKER_07.
Если сегмент перекрывает две реплики, метка достаётся той, с которой перекрытие больше, а при малом перекрытии решающим становится сходство эмбеддингов.
Метки приходят обобщёнными — SPEAKER_00, SPEAKER_01 — потому что модель не может знать, что SPEAKER_01 — это ваш директор по инженерии. Вы переименовываете их один раз в заметке, сопоставление сохраняется вместе с ней и затем применяется везде, включая экспорт и ссылки для доступа. Вот честное разделение труда: машина разделяет голоса, имена даёте вы.
Что на самом деле остаётся после каждого этапа
Правило проектирования, которого мы держимся: ни один этап не уничтожает вывод предыдущего. Вы всегда должны иметь возможность вернуться к тому, что было сказано на самом деле.
Четыре группы: транскрипт, карта говорящих, обработанный текст и сводка. Переведённые строки прикреплены к транскрипту; пятая строка не является пятым независимым результатом.
| Артефакт | Кем создаётся | Что содержит | Для чего нужен |
|---|---|---|---|
| Сырая расшифровка | Этапы 1 + 2 | Дословные строки с отметками времени и меткой говорящего в каждой | Проверить, что было сказано буквально; кликнуть по строке и перейти к аудио |
| Карта говорящих | Этап 2 (+ ваши правки) | Соответствие меток именам в этой заметке | Делает читаемыми все остальные представления — работает в заметке, экспорте и по ссылке |
| Очищенный сценарий | Этап 4 | Каждый блок переписан в жирную строку темы плюс до 3 пунктов | Просмотреть длинную встречу, не читая её |
| Переведённые строки | Этап 3 | Перевод рядом с каждой исходной строкой | Прочитать встречу, которая шла на неродном для вас рабочем языке |
| Резюме | Этап 5 | По одному структурированному документу на каждый применённый формат | То, что вы действительно отправляете людям |
В интерфейсе заметки это выглядит как три вида вкладок: История (сырая расшифровка), Сценарий (очищенная версия) и по вкладке на каждый сгенерированный формат резюме. Если аудио записи сохранено, сверху появляется плеер, и клик по любой строке расшифровки перематывает аудио на эту отметку времени.
Этап 3: в переводе значимое число — 44
Перевод встреч в реальном времени привёл к нам большинство ранних пользователей, и его границы стоит обозначить точно: «поддержка более 100 языков» — самое непроверяемое утверждение в этой категории.
Здесь работают два разных числа, и это не одно и то же число:
- Для перевода принимаются 44 кода целевых языков. Это множество явно перечислено в конфигурации бэкенда и включает
zh-TWотдельно отzh— что важнее, чем кажется, если вы работаете и с Тайванем, и с материковым Китаем. - 15 языков поддерживаются для самого интерфейса и для языка, на котором ИИ пишет ваше резюме: английский, корейский, японский, китайский, немецкий, французский, испанский, итальянский, португальский, русский, польский, вьетнамский, тайский, индонезийский и малайский.
В живой сессии перевод идёт инкрементально, а не пакетом в конце. По мере того как в расшифровку приходят границы предложений, перевод соответствующего фрагмента втекает рядом с оригиналом, а посессионный кэш не даёт переводить заново неизменившийся текст. При загрузке файла строки, наоборот, группируются в пакеты: когда никто не смотрит на экран, пропускная способность важнее задержки.
Есть и отдельный режим рабочего процесса «перевод», отличный от режима заметки, — для случаев, когда результатом является сам перевод: двуязычный разговор, за которым нужно следить вживую, а не встреча, из которой нужен протокол.
Этап 4: этап, которого никто не просит и который нужен всем
Здесь описание переходит в мнение, и смягчать его мы не будем: очистка — самый недооценённый этап этого конвейера.
Дословная расшифровка человеческой речи почти нечитаема. Люди начинают фразу заново, обрывают её, четыре раза говорят «да-да, точно» и хоронят одно решение внутри девяноста секунд покашливания. Пословно точная расшифровка этого — всё те же девяносто секунд покашливания.
Поэтому этап очистки берёт каждый блок разговора и переписывает его в жёстких рамках, заданных в шаблоне промпта, а не в коде, — чтобы их можно было подкручивать без деплоя. Каждый блок превращается в жирную строку темы, выведенную из содержания, — не из названия роли, без квадратных скобок, — за которой идут максимум три пункта, с ориентиром около 300 символов на блок. Имена говорящих и отметки времени убираются явно: они уже есть в сырой расшифровке, а их повторение лишь делает представление для беглого просмотра менее пригодным для беглого просмотра.
Одно ограничение в этом шаблоне заслуживает отдельного упоминания: модели предписано попадать в регистр услышанного и, в частности, не натягивать деловой тон совещания на непринуждённый разговор. Разговор в коридоре, отсуммированный как протокол совета директоров, — артефакт хуже, чем отсутствие резюме.
Результат мы называем сценарием: версия, которую можно прочесть одним взглядом, в одной вкладке от версии, которую можно цитировать в споре.
Этап 5: десять форматов резюме, потому что «резюме» — не одна вещь
Последний этап производит документ, который вы действительно отправляете. Попросить у LLM «резюме» — значит получить резюме ни о чём конкретном, поэтому формат здесь полноценный выбор, а не скрытое значение по умолчанию.
Встроенных форматов десять: ИИ-резюме (общее), Протокол встречи, Сводный отчёт, Конспект лекции, Проповедь / Выступление, Запись консультации, Итог звонка, Интервью, Заметки по идеям и Черновик презентации. У каждого своя структура разделов: протокол даёт обзор, обсуждаемые вопросы, решения и следующие шаги; черновик презентации даёт план, порядок слайдов, ключевые сообщения, заметки докладчика и следующие действия. Сами заголовки разделов локализованы по языкам, а не переводятся в момент генерации, — поэтому резюме на японском читается как японский документ, а не как переведённый английский.
Если ни один из десяти не подходит, вы задаёте собственный формат: название, набор инструкций и нужный список разделов, сохранённые и переиспользуемые. «Еженедельное обновление для совета директоров с рисками и открытыми решениями» — формат, который пишется один раз.
Любой формат можно применить к заметке задним числом, и каждый создаёт собственную вкладку. Отсуммировать одну и ту же запись тремя способами для трёх аудиторий здесь — нормальный сценарий, а не обходной путь.
Точность транскрибации — это стек, а не число
Частота ошибок слов — лишь одна из составляющих оценки расшифровки встречи. В статье Точности STT недостаточно мы объясняем, почему пропуск одного «не» может перевернуть решение, почти не повлияв на общий показатель.
Практическая версия: точность транскрибации, которая переживает контакт с настоящей встречей, состоит из пяти слоёв, и акустическая модель — только нижний из них.
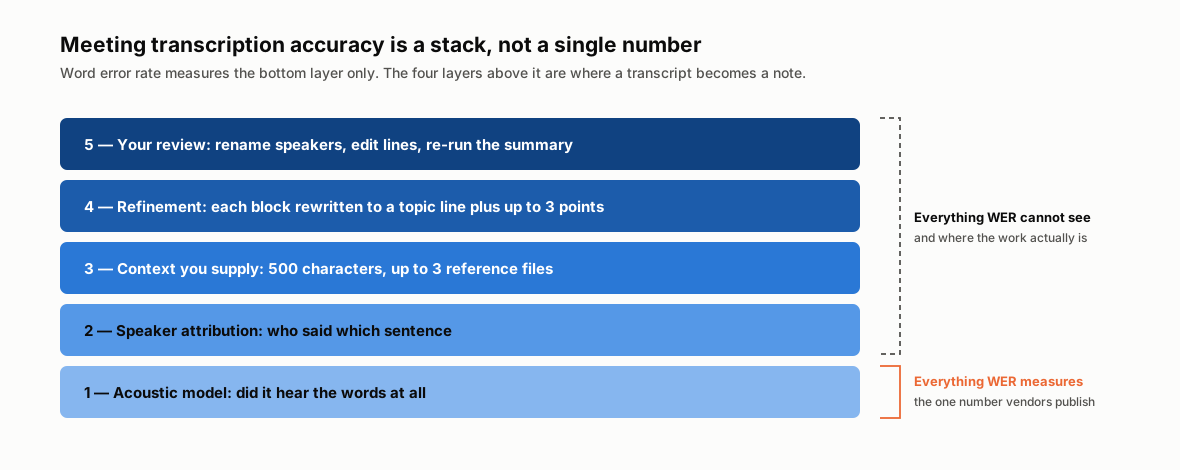
Частота словесных ошибок измеряет слой 1. Пригодность расшифровки решают слои со 2-го по 5-й.
Слой 3 — тот, которым пользователь управляет напрямую и который большинство пропускает. Перед записью или загрузкой можно задать блок контекста до 500 символов — тему, имена участников, коды продуктов, аббревиатуры — и приложить до 3 справочных файлов (PDF, изображение или текст), текст которых извлекается в браузере и сворачивается в тот же лимит. Этот контекст передаётся на этапы с ИИ.
Имена собственные одновременно очень информативны и редко встречаются в общих обучающих данных: это внутренние названия проектов, необычные фамилии и артикулы продуктов. Контекст вроде «Kestrel — продукт» и «Рави — человек» помогает системе их распознавать. Перед записью заполните поле контекста именами и терминами, которые система может не знать.
От нуля до заметки, которой можно поделиться, за одиннадцать шагов
Конкретно, от первого запуска до артефакта, которым можно поделиться:
- Зарегистрируйтесь. Смотрите текущие тарифы: месячная и годовая оплата, минуты и функции планов. Они могут меняться; валюту, налоги и условия проверяйте при оплате. Статья не является расчётом счёта.
- Выберите путь: начните живую запись или откройте окно загрузки и положите туда аудиофайл (
audio/*, меньше 500 МБ). - Задайте языковую пару. Источник можно оставить на автоопределении; целевой язык решает, на каком языке выйдут перевод и резюме.
- Заполните поле контекста — тема, имена, аббревиатуры, до 500 символов. Приложите до 3 справочных файлов, если есть презентация или повестка.
- Выберите папку, если заметку нужно положить в конкретное место. Переместить можно и потом.
- Записывайте или дождитесь потока загрузки. В живой сессии расшифровка появляется по мере того, как люди говорят, а перевод втекает рядом, если задан целевой язык. Во время загрузки вы увидите названные шаги: распознавание речи, анализ, очистка, резюме, завершение.
- Завершите сессию. Это запускает управляющее сообщение
FINISH, которое сбрасывает последний фрагмент, дожидается незавершённой очистки, сохраняет аудио, генерирует резюме и записывает заметку. - Переименуйте говорящих. SPEAKER_00 один раз становится именем, и сопоставление расходится по всем представлениям и всем экспортам.
- Прочитайте вкладку Сценарий, чтобы понять, о чём была встреча; спуститесь в Историю и кликните по строке, чтобы услышать аудио ровно в этот момент, если что-то выглядит неверно.
- Сгенерируйте дополнительные форматы резюме, если одной аудитории нужен протокол, а другой — сводный отчёт.
- Поделитесь или экспортируйте. Ссылка доступна только для чтения, истекает через 7 дней и может нести необязательный пароль. Экспорт даёт Markdown или JSON — с резюме, очищенными блоками и полной расшифровкой в одном файле.
Загрузить запись, которая у вас уже есть
Простые и прозрачные цены
Смотрите текущие тарифы: месячная и годовая оплата, минуты и функции планов. Они могут меняться; валюту, налоги и условия проверяйте при оплате. Статья не является расчётом счёта.
Текущая лицензия разрешает личное некоммерческое использование. Прочитайте условия, документы о безопасности и приватности. До загрузки чувствительных данных уточните хранение и обучение ИИ у [email protected].
Чего Telli.sh не делает
Продуктовый текст, который перечисляет только возможности, — это реклама. Вот вторая колонка.
Не принимает видеофайлы. Загрузчик принимает audio/*. Сначала извлеките аудиодорожку.
Не подключается к вашим звонкам. Нет бота, который набирает Zoom, Meet или Teams и сидит в списке участников. Вы записываете комнату, или звук со своего устройства, или загружаете файл после.
Не чинит плохое аудио. Один всенаправленный микрофон ноутбука в торце стола на двенадцать человек, в комнате с твёрдыми стенами — и диаризация просядет, чья бы модель ни работала: перекрывающаяся речь и удалённые говорящие — то место, где атрибуция ломается первой. Телефон посередине стола выигрывает у ноутбука в торце каждый раз и не стоит ничего.
Не знает вашей лексики, пока вы её не назовёте. См. слой 3 выше. Необычные имена собственные — самый частый источник ошибок, а поле контекста — средство от них.
Метки говорящих начинаются обобщёнными. Ни одна система не угадает, что SPEAKER_01 — это Прия. Переименовать нужно один раз на заметку.
Ссылки для доступа ограничены по времени. Семь дней, потом ссылка умирает. Это осознанное значение по умолчанию для содержимого встреч, а не забытая функция — но означает и то, что такая ссылка не архив. Если нужна долговечность, экспортируйте Markdown.
Итог
Telli.sh — это больше, чем продукт для транскрибации. Транскрибация — первый из пяти этапов, за которым следуют атрибуция говорящих, доработка, перевод и резюме.
На самом деле мы строим расстояние между записью и решением: знать, кто говорил; сжать девяносто секунд покашливания до одной фразы внутри них; передать эту фразу на языке, на котором работает читатель; и положить её туда, где коллега сможет её открыть. Запись — это свидетельство. Заметка — то, что меняет происходящее на следующей неделе.
Если у вас есть запись встречи, попробуйте этот процесс со своим аудио и сравните полученную заметку с расшифровкой.
Начать живую сессию с переводом
Источники
- Точности STT недостаточно — блог Telli.sh, 4 августа 2026 — полный разбор аргумента о частоте словесных ошибок, включая разброс в рейтинге
- pyannote/speaker-diarization-community-1 — Hugging Face — модель диаризации, используемая в этом конвейере
- Документация модели Deepgram Nova-3 — модель распознавания речи, используемая в продакшене
- Тарифы Telli.sh — текущие квоты и цены
- Страница изображения на Wikimedia Commons — заглавное фото, Klean Denmark, CC BY-SA 2.0
