Cinco etapas, quatro artefatos: o que o Telli.sh realmente faz com a gravação de uma reunião
Um passeio pelo pipeline completo do Telli.sh: gravação ao vivo ou upload de áudio, transcrição de reuniões com IA e identificação de quem falou, tradução de reuniões em tempo real para 44 idiomas de destino, resumos por IA em 10 formatos e uma nota compartilhável. Com os limites honestos, os preços exatos e o que a precisão de transcrição realmente exige.
Oito pessoas de pé numa sala. Uma explica por que a migração atrasou. Duas escutam pela metade. Alguém no fundo diz a frase que vai importar daqui a três semanas, e ninguém anota.
Essa é a matéria-prima. Este texto trata do que o nosso sistema faz com ela, etapa por etapa, desde o instante em que o áudio começa a fluir até o momento em que você cola um link num canal.
Este é um percurso pelo produto, feito pela equipe que desenvolve o Telli.sh. Ele acompanha o áudio da gravação ou do upload até a transcrição, a tradução, o refinamento e uma nota compartilhável, identificando os modelos, limites e preços ao longo do caminho.
Resumo:
- Uma gravação passa por cinco etapas de processamento e deixa quatro artefatos armazenados separadamente: a transcrição bruta, o mapa de quem falou, o roteiro refinado e um resumo para cada formato aplicado.
- A identificação de quem falou roda sobre
pyannote/speaker-diarization-community-1, bloco a bloco, carregando as impressões de voz adiante para que a mesma pessoa mantenha o mesmo rótulo do minuto 5 ao minuto 50.- A tradução aceita 44 códigos de idioma; a própria interface existe em 15 idiomas; os resumos vêm em 10 formatos embutidos, além dos formatos personalizados que você define por nome, instruções e lista de seções.
- Consulte os preços atuais para cobrança mensal ou anual, minutos e funções por plano. Podem mudar; confira moeda, impostos e condições no pagamento. Este artigo não é uma cotação.
Imagem: Klean Denmark, "Daily sprint meeting", Wikimedia Commons, CC BY-SA 2.0. Exatamente o tipo de reunião para o qual todo esse pipeline existe.
Há duas formas de o áudio entrar, e elas não são a mesma
Existem exatamente dois pontos de entrada, e a diferença entre eles molda tudo o que vem depois.
O primeiro é a gravação ao vivo. O navegador abre um AudioContext fixado em 16.000 Hz, carrega um AudioWorklet e acumula a entrada do microfone em blocos de 4.096 amostras — a 16 kHz, um pacote a cada 256 milissegundos. Cada bloco é convertido de ponto flutuante de 32 bits para PCM inteiro de 16 bits e enviado por WebSocket para /ws/audio/{sessionId}. Um segundo socket, /ws/session/{id}, carrega o canal de controle: mudanças de idioma, atualizações de contexto, o comando SUMMARIZE e o comando FINISH, que encerra a sessão e grava a nota.
O segundo é o upload de arquivo. Você solta uma gravação na janela de upload, ela é transmitida para POST /upload, e a resposta chega como JSON delimitado por linhas — um fluxo, não uma rodinha girando — para que a interface mostre progresso real em passos nomeados, e não uma porcentagem inventada. Os limites merecem ser ditos com franqueza: 500 MB por arquivo, e o seletor aceita apenas audio/*. Se a sua reunião está dentro de uma gravação de tela em MP4, é preciso extrair a trilha de áudio antes. Isso hoje não fazemos por você.
Os dois caminhos convergem para a mesma espinha de processamento. Da etapa 1 em diante, uma gravação ao vivo e um arquivo enviado são tratados de forma idêntica.
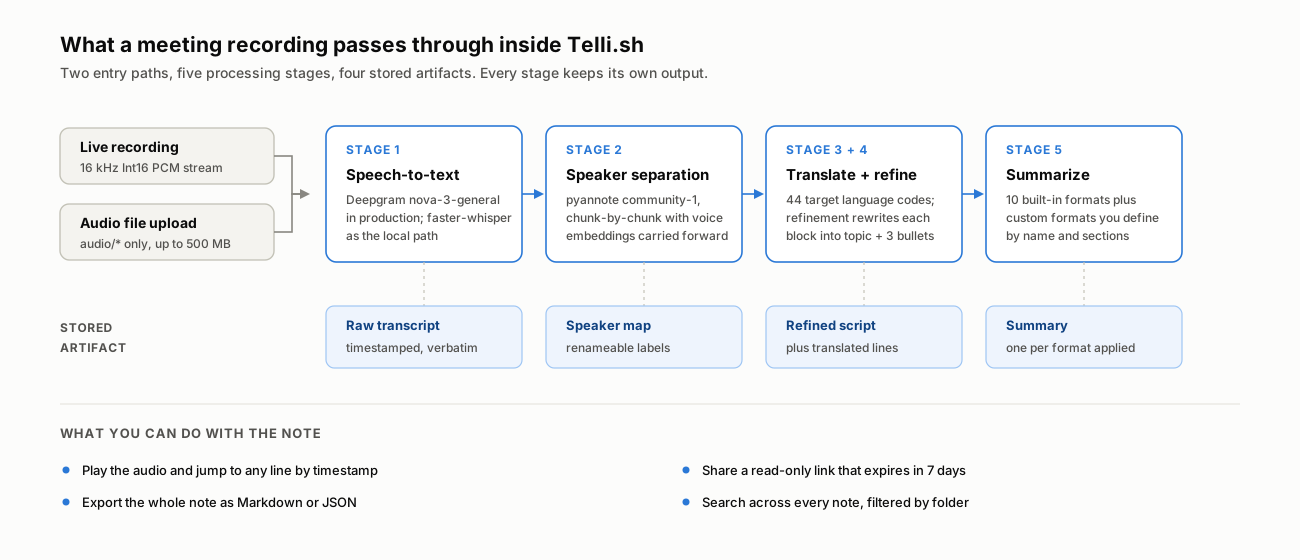
Cada etapa guarda a própria saída. Nada é sobrescrito pela etapa seguinte.
Etapas 1 e 2: ouvir as palavras e descobrir de quem elas eram
O reconhecimento de fala roda primeiro. Em produção, tanto o caminho em lote quanto o de streaming usam o modelo nova-3-general da Deepgram; o código também traz um caminho totalmente local baseado em faster-whisper para instalações próprias, escolhido por uma única configuração de provedor. Essa escolha importa menos do que se imagina, por um motivo sobre o qual já escrevemos bastante: os melhores modelos de fala nos rankings independentes hoje se agrupam dentro de cerca de 1,5 ponto percentual de taxa de erro de palavra. O motor deixou de ser o lugar onde mora a diferença de qualidade.
O lugar é a identificação de quem falou.
A diarização roda sobre pyannote/speaker-diarization-community-1. O detalhe de implementação que de fato importa é como ela lida com gravações longas. Em vez de diarizar o arquivo inteiro de uma vez, o pipeline processa o áudio em blocos e atribui falantes logo depois de cada bloco — mantendo, porém, um dicionário acumulado de impressões de voz por falante e reidentificando contra esse conjunto acumulado a cada bloco seguinte. É esse mecanismo que evita a falha clássica em que uma gravação de duas horas rebatiza silenciosamente a mesma pessoa como SPEAKER_00, depois SPEAKER_03, depois SPEAKER_07 conforme a reunião se arrasta.
Quando um segmento se sobrepõe a duas falas, o rótulo vai para a que cobre mais, com a semelhança de impressões servindo de desempate nos casos de sobreposição pequena.
Você recebe rótulos genéricos — SPEAKER_00, SPEAKER_01 — porque um modelo não tem como saber que SPEAKER_01 é a sua diretora de engenharia. Você renomeia uma vez na nota, e o mapeamento fica salvo com ela e é aplicado em todos os lugares depois, inclusive em exportações e links compartilhados. Essa é a divisão honesta de trabalho: a máquina separa as vozes, você fornece os nomes.
O que cada etapa de fato deixa para trás
A regra de projeto que seguimos é que nenhuma etapa destrói a saída da anterior. Você precisa sempre conseguir voltar às palavras que foram realmente ditas.
Os quatro grupos armazenados são transcrição, mapa de falantes, texto refinado e resumo. Linhas traduzidas pertencem à transcrição; a quinta linha não é um quinto artefato independente.
| Artefato | Produzido por | O que contém | Para que serve |
|---|---|---|---|
| Transcrição bruta | Etapas 1 + 2 | Linhas literais com marca de tempo e rótulo de falante em cada uma | Conferir o que foi dito ao pé da letra; clicar numa linha para posicionar o áudio |
| Mapa de falantes | Etapa 2 (+ suas edições) | A correspondência rótulo-nome da nota | Torna todas as outras visões legíveis — aplicado na nota, nas exportações e nos compartilhamentos |
| Roteiro refinado | Etapa 4 | Cada bloco reescrito como uma linha de tema em negrito mais até 3 pontos | Passar o olho numa reunião longa sem lê-la |
| Linhas traduzidas | Etapa 3 | Uma tradução ao lado de cada linha original | Ler uma reunião feita num idioma com o qual você não trabalha |
| Resumo | Etapa 5 | Um documento estruturado para cada formato aplicado | A coisa que você realmente envia às pessoas |
Na interface da nota, isso aparece como três tipos de abas: Histórico (transcrição bruta), Roteiro (versão refinada) e uma aba para cada formato de resumo gerado. Se o áudio da gravação foi guardado, um player fica acima delas, e clicar em qualquer linha da transcrição leva o áudio até aquela marca de tempo.
Etapa 3: em tradução, o número que importa é 44
A tradução de reuniões em tempo real foi o recurso que mais trouxe usuários no começo, e vale a pena ser preciso sobre o alcance dela, porque "suporta mais de 100 idiomas" é a afirmação menos verificável desta categoria.
Há dois números diferentes, e eles não são o mesmo:
- São aceitos 44 códigos de idioma de destino para tradução. Esse conjunto está enumerado explicitamente na configuração do backend e inclui
zh-TWcomo distinto dezh— o que pesa mais do que parece se você trabalha entre Taiwan e a China continental. - São 15 idiomas para a própria interface e para o idioma em que a IA escreve o seu resumo: inglês, coreano, japonês, chinês, alemão, francês, espanhol, italiano, português, russo, polonês, vietnamita, tailandês, indonésio e malaio.
Numa sessão ao vivo, a tradução é incremental, não agrupada no fim. Conforme fronteiras de pontuação chegam à transcrição, a tradução daquele trecho flui ao lado do original, e um cache por sessão evita retraduzir texto que não mudou. No upload de arquivo, as linhas são agrupadas em lotes: quando ninguém está olhando a tela, vazão importa mais do que latência.
Há também um modo de fluxo de tradução, distinto do modo nota, para quando a tradução é a entrega: uma conversa bilíngue que você precisa acompanhar ao vivo, e não uma reunião da qual você precisa tirar uma ata.
Etapa 4: a etapa que ninguém pede e todo mundo precisa
Aqui a descrição vira opinião, e não vamos suavizar: o refinamento é a etapa mais subestimada deste pipeline.
Uma transcrição literal da fala humana é quase ilegível. As pessoas recomeçam frases, deixam o final no ar, dizem "sim, sim, isso" quatro vezes e enterram uma decisão dentro de noventa segundos de pigarro. Transcrever isso sem errar uma palavra continua sendo noventa segundos de pigarro.
Por isso a etapa de refinamento pega cada bloco de conversa e o reescreve sob restrições apertadas, definidas num template de prompt e não no código, para que possamos ajustá-las sem um deploy. Cada bloco vira uma linha de tema em negrito derivada do conteúdo — não de um nome de papel, não entre colchetes — seguida de no máximo três marcadores, mirando cerca de 300 caracteres por bloco. Nomes de falantes e marcas de tempo são removidos explicitamente: já estão na transcrição bruta, e repeti-los só deixa a visão de leitura rápida menos rápida.
Uma restrição desse template merece ser nomeada: o modelo é instruído a acompanhar o registro do que ouviu e, especificamente, a não forçar um tom de reunião corporativa sobre uma conversa informal. Um papo de corredor resumido como se fosse ata de conselho é um artefato pior do que resumo nenhum.
Chamamos o resultado de roteiro: a versão que você lê de relance, a uma aba de distância da versão que você pode citar numa discussão.
Etapa 5: dez formatos de resumo, porque "resumo" não é uma coisa só
A última etapa produz o documento que você de fato envia. Pedir a um LLM "um resumo" devolve o resumo de nada em particular, então aqui o formato é uma escolha de primeira classe, não um padrão escondido.
Dez formatos vêm embutidos: Resumo de IA (geral), Ata de reunião, Relatório executivo, Notas de aula, Sermão / Palestra, Registro de atendimento, Resumo de ligação, Entrevista, Notas de ideias e Roteiro de apresentação. Cada um carrega sua própria estrutura de seções: a ata produz visão geral, pontos discutidos, decisões e próximos passos; o roteiro de apresentação produz esboço, fluxo dos slides, mensagens-chave, notas do apresentador e próximas ações. Os títulos das seções são localizados por idioma em vez de traduzidos na hora da geração, e é por isso que um resumo em japonês se lê como um documento japonês, não como um texto em inglês traduzido.
Quando nenhum dos dez serve, você define um formato personalizado: um nome, um conjunto de instruções e a lista de seções que quiser, salvo e reutilizável. "Atualização semanal para o conselho com riscos e decisões em aberto" é um formato que se escreve uma vez.
Qualquer formato pode ser aplicado a uma nota depois do fato e gera a própria aba. Resumir a mesma gravação de três maneiras para três públicos aqui é uso normal, não gambiarra.
Precisão de transcrição é uma pilha, não um número
Taxa de erro de palavra é apenas uma parte da avaliação de uma transcrição de reunião. Em Precisão de STT não é suficiente, explicamos por que perder um único "não" pode inverter uma decisão e quase não afetar a pontuação geral.
A versão prática: a precisão de transcrição que sobrevive ao contato com uma reunião real é construída em cinco camadas, e o modelo acústico é só a de baixo.
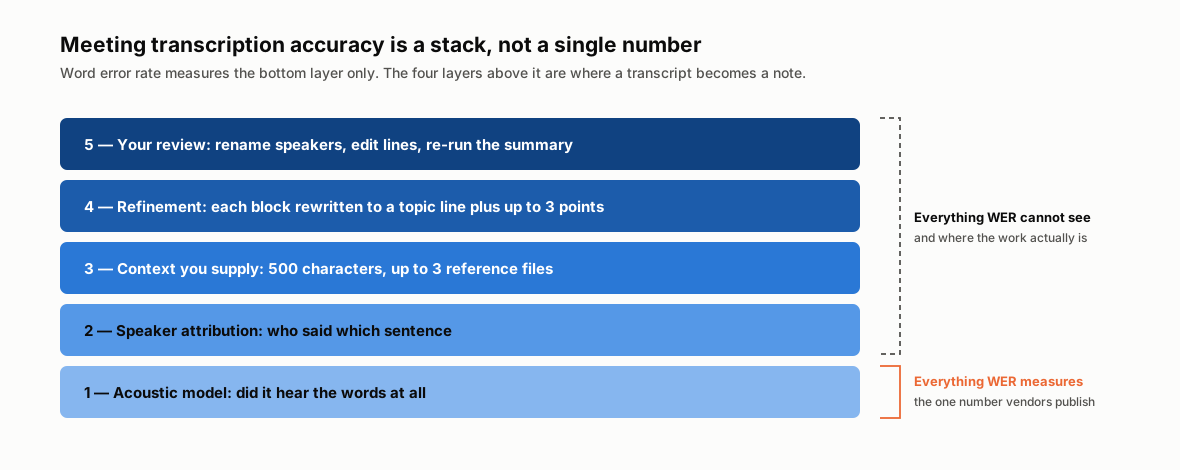
A taxa de erro mede a camada 1. As camadas 2 a 5 decidem se a transcrição é utilizável.
A camada 3 é a que o usuário controla diretamente e que a maioria pula. Antes de gravar ou enviar, você pode fornecer um bloco de contexto de até 500 caracteres — tema, nomes dos participantes, códigos de produto, siglas — e anexar até 3 arquivos de referência (PDF, imagem ou texto), cujo texto é extraído no navegador e dobrado nesse mesmo orçamento. Esse contexto é passado para as etapas de IA.
Nomes próprios são muito informativos, mas pouco frequentes nos dados gerais de treinamento: nomes de projetos internos, sobrenomes incomuns e códigos de produto. Acrescentar contexto, como indicar que "Kestrel" é um produto e "Ravi" é uma pessoa, ajuda o sistema a reconhecê-los. Antes de gravar, preencha o campo de contexto com nomes e termos que o sistema talvez não conheça.
Do zero a uma nota compartilhada, em onze passos
Concretamente, da primeira execução ao artefato compartilhável:
- Crie a conta. Consulte os preços atuais para cobrança mensal ou anual, minutos e funções por plano. Podem mudar; confira moeda, impostos e condições no pagamento. Este artigo não é uma cotação.
- Escolha o caminho: inicie uma gravação ao vivo ou abra a janela de upload e solte um arquivo de áudio (
audio/*, abaixo de 500 MB). - Defina o par de idiomas. A origem pode ficar em detecção automática; o idioma de destino decide em que língua saem a tradução e o resumo.
- Preencha o campo de contexto — tema, nomes, siglas, até 500 caracteres. Anexe até 3 arquivos de referência se tiver um deck ou uma pauta.
- Escolha uma pasta se quiser arquivar a nota em algum lugar específico. Dá para mover depois.
- Grave, ou aguarde o fluxo de upload. Numa sessão ao vivo, a transcrição aparece conforme as pessoas falam, com a tradução entrando ao lado se houver idioma de destino definido. Durante um upload você verá passos nomeados: reconhecimento de voz, análise, refinamento, resumo e finalização.
- Encerre a sessão. Isso dispara a mensagem de controle
FINISH, que descarrega o último trecho, espera o refinamento em andamento, salva o áudio, gera o resumo e grava a nota. - Renomeie os falantes. SPEAKER_00 vira um nome uma única vez, e o mapeamento se propaga por todas as visões e todas as exportações.
- Leia a aba Roteiro para entender do que a reunião tratou; desça para o Histórico e clique numa linha para ouvir o áudio naquele instante exato quando algo parecer errado.
- Gere formatos de resumo adicionais se um público precisa da ata e outro do relatório executivo.
- Compartilhe ou exporte. Um link de compartilhamento é somente leitura, expira em 7 dias e aceita senha opcional. A exportação entrega Markdown ou JSON, com o resumo, os blocos refinados e a transcrição completa num único arquivo.
Envie uma gravação que você já tem
Preços simples e transparentes
Consulte os preços atuais para cobrança mensal ou anual, minutos e funções por plano. Podem mudar; confira moeda, impostos e condições no pagamento. Este artigo não é uma cotação.
A licença atual permite uso pessoal não comercial. Leia termos, segurança e privacidade. Consulte [email protected] sobre retenção e treinamento de IA antes de enviar material sensível.
O que o Telli.sh não faz
Um texto de produto que só lista capacidades é anúncio. Aqui vai a outra coluna.
Não aceita arquivos de vídeo. O uploader aceita audio/*. Extraia a trilha de áudio antes.
Não entra nas suas chamadas. Não existe bot que disque para Zoom, Meet ou Teams e apareça na lista de participantes. Você grava a sala, ou o áudio da sua própria máquina, ou envia o arquivo depois.
Não conserta áudio ruim. Um microfone omnidirecional de notebook na ponta de uma mesa de doze pessoas, numa sala de paredes duras, vai degradar a diarização independentemente de qual modelo estiver rodando — fala sobreposta e falantes distantes são onde a atribuição quebra primeiro. Um celular no meio da mesa ganha do notebook na ponta todas as vezes, e não custa nada.
Não conhece o seu vocabulário se você não contar. Veja a camada 3 acima. Nomes próprios incomuns são a fonte de erro mais comum, e o campo de contexto é a solução.
Os rótulos de falante começam genéricos. Nenhum sistema adivinha que SPEAKER_01 é a Priya. Renomeie uma vez por nota.
Links de compartilhamento têm prazo. Sete dias, e depois o link morre. É um padrão deliberado para conteúdo de reunião, não um recurso esquecido — mas significa que um link compartilhado não é arquivo permanente. Exporte o Markdown se precisar de permanência.
Conclusão
O Telli.sh é mais do que um produto de transcrição. A transcrição é a primeira de cinco etapas, seguida pela atribuição de falantes, pelo refinamento, pela tradução e pelos resumos.
O que realmente construímos é a distância entre uma gravação e uma decisão: saber quem falou, encolher os noventa segundos de pigarro até a única frase que existe ali dentro, entregar essa frase no idioma em que quem lê trabalha e colocá-la onde um colega possa abrir. A gravação é evidência. A nota é o que muda o que vai acontecer na semana que vem.
Se você tem uma gravação de reunião, experimente o fluxo com seu próprio áudio e compare a nota resultante com a transcrição.
Comece uma sessão ao vivo com tradução
Fontes
- Precisão de STT não é suficiente — blog do Telli.sh, 4 de agosto de 2026 — o argumento completo sobre taxa de erro, com a dispersão do ranking
- pyannote/speaker-diarization-community-1 — Hugging Face — o modelo de diarização usado neste pipeline
- Documentação do modelo Deepgram Nova-3 — o modelo de reconhecimento de fala usado em produção
- Preços do Telli.sh — cotas e preços atuais
- Página da imagem no Wikimedia Commons — imagem de capa, Klean Denmark, CC BY-SA 2.0
