Cinq étapes, quatre artefacts : ce que Telli.sh fait réellement d'un enregistrement de réunion
Une visite guidée de toute la chaîne Telli.sh — enregistrement en direct ou import audio, transcription de réunion par IA avec identification des locuteurs, traduction de réunion en temps réel vers 44 langues cibles, résumés IA en 10 formats et note partageable. Avec les limites assumées, les prix exacts et ce qu'exige vraiment la précision de transcription.
Huit personnes sont debout dans une pièce. L'une explique pourquoi la migration a glissé. Deux écoutent à moitié. Quelqu'un au fond prononce la phrase qui comptera dans trois semaines, et personne ne la note.
Voilà la matière première. Cet article décrit ce que notre système en fait, étape par étape, depuis l'instant où l'audio commence à circuler jusqu'à celui où vous collez un lien dans un canal.
Cette visite guidée du produit, réalisée par l'équipe Telli.sh, suit l'audio depuis l'enregistrement ou l'import, à travers la transcription, la traduction et la reformulation, jusqu'à la note partageable. Les modèles utilisés, leurs limites et les tarifs sont précisés au fil du parcours.
En bref :
- Un enregistrement traverse cinq étapes de traitement et laisse derrière lui quatre artefacts stockés séparément : la transcription brute, la carte des locuteurs, le script condensé et un résumé par format appliqué.
- L'identification des locuteurs tourne sur
pyannote/speaker-diarization-community-1, bloc par bloc, en reportant les empreintes vocales d'un bloc à l'autre pour qu'une même personne garde la même étiquette de la minute 5 à la minute 50.- La traduction vise 44 codes de langue ; l'interface elle-même existe en 15 langues ; les résumés arrivent en 10 formats intégrés, plus les formats personnalisés que vous définissez par nom, consignes et liste de sections.
- Consultez les tarifs actuels pour facturation mensuelle ou annuelle, minutes et fonctions par offre. Prix et fonctions peuvent changer ; vérifiez devise, taxes et conditions au paiement. Cet article n’est pas un devis.
Image : Klean Denmark, « Daily sprint meeting », Wikimedia Commons, CC BY-SA 2.0. Le genre de réunion pour lequel toute cette chaîne existe.
Deux façons d'entrer, et ce ne sont pas les mêmes
Il y a exactement deux points d'entrée, et leur différence conditionne tout l'aval.
Le premier est l'enregistrement en direct. Le navigateur ouvre un AudioContext fixé à 16 000 Hz, charge un AudioWorklet et met en tampon l'entrée micro par blocs de 4 096 échantillons — soit, à 16 kHz, un paquet toutes les 256 millisecondes. Chaque bloc passe du flottant 32 bits au PCM entier 16 bits et part par WebSocket vers /ws/audio/{sessionId}. Un second socket, /ws/session/{id}, porte le canal de commande : changements de langue, mises à jour du contexte, commande SUMMARIZE, et la commande FINISH qui clôt la session et écrit la note.
Le second est l'import de fichier. Vous déposez un enregistrement dans la fenêtre d'import, il part en flux vers POST /upload, et la réponse revient en JSON délimité par lignes — un flux, pas un sablier — pour que l'interface affiche une vraie progression par étapes nommées plutôt qu'un pourcentage inventé. Les limites méritent d'être dites franchement : 500 Mo par fichier, et le sélecteur n'accepte que audio/*. Si votre réunion est enfermée dans une capture d'écran MP4, il faut d'abord en extraire la piste audio. Nous ne le faisons pas à votre place aujourd'hui.
Les deux chemins rejoignent la même colonne de traitement. À partir de l'étape 1, un direct et un fichier importé sont traités à l'identique.
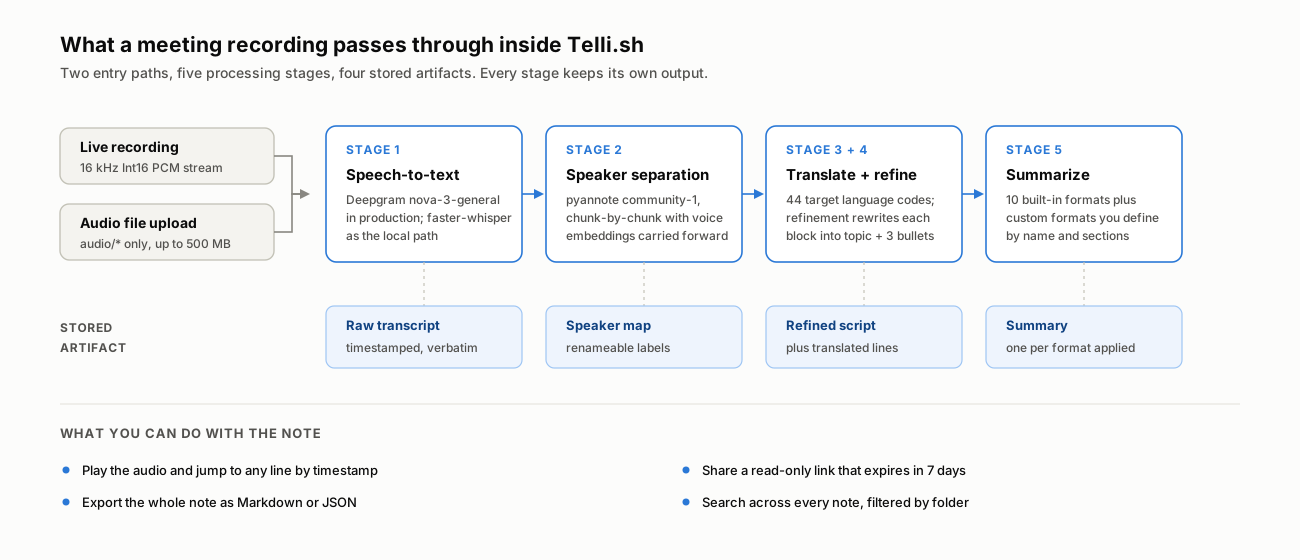
Chaque étape conserve sa propre sortie. Rien n'est écrasé par l'étape suivante.
Étapes 1 et 2 : entendre les mots, puis établir à qui ils appartenaient
La reconnaissance vocale passe en premier. En production, le chemin par lots comme le chemin en flux utilisent le modèle nova-3-general de Deepgram ; la base de code embarque aussi un chemin entièrement local bâti sur faster-whisper pour les déploiements auto-hébergés, sélectionné par un seul réglage de fournisseur. Ce choix compte moins qu'on ne l'imagine, pour une raison que nous avons longuement développée : les meilleurs modèles vocaux des classements indépendants se tiennent désormais dans un mouchoir d'environ 1,5 point de taux d'erreur sur les mots. Le moteur n'est plus l'endroit où se joue la différence de qualité.
Elle se joue sur l'identification des locuteurs.
La diarisation tourne sur pyannote/speaker-diarization-community-1. Le détail d'implémentation qui compte vraiment, c'est la gestion des longs enregistrements. Plutôt que de diariser tout le fichier d'un coup, la chaîne traite l'audio par blocs et attribue les locuteurs immédiatement après chaque bloc — tout en tenant un dictionnaire cumulatif d'empreintes vocales par locuteur, et en ré-identifiant contre ce cumul à chaque bloc suivant. C'est ce mécanisme qui empêche le grand classique : un enregistrement de deux heures qui rebaptise discrètement la même personne SPEAKER_00, puis SPEAKER_03, puis SPEAKER_07 au fil de la réunion.
Quand un segment chevauche deux tours de parole, l'étiquette va au tour qui le recouvre le plus, la similarité des empreintes servant d'arbitre dans les cas de faible recouvrement.
Vous obtenez des étiquettes génériques — SPEAKER_00, SPEAKER_01 — parce qu'un modèle ne peut pas deviner que SPEAKER_01 est votre directrice de l'ingénierie. Vous les renommez une fois dans la note, et la correspondance est stockée avec elle puis appliquée partout ensuite, y compris dans les exports et les liens de partage. Voilà l'honnête répartition des rôles : la machine sépare les voix, vous fournissez les noms.
Ce que chaque étape laisse réellement
Notre règle de conception tient en une phrase : aucune étape ne détruit la sortie de la précédente. Vous devez toujours pouvoir revenir aux mots réellement prononcés.
Les quatre groupes stockés sont transcription, correspondance des intervenants, texte retravaillé et résumé. Les lignes traduites appartiennent à la transcription : la cinquième ligne du tableau n’est pas un cinquième élément indépendant.
| Artefact | Produit par | Contenu | À quoi il sert |
|---|---|---|---|
| Transcription brute | Étapes 1 + 2 | Lignes horodatées mot à mot, étiquette de locuteur sur chacune | Vérifier ce qui a été dit littéralement ; cliquer une ligne pour se caler sur l'audio |
| Carte des locuteurs | Étape 2 (+ vos retouches) | La correspondance étiquette-nom de la note | Rendre toutes les autres vues lisibles — appliquée dans la note, les exports et les partages |
| Script condensé | Étape 4 | Chaque bloc réécrit en une ligne de sujet en gras plus 3 points au maximum | Survoler une longue réunion sans la lire |
| Lignes traduites | Étape 3 | Une traduction attachée à chaque ligne, à côté de l'original | Lire une réunion tenue dans une langue que vous ne pratiquez pas |
| Résumé | Étape 5 | Un document structuré par format appliqué | Ce que vous envoyez réellement aux gens |
Dans l'interface, cela apparaît en trois sortes d'onglets — Historique (transcription brute), Script (version condensée), et un onglet par format de résumé généré. Si l'audio a été conservé, un lecteur se place au-dessus, et cliquer sur n'importe quelle ligne de transcription positionne l'audio à cet horodatage.
Étape 3 : en traduction, le chiffre qui compte est 44
La traduction de réunion en temps réel est la fonctionnalité qui a attiré le plus d'utilisateurs des débuts, et il vaut la peine d'en préciser la portée : « plus de 100 langues prises en charge » est l'affirmation la moins vérifiable de cette catégorie.
Deux chiffres différents s'appliquent, et ce ne sont pas les mêmes :
- 44 codes de langue cible sont acceptés pour la traduction. Cet ensemble est énuméré explicitement dans la configuration du backend et distingue
zh-TWdezh— ce qui pèse plus qu'il n'y paraît si vous travaillez entre Taïwan et la Chine continentale. - 15 langues sont prises en charge pour l'interface elle-même et pour la langue dans laquelle l'IA rédige votre résumé : anglais, coréen, japonais, chinois, allemand, français, espagnol, italien, portugais, russe, polonais, vietnamien, thaï, indonésien et malais.
En session live, la traduction est incrémentale, pas regroupée en fin de parcours. Dès qu'une frontière de ponctuation arrive dans la transcription, la traduction de ce segment s'écoule à côté de l'original, et un cache par session évite de retraduire un texte inchangé. À l'import de fichier, les lignes sont au contraire regroupées par lots : quand personne ne regarde un écran, le débit prime sur la latence.
Il existe aussi un mode de flux traduction, distinct du mode note, pour le cas où la traduction est le livrable — une conversation bilingue à suivre en direct plutôt qu'une réunion dont il faut tirer un compte rendu.
Étape 4 : celle que personne ne demande et dont tout le monde a besoin
Ici, la description bascule en opinion, et nous ne l'atténuerons pas : la condensation est l'étape la plus sous-estimée de cette chaîne.
Une transcription mot à mot de parole humaine est quasi illisible. Les gens recommencent leurs phrases, laissent traîner, répètent quatre fois « oui, oui, voilà », et enterrent une décision dans quatre-vingt-dix secondes de raclements de gorge. Transcrire cela sans une erreur donne encore quatre-vingt-dix secondes de raclements de gorge.
L'étape de condensation prend donc chaque bloc de conversation et le réécrit sous contraintes serrées, définies dans un gabarit de prompt plutôt que dans le code, ce qui permet de l'ajuster sans déploiement. Chaque bloc devient une ligne de sujet en gras dérivée du contenu — pas d'un nom de rôle, pas entre crochets — suivie de trois puces au maximum, en visant environ 300 caractères par bloc. Les noms de locuteurs et les horodatages sont explicitement retirés : ils figurent déjà dans la transcription brute, et les répéter rend la vue de survol moins survolable.
Une contrainte de ce gabarit mérite d'être nommée : le modèle a pour consigne d'épouser le registre de ce qu'il a entendu et, explicitement, de ne pas plaquer un ton de réunion d'affaires sur une conversation informelle. Une discussion de couloir résumée comme un procès-verbal de conseil est un artefact pire que pas de résumé du tout.
Nous appelons le résultat le script — la version lisible d'un coup d'œil, à un onglet de la version citable en cas de litige.
Étape 5 : dix formats de résumé, parce que « résumé » n'est pas une seule chose
La dernière étape produit le document que vous envoyez vraiment. Demander « un résumé » à un LLM donne le résumé de rien en particulier ; le format est donc ici un choix de premier ordre, pas une valeur par défaut cachée.
Dix formats sont intégrés : Résumé IA (général), Compte rendu de réunion, Note de synthèse, Notes de cours, Sermon / Conférence, Compte rendu d'entretien d'accompagnement, Résumé d'appel, Interview, Notes d'idées et Trame de présentation. Chacun porte sa propre structure de sections : le compte rendu produit un aperçu, les points discutés, les décisions et les prochaines étapes ; la trame de présentation produit un plan, l'enchaînement des diapositives, les messages clés, les notes d'orateur et les actions suivantes. Les titres de sections sont eux-mêmes localisés par langue plutôt que traduits au moment de la génération — d'où le fait qu'un résumé en japonais se lise comme un document japonais et non comme un texte anglais traduit.
Si aucun des dix ne convient, vous définissez un format personnalisé : un nom, un jeu de consignes et la liste de sections souhaitée, enregistrés et réutilisables. « Point hebdomadaire au conseil, avec risques et décisions en suspens » est un format qu'on écrit une fois.
N'importe quel format peut être appliqué après coup à une note et génère son propre onglet. Résumer trois fois le même enregistrement pour trois publics est ici un usage normal, pas un contournement.
La précision de transcription est une pile, pas un chiffre
Le taux d'erreur sur les mots n'est qu'un aspect de l'évaluation d'une transcription de réunion. Dans La précision STT ne suffit pas, nous expliquons pourquoi l'omission d'un seul « ne… pas » peut inverser une décision tout en pesant à peine sur le score global.
Version pratique : la précision de transcription qui survit au contact d'une vraie réunion se construit en cinq couches, et le modèle acoustique n'est que celle du bas.
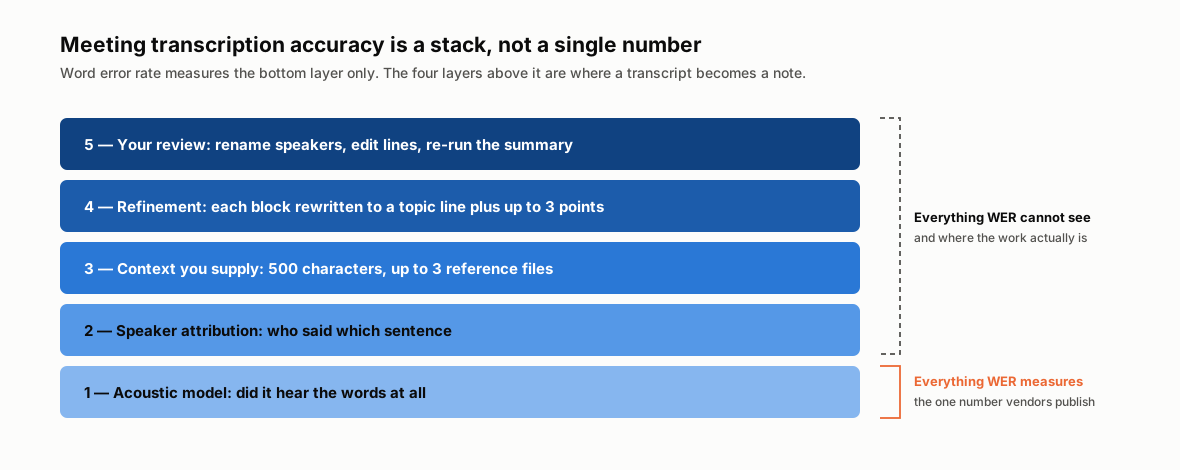
Le taux d'erreur mesure la couche 1. Ce sont les couches 2 à 5 qui décident si la transcription est utilisable.
La couche 3 est celle que les utilisateurs contrôlent directement et que la plupart sautent. Avant d'enregistrer ou d'importer, vous pouvez fournir un bloc de contexte de 500 caractères maximum — sujet, noms des participants, codes produits, acronymes — et joindre jusqu'à 3 fichiers de référence (PDF, image ou texte), dont le texte est extrait dans le navigateur et replié dans ce même budget. Ce contexte est transmis aux étapes IA.
Les noms propres sont très informatifs, mais rares dans les données générales d'entraînement : noms de projets internes, patronymes inhabituels et références produit. Ajouter des précisions comme « Kestrel est un produit » et « Ravi est une personne » aide le système à les reconnaître. Avant l'enregistrement, renseignez le champ de contexte avec les noms et termes que le système ne connaît peut-être pas.
De rien à une note partagée, en onze étapes
Concrètement, du premier essai à l'artefact partageable :
- Inscrivez-vous. Consultez les tarifs actuels pour facturation mensuelle ou annuelle, minutes et fonctions par offre. Prix et fonctions peuvent changer ; vérifiez devise, taxes et conditions au paiement. Cet article n’est pas un devis.
- Choisissez le chemin : lancez un enregistrement en direct, ou ouvrez la fenêtre d'import et déposez un fichier audio (
audio/*, moins de 500 Mo). - Réglez la paire de langues. La source peut rester en détection automatique ; la langue cible décide de la langue de la traduction et du résumé.
- Remplissez le champ de contexte — sujet, noms, acronymes, jusqu'à 500 caractères. Joignez jusqu'à 3 fichiers de référence si vous avez un support ou un ordre du jour.
- Choisissez un dossier si la note doit être rangée quelque part de précis. Vous pourrez la déplacer plus tard.
- Enregistrez, ou attendez le flux d'import. En direct, la transcription apparaît au fil de la parole, la traduction s'écoulant à côté si une langue cible est réglée. Pendant un import, vous voyez des étapes nommées : reconnaissance vocale, analyse, condensation, résumé, finalisation.
- Terminez la session. Cela déclenche le message de commande
FINISH, qui vide le dernier segment, attend la condensation en cours, enregistre l'audio, génère le résumé et écrit la note. - Renommez les locuteurs. SPEAKER_00 devient un prénom une fois, et la correspondance se propage à toutes les vues et à tous les exports.
- Lisez l'onglet Script pour saisir le sujet de la réunion ; passez à Historique et cliquez une ligne pour écouter l'audio à cet instant précis dès que quelque chose semble faux.
- Générez d'autres formats de résumé si un public a besoin du compte rendu et un autre de la note de synthèse.
- Partagez ou exportez. Un lien de partage est en lecture seule, expire au bout de 7 jours et peut porter un mot de passe optionnel. L'export fournit du Markdown ou du JSON, avec le résumé, les blocs condensés et la transcription complète dans un seul fichier.
Importer un enregistrement que vous avez déjà
Des tarifs simples et transparents
Consultez les tarifs actuels pour facturation mensuelle ou annuelle, minutes et fonctions par offre. Prix et fonctions peuvent changer ; vérifiez devise, taxes et conditions au paiement. Cet article n’est pas un devis.
La licence actuelle autorise un usage personnel non commercial. Consultez conditions, sécurité et confidentialité. Pour la conservation et l’entraînement IA, contactez [email protected] avant tout import sensible.
Ce que Telli.sh ne fait pas
Un article produit qui n'aligne que des capacités est une publicité. Voici l'autre colonne.
Il ne prend pas de fichiers vidéo. L'import accepte audio/*. Extrayez d'abord la piste audio.
Il ne rejoint pas vos appels. Aucun bot ne se connecte à Zoom, Meet ou Teams pour figurer dans la liste des participants. Vous enregistrez la salle, ou l'audio de votre machine, ou vous importez le fichier ensuite.
Il ne répare pas un mauvais audio. Un micro omnidirectionnel de portable posé au bout d'une table de douze personnes, dans une pièce aux murs durs, dégradera la diarisation quel que soit le modèle qui tourne : la parole superposée et les locuteurs éloignés sont les premiers points de rupture de l'attribution. Un téléphone au centre de la table bat à chaque fois le portable au bout de la table, et ne coûte rien.
Il ne connaît pas votre vocabulaire si vous ne le lui dites pas. Voir la couche 3 ci-dessus. Les noms propres inhabituels sont la première source d'erreurs, et le champ de contexte est le remède.
Les étiquettes de locuteurs partent génériques. Aucun système ne devine que SPEAKER_01 est Priya. Vous renommez une fois par note.
Les liens de partage ont une durée. Sept jours, puis le lien meurt. C'est un choix par défaut assumé pour du contenu de réunion, pas une fonctionnalité oubliée — mais cela veut dire qu'un lien de partage n'est pas une archive. Exportez le Markdown s'il vous faut de la permanence.
Ce qu'il faut retenir
Telli.sh est plus qu'un outil de transcription. La transcription est la première de cinq étapes, suivie de l'attribution des locuteurs, de la reformulation, de la traduction et des résumés.
Ce que nous construisons réellement, c'est la distance entre un enregistrement et une décision : savoir qui a parlé, ramener les quatre-vingt-dix secondes de raclements de gorge à la phrase qu'elles contiennent, rendre cette phrase dans la langue de travail du lecteur, et la déposer là où un collègue peut l'ouvrir. L'enregistrement est une pièce à conviction. La note est ce qui change ce qui se passera la semaine prochaine.
Si vous avez un enregistrement de réunion, essayez le parcours avec votre propre audio et vérifiez la note obtenue à partir de la transcription.
Lancer une session traduite en direct
Sources
- La précision STT ne suffit pas — blog Telli.sh, 4 août 2026 — l'argument complet sur le taux d'erreur, avec l'écart du classement
- pyannote/speaker-diarization-community-1 — Hugging Face — le modèle de diarisation utilisé dans cette chaîne
- Documentation du modèle Deepgram Nova-3 — le modèle de reconnaissance vocale utilisé en production
- Tarifs Telli.sh — quotas et prix actuels
- Page de l'image sur Wikimedia Commons — photo d'en-tête, Klean Denmark, CC BY-SA 2.0
