Google переведёт вашу встречу на вьетнамском в реальном времени. И не запишет из неё ни слова.
Переводимые субтитры Google Meet покрывают 69 языков, включая вьетнамский, а Live translate в Google Переводчике — 74. Функция Transcripts в Meet и её заметочник на Gemini поддерживают ровно по 8 языков, и вьетнамского нет ни в одном из списков. DeepL Voice может расшифровать устный вьетнамский только через стороннего поставщика, которого должен включить администратор и который не работает с автоопределением. Разбираем, что живой голосовой перевод реально даёт вьетнамским командам в 2026 году — и чего он не даёт никогда.
Наберите в Google запрос про живой голосовой перевод на вьетнамский — и вы получите по-настоящему хороший ответ. Функция Live translate в Google Переводчике поддерживает 74 языка, включая вьетнамский, и на Android, и на iOS. Она работает с наушниками и без них, продолжает работать при заблокированном экране и предлагает режим «лицом к лицу», который делит экран телефона пополам, чтобы каждый собеседник читал свою половину.
Это работает. И это не самая интересная часть.
Интересное начинается на той же платформе четыре часа спустя, когда вы хотите узнать, о чём же в итоге договорились. Функция Transcripts в Google Meet — та самая, что создаёт долговечный документ Google Docs, — поддерживает ровно восемь языков, и вьетнамского среди них нет. Нет его и среди восьми языков функции Meet «Take notes for me», на справочной странице которой добавлено, что функция «поддерживает один язык за раз» и что «несколько языков, звучащих на одной встрече, сейчас не поддерживаются».
Коротко
- Вьетнамский поддерживают все продукты Google, которые слушают: Live translate (74 языка), переводимые субтитры Meet (69 языков). И его не поддерживает ни один продукт Google, который пишет: Transcripts в Meet и заметочник Meet на Gemini — по 8 языков каждый.
- DeepL Voice умеет показывать субтитры на вьетнамском, но не умеет расшифровывать устный вьетнамский собственными моделями — вьетнамский находится в стороннем уровне, который должен включить администратор и который не работает с автоопределением.
- Сравнение ниже показывает, где поддерживается вьетнамский на каждой крупной платформе по состоянию на 31 августа 2026 года, а затем предлагает шесть шагов для вьетнамско-английской встречи, после которой останется запись.
Тот же разрыв затрагивает и другие языки; мы объясняем это в обзоре перевода, который исчезает после разговора. Для вьетнамских команд проблема острее: функции встреч, предназначенные для сохранения записи, не поддерживают вьетнамский.
Что «живой голосовой перевод» реально даёт на вьетнамском сегодня
Начнём с честного подсчёта, потому что бесплатные инструменты Google очень хорошо делают то, для чего созданы.
В Live translate от Google Переводчика четыре режима — согласно справочной странице для Android, просмотренной 31 августа 2026 года: Listening (поднесите телефон к уху или наденьте наушники, чтобы в реальном времени слышать перевод собеседника), Conversation (переводы проигрываются вслух, говорящие сменяют друг друга), Text only (только чтение, без звука) и Custom settings. Отдельно есть режим Face to face, где экран делится надвое и каждый говорящий видит на своей половине и расшифровку, и перевод на своём языке. Микрофон сам определяет, когда один язык заканчивается и начинается другой, так что между фразами никому не нужно нажимать кнопку.
Две детали заслуживают больше признания, чем обычно получают. Во-первых, сессия переживает многозадачность: в документации Google сказано, что перевод «продолжается без разрывов, когда вы переключаете приложения, сворачиваете приложение или когда экран блокируется». Во-вторых, вьетнамский можно скачать для офлайн-использования, а загруженные пакеты можно обновить до версии более высокого качества с того же экрана — это важно в стране, где выезд на объект или цех завода не гарантируют связи.
Одно ограничение стоит назвать прямо, потому что оно людей удивляет: это функция телефона. Собственная справочная страница Google для веб-версии сообщает одной фразой: «В веб-версии Google Переводчика нельзя говорить и переводить одновременно». Если ваша двуязычная встреча проходит на ноутбуке, Live translate в комнате нет.
В поездке на такси, при визите к поставщику или коротком разговоре в коридоре с приехавшим клиентом Live translate — удобный бесплатный вариант. Проблема возникает, когда после встречи нужна долговечная запись с поиском.
Gemini 3.5 Live Translate поднимает Meet с пяти языков до более чем семидесяти
Поддержка живого перевода Google выходит за пределы телефонных функций и субтитров, доступных на момент публикации этой статьи.
9 июня 2026 года Google представил Gemini 3.5 Live Translate — модель речь-в-речь, покрывающую более 70 языков. Как сообщил Slator 16 июня 2026 года, она разворачивается через Gemini Live API и Google AI Studio в публичном превью, входит в закрытое превью в Google Meet для отдельных клиентов Workspace и глобально появляется в мобильном приложении Google Переводчика на Android и iOS.
Для Meet важна цифра «до и после». Перевод речи в Meet был ограничен пятью поддерживаемыми языками, причём перевод шёл только на английский и с английского. Gemini 3.5 Live Translate расширяет это до более чем 70 языков и свыше 2000 языковых пар, а более широкая доступность запланирована на конец 2026 года. Для вьетнамской команды система из пяти языков с английским в качестве оси была по сути отсутствием системы; 2000 пар — это уже другой продукт.
Google позиционирует модель узко, и это скорее хороший знак, чем плохой. По данным Slator, документация противопоставляет Live Translate более широким возможностям Live Agent у Gemini: модель работает как конвейер перевода в реальном времени, принимает только аудио и намеренно лишена вызова функций, привязки к поиску, инструментов и системных инструкций. Это переводчик-синхронист, а не ассистент — то же различие OpenAI проводила, описывая GPT-Realtime-Translate. Google также добавил на Android «режим прослушивания», который выводит переведённый звук через разговорный динамик, чтобы вы могли следить за переводом, не надевая на встрече заметные наушники.
То есть живой слой для вьетнамского быстро улучшается сразу с нескольких сторон. Теперь второй вопрос.
Линия записи: где заканчивается вьетнамский
У каждой платформы есть своя линия. По одну сторону — функции, которые помогают понимать речь в момент, когда она звучит. По другую — функции, которые превращают речь в то, что останется у вас на следующей неделе. Назовём это линией записи — и для вьетнамского поддержка исчезает ровно на ней.
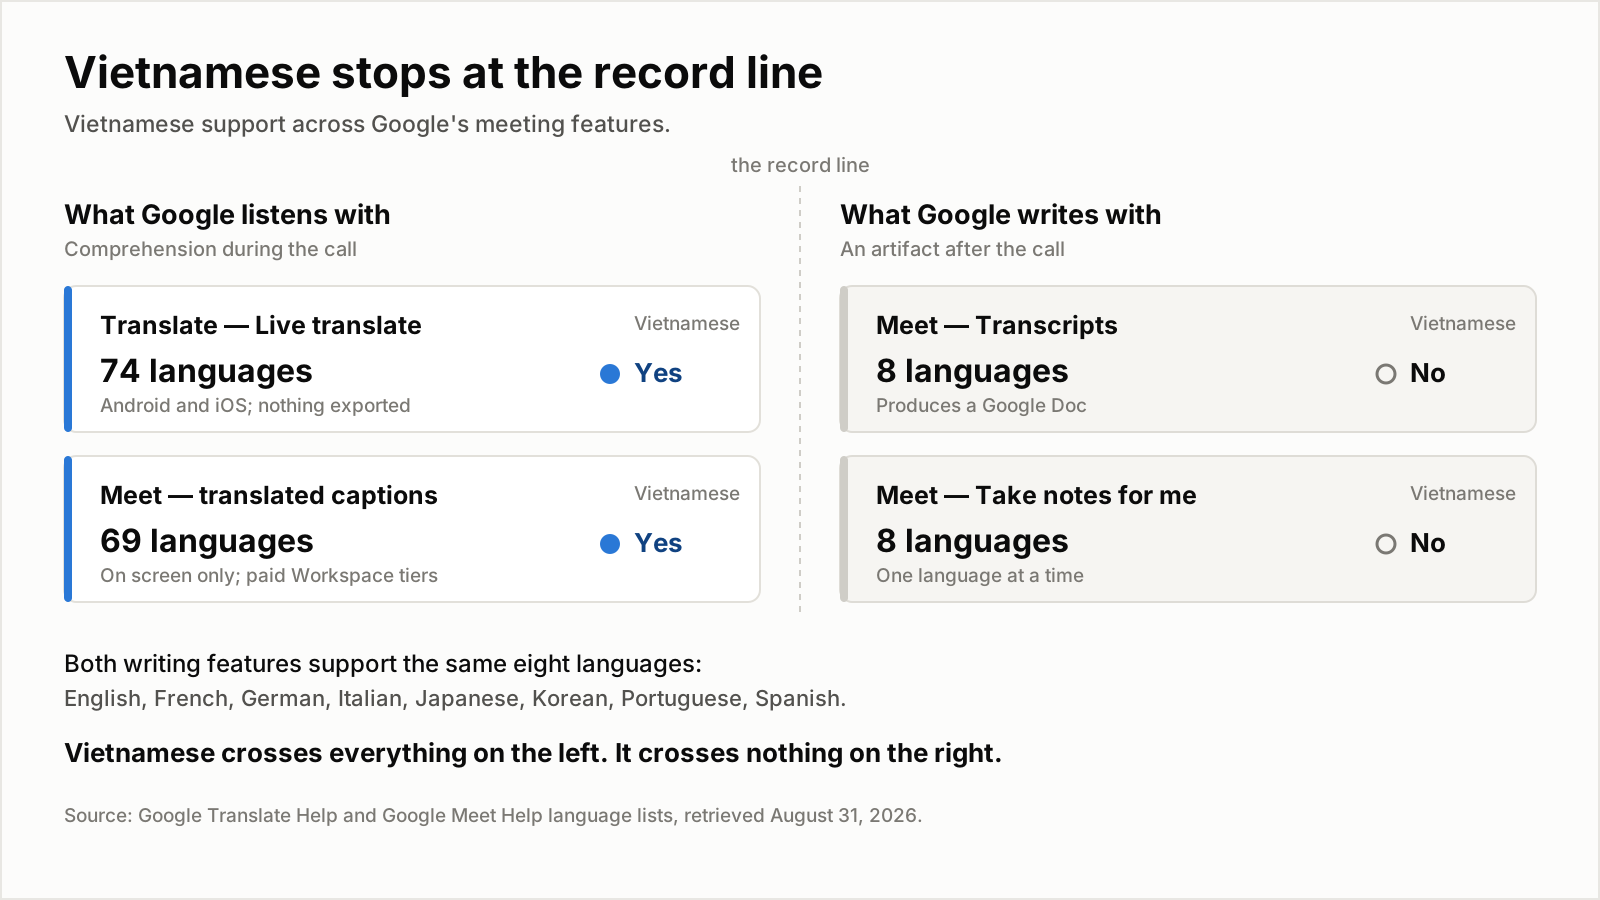
Количество языков — данные самого Google, из четырёх справочных страниц, просмотренных 31 августа 2026 года. Вьетнамский есть в обеих функциях, которые слушают, и ни в одной, которая пишет.
Сравнение по отдельным функциям наглядно показывает эту границу:
| Функция Google | Вьетнамский поддерживается? | Языки | Остаётся ли артефакт после звонка? |
|---|---|---|---|
| Google Переводчик — Live translate | Да | 74 | Нет |
| Google Meet — переводимые субтитры | Да | 69 | Только на экране; вшиты в запись, если включить Record captions |
| Google Meet — Transcripts | Нет | 8 | Да, документ Google Docs |
| Google Meet — «Take notes for me» | Нет | 8, по одному за раз | Да, заметки в Google Docs плюс сводка на почту |
| Google Meet — Gemini 3.5 Live Translate | Разворачивается | 5 сегодня, 70+ в закрытом превью | Не указано |
Все строки — из справочных страниц Google и отчёта Slator от 16 июня 2026 года, просмотренных 31 августа 2026 года.
Восемь языков, общих для Transcripts и «Take notes for me», совпадают полностью: английский, французский, немецкий, итальянский, японский, корейский, португальский и испанский. Это один и тот же список дважды, и это список крупных европейских и восточноазиатских рынков. Вьетнамский — примерно 97 миллионов носителей, по собственной оценке Samsung в её материале 2024 года об этой работе — остаётся за его пределами, вместе с тайским, индонезийским, хинди и арабским.
Есть ещё одно ограничение, которое бьёт именно по двуязычным командам, и оно действует даже для команд, работающих полностью на поддерживаемых языках. Справочная страница Google по «Take notes for me» сообщает, что функция поддерживает один язык за раз и что несколько языков, звучащих на одной встрече, сейчас не поддерживаются. Звонок Вьетнам — США, в котором переключаются между вьетнамским и английским, дисквалифицирован дважды: один раз за вьетнамский, второй — за переключение.
У переводимых субтитров Meet есть ограниченный способ сохранения: выберите Record captions, и они встроятся в записанный клип; во время сеанса к субтитрам также можно вернуться. Однако встроенные в видео субтитры — это не доступная для поиска и редактирования расшифровка, и на их основе нельзя подготовить текст для сводки. Переводимые субтитры Meet доступны только в платных редакциях Workspace: Business Standard, Business Plus, Enterprise Standard, Enterprise Plus, Enterprise Starter (доступна до 30 июня 2025 года) и Google AI Pro for Education.
DeepL покажет вам вьетнамские субтитры. Расшифровка устного вьетнамского — это другой уровень.
DeepL Voice предлагает ещё один вариант, но в его документации отдельно указаны языки распознавания речи и языки субтитров.
DeepL делит языковую поддержку на два списка. Устные языки — это то, что принимает распознаватель. Языки перевода — это то, на чём могут отображаться субтитры. Вьетнамский есть в списке перевода, а тот насчитывает 41 язык. Теперь посмотрим на другую сторону: собственные модели DeepL расшифровывают 18 устных языков — китайский (мандаринский), чешский, нидерландский, английский, французский, немецкий, индонезийский, итальянский, японский, корейский, польский, португальский, румынский, русский, испанский, шведский, турецкий и украинский. Вьетнамского среди них нет.
Вьетнамский доступен как устный язык, но только во втором уровне из 20 языков, которые расшифровывает сторонний поставщик — Speechmatics. К этому прилагаются три условия, все задокументированы на справочной странице DeepL, просмотренной 31 августа 2026 года:
- Администратор команды должен включить стороннюю обработку в администраторском аккаунте организации — без этого ни один из этих языков вообще не работает.
- Автоопределение не работает. Формулировка DeepL: «Сторонние языки не работают с Auto-detect language — их нужно вручную выбрать в качестве Spoken language».
- Чтобы участники могли сами выбирать свой устный язык, организатор должен включить код доступа при подключении встречи к DeepL Voice.
Ничего неразумного в этом нет — DeepL отмечает, что Speechmatics работает по соглашению о нулевом хранении, так что данные расшифровки удаляются с их серверов сразу после обработки. Но сложите требования вместе — и получите практический итог: говорящий на вьетнамском, подключившийся к встрече с DeepL, находится в одной непоставленной администратором галочке от того, чтобы вообще не быть расшифрованным, и не может рассчитывать, что система заметит его сама. При этом позиция по хранению та же, о которой мы писали сегодня утром: в FAQ DeepL сказано, что данные встречи «временно обрабатываются в памяти и удаляются по завершении звонка».
Samsung — контрпример, который стоит назвать. Вьетнамский вошёл в первые 16 языков Galaxy AI, а Samsung R&D Institute Vietnam 23 мая 2024 года опубликовал необычно откровенный рассказ о том, почему это было сложно. Во вьетнамском шесть различных тонов; пример из статьи — ma, mả и má (призрак, могила и мать) различаются только тоном. Буй Нгок Тунг, руководитель направления ASR в институте, описал модель, которая различает аудиокадры длиной «около 20 миллисекунд», чтобы решить, к какому слову относится их последовательность. Когда корейский производитель смартфонов вкладывается в тональное моделирование вьетнамского, а европейская переводческая компания отдаёт этот язык субподрядчику, это кое-что говорит о том, как рынок оценивает данный язык.
В документации Nova-3 от Deepgram вьетнамский указан как vi (страница просмотрена 31 августа 2026 года). Это один из 58 языков, рассмотренных в нашем разборе того, что скрывает слово «поддерживается» в распознавании речи.
Ни один вендор не публикует уровень ошибок для вьетнамской речи на встречах, и корпуса объясняют почему
Опубликованные показатели распознавания речи пока не позволяют понять, как вьетнамская расшифровка справится со спонтанной речью на встрече; доступные корпуса помогают объяснить этот пробел.
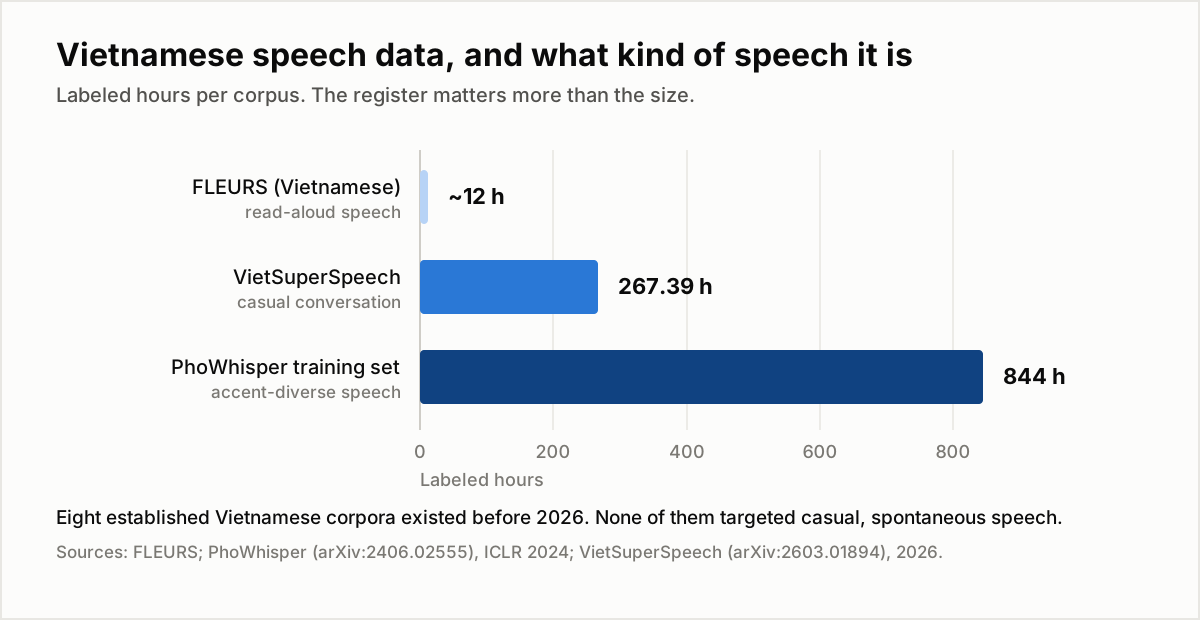
Размеченные часы — не вся история, история — это регистр. FLEURS — это читаемая речь; обучающая выборка PhoWhisper охватывает акценты; VietSuperSpeech — первый корпус, построенный специально для непринуждённого разговора. Источники с датами — в списке ниже.
В часто цитируемом вьетнамском бенчмарке FLEURS примерно 12 часов чтения вслух. PhoWhisper, представленный на секции Tiny Papers ICLR 2024, дообучал Whisper на 844-часовом наборе данных, отобранном с учётом разнообразия акцентов. VietASR, опубликованный 23 мая 2025 года, использовал 70 000 часов неразмеченного аудио и 50 часов размеченных данных; авторы сообщают, что на реальных данных он превзошёл Whisper Large-v3 и коммерческие системы.
Выпущенный в 2026 году VietSuperSpeech включает 52 023 пары «аудио — текст» общей длительностью 267,39 часа непринуждённой разговорной речи на вьетнамском: 240,67 часа для обучения и 26,72 часа для оценки, всего 13,8 миллиона символов с диакритическими знаками. Авторы описывают пробел, который призван закрыть этот набор данных:
«Хотя такие корпуса, как VLSP2020, VIET_BUD500, VietSpeech, FLEURS, VietMed, Sub-GigaSpeech2-Vi, viVoice и Sub-PhoAudioBook, обеспечивают широкое покрытие формальной и читаемой речи, ни один из них не нацелен именно на непринуждённый спонтанный регистр, необходимый для приложений разговорного ИИ».
Этот набор данных ориентирован на речь, характерную для встреч: перебивания, оговорки, английские названия продуктов внутри вьетнамских фраз и незаконченные мысли. Одной оценки на читаемой речи недостаточно, чтобы понять, насколько точно система справится с таким разговором.
Практическая мера защиты для команды — расшифровка, которую люди могут прочитать и исправить. Для этого выбранная функция встреч прежде всего должна создавать расшифровку на вьетнамском.
Как провести вьетнамско-английскую встречу так, чтобы запись уцелела
Проверьте эти шесть пунктов до звонка и во время него:
- При необходимости выберите отдельные инструменты для понимания речи и ведения записи. Google Переводчик или субтитры Meet подходят для понимания вьетнамской речи в реальном времени; ни одна из этих функций не создаёт долговечную расшифровку на вьетнамском, о которой говорится здесь.
- Задайте вьетнамский как устный язык явно; не полагайтесь на автоопределение. В DeepL это обязательно — сторонние языки, включая вьетнамский, автоматически не определяются. Везде остальном это всё равно лучший выбор, потому что автоопределение фиксирует догадку в первые несколько секунд — на самом бесконтекстном аудио всей сессии.
- Сверяйте список языков функции записи, а не платформы. Ловушка, ради описания которой существует этот материал, — предположение, что платформа, переводящая вьетнамский, его же и расшифровывает. В Google Meet 69 против 8 — это и есть разрыв между двумя такими предположениями.
- Назовите проблему переключения языков до звонка. Если ваша команда вставляет английские названия продуктов, номера тикетов и аббревиатуры во вьетнамские фразы — а так делает любая офшорная инженерная команда, — убедитесь, что ваш инструмент записи допускает два языка в одной сессии. Заметочник Meet прямо не допускает.
- Исправляйте имена собственные в первые пять минут, вживую. Вьетнамская диакритика и английские кодовые названия продуктов — два места, где расшифровка стабильно ломается, и они же — два места, где неверная строка сильнее всего портит любую сводку, построенную поверх неё. Исправление по ходу встречи стоит секунд.
- Держите исходный вьетнамский текст, английский перевод и сводку в одной записи. Не три файла в трёх инструментах. Перевод односторонен: через год вы сможете заново перевести с вьетнамского более сильной моделью, но восстановить вьетнамский из английского не сможете никогда.
Пошаговое руководство по продукту см. в нашей июньской статье о том, как превратить запись двуязычной встречи в ИИ-заметку, которую можно проверить.
Итог: вьетнамский преодолел разрыв в понимании, но не разрыв в записи
Поддержка вьетнамского расширилась в живых субтитрах, голосовом переводе и распознавании речи. Это дает командам больше способов следить за разговором, но заявленная поддержка не гарантирует доступность функции в вашей учетной записи. Расширение Gemini 3.5 Live Translate в Meet пока является предварительным просмотром и поэтапным запуском, а не универсальной заменой уже поддерживаемых языковых пар. До встречи проверьте нужную функцию, тип аккаунта и направление перевода с вьетнамского или на него.
Что не сдвинулось — так это запись. Две функции Google, создающие долговечный артефакт, поддерживают между собой восемь языков, одни и те же восемь, и вьетнамского нет ни в одной. DeepL сделает субтитры на вьетнамском, но расшифровку самого вьетнамского отправит субподрядчику за администраторский переключатель. Рынок решил, что вьетнамский — язык, который стоит слышать, и пока не язык, который стоит записывать.
Поэтому вендора нужно спрашивать не о том, поддерживает ли он вьетнамский. Почти все теперь отвечают «да», и почти все имеют в виду половину, которая слушает. Спрашивать надо так: какие именно из ваших функций поддерживают вьетнамский после завершения звонка — и можете ли вы показать мне список языков для этой конкретной функции?
Где здесь Telli.sh: слой записи — это тот слой, который строим мы. Telli.sh расшифровывает встречу на том языке, на котором она действительно шла, переводит на 44 целевых языка, включая вьетнамский, и хранит все три артефакта в одной заметке — исходный вьетнамский текст, выровненный по нему перевод и сводку, построенную поверх. Сам интерфейс доступен на 15 языках, включая вьетнамский, так что команда в Дананге и клиент в Сиднее читают одну и ту же встречу каждый на своём языке и при этом пользуются одной исправляемой записью.
Создать заметку встречи с живым переводом
Источники
- Google Translate Help, "Hear live speech to speech translations with Live translate" (Android), просмотрено 31 августа 2026 года — список из 74 языков, включая вьетнамский, четыре режима перевода, режим «лицом к лицу» и продолжение работы в фоне.
- Google Translate Help, "Download languages to use offline" (Android), просмотрено 31 августа 2026 года — офлайн-пакеты и обновления до более высокого качества.
- Google Meet Help, "Use translated captions in Google Meet", просмотрено 31 августа 2026 года — список из 69 языков, включая вьетнамский, платные редакции Workspace и Record captions.
- Google Meet Help, "Use Transcripts with Google Meet", просмотрено 31 августа 2026 года — восемь поддерживаемых языков расшифровки.
- Google Meet Help, "'Take notes for me' in Google Meet", просмотрено 31 августа 2026 года — те же восемь языков и ограничение «один язык за раз».
- Slator, "Google Expands AI Live Speech Translation with Gemini 3.5 Live Translate", 16 июня 2026 года — анонс 9 июня, более 70 языков, переход Meet с пяти языков к более чем 2000 пар и режим прослушивания.
- DeepL Help Center, "DeepL Voice languages", просмотрено 31 августа 2026 года — 18 устных языков, расшифровываемых DeepL, 20 сторонних устных языков, включая вьетнамский, 41 язык перевода, ограничение автоопределения и соглашение Speechmatics о нулевом хранении.
- Samsung Newsroom, "The Learning Curve, Part 3: Taking AI Data From Good to Great", 23 мая 2024 года — вьетнамский среди первых 16 языков Galaxy AI, шесть тонов, пример ma/mả/má и описание кадров длиной ~20 мс.
- Deepgram, Models & Languages Overview, просмотрено 31 августа 2026 года — вьетнамский (
vi) в списке языков Nova-3. - Ле, Нгуен и Нгуен, "PhoWhisper: Automatic Speech Recognition for Vietnamese", ICLR 2024 Tiny Papers — набор для дообучения на 844 часа с разнообразием акцентов.
- "VietASR: Achieving Industry-level Vietnamese ASR with 50-hour labeled data and Large-Scale Speech Pretraining", 23 мая 2025 года — 70 000 неразмеченных часов, 50 размеченных часов.
- "VietSuperSpeech: A Large-Scale Vietnamese Conversational Speech Dataset", 2026 год — 52 023 пары, 267,39 часа и пробел в регистре у восьми корпусов.