[AI创意笔记 02] Timestral:预测明天的数字,不靠聊天机器人猜
介绍Mistral小型时间序列模型:概率预测意味着什么、适合哪些任务,以及如何从CPU实验和公平比较开始。
AI创意笔记探索新兴AI模型与工具背后的思路,以及它们在实际应用中的可能性。
明天的客服队列,在变成一段文字之前,首先是一个数字。你可能想知道是否要增派人手、服务器是否需要更多容量,或常规补货能否撑过周末。只有预测本身有依据,流畅的解释才有用。
Mistral AI于2026年10月15日推出的Timestral是一组预测数值序列的模型。它输出概率预测,而非聊天回复,支持多条相关序列,已发布5M、28M、123M和209M参数四种规模。Mistral公告
本文从这一定义走向第一次有用的实验:该输入什么、如何理解预测范围,以及怎样与简单基线比较。示例都是建议的练习,方便尝试,而不把说明图当成实测结果。
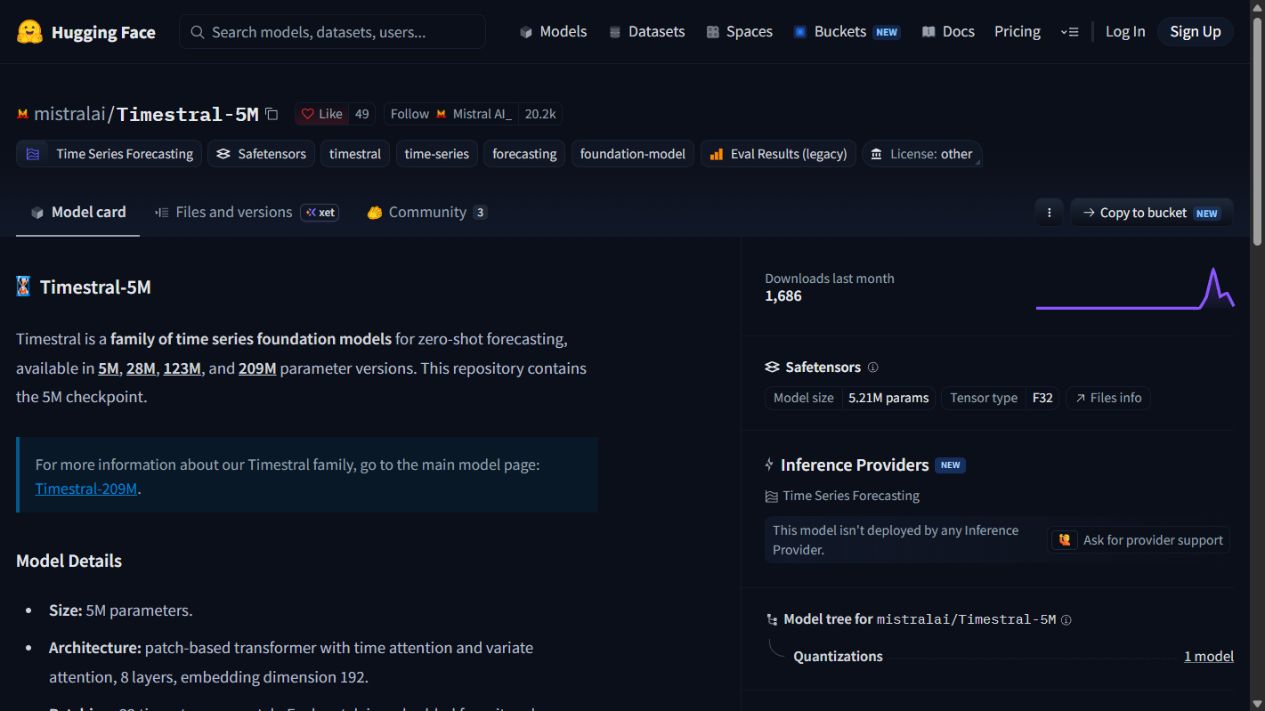 Mistral AI的Timestral-5M页面,摄于2026年10月20日。画面标识的是预测检查点,并非本文运行实验得到的图表。
预测首先需要时间和数量的定义
时间序列记录连续时间步上的某个量,例如每分钟请求数、每日订单数或定时测量的温度。间隔也是含义的一部分:每分钟100次请求,与每小时100次请求,描述的是完全不同的系统。
选模型前,先用一句话写明决策。“估计明天的客服量,以便安排值班”,比“从数据中发现洞察”更清楚,因为它明确了目标、预测跨度和可能改变的行动。
接着定义一次观测代表什么。今天创建的工单和今天解决的工单是不同事件。为了方便合成一列,可能恰好掩盖了你想理解的瓶颈。
Timestral应在这些定义之后进入流程。它能处理数值历史,但数字的含义仍由团队负责。如果文件中途悄悄从请求数变成完成任务数,模型无法修复这个目标定义问题。
有用的输出,是能指导行动的范围
点预测给出一个数字;概率预测描述未来值的多个可能水平,让你看到中心估计周围有多大余地。Timestral的公开输出在每个预测时间步包含21个分位数。推理仓库
设想一次练习,明天的中位预测是100张工单,较高分位数是140。这些是假设数字,但能说明决策:常规排班覆盖中心估计,备用计划应对忙碌日。预测有用,是因为它改变准备方式。
分位数并不承诺现实一定在线下。你需要反复进行历史预测,检查校准情况。如果实际值超过所谓第90百分位预测的频率远高于预期,那么它对你的数据就不是可靠的计划边界。
选择哪条边界还取决于决策。缺货与略有库存盈余的成本不同,所以有的团队会依据高于中位数的分位数行动,而另一些任务可以接受成本更低、没那么保守的安排。
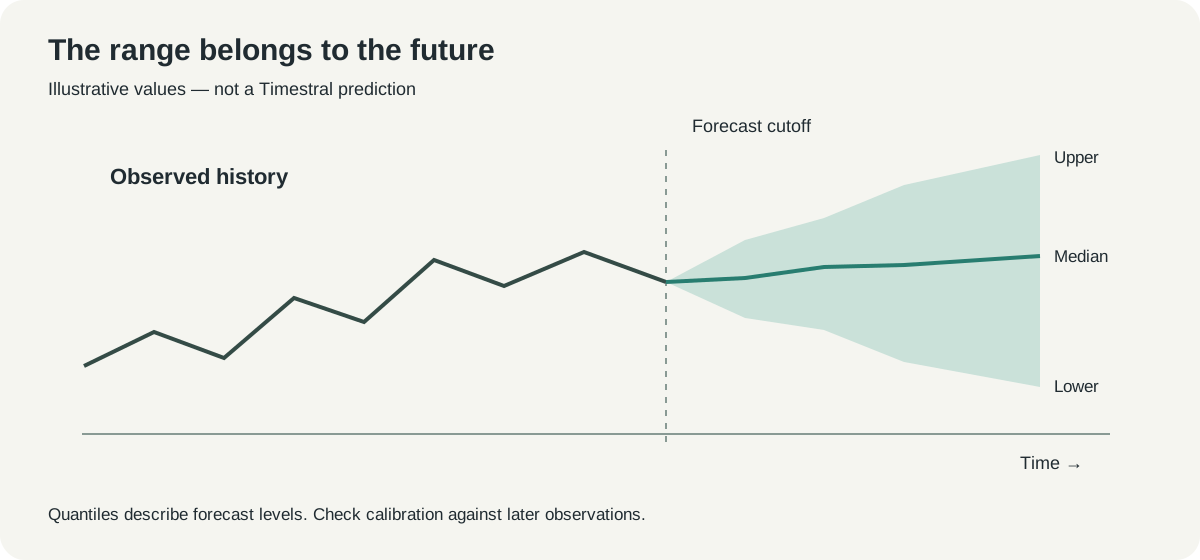 原创示意图。曲线和范围仅用于说明预测窗口,并非Timestral输出。
相关信号只有守住时间边界才有帮助
Mistral把Timestral描述为支持仅历史协变量和未来已知协变量的多变量模型。通俗地说,它能使用多条相关数值信号,以及未来取值已经确定的信息。发布说明
门店明天是否营业,可以提前知道;明天的实际销售额不行。即使事后完成的表格同时拥有两列,预测实验也必须尊重这个区别。
在服务器容量练习中,产品上线日程可能已知,准确请求量则未知。在订单量练习中,节假日标记可以提前获得,最终订单数才是目标。这些是用来说明区别的场景,并非已部署集成的声明。
天气很容易引发同类错误。历史文件可能记录实际天气,但当时真正能用的只有天气预报。拿后来的观测值评估,会给系统提供决策时不存在的信息。
从能回答问题的最小实验开始
官方仓库提供CPU或GPU独立推理。CPU路径降低初试门槛,但模型规模并不等于完整硬件需求。依赖、已加载张量、历史长度和序列数量也会影响运行内存。安装与用法
入门时,5M检查点适合用来认识接口。这只是小练习的起点建议,并不声称它在你的数据上能胜过更大检查点。先跑通流程,再比较模型大小。
- 打开官方仓库,检查安装说明与许可链接,在独立Python环境中操作。
- 准备一条固定间隔采样的序列。即使传入模型的数组只有数值,也要在源文件保留时间戳和单位。
- 留出最后若干观测作为测试窗口,不要把它们放进这次预测的历史。
- 加载检查点,指定预测跨度,检查中心预测和分位数。
- 与同一历史产生的简单预测比较,并在更早的多个截点重复,再作结论。
仓库给出的安装路径要求Python 3.10及以上、PyTorch 2.4及以上。安装会获取代码,需要可复现环境时,应检查并固定版本。
python -m venv .venv
# Activate the environment using your shell's activation command.
python -m pip install "git+https://github.com/mistralai/timestral.git"
以下是公开推理接口的简小改写。数值为合成的每日计数,不意味着本文执行过模型或得到了特定结果。
import numpy as np
from timestral import TimestralForecaster

history = np.array([
    80, 83, 85, 88, 96, 61, 58,
    82, 84, 87, 91, 99, 64, 60,
    85, 86, 89, 94, 102, 66, 63,
], dtype=np.float32)

model = TimestralForecaster.from_pretrained("mistralai/Timestral-5M")
forecast = model.forecast(history, prediction_length=7)
print(forecast.median)
print(forecast.quantile(0.9))
三周的虚构数据足够说明API,不足以证明业务性能。决策前应替换为足够长、含义清楚的序列。检查缺失观测和异常事件,不要悄悄把每个空缺都变成零。
三种工作说明预测为何不同于文本生成
每日客服计划把预测连接到排班。输入可以是每日创建工单的历史,并附上周末和已知休业日的日历。要检查的是,预测能否帮助准备服务能力,尤其能否覆盖简单平均数漏掉的忙碌日。
服务器计划把预测连接到技术上限。目标可能是每个时间段的请求数,但错误、延迟和可承载容量仍需单独监测。需求预测不能证明应用能承受某种负载。
库存计划把预测连接到补货提前期。如果补货需要几天,仅预测明天需求就选错了跨度。更有用的练习,是预测下一批订单尚未到货的这段时间,并比较缺货与过量库存的后果。
三者都有同一模式:定义数量、定义何时决策、定义预测会改变什么。模型随后成为工作流程里的工具。预期行动越清楚,工具就越容易评估。
在当时真正能够预测的时刻做比较
回测重建过去的预测机会:选择历史截点,仅提供此前可得的信息,预测下一个时间段。再向前移动截点并重复,避免未来观测反向泄漏进模型选择。
从符合模式的基线开始。有周周期时,可以用上周同一天;稳定的短期流程,可以用最近值。两者未必总强,但能告诉你增加复杂度是否值得。
| 比较 | 固定条件 | 结果能够说明什么 |
|---|---|---|
| Timestral与季节性基线 | 目标、截点、预测跨度 | 是否改善与决策相关的误差 |
| 5M与更大检查点 | 数据准备和评分 | 额外模型资源是否带来足够收益 |
| 有无已知日历 | 每个截点当时可得的历史信息 | 新信号能否在不泄漏未来的前提下提供帮助 |
| 中位数与更高决策分位数 | 预测与业务成本假设 | 改变的是计划策略,而非模型本身 |
别忽略零和接近零的时段。目标极小时,百分比误差可能难以解释。选择适合序列的指标,并把实际失误与总分一起检查。
实际试点中,一张最严重误差表常比一个平均数更有启发。错误关联的是缺失区间、节假日、系统故障,还是需求真的变了?答案决定应改善数据流程、增加信息,还是重新考虑预测方法。
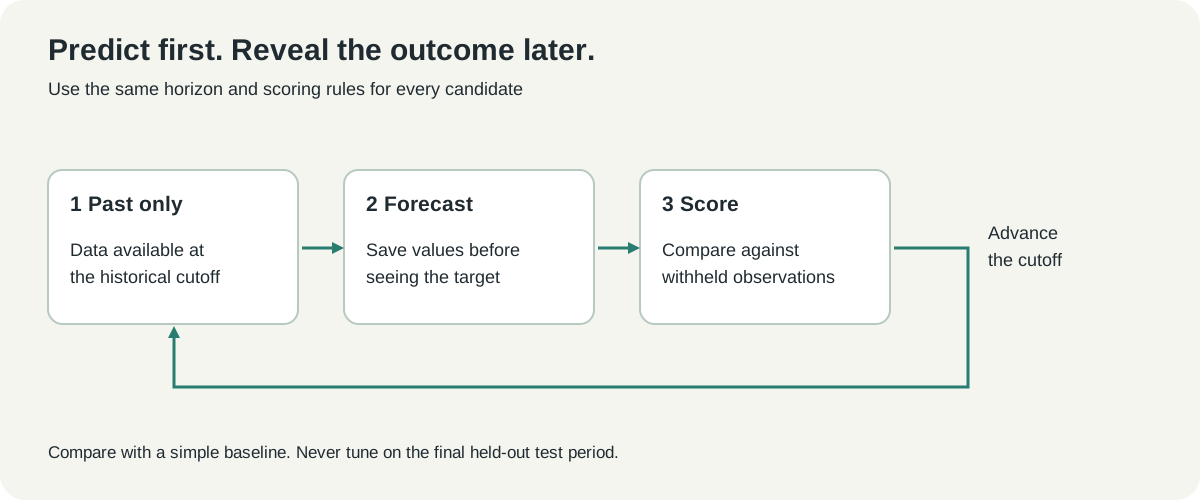 原创回测图。每次预测只使用该截点当时可得的信息,后续观测留作评分。
小权重只是部署的一部分
仓库区分Apache 2.0代码与采用Modified MIT许可的模型权重。请阅读所选检查点的实际权重条款:开放仓库与单独授权的模型,是不同的分发产物。仓库许可说明
首次下载与常规推理也是不同阶段。公开加载器可使用本地缓存,但只有所有组件都离线,整个应用才算离线。本地预测模型并不能阻止流程中的其他环节向远程服务发送数据。
持续运行时,应记录每次预测使用哪个检查点,以及输入数据截止到何时。没有截点的图,即使包含后续观测,也可能被误认为真正的预测。保存原始预测值,不要修改,才能日后与实绩比较。
预测服务还要处理缺失数据与运行失败。把昨天的预测当作最新结果展示,会制造界面一切正常的假象。应显示最后成功取得数据的时间,并决定何时应采用简单基线,而非过期模型输出。
预测更快,只有改善决策才有用
Mistral报告这一系列具备适合CPU的推理能力和较强基准成绩。这值得研究,但不是你自身数据流程的测量结果。公开模型耗时并不包含应用里所有文件读取、特征计算、队列或图表环节。10月15日公告
试点很容易变成“能跑多大的检查点”。更好的问题是:预测能否赶在决策前到达,并改善重要误差?略微更准、却在排班截止后才交付的结果,运营价值有限。
还应区分数值改善与策略改善。平均误差下降,可能没有改变代价最高的繁忙日;反过来,即使中位数变化不大,校准更好的上分位数也可能改善计划。
比较模型前就定好标准。试点才能给出有用选择:保留基线、使用小检查点,或为更高要求的配置提供理由。证据清楚时,任何一种都可能正确。
在明天到来前,把预测留下来
我们认为,Timestral有趣之处在于让专门的数值任务进入容易接触的模型流程。它可以像工作量的天气预报,给出中心预期、范围与准备理由。当这些预测连接真实计划决策,价值才会出现。
从一个数量、一个跨度开始。在结果揭晓前保存预测,再与简单替代方案公平比较。这样,有希望的模型发布才会变成结果真正可用的实验。
来源与媒体
核对日期:2026年10月20日。示例与图表仅作说明,并非模型执行结果。公开模型卡截图由作者拍摄,解释图为原创。来源与许可说明见媒体记录。
把预测与结果保存在一起
把数据定义、预测截点、审阅笔记与原始来源链接一起保存。Telli.sh可以帮助整理实验记录。创建Telli.sh账号