AnyDecisionModel e AnySpeechRecognizer separam a escuta das escolhas em um app Swift
Dois pacotes Swift de terceiros conectam reconhecimento de fala e decisões tipadas. Onde a inferência local ajuda, por que calibrar a confiança e como começar um piloto delimitado.
Uma gravação de atendimento contém dois problemas diferentes. Primeiro, a aplicação precisa recuperar o que a pessoa disse. Depois, deve decidir se a solicitação pertence à cobrança, ao suporte técnico ou a outra equipe. Tratar ambos como uma conversa aberta dificulta enxergar as responsabilidades do aplicativo.
O desenvolvedor Mattt apresentou AnySpeechRecognizer e AnyDecisionModel em 29 de outubro de 2026. São pacotes Swift de terceiros para desenvolvedores das plataformas Apple: um oferece opções de motores de reconhecimento de fala; o outro retorna escolhas tipadas e distribuições de probabilidade. Usam padrões familiares do Swift sem serem anúncios de produtos Apple. A apresentação de Mattt explica os dois trabalhos com o mesmo exemplo de atendimento.
A novidade interessante é poder escolher e avaliar esses trabalhos separadamente. Este guia explica a contribuição dos pacotes, como backends locais e hospedados mudam o projeto do aplicativo e por que um valor numérico de confiança ainda precisa de uma política de produto.
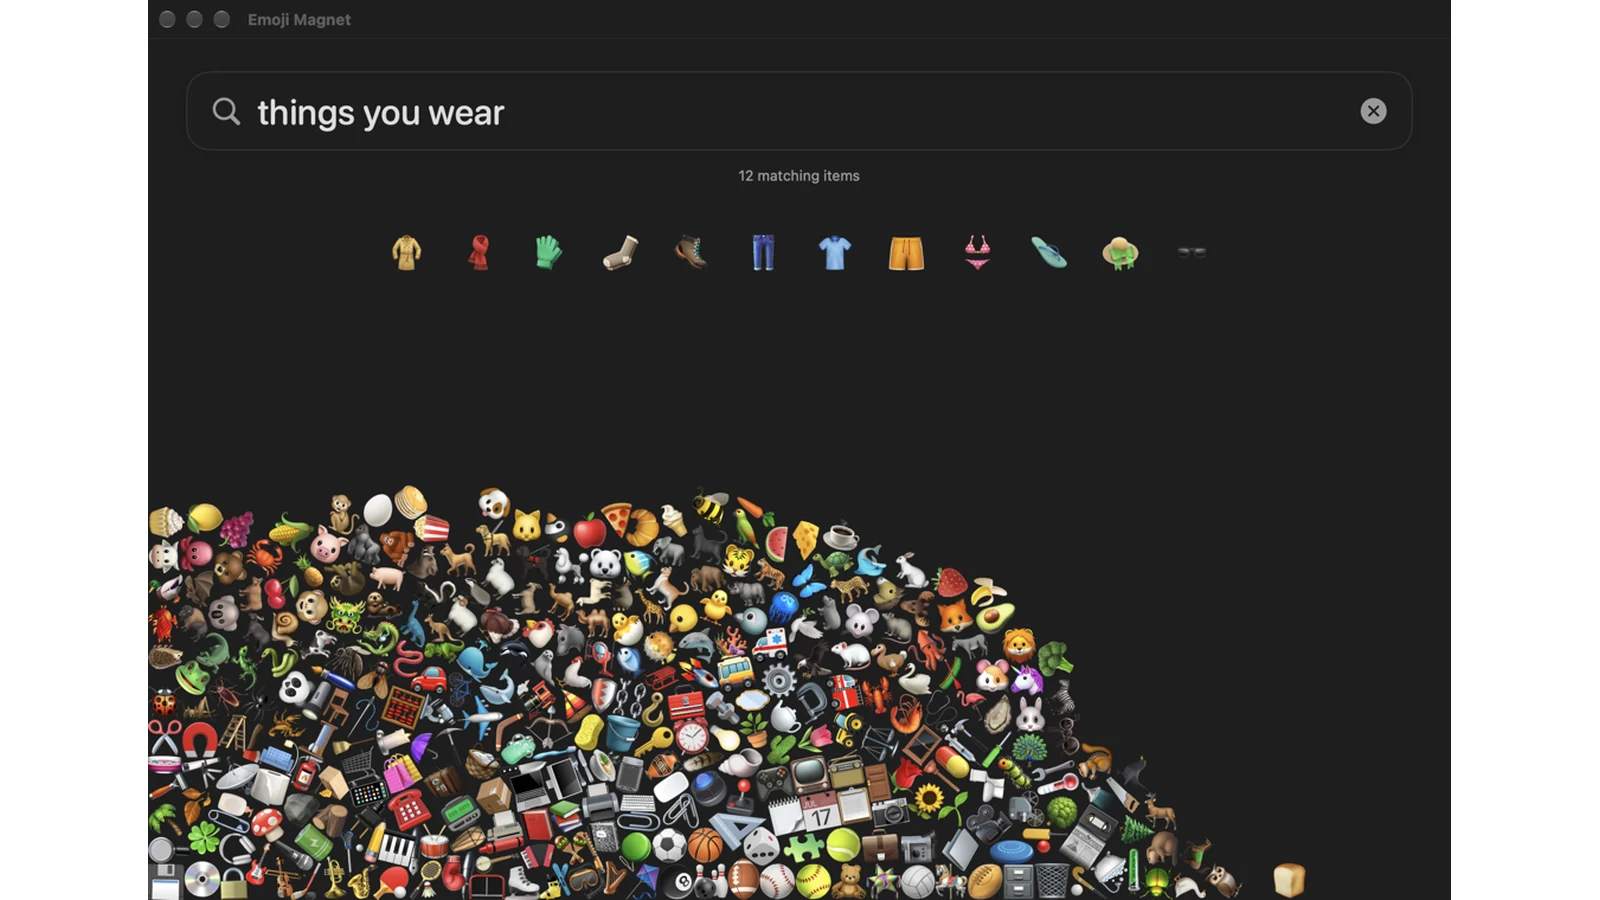 O aplicativo de exemplo Emoji Magnet de Mattt usa AnyDecisionModel para ordenar emojis. Captura da documentação fornecida pelo autor, Apache 2.0; redimensionada com margens. Fonte da imagem · Licença e notas da imagem.
Transcrição e encaminhamento precisam de testes de aceitação separados
Imagine alguém dizendo: “A fatura está errada e não consigo entrar para baixá-la”. A transcrição pode reproduzir a frase corretamente e a política de encaminhamento ainda falhar. A empresa envia à cobrança por causa da fatura, ao suporte técnico pelo problema de acesso ou a uma fila geral porque há os dois?
A resposta depende da política do serviço. Um modelo não fornece uma regra de responsabilidade ausente apenas retornando um rótulo com forte preferência. Antes de avaliar qualquer backend, escreva o significado de cada opção e o que deve acontecer quando várias se aplicarem. Isso dá ao app um alvo mais útil que “a saída parecia sensata”.
Separar as etapas também facilita diagnosticar erros. Se o reconhecedor muda o nome do produto, preserve a transcrição e confira se a decisão mudaria com as palavras corretas. Se a transcrição estiver correta e a equipe escolhida errada, examine as definições das opções e o modelo de decisão. São reparos diferentes, e combiná-los esconde a origem da falha.
Nossa avaliação é que a abstração mais valiosa aqui é uma fronteira entre ouvir e escolher. Cada etapa deve produzir um artefato verificável pela seguinte. A equipe de produto pode decidir quais etapas merecem execução automática e quais devem continuar como sugestões para uma pessoa.
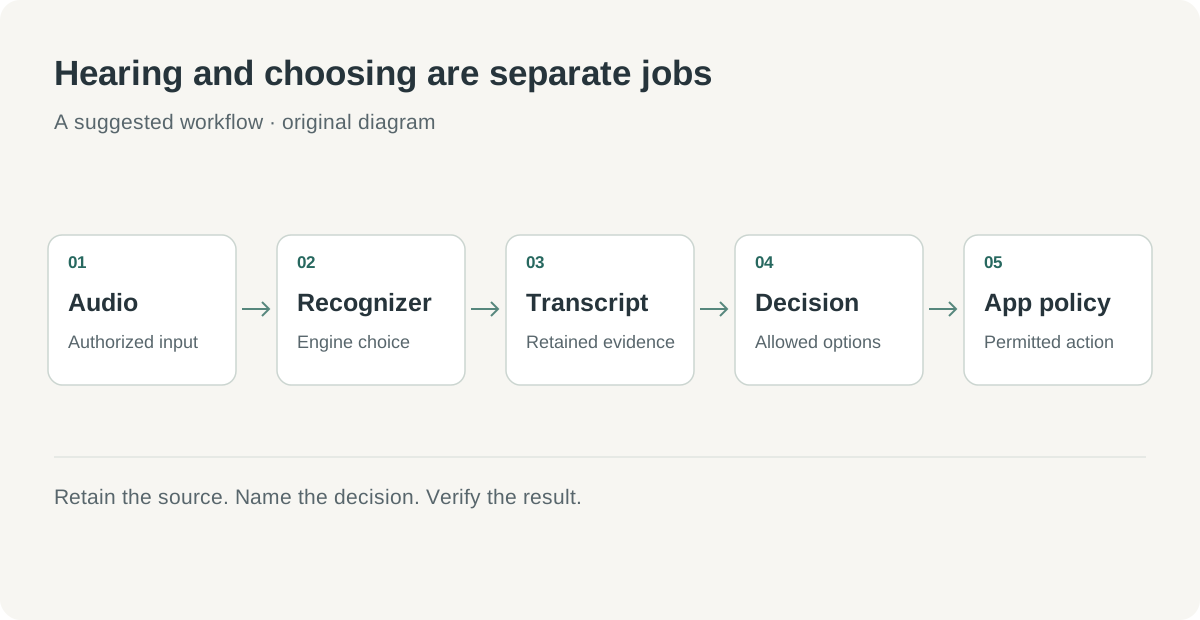 Diagrama original: o reconhecimento fornece evidência; uma decisão delimitada fornece uma distribuição; a aplicação decide qual ação é permitida.
A escolha do motor importa quando o áudio do aplicativo muda
O README do AnySpeechRecognizer, consultado em 2 de novembro, descreve uma API inspirada no framework Speech moderno da Apple, com opções Apple, Parakeet e Qwen3-ASR. As capacidades diferem: a comparação publicada indica resultados provisórios ao vivo e tempos por palavra em alguns caminhos; Qwen3-ASR fornece resultados por segmento sem tempos por palavra. O pacote exige Swift 6.2 ou posterior e macOS ou iOS 26 ou posterior, com requisitos adicionais de hardware para certos modelos.
A diferença aparece no projeto do produto. Legendas ao vivo se beneficiam de texto antes de o falante terminar, mas precisam mostrar que palavras provisórias podem mudar. Um fluxo de importação de arquivos pode priorizar resultados finais e deixar o usuário aguardar o processamento. A mesma tela não deve fingir que ambos têm comportamento temporal idêntico.
Em um aplicativo ilustrativo de entrevistas, tempos por palavra podem ser essenciais porque tocar uma frase deve levar ao trecho da gravação. Em uma caixa de mensagens de voz ilustrativa, uma transcrição por segmento pode bastar para revisar mensagens curtas. Escolha o motor depois de definir a interação e teste idioma, sotaques e condições de gravação reais do público.
O suporte a idiomas merece o mesmo tratamento. Uma lista de idiomas é uma verificação de elegibilidade; uma gravação ruidosa de cliente é um teste de aceitação. Mantenha o áudio original disponível aos revisores autorizados e ofereça correção de nomes e números importantes. Essas correções ajudam a decidir se o reconhecedor precisa de outra configuração ou o produto precisa de uma recuperação melhor.
O pacote também deixa a captura de áudio com a aplicação. É uma divisão útil: o app continua responsável pela permissão de gravação, seleção da fonte e ciclo de vida da captura. Uma biblioteca de reconhecimento não deve ser confundida com um recurso completo de gravação, especialmente ao lidar com interrupções, cancelamento e usuários que param antes do fim.
Decisões tipadas reduzem a interpretação de texto, não a responsabilidade
O README do AnyDecisionModel, consultado em 2 de novembro, documenta probabilidades binárias, escolhas entre opções permitidas e notas em escalas ordenadas. Oferece caminhos locais MLX, Core AI e llama.cpp, além de backends Jev e Ollama. A API retorna resultados estruturados sem exigir que a aplicação recupere um rótulo de um parágrafo explicativo.
Isso pode simplificar muito um aplicativo. Quando o resultado permitido é um departamento, o código pode tratar cada departamento explicitamente. Quando a pergunta é se uma mensagem precisa de revisão, o resultado alimenta uma política com esse estado. O app ainda precisa definir o significado da revisão e quem responde pela fila.
Um app ilustrativo de relatos de manutenção esclarece a distinção. O trabalhador grava uma descrição, o reconhecedor produz texto e a camada de decisão sugere uma categoria de equipamento. O app pode exibir a sugestão ao lado da transcrição antes de salvar. Não deve transformar silenciosamente uma categoria sugerida em uma determinação de segurança, ordem de reparo ou permissão para operar o equipamento.
Notas ordenadas precisam de definições igualmente concretas. Se a equipe pede urgência em três níveis, cada um deve descrever uma ação ou expectativa de serviço. “Baixa”, “média” e “alta” são fáceis de exibir, mas difíceis de avaliar se cada revisor interpretar de maneira diferente. Uma rubrica curta torna os desacordos visíveis antes de virarem problemas de treinamento ou limiares.
| Abordagem | O que a aplicação recebe | Útil quando | Pergunta principal de avaliação |
|---|---|---|---|
| Geração aberta | Texto que pode incluir justificativa | O usuário precisa de explicação ou rascunho | O conteúdo está correto e é utilizável? |
| Escolha delimitada | Opção permitida selecionada e distribuição | O app tem categorias definidas | A escolha segue a política das categorias? |
| Nota ordenada | Distribuição entre níveis definidos | O app tem uma rubrica significativa de classificação | Os níveis correspondem à ação pretendida? |
| Revisão humana | Decisão registrada de uma pessoa | Falta contexto ou as consequências exigem julgamento | O revisor recebe evidência suficiente? |
A comparação trata de interfaces, não afirma que uma técnica sempre vence. Algumas telas precisam de uma escolha delimitada e de uma explicação concisa. Distinga explicação e evidência e permita editar a decisão quando o processo autorizar.
Confiança descreve uma distribuição, não garante acurácia
O README do AnyDecisionModel faz uma distinção especialmente útil: a confiança local mede a concentração da distribuição de respostas, não a probabilidade de a resposta selecionada estar correta. Também alerta contra comparar valores de backends diferentes como se usassem uma única fórmula. A calibração deve ser ajustada separadamente dos dados de avaliação. Documentação do projeto, consultada em 2 de novembro de 2026.
Suponha que um teste ilustrativo retorne um departamento com probabilidade 0.90 e distribua o restante pelos outros. Isso diz que o modelo favoreceu aquele departamento com a pergunta e as opções recebidas. Não estabelece um histórico de 90% de acertos nesse tipo de mensagem. As categorias podem ser ruins, a entrada pode omitir contexto essencial ou o modelo pode preferir sistematicamente uma opção.
Uma política útil precisa, portanto, de um caminho explícito de “reter para revisão”. Comece mostrando todas as decisões aos revisores e coletando correções. Depois avalie se algum subconjunto é confiável para uma ação automática bem delimitada. O limiar resulta dos erros observados e de seu custo, não de um número escolhido por parecer confiante.
O conjunto de avaliação deve conter mensagens ambíguas, nomes desconhecidos e casos em que nenhum departamento se ajusta bem. O sistema pode parecer forte quando cada exemplo cabe em uma categoria clara e falhar nos pedidos mistos do atendimento real. Peça aos revisores que registrem por que mudaram uma escolha para distinguir resposta ruim do modelo de política ausente.
Examine também o custo de cada direção do erro. Enviar uma solicitação rotineira à revisão consome tempo; encaminhar silenciosamente uma solicitação sensível ao público errado pode ter outra consequência. Uma média única esconde isso. Relate os casos importantes aos responsáveis pelo produto e escolha uma política que possam explicar a usuários e mantenedores.
É também por isso que trocar backends é uma mudança de produto. A mesma chamada Swift pode esconder comportamento, semântica numérica e dependências operacionais diferentes. Repita a avaliação antes de levar um limiar antigo à configuração nova. Guarde identificador, configuração e definições das opções com o resultado para explicar depois como a decisão foi produzida.
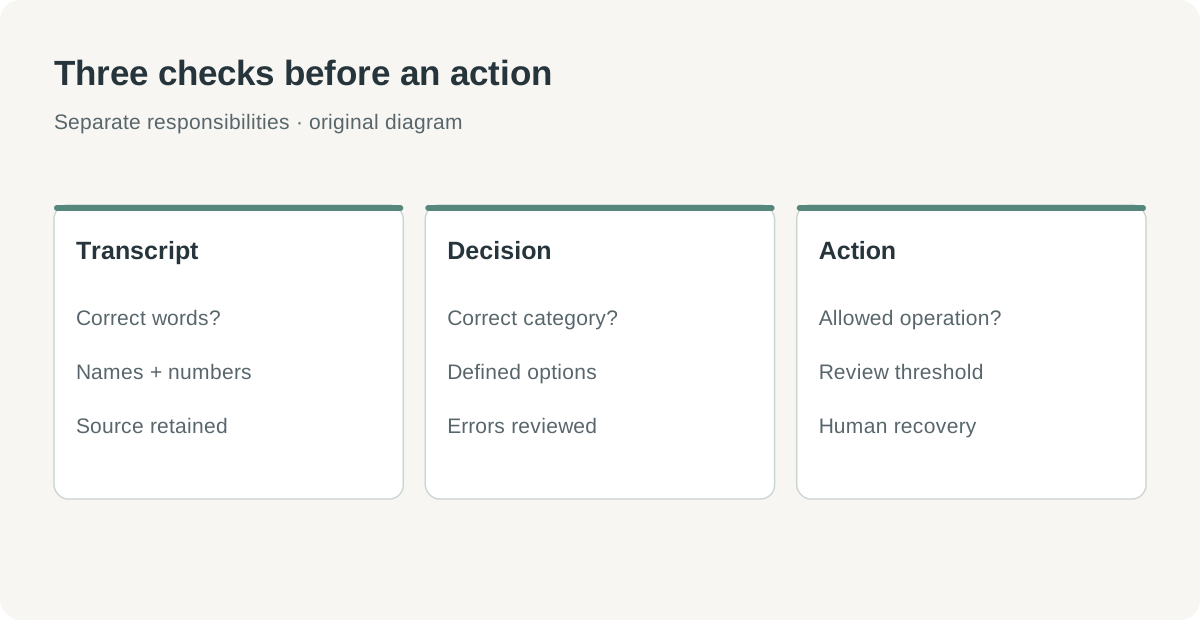 Diagrama original: uma preferência forte não elimina a necessidade de avaliar correção ou definir política de ação. Confiança e acurácia respondem a perguntas diferentes.
A operação local muda o trabalho assumido pela equipe
Executar um modelo no dispositivo pode atrair em uma caixa de voz ou ferramenta de referência offline. A equipe pode projetar entradas retidas localmente e uma fronteira previsível de rede. Mas downloads de modelos, hardware suportado, memória e preparação inicial tornam-se partes visíveis da experiência. Uma promessa de privacidade deve descrever todo o caminho, inclusive qualquer etapa hospedada acrescentada depois.
Um backend hospedado transfere parte da operação ao serviço, mas introduz rede, credenciais e disponibilidade no fluxo. O usuário precisa de um estado compreensível quando a solicitação falha ou continua pendente. Repetir deve preservar a transcrição original e não executar novamente por acidente uma ação posterior já concluída.
A documentação atual também distingue compatibilidade testada de verificação de serviço real. O AnyDecisionModel informa que os testes de compatibilidade de comunicação com Jev e Ollama usam fixtures. Essa cobertura é valiosa, mas uma aplicação entregue ainda deve verificar de ponta a ponta a configuração do serviço escolhido. README do AnyDecisionModel, consulta de 2 de novembro.
Evite prometer desempenho igual entre um Mac de desenvolvimento e o menor celular suportado. Um alvo de implantação indica onde se pretende executar o código; não fornece evidência de latência, bateria ou memória para cada dispositivo. O app pode começar processando arquivos em uma máquina qualificada e ampliar o suporte quando a interação pretendida passar em hardware adicional.
Comece com um processo de arquivos que possa ser revisado
Um primeiro piloto deve facilitar examinar erros. Uma aplicação pequena baseada em arquivos costuma ser um começo mais claro que um assistente ao vivo, pois o mesmo áudio autorizado pode ser reproduzido e comparado. O objetivo é provar etapas e transferências antes de acrescentar interação em tempo real.
- Defina uma tarefa com poucas decisões permitidas e uma regra escrita para casos ambíguos. Inclua uma opção de revisão na política.
- Confira os requisitos atuais e adicione a dependência Swift relevante. Escolha um motor de reconhecimento e um backend de decisão, sem qualificar todas as combinações de uma vez.
- Importe um conjunto pequeno de gravações autorizadas. Guarde originais, transcrições esperadas e decisões dos revisores em registros separados.
- Instale ou prepare explicitamente os modelos necessários conforme a documentação. Mostre preparação e processamento como estados distintos da interface.
- Execute o reconhecimento, preserve o texto final e faça perguntas delimitadas sobre ele. Exiba o resultado ao lado da fonte em vez de agir externamente de imediato.
- Revise erros por etapa e avalie outro conjunto de gravações depois das mudanças. Registre a configuração com cada resultado.
- Acrescente comportamentos de cancelamento, modelo indisponível e falha de rede antes de ampliar para captura ao vivo ou encaminhamento automático.
O critério de sucesso deve ser compreensível para um responsável pelo produto. Por exemplo, o piloto de caixa de voz pode exigir que o revisor encontre a gravação, corrija a transcrição e mude a fila sugerida sem perder o material original. É um resultado útil de processo antes mesmo de decidir automatizar algo.
Decisões pequenas ainda merecem um projeto completo de produto
Os pacotes fazem uma proposta arquitetural atraente: um componente ouve, outro escolhe e o código da aplicação aplica a ação permitida. Isso cria pontos para medir qualidade e recuperar falhas. Também facilita discutir os limites de uma resposta numérica com quem precisa confiar nela.
A expectativa a testar é a manutenção. A equipe consegue trocar o reconhecedor sem reescrever o app inteiro? Avaliar um novo backend sem fingir que os limiares antigos ainda valem? Os usuários conseguem corrigir o resultado no ponto em que o erro ocorreu?
Um modelo pequeno se torna útil quando o trabalho é claro e a saída tem um responsável. A abstração Swift conecta as partes; a política de decisão do produto lhes dá uma finalidade.
Fontes
- Mattt: apresentação de AnySpeechRecognizer e AnyDecisionModel, 29 de outubro de 2026.
- AnySpeechRecognizer: requisitos, comparação de motores e exemplos, consultado em 2 de novembro de 2026.
- AnyDecisionModel: backends, calibração e limitações, consultado em 2 de novembro de 2026. Licenças do código dos pacotes e dos modelos individuais exigem análise separada.
- Mattt: documentação e captura do Emoji Magnet, documentação Apache-2.0; consultada em 2 de novembro de 2026.
Mantenha uma decisão de implementação conectada à fonte
O Telli.sh é uma opção para guardar fontes autorizadas e as notas por trás de uma decisão de implementação. Criar um espaço de notas.