AnyDecisionModel und AnySpeechRecognizer trennen Zuhören und Entscheiden in Swift-Apps
Zwei Swift-Pakete von Drittanbietern verbinden Spracherkennung und typisierte Entscheidungen. Wo lokale Inferenz hilft, warum Konfidenz Kalibrierung braucht und wie ein begrenzter Pilot beginnt.
Eine Supportaufnahme enthält zwei verschiedene Probleme. Zunächst muss eine Anwendung erkennen, was der Anrufer sagte. Dann muss sie entscheiden, ob die Anfrage zu Abrechnung, Technik oder einem anderen Team gehört. Beides als ein offenes Gespräch zu behandeln macht die Verantwortung der App schwerer erkennbar.
Entwickler Mattt stellte AnySpeechRecognizer und AnyDecisionModel am 29. Oktober 2026 vor. Es sind Swift-Pakete eines Drittanbieters für Entwickler auf Apple-Plattformen: eines bietet verschiedene Spracherkennungsengines, das andere typisierte Auswahlentscheidungen und Wahrscheinlichkeitsverteilungen. Sie greifen vertraute Swift-Muster auf und sind keine Apple-Produktankündigungen. Mattts Einführung erklärt die beiden Aufgaben am selben Supportanruf.
Interessant ist die Möglichkeit, diese Aufgaben getrennt auszuwählen und zu bewerten. Dieser Leitfaden erklärt den Beitrag der Pakete, den Einfluss lokaler und gehosteter Backends auf das Appdesign und warum ein numerischer Konfidenzwert weiterhin eine Produktrichtlinie benötigt.
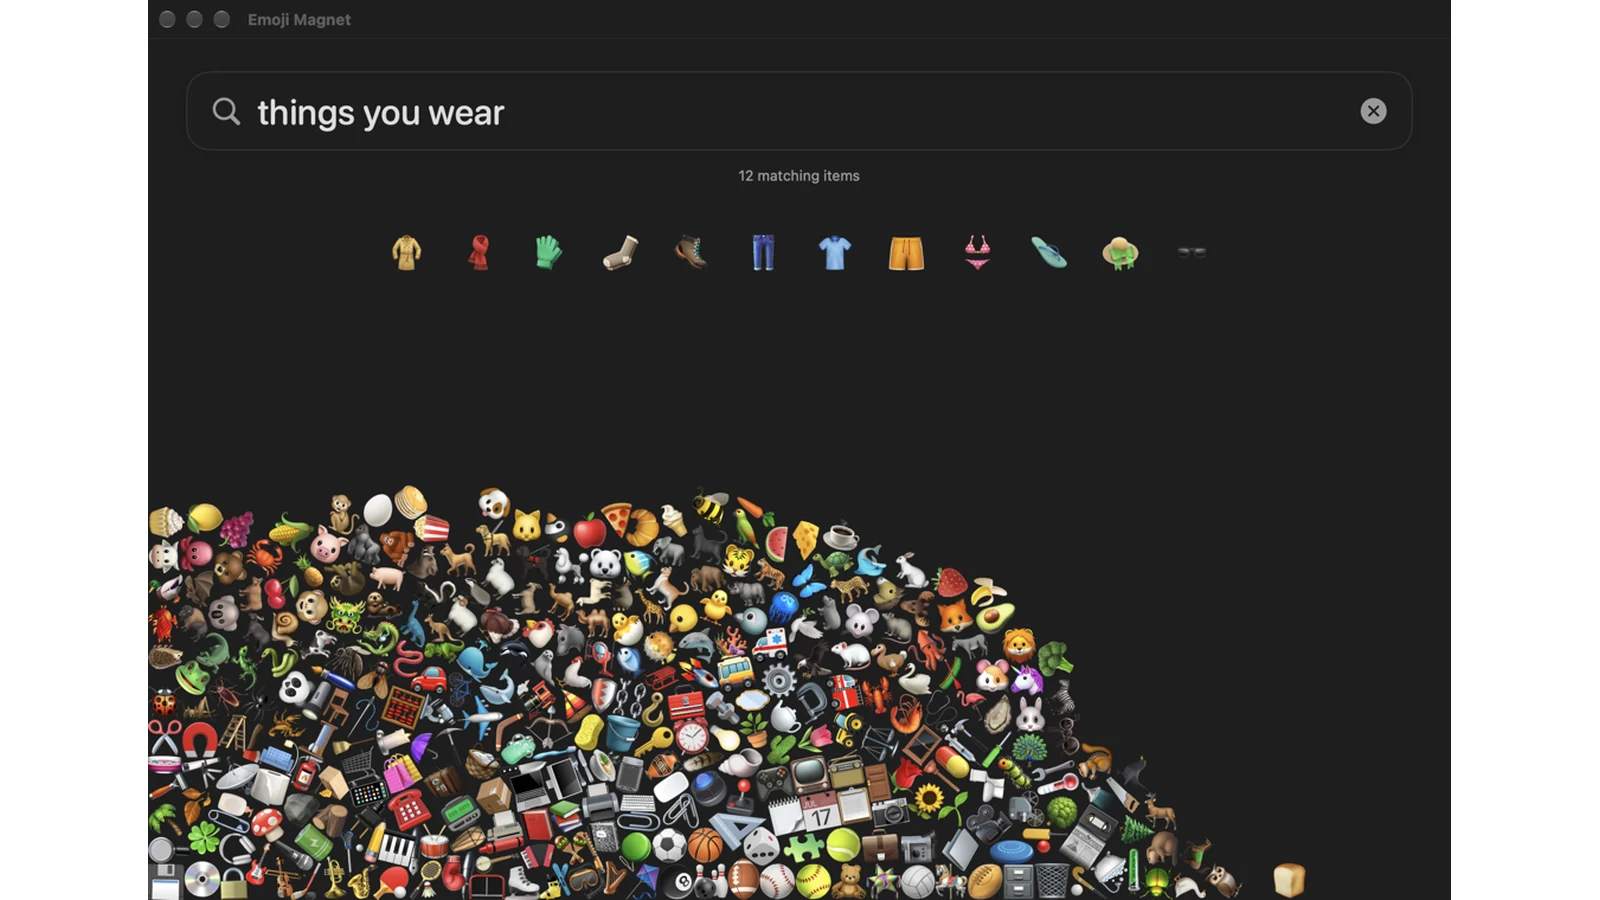 Mattts Beispielapp Emoji Magnet verwendet AnyDecisionModel zum Sortieren von Emojis. Vom Autor bereitgestellter Dokumentationsscreenshot, Apache 2.0; mit Rändern skaliert. Bildquelle · Lizenz und Bildhinweise.
Transkript und Zuordnungsentscheidung brauchen getrennte Abnahmetests
Ein Anrufer sagt etwa: „Die Rechnung ist falsch, und ich kann mich nicht anmelden, um sie herunterzuladen.“ Ein Transkript kann den Satz korrekt wiedergeben, während die Zuordnungsregel versagt. Geht die Anfrage wegen der Rechnung zur Abrechnung, wegen der Anmeldung zur Technik oder wegen beider Aspekte in eine allgemeine Warteschlange?
Die Antwort hängt von der Dienstrichtlinie ab. Ein Modell ersetzt keine fehlende Zuständigkeitsregel, indem es ein Label stark bevorzugt. Schreiben Sie vor jeder Backendbewertung auf, was jede erlaubte Option bedeutet und was bei mehreren passenden Optionen geschieht. Das gibt der App ein besseres Ziel als „die Ausgabe wirkte sinnvoll“.
Getrennte Stufen erleichtern auch die Fehlerdiagnose. Verändert der Erkenner einen Produktnamen, bewahren Sie das Transkript auf und prüfen Sie die Entscheidung mit den korrekten Worten. Ist das Transkript richtig, aber das Team falsch, untersuchen Sie Auswahlbeschreibungen und Entscheidungsmodell. Das sind unterschiedliche Reparaturen; zusammengefasst verdecken sie die Fehlerquelle.
Unsere Einschätzung: Die wertvollste Abstraktion ist hier die Grenze zwischen Hören und Wählen. Jede Stufe sollte ein Ergebnis liefern, das die nächste prüfen kann. Das Produktteam entscheidet dann, welche Stufen automatisch ausgeführt und welche nur als menschliche Vorschläge behandelt werden.
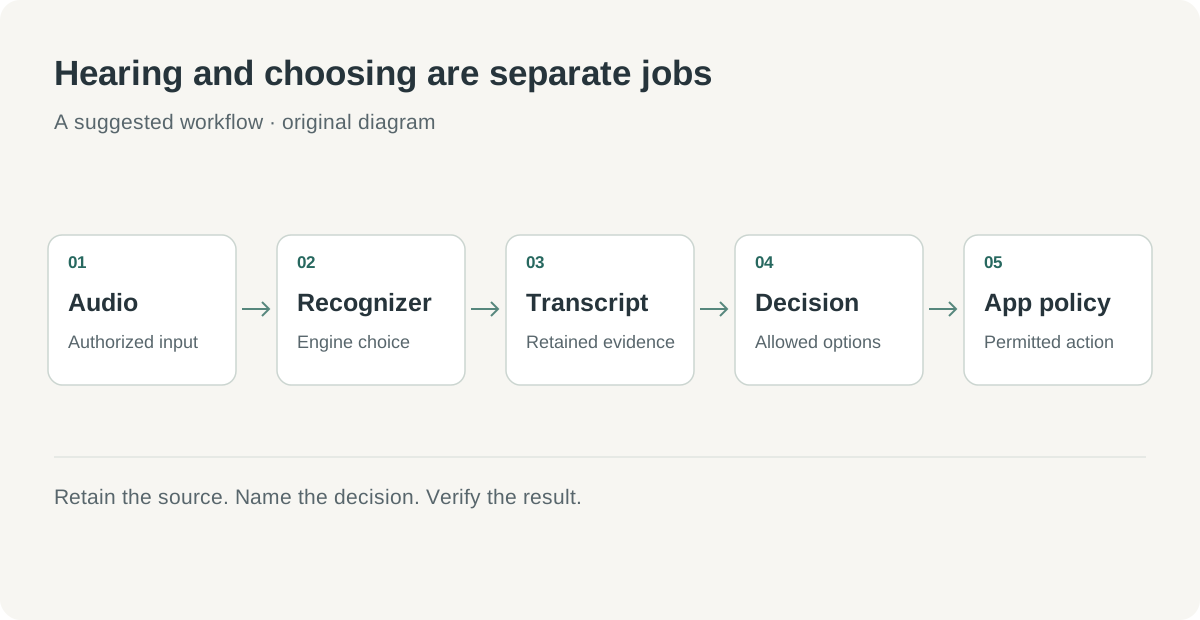 Eigene Ablaufgrafik: Erkennung liefert Belege, eine begrenzte Entscheidung eine Verteilung, und die Anwendung bestimmt die erlaubte Aktion.
Die Enginewahl zählt, wenn sich das Audio der App verändert
Die am 2. November geprüfte README von AnySpeechRecognizer beschreibt eine an Apples modernem Speech-Framework orientierte API mit Apple-, Parakeet- und Qwen3-ASR-Optionen. Die Fähigkeiten unterscheiden sich: Der Vergleich nennt für manche Wege vorläufige Liveergebnisse und Wortzeitmarken; Qwen3-ASR liefert Segmente ohne Wortzeitmarken. Das Paket erwartet Swift 6.2 oder neuer und macOS oder iOS 26 oder neuer; einzelne Modelle haben zusätzliche Hardwareanforderungen.
Dieser Unterschied wird im Produktdesign sichtbar. Liveuntertitel profitieren von Text vor dem Satzende, müssen aber die Veränderlichkeit vorläufiger Wörter zeigen. Ein Dateiimport kann Endergebnisse priorisieren und Nutzer auf die vollständige Verarbeitung warten lassen. Dieselbe Transkriptansicht sollte nicht identisches Zeitverhalten beider Modi vortäuschen.
Für eine beispielhafte Interviewapp können Wortzeitmarken unverzichtbar sein, damit Antippen eines Satzes die passende Aufnahmeposition öffnet. Für eine beispielhafte Sprachnachrichtenablage reicht möglicherweise Segmenttext, weil die Hauptaufgabe die Prüfung kurzer Nachrichten ist. Definieren Sie zuerst die Interaktion und wählen Sie dann die Engine; testen Sie tatsächliche Sprachen, Akzente und Aufnahmebedingungen.
Sprachunterstützung verdient dieselbe Behandlung. Eine Sprachliste ist eine Eignungsprüfung; eine verrauschte Kundenaufnahme ist ein Abnahmetest. Halten Sie Originalaudio für autorisierte Prüfer verfügbar und ermöglichen Sie die Korrektur wichtiger Namen und Zahlen. Solche Korrekturen zeigen, ob eine andere Erkennerkonfiguration oder eine bessere Korrekturinteraktion nötig ist.
Das Paket überlässt die Audioaufnahme der Anwendung. Diese Zuständigkeitsgrenze ist sinnvoll: Die App verantwortet Aufnahmeberechtigung, Quellwahl und Aufnahmelebenszyklus. Eine Erkennungsbibliothek ist keine vollständige Aufnahmefunktion, besonders wenn die Oberfläche Unterbrechung, Abbruch und vorzeitiges Stoppen behandeln muss.
Typisierte Entscheidungen verringern Parsingarbeit, nicht Verantwortung
Die am 2. November geprüfte README von AnyDecisionModel dokumentiert binäre Wahrscheinlichkeiten, Auswahl aus erlaubten Optionen und Werte auf geordneten Skalen. Sie bietet lokale Wege über MLX, Core AI und llama.cpp sowie Jev- und Ollama-Backends. Die API liefert strukturierte Ergebnisse, statt ein Label aus einem erklärenden Absatz herauslösen zu lassen.
Das kann eine App deutlich vereinfachen. Ist das erlaubte Ergebnis eine Abteilung, kann der Code jede ausdrücklich behandeln. Geht es um Prüfbedarf einer Nachricht, kann das Ergebnis eine Richtlinie mit Prüfzustand speisen. Die App muss weiterhin „Prüfung“ und Warteschlangenverantwortung definieren.
Eine beispielhafte Wartungsmeldeapp macht das deutlich. Ein Beschäftigter nimmt eine Beschreibung auf, die Erkennung erzeugt Text, und die Entscheidungsschicht schlägt eine Gerätekategorie vor. Die Anwendung kann den Vorschlag vor dem Speichern neben dem Transkript zeigen. Sie sollte ihn nicht still in eine Sicherheitsbewertung, einen Reparaturauftrag oder eine Betriebserlaubnis verwandeln.
Geordnete Werte brauchen ebenso konkrete Definitionen. Bei einer dreistufigen Dringlichkeit sollte jede Stufe eine Aktion oder Serviceerwartung beschreiben. „Niedrig“, „mittel“ und „hoch“ sind leicht anzuzeigen, aber schwer zu bewerten, wenn Prüfer sie unterschiedlich verstehen. Eine kurze Bewertungsregel zeigt Unterschiede, bevor daraus Trainings- oder Schwellenprobleme werden.
| Ansatz | Was die Anwendung erhält | Nützlich, wenn | Zentrale Bewertungsfrage |
|---|---|---|---|
| Offene Generierung | Text mit möglicher Begründung | Nutzer Erklärung oder Entwurf brauchen | Ist der Inhalt richtig und nutzbar? |
| Begrenzte Auswahl | Gewählte erlaubte Option und Verteilung | Die App definierte Kategorien hat | Entspricht die Wahl der Kategorierichtlinie? |
| Geordneter Wert | Verteilung über definierte Stufen | Eine sinnvolle Bewertungsordnung besteht | Passen die Stufen zur beabsichtigten Aktion? |
| Menschliche Prüfung | Dokumentierte menschliche Entscheidung | Kontext fehlt oder Folgen Urteil verlangen | Erhält der Prüfer genügend Belege? |
Der Vergleich betrifft Schnittstellendesign, nicht den universellen Sieg einer Technik. Manche Ansichten brauchen begrenzte Auswahl und kurze Erklärung. Halten Sie Erklärung und Belege unterscheidbar und die Entscheidung editierbar, wo der Ablauf es erlaubt.
Konfidenz beschreibt eine Verteilung, keine Genauigkeitsgarantie
Die README von AnyDecisionModel macht eine besonders nützliche Unterscheidung: Lokale Konfidenz misst die Konzentration der Antwortverteilung, nicht die Wahrscheinlichkeit einer richtigen Auswahl. Sie warnt auch vor Vergleichen verschiedener Backends, als nutzten deren Werte dieselbe Formel. Kalibrierung sollte getrennt von Bewertungsdaten angepasst werden. Projektdokumentation, geprüft am 2. November 2026.
Ein beispielhafter Test könnte einer Abteilung 0.90 Wahrscheinlichkeit geben und den Rest verteilen. Das sagt, dass das Modell diese Abteilung unter Frage und Optionen bevorzugte. Es belegt keine historische Erfolgsquote von 90% für solche Kundennachrichten. Kategorien können schlecht definiert sein, entscheidender Kontext fehlen oder eine systematische Präferenz bestehen.
Eine brauchbare Produktrichtlinie braucht deshalb einen ausdrücklichen Pfad „zur Prüfung zurückhalten“. Machen Sie anfangs alle Entscheidungen für Prüfer sichtbar und sammeln Sie Korrekturen. Bewerten Sie danach, ob eine Teilmenge für eine eng definierte automatische Aktion verlässlich genug ist. Die Schwelle folgt beobachteten Fehlern und ihren Kosten, nicht einer selbstsicher wirkenden Zahl.
Das Bewertungsset sollte mehrdeutige Nachrichten, unbekannte Namen und Fälle ohne passende Abteilung enthalten. Ein System kann bei sauber trennbaren Beispielen stark wirken und an gemischten realen Supportanfragen scheitern. Lassen Sie Prüfer Änderungsgründe festhalten, um schlechte Modellantworten von fehlenden Richtlinien zu trennen.
Untersuchen Sie auch beide Fehlerrichtungen. Eine Routineanfrage zur Prüfung zu schicken kostet Zeit; eine sensible Anfrage unbemerkt an falsche Empfänger zu leiten kann andere Folgen haben. Ein Durchschnittswert verbirgt das. Berichten Sie verantwortungsrelevante Fälle und wählen Sie eine erklärbare Aktionsrichtlinie für Nutzer und Maintainer.
Deshalb ist auch ein Backendwechsel eine Produktänderung. Derselbe Swift-Aufruf kann anderes Verhalten, andere Zahlenbedeutung und Betriebsabhängigkeiten verbergen. Wiederholen Sie die Bewertung, bevor Sie alte Schwellen übernehmen. Bewahren Sie Modellkennung, Konfiguration und Optionsdefinitionen beim Ergebnis auf, damit die Entscheidung später erklärbar bleibt.
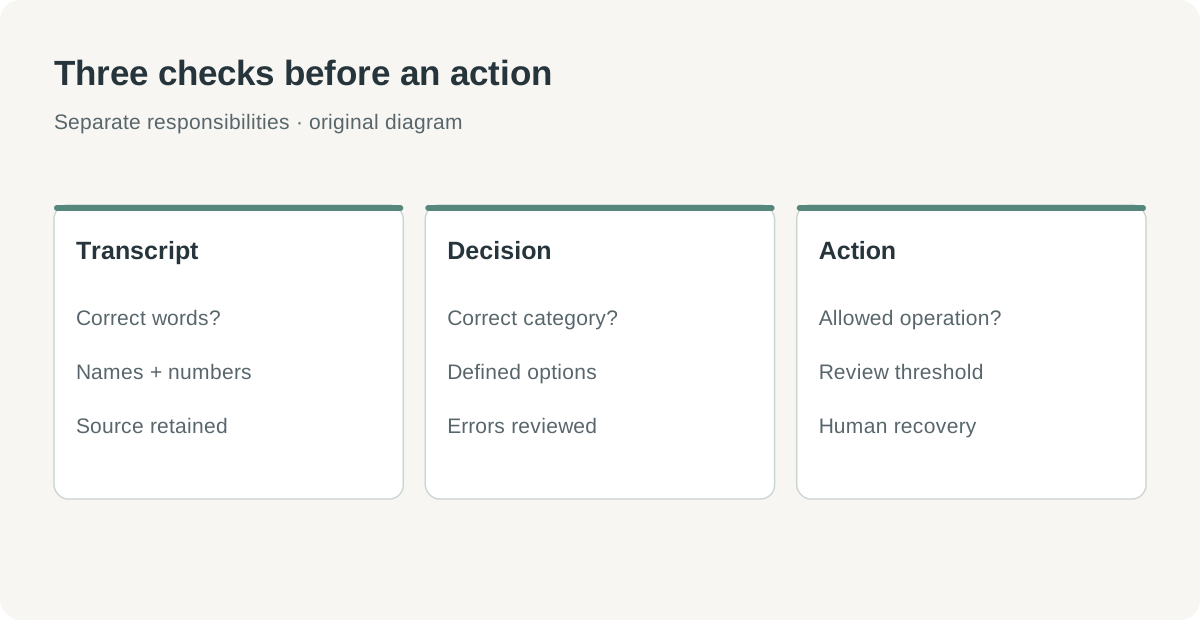 Eigene Grafik: Eine starke Präferenz beseitigt weder die Richtigkeitsprüfung noch die Notwendigkeit einer Aktionsrichtlinie. Konfidenz und Genauigkeit beantworten unterschiedliche Fragen.
Lokaler Betrieb verändert die Teamverantwortung
Ein Modell auf dem Gerät kann für Sprachnachrichten oder Offline-Nachschlagewerke attraktiv sein. Das Team kann lokal gespeicherte Eingaben und eine vorhersehbare Netzwerkgrenze gestalten. Modelldownloads, Hardwareunterstützung, Speicher und Ersteinrichtung werden aber sichtbare Teile der Nutzererfahrung. Ein Datenschutzversprechen sollte den ganzen Pfad einschließlich später ergänzter gehosteter Stufen beschreiben.
Ein gehostetes Entscheidungsbackend verlagert Betriebsarbeit zum Dienst und bringt Netzwerkverhalten, Zugangsdaten und Verfügbarkeit in den Ablauf. Nutzer brauchen einen verständlichen Zustand bei Fehler oder ausstehender Anfrage. Wiederholungen sollten das Originaltranskript erhalten und keine bereits abgeschlossene Folgeaktion versehentlich wiederholen.
Die aktuelle Dokumentation unterscheidet zudem getestete Kompatibilität von Liveverifikation eines Dienstes. Laut AnyDecisionModel verwenden Jev- und Ollama-Kompatibilitätstests Fixtures. Das ist wertvolle Abdeckung; eine ausgelieferte App sollte ihre gewählte Dienstkonfiguration trotzdem durchgängig prüfen. AnyDecisionModel-README, geprüft am 2. November.
Versprechen Sie nicht identische Leistung auf Entwickler-Mac und kleinstem unterstützten Telefon. Ein Bereitstellungsziel benennt vorgesehene Geräte und liefert keine Latenz-, Akku- oder Speicherbelege für jedes. Eine App kann mit Dateiverarbeitung auf einem qualifizierten Rechner beginnen und nach bestandener Interaktionsprüfung auf weitere Hardware ausweiten.
Beginnen Sie mit einem prüfbaren Dateiablauf
Ein erster Pilot sollte Fehler leicht untersuchbar machen. Eine kleine dateibasierte Anwendung ist oft klarer als ein Liveassistent, weil dasselbe autorisierte Audio erneut abgespielt und verglichen werden kann. Zuerst sollen Stufen und Übergabe funktionieren, erst danach Echtzeitinteraktion.
- Definieren Sie eine Aufgabe mit wenigen erlaubten Entscheidungen und schriftlicher Mehrdeutigkeitsregel. Die Anwendungsrichtlinie soll eine Prüfoption enthalten.
- Prüfen Sie aktuelle Paketanforderungen und fügen Sie die passende Swift-Abhängigkeit hinzu. Wählen Sie zunächst eine Erkennungsengine und ein Entscheidungsbackend statt aller Kombinationen.
- Importieren Sie wenige autorisierte Aufnahmen. Bewahren Sie Originaldateien, erwartete Transkripte und Prüferentscheidungen getrennt auf.
- Installieren oder stellen Sie Modellassets ausdrücklich nach Dokumentation bereit. Zeigen Sie Vorbereitung und Verarbeitung als getrennte Zustände.
- Führen Sie Erkennung aus, behalten Sie den Endtext und stellen Sie dazu begrenzte Fragen. Zeigen Sie Ergebnis und Quelle nebeneinander, statt sofort extern zu handeln.
- Prüfen Sie Fehler pro Stufe und bewerten Sie nach Änderungen ein separates Aufnahmeset. Dokumentieren Sie jede Ergebniskonfiguration.
- Ergänzen Sie Abbruch, fehlendes Modell und Netzwerkfehler, bevor Sie Liveaufnahme oder automatische Zuordnung hinzufügen.
Das Erfolgskriterium sollte für Produktverantwortliche verständlich sein. Eine Sprachnachrichtenablage könnte etwa verlangen, dass ein Prüfer Quelle findet, Transkript korrigiert und vorgeschlagene Warteschlange ändert, ohne Originalmaterial zu verlieren. Das ist ein nützliches Ablaufergebnis, noch bevor über Automation entschieden wird.
Auch kleine Entscheidungen brauchen vollständiges Produktdesign
Die Pakete bieten eine attraktive Architektur: eine Komponente hört, eine andere wählt, Anwendungscode erzwingt die erlaubte Aktion. Das schafft Stellen zum Messen und zur Fehlerbehebung. Zugleich lassen sich Grenzen numerischer Antworten leichter mit den Menschen besprechen, die ihnen vertrauen müssen.
Die prüfenswerte Erwartung ist Wartbarkeit. Kann ein Team den Erkenner ohne kompletten Appumbau wechseln? Kann es ein neues Entscheidungsbackend bewerten, ohne alte Schwellen als unverändert gültig auszugeben? Können Nutzer dort korrigieren, wo der Fehler tatsächlich entstand?
Ein kleines Modell wird nützlich, wenn Aufgabe und Ergebnisverantwortung klar sind. Die Swift-Abstraktion verbindet Teile; die Entscheidungsrichtlinie des Produkts gibt ihnen einen Zweck.
Quellen
- Mattt: Einführung von AnySpeechRecognizer und AnyDecisionModel, 29. Oktober 2026.
- AnySpeechRecognizer: Anforderungen, Enginevergleich und Beispiele, geprüft am 2. November 2026.
- AnyDecisionModel: Backends, Kalibrierung und Grenzen, geprüft am 2. November 2026. Paketcode- und einzelne Modelllizenzen sind getrennt zu betrachten.
- Mattt: Emoji-Magnet-Dokumentation und Screenshot, Apache-2.0-Dokumentation; geprüft am 2. November 2026.
Verbinden Sie Implementierungsentscheidungen mit ihren Quellen
Telli.sh ist eine Möglichkeit, autorisiertes Quellenmaterial und die Notizen hinter einer Implementierungsentscheidung aufzubewahren. Notizbereich anlegen.