Strata e Qwen3.8-Flash-Next: como executar um modelo da classe 180B em um PC pessoal
Um guia com fontes verificadas sobre a arquitetura do Strata, a configuração no Windows e no Linux, a rota separada para Mac com Apple Silicon, os benchmarks publicados e os limites da IA local.
Um modelo com cerca de 180 bilhões de parâmetros rodando em um desktop com uma placa de vídeo de 12 GB parece uma contradição. O Strata torna essa possibilidade plausível, mas não espremendo todos os parâmetros para dentro da placa. Sua conquista mais interessante é fazer com que diferentes partes de um modelo esparso usem tipos distintos de memória e processamento sem transformar cada token gerado em um gargalo de transferência de dados.
O nome oficial do modelo é Qwen3.8-Flash-Next, não Qwen3.8-Next-Flash. A Qwen lista um núcleo de 125B parâmetros com 6B ativados, um componente adicional de embeddings n-gram de 51B e 4B para predição de múltiplos tokens. O total arredondado de 180B descreve os componentes armazenados; não é a quantidade de computação densa realizada para cada token. Cartão do modelo Qwen
As informações de configuração e desempenho a seguir referem-se à revisão do Strata fb58e0dbc8399662c0e47c76578c6e878b14f6cf. Os números de benchmark são medições publicadas pelo projeto; seu hardware, prompt, contexto e variante do modelo podem produzir resultados diferentes.
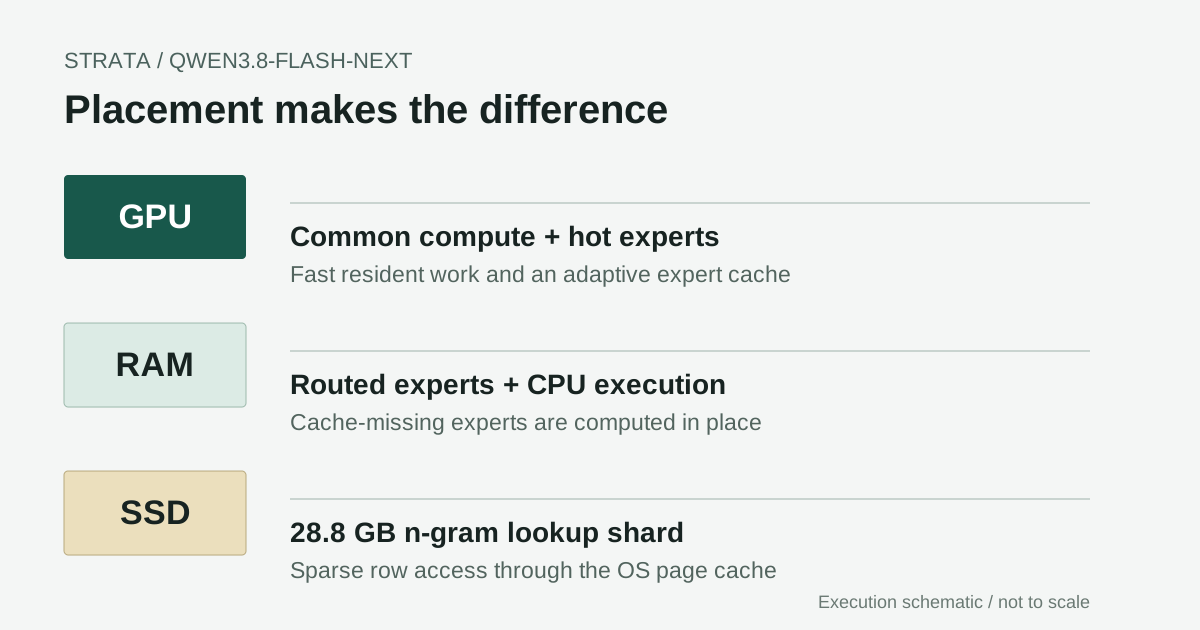
Esquema original baseado no projeto de execução documentado. Os níveis não estão em escala: tamanho do download, uso de RAM e residência na GPU são grandezas diferentes.
A inovação está na alocação, não em um modelo menor
Há três perguntas a fazer sobre qualquer modelo local excepcionalmente grande: quanto precisa ser armazenado, quanto fica ativo para um token e onde o processamento ativo acontece. Um número pequeno de parâmetros ativos responde apenas à segunda pergunta. Ele não elimina a necessidade de manter os demais pesos acessíveis em algum lugar.
O Strata é um mecanismo de inferência e aplicativo de execução local desenvolvido pela comunidade, disponível no repositório Niko1221. Sua configuração documentada oferece instalação no Windows e no Linux, uma interface local de chat, APIs compatíveis e entrada opcional de imagens. É um projeto comunitário independente, não um produto oficial da Qwen para desktop. Repositório do Strata
A mudança de perspectiva útil é deixar de tratar um PC como se fosse uma GPU com memória insuficiente. Um desktop também tem RAM do sistema, unidades vetoriais da CPU e cache de páginas do sistema operacional. Esses recursos são mais lentos do que a memória da GPU para algumas operações, mas não são igualmente inadequados para todas elas. Uma busca em uma tabela grande e uma multiplicação de matrizes densas não precisam da mesma política de alocação.
Essa distinção é o que torna a manchete interessante. O modelo continua grande; o que muda é a forma como o runtime decide quais partes precisam da memória mais rápida em determinado momento. Isso abre um caminho prático para inferência local sem provar que qualquer notebook comum vai executá-lo bem.
A arquitetura esparsa cria a oportunidade
A arquitetura da Qwen combina blocos Gated DeltaNet de estilo recorrente com Qwen Sparse Attention, especialistas roteados e embeddings n-gram. O relatório técnico explica por que esses componentes foram projetados para escalar com mais eficiência. O Strata não inventou os componentes do modelo; ele constrói uma estratégia de execução em torno dos diferentes padrões de acesso de cada um. Relatório de arquitetura da Qwen
O detalhe do roteamento importa. Cada uma das 48 camadas tem 512 especialistas roteados; 10 especialistas roteados são ativados por camada, além de um especialista compartilhado. Isso significa que há 24.576 especialistas roteados armazenados ao longo das camadas. Não significa que apenas 10 desses 24.576 especialistas sejam usados em todo o modelo para um token. Configuração de arquitetura da Qwen
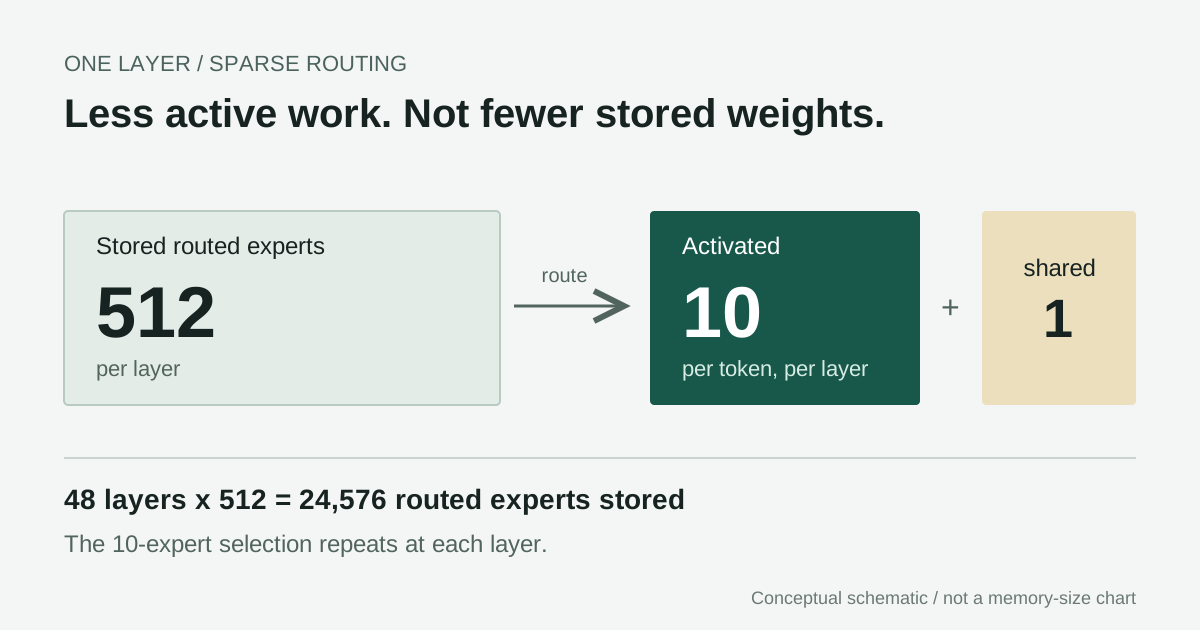
A seleção reduz o processamento ativo, não o conjunto armazenado. Este diagrama representa uma camada, não o modelo inteiro de 48 camadas.
Considere a consequência sem depender de nenhuma alegação de velocidade. Se um especialista é selecionado raramente, manter sua ocupação permanente na cara memória do acelerador pode ser um mau uso da capacidade. Se outro componente é usado em cada etapa, transferi-lo repetidamente tende a custar caro. Um escalonador útil precisa distinguir esses casos e, depois, lidar com as falhas de cache que não consegue evitar.
Por isso, um modelo esparso da classe 180B não deve ser comparado a um modelo denso de 180B apenas pela contagem de parâmetros. Por outro lado, chamá-lo de «modelo de 6B» esconde o armazenamento, o roteamento, o estado de contexto e o custo de acessar pesos distribuídos. Os dois atalhos obscurecem o verdadeiro problema de engenharia.
GPU, RAM e SSD fazem trabalhos diferentes
Na configuração básica documentada, a GPU mantém o processamento comum e um cache dos especialistas roteados mais usados. A RAM do sistema guarda os pesos dos especialistas roteados, e a CPU calcula localmente os especialistas que não estão no cache da GPU. Uma tabela n-gram separada, mapeada em memória, fica no SSD; as linhas necessárias são atendidas pelo cache do sistema operacional. Visão geral da execução do Strata
Esse caminho pela CPU é mais importante do que um rótulo genérico como «offload» deixa transparecer. Durante a decodificação, uma falha de cache não significa simplesmente que cada especialista ausente precisa ser copiado para a GPU antes de continuar. O trabalho da CPU e da GPU pode ocorrer em paralelo. A contrapartida é que a capacidade da CPU e a largura de banda da memória do sistema passam a afetar diretamente a velocidade de geração.
O componente n-gram tem outro padrão de acesso. Sua tabela é grande demais para ficar inteira na memória normal, e cada consulta precisa apenas de linhas específicas. Em vez de ler tudo na inicialização, o processo pode mapear o arquivo em memória e recorrer ao cache de páginas quando precisar de determinadas linhas. Um SSD ou conjunto de trabalho lento também tem um custo nessa estratégia. A paginação sob demanda não torna o armazenamento gratuito: ela evita ler dados que nunca serão necessários.
A quantização reduz ainda mais o espaço ocupado pelos pesos armazenados. O repositório documenta variantes quantizadas em formato GGUF, mas quantização não é compressão sem perdas: a precisão é reduzida, e variantes diferentes envolvem compromissos distintos entre tamanho e qualidade. Além disso, os tamanhos dos arquivos não predizem sozinhos o pico de memória do processo nem a velocidade das falhas de cache. Detalhes de implementação do Strata
Na minha leitura, a inovação está em um sistema coordenado, não em um único truque de compressão. A quantização reduz a ocupação dos pesos armazenados; o cache reduz o acesso repetido aos pesos mais usados; a CPU lida com as falhas; e a consulta esparsa evita carregar uma tabela enorme por inteiro. Sem qualquer uma dessas vantagens, um desktop com memória modesta se torna um hospedeiro bem menos convincente.
A especulação economiza trabalho apenas quando a verificação aceita
O Strata também usa o componente de predição de múltiplos tokens do modelo para propor continuações curtas e verificá-las com o modelo-alvo. Em vez de pagar por uma passagem completa do modelo-alvo para cada token de saída, um rascunho bem-sucedido pode permitir que essa passagem aceite vários tokens. O repositório descreve rascunhos de até três tokens no caminho MTP. Projeto e implementação do MTP
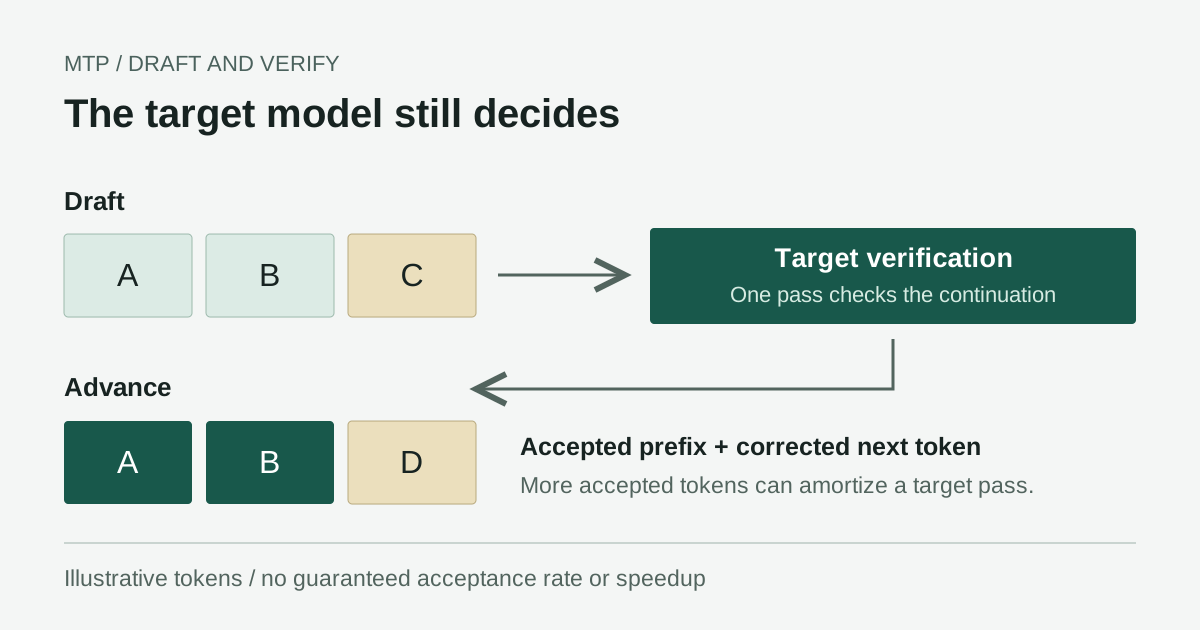
O exemplo ilustra a verificação, não uma taxa de aceitação garantida nem um ganho de velocidade medido.
Essa aceleração é condicional. Pode ser mais fácil rascunhar código previsível ou texto repetido do que uma transição de raciocínio desconhecida. A redação do prompt, a amostragem, o tamanho da saída e a variante do modelo podem alterar a aceitação. Portanto, não se deve presumir que uma manchete medida com um prompt descreva outra tarefa ou idioma.
A verificação é feita com o modelo que está realmente em execução. Ela não recupera informações perdidas na quantização nem comprova equivalência com os pesos BF16 originais. É essencial manter esses dois pontos separados: execução especulativa e qualidade de um modelo de precisão reduzida respondem a perguntas diferentes.
Há também uma distinção relacionada ao reaproveitamento de cache. Um prefixo inalterado da conversa pode poupar trabalho repetido, mas uma continuação com cache aquecido e um novo prompt longo não são testes equivalentes. Registre se o prefixo foi reutilizado ao comparar resultados locais. O projeto documenta explicitamente o cache em limites de mensagem. Comportamento do cache de prefixo
«GPU de 12 GB» não significa uma instalação de 12 GB
As quantizações GGUF publicadas dividem o modelo em um fragmento principal e um fragmento n-gram fixo de 28.8 GB. Os tamanhos dos arquivos abaixo estão em GB decimais e representam o tamanho do download, não os requisitos de memória da GPU. O projetor de visão opcional acrescenta cerca de 0.91 GB; downloads auxiliares e arquivos temporários de conversão precisam de espaço adicional. Arquivos de quantização da ISTA-DASLab
| Variante | Média de bits por peso do núcleo | Fragmento principal | Fragmento n-gram | Download total |
|---|---|---|---|---|
| Q2_0 | 2.40 | 37.6 GB | 28.8 GB | 66.4 GB |
| IQ2_XS | 2.50 | 39.2 GB | 28.8 GB | 68.0 GB |
| IQ3_XXS | 3.00 | 47.0 GB | 28.8 GB | 75.8 GB |
| IQ3_S | 3.50 | 54.8 GB | 28.8 GB | 83.6 GB |
O nome do formato não descreve com precisão todos os tensores. O fragmento principal usa formatos mistos, enquanto o fragmento n-gram usa IQ4_NL. «Modelo de dois bits» é uma abreviação conveniente, mas enganosa se sugerir que todo o download usa exatamente dois bits por parâmetro. Metodologia de quantização
Para uma primeira tentativa com o modelo completo, uma GPU compatível de 12 GB ou mais e 64 GB de RAM do sistema formam uma base de planejamento mais realista do que se guiar apenas pela placa de vídeo. O repositório também discute caminhos com uso reduzido de RAM e uma variante Coder podada. São configurações diferentes, não provas de que uma máquina com 32 GB oferece a mesma experiência com o modelo completo. Seleção de modelo do Strata
Eu reservaria 100-150 GB de espaço livre no SSD antes de experimentar. É uma margem conservadora para planejamento, não um requisito fixo do fornecedor: a quantização escolhida, o auxiliar MTP, os arquivos opcionais de visão e os caches de compilação/conversão determinam o total real. Alguns caminhos de otimização de CPU para Q2 podem exigir uma cópia adicional substancial dos especialistas. Confira o caminho escolhido em vez de presumir um único número universal para o disco.
Antes de escolher o hardware, defina a configuração de que você precisa: modelo completo ou podado, contexto curto ou longo, visão ou somente texto, throughput contínuo ou uso ocasional. Essas escolhas mudam a localização do gargalo, e o benchmark a seguir descreve um sistema específico.
Instale uma configuração básica fixada antes de ajustar
O caminho padrão documentado cobre Windows 10/11 e Ubuntu 22.04/24.04, com GPUs NVIDIA compatíveis e alguns modelos AMD selecionados. As instruções para NVIDIA especificam o driver 580 ou mais recente. macOS e outros backends compilados do código-fonte têm requisitos próprios; os comandos a seguir não são uma configuração universal. Guia oficial de instalação
No Windows, verifique antes de baixar
Se o Git não estiver instalado, obtenha-o pela distribuição oficial. No PowerShell, clone o repositório upstream e fixe a revisão analisada aqui:
git clone https://github.com/Niko1221/Strata.git
cd Strata
git checkout fb58e0dbc8399662c0e47c76578c6e878b14f6cf
.\START-HERE.bat --check
A verificação evita o download grande do modelo, mas o iniciador pode preparar o Python e um ambiente privado. Comportamento da verificação de configuração
Leia o relatório de hardware, inspecione os scripts de configuração e confirme o espaço livre antes de continuar. Em seguida, inicie a configuração interativa:
.\START-HERE.bat
Para um primeiro teste com 64 GB, IQ2_XS é um ponto de partida razoável entre as opções documentadas. Use 32,768 tokens de contexto, somente texto e deixe Experimental Speed Projection desativado. Essa configuração básica menor facilita isolar problemas em vez de começar com o contexto máximo, visão e todas as otimizações ativadas.
Espere downloads e instalação de dependências, não um pequeno executável autocontido. Dependendo do caminho da GPU, a configuração usa um mecanismo já preparado ou ferramentas de build. Analise solicitações envolvendo drivers, compiladores ou privilégios de administrador; não desative o antivírus nem as proteções do navegador para forçar a instalação. Obtenha os drivers necessários com o fabricante do hardware.
Os próximos lançamentos usam o mesmo iniciador. Para rever a configuração ou evitar conflito de porta:
.\START-HERE.bat --setup
.\START-HERE.bat --port 8081
No Ubuntu, use o script de configuração documentado
git clone https://github.com/Niko1221/Strata.git
cd Strata
git checkout fb58e0dbc8399662c0e47c76578c6e878b14f6cf
./setup.sh
Escolha o backend correspondente à GPU. O caminho ROCm da AMD e o caminho CUDA da NVIDIA não são intercambiáveis. Trate pedidos para instalar pacotes ou compiladores como alterações na sua máquina que precisam ser revisadas. A revisão fixada torna este artigo reproduzível; versões mais recentes podem melhorar o suporte, então leia as notas de lançamento antes de decidir atualizar.
Confirme uma resposta antes de conectar um agente
Quando o carregamento terminar, abra http://127.0.0.1:8080 no navegador local ou na porta alternativa escolhida. Envie uma pergunta curta e não sensível e confirme que a resposta é concluída. Só então experimente um prompt mais longo, o reaproveitamento do cache em uma continuação e o idioma que pretende usar. Acompanhe o uso de memória e os logs do servidor durante o primeiro carregamento.
A API compatível documentada inclui GET /v1/models e POST /v1/chat/completions. Descubra o identificador do modelo servido em vez de copiar um alias presumido para outro cliente:
$base = "http://127.0.0.1:8080"
$models = Invoke-RestMethod "$base/v1/models"
$models.data | Select-Object id
Use o identificador retornado ao configurar um cliente compatível. Uma solicitação bem-sucedida para listar modelos comprova a descoberta, não a qualidade da geração; a primeira verificação significativa é concluir uma resposta de chat. Mantenha desativadas as ferramentas de agente que escrevem arquivos ou executam comandos no shell durante esse teste inicial.
Se a placa ficar sem memória, reduza primeiro o contexto e desative a visão. Se o processo for encerrado ou a máquina começar a usar muita memória de troca, investigue a RAM do sistema, não apenas a VRAM. Se faltarem bibliotecas de runtime, consulte as instruções específicas do backend em vez de instalar DLLs aleatórias. O projeto mantém orientações organizadas por sintoma. Solução de problemas do Strata
No Mac, separe o suporte ao modelo do suporte ao Strata
O Apple Silicon usa memória unificada em vez do arranjo separado de VRAM da GPU e RAM do sistema usado no benchmark de desktop. O instalador fixado do Strata não documenta uma rota compatível com macOS; uma solicitação de suporte a Mac não equivale a uma portabilidade concluída. Solicitação upstream para Mac
Há dois experimentos diferentes que uma pessoa usuária de Mac pode ter em mente. Um fork comunitário do Strata para macOS preserva a interface e a API Python com um backend Metal para modelos GGUF menores; as verificações documentadas usam Qwen2.5, não a configuração original do Flash-Next. O fork afirma explicitamente que não porta o streaming de especialistas CUDA nem o caminho MTP do Strata. Não o trate como uma instalação de um clique do modelo discutido aqui. Fork comunitário e escopo
Para o próprio Qwen3.8-Flash-Next, um caminho experimental separado é uma build compatível do llama.cpp com Metal e os arquivos GGUF divididos do publicador. Isso não é Strata no Mac, e a tabela de velocidade do Windows abaixo não se aplica.
Compile o runtime Metal separado
Use um Mac com Apple Silicon, um terminal ARM64 nativo, as ferramentas de desenvolvedor de linha de comando da Apple, Git e CMake. Se o CMake não estiver disponível, instale-o pela distribuição oficial ou pelo gerenciador de pacotes de sua confiança. A documentação de build do llama.cpp analisada ativa o Metal por padrão no macOS. Fixar também esse mecanismo impede que uma branch em movimento altere silenciosamente o exemplo no futuro. Instruções de build Metal do llama.cpp
git clone https://github.com/ggml-org/llama.cpp.git
cd llama.cpp
git checkout 71ad0590f4808b6202f9213d166913858c73b1bc
cmake -B build -DCMAKE_BUILD_TYPE=Release -DGGML_METAL=ON
cmake --build build --config Release -j 4
./build/bin/llama-cli --version
Baixe os dois fragmentos IQ2_XS da lista de arquivos do publicador para um único diretório, mantendo os nomes originais. O segundo fragmento é necessário mesmo quando as linhas de consulta permanecem no disco. Substitua o caminho de exemplo abaixo pelo caminho real do primeiro fragmento no seu Mac:
./build/bin/llama-cli \
  -m "/path/to/IQ2_XS/Qwen3.8-Flash-Next-GSQ-RCO-IQ2_XS-00001-of-00002.gguf" \
  -lm mmap --lazy-mode on -ngl 99 \
  --ctx-size 4096 --n-predict 128 \
  -p "Explain sparse expert routing in three sentences."
O publicador documenta o carregamento de arquivos divididos e as opções mmap/lazy; o mecanismo analisado oferece esses parâmetros. Eles mantêm a tabela n-gram disponível sob demanda sem exigir que fique totalmente residente. São opções do llama.cpp, não do iniciador do Strata. Exemplo de carregamento GGUF
A capacidade continua sendo importante: o fragmento principal IQ2_XS ocupa 39.2 GB antes do estado de runtime e da sobrecarga do macOS. Portanto, um Mac de 16 GB ou 24 GB não é uma base confiável para manter todo o exemplo residente; mesmo 64 GB são um ponto de partida para planejamento, não uma garantia de sucesso. Confira a pressão de memória e o uso de swap no Monitor de Atividade, comece com contexto de 4K e pare se a pressão continuar alta. Não altere limites de memória do kernel para forçar uma execução que não cabe.
Confirme nos logs que o Metal foi selecionado e que uma resposta coerente somente em texto é concluída antes de prosseguir. Depois, teste consultas mais longas antes de adicionar decodificação especulativa ou visão. Este caminho não cobre Macs Intel, execução distribuída em vários Macs nem conversões MLX. Não há números de throughput para Mac disponíveis aqui; os resultados dependem do chip exato, da memória unificada, do mecanismo, da quantização e do contexto.
A velocidade publicada é animadora; a latência do primeiro token conta outra história
Para uma comparação reproduzível, a tabela usa o benchmark de 29 de setembro de 2026, mecanismo 0.1.26, em vez de misturar manchetes posteriores do README. A máquina era uma RTX 5070 de 12 GB em PCIe 5.0 x16, um Ryzen 5 7600 de seis núcleos, 64 GB DDR5-5200 e Windows 10. Os testes usaram geração gulosa, MTP ativado, imagens desativadas e 256 tokens gerados. Condições do benchmark
| Variante | Decodificação com prompt curto, tokens/s | Decodificação com prompt longo, tokens/s | Prefill com prompt médio, tokens/s | Primeiro token com prompt longo, segundos |
|---|---|---|---|---|
| Q2_0 | 92.97 | 73.73 | 2170.85 | 62.48 |
| IQ2_XS | 78.60 | 62.72 | 2092.02 | 74.85 |
| IQ3_XXS | 61.64 | 48.95 | 1745.16 | 81.71 |
| IQ3_S | 53.30 | 45.51 | 1624.07 | 90.72 |
As faixas curta, média e longa contêm 3,562, 31,566 e 128,478 tokens de prompt, respectivamente. Cada célula representa uma execução, não uma média com intervalo de confiança. A execução IQ2_XS usa o fine-tune Swift 1.5 documentado, portanto não é uma comparação controlada apenas por quantização com o modelo-base. Os valores foram copiados da matriz de resultados publicada. Medições legíveis por máquina
O caso Q2_0 com prompt longo leva 62.48 segundos até o primeiro token, apesar de a decodificação seguinte ocorrer a 73.73 tokens/s. Para quem está esperando uma resposta a um documento novo, esse primeiro minuto importa. A experiência pode ser diferente em uma conversa em andamento com contexto reutilizável. Nenhum dos dois aspectos deve ficar escondido atrás de uma alegação de máximo de tokens por segundo.
Esses números sustentam uma conclusão útil e delimitada: no desktop especificado pelo autor, determinadas configurações quantizadas alcançaram velocidades de geração interativas. Eles não demonstram o mesmo resultado em uma máquina com menor largura de banda, em coreano, com raciocínio por amostragem, com visão ativada ou sob usuários simultâneos. Tokens não são palavras, e a tokenização de cada idioma também dificulta comparações informais.
Da mesma forma, o contexto nativo de 262,144 tokens do modelo e as alegações de contexto estendido não garantem que a configuração escolhida do Strata consiga atender confortavelmente a esse tamanho. Estado do runtime, alocação do cache e RAM disponível continuam importantes. Comece com pouco contexto e aumente-o somente quando a carga de trabalho justificar a latência e a memória adicionais.
Qualidade e recursos de «velocidade» precisam de verificações separadas
O publicador da quantização apresenta comparações de qualidade úteis, mas elas não são benchmarks de ponta a ponta do Strata. Por exemplo, sua pontuação no LiveCodeBench v6 é 87.43 para BF16 e 81.14 para Q2_0. Isso é motivo para testar as tarefas que importam para você, não para declarar toda saída de poucos bits inutilizável ou todas as variantes equivalentes. Avaliação publicada da quantização
Experimental Speed Projection merece cautela especial. O projeto descreve um recurso opcional de vetor de controle que altera o comportamento do modelo; não é apenas uma otimização aritmética invisível. Deixe-o desativado no baseline e informe seu uso em comparações. Uma resposta mais rápida causada por uma mudança no conteúdo não é a mesma medição que executar mais rápido um trabalho equivalente. Detalhes do recurso experimental
Na sua própria avaliação, registre o commit do repositório, a versão do mecanismo, a quantização e o fine-tune, a GPU e a VRAM, a CPU, a velocidade da RAM, o SSD, o driver, a configuração de contexto e os recursos ativados. Depois, meça pelo menos três prompts novos e três continuações com cache, relatando a mediana e a faixa em vez de escolher a melhor execução. Registre a quantidade de tokens de entrada e saída junto com o tempo até o primeiro token, a taxa de decodificação e o tempo total.
Combine as verificações de velocidade com verificações de correção específicas para cada tarefa: compile e teste respostas de programação, compare respostas sobre documentos com a fonte e confira o idioma e a terminologia das saídas multilíngues. Registre falhas, timeouts e esgotamento de memória junto com as execuções bem-sucedidas.
A execução local muda o controle, não elimina todos os riscos de segurança
Mantenha o endereço loopback padrão. Expor um servidor de modelos local à LAN ou à internet muda seu modelo de ameaças, e uma API compatível não é automaticamente um serviço autenticado. A política de segurança do Strata descreve a vinculação local e seu escopo de segurança; ela não afirma que houve uma auditoria de segurança externa independente. Política de segurança do Strata
A geração local pode reduzir a dependência de um provedor de inferência hospedado, mas a privacidade ainda depende de todo o fluxo de trabalho. Logs de chat, aplicativos clientes, buscas na web, ferramentas externas e backups podem enviar ou reter dados fora do processo do modelo. Revise esses caminhos antes de colocar documentos confidenciais em um agente. «Roda localmente» é um fato útil sobre a arquitetura, não uma certificação completa de privacidade.
As licenças também têm várias camadas. A licença do código do Strata não substitui os termos qwen-community-1.0 do modelo. Pesos quantizados não eliminam as obrigações associadas ao modelo original. Leia as licenças aplicáveis antes de redistribuir ou implantar comercialmente, em vez de presumir que um repositório aberto permite qualquer uso. Licença do modelo Qwen
A implicação é um tipo diferente de computador pessoal para IA
A principal implicação não é que a inferência na nuvem tenha se tornado obsoleta. Um desktop ainda tem limitações em atendimento simultâneo, latência do primeiro token, consumo de energia, manutenção e qualidade do modelo. Um sistema hospedado pode continuar sendo a melhor escolha quando disponibilidade ou alto volume de solicitações importam mais do que controlar o ambiente de execução.
O que o Strata sugere é que a inferência para consumidores pode ser tão limitada pela orquestração quanto pela capacidade da GPU. Um uso melhor da CPU, da RAM e do acesso esparso ao armazenamento pode viabilizar uma classe de modelos que um cálculo simplista de tudo na GPU descartaria. A largura de banda da memória do sistema passa a fazer parte da especificação de um computador para IA, não é mais um detalhe secundário.
Essa é uma inferência baseada na arquitetura e nos resultados publicados, não uma garantia para todos os modelos futuros. Ela depende de os modelos exporem componentes esparsos, cacheáveis ou orientados a consultas que o runtime possa aproveitar. Um modelo denso com padrões de acesso diferentes não herdará a mesma vantagem só por ter uma contagem de parâmetros semelhante.
Para uma pessoa pesquisadora ou desenvolvedora, o próximo passo realista é um piloto delimitado: uma versão fixada, contexto curto, uma máquina compatível, algumas tarefas representativas e um registro honesto de qualidade e latência. Esse avanço é significativo justamente quando descrito dessa forma. Um modelo muito grande se tornou uma carga de trabalho plausível para desktop graças à alocação e à verificação cuidadosas, não porque as limitações de hardware desapareceram.
Mantenha as decisões de configuração junto das notas de pesquisa
Ao comparar configurações de IA local, mantenha juntos os links das fontes, os detalhes do hardware, as observações e as dúvidas ainda em aberto. O Telli.sh pode ajudar a organizar essas notas e resumos sem sugerir que tenha uma integração incorporada com o Strata. Crie uma conta no Telli.sh