Strata und Qwen3.8-Flash-Next: Wie ein Modell der 180B-Klasse auf dem PC läuft
Ein quellengeprüfter Leitfaden zu Stratas Architektur, der Einrichtung unter Windows und Linux, dem separaten Apple-Silicon-Mac-Weg, veröffentlichten Benchmarks und den Grenzen lokaler KI.
Ein Modell mit rund 180 Milliarden Parametern auf einem Desktop mit einer Grafikkarte mit 12 GB auszuführen, klingt widersprüchlich. Strata macht das plausibel, aber nicht, indem es sämtliche Parameter in die Grafikkarte quetscht. Die interessantere Leistung besteht darin, verschiedene Teile eines spärlich besetzten Modells unterschiedliche Speicher- und Rechenarten nutzen zu lassen, ohne dass jedes generierte Token zum Engpass beim Datentransfer wird.
Der offizielle Modellname lautet Qwen3.8-Flash-Next, nicht Qwen3.8-Next-Flash. Qwen gibt einen Kern mit 125B Parametern an, von denen 6B aktiviert werden, dazu eine zusätzliche N-Gramm-Einbettungskomponente mit 51B sowie 4B für Multi-Token Prediction. Die gerundete Gesamtsumme von 180B beschreibt gespeicherte Komponenten; sie entspricht nicht der dichten Rechenarbeit für jedes Token. Qwen-Modellkarte
Die Einrichtungs- und Leistungsangaben unten beziehen sich auf Strata-Revision fb58e0dbc8399662c0e47c76578c6e878b14f6cf. Die Benchmarkwerte sind vom Projekt veröffentlichte Messungen; Ihre Hardware, Ihr Prompt, der Kontext und die Modellvariante können zu anderen Ergebnissen führen.
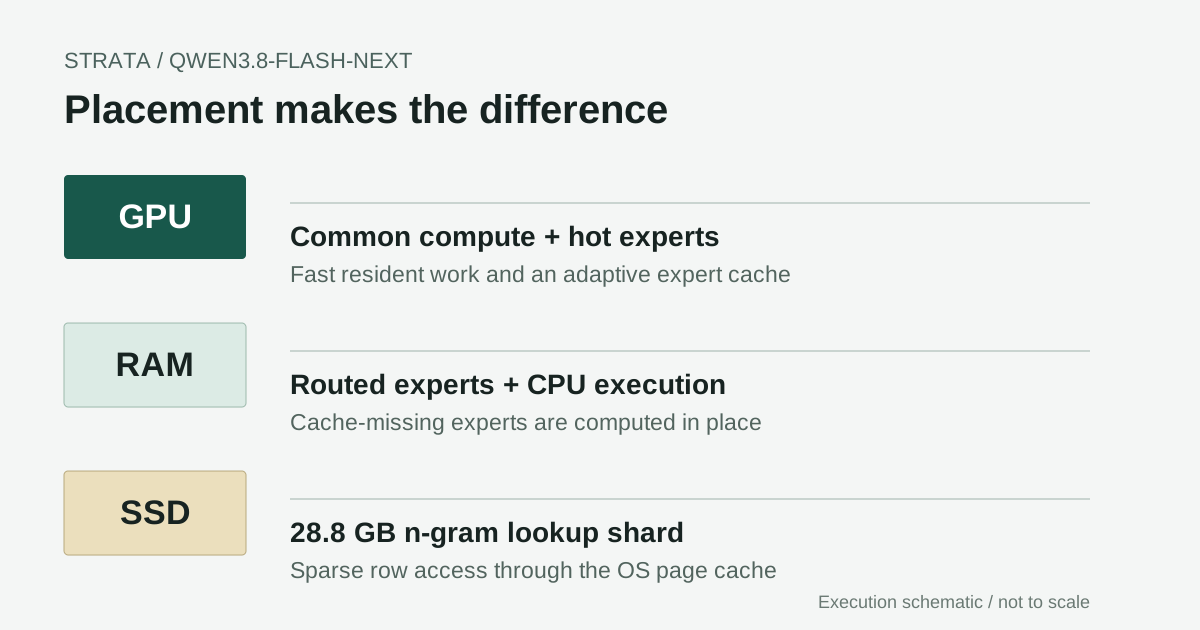
Originalschema auf Grundlage des dokumentierten Ausführungsdesigns. Die Ebenen sind nicht maßstabsgetreu: Downloadgröße, RAM-Verbrauch und GPU-Residenz sind unterschiedliche Größen.
Der Durchbruch liegt in der Platzierung, nicht in einem kleineren Modell
Bei jedem ungewöhnlich großen lokalen Modell sollte man drei Fragen stellen: Wie viel muss gespeichert werden, wie viel davon ist für ein Token aktiv, und wo wird die aktive Arbeit ausgeführt? Eine geringe Zahl aktiver Parameter beantwortet nur die zweite Frage. Sie hebt nicht die Notwendigkeit auf, die übrigen Gewichte irgendwo zugänglich zu halten.
Strata ist eine von der Community entwickelte Inferenz-Engine und lokale Serving-Anwendung im Repository von Niko1221. Die dokumentierte Einrichtung bietet Installation unter Windows und Linux, eine lokale Chat-Oberfläche, kompatible API-Endpunkte und optionale Bildeingabe. Strata ist ein eigenständiges Community-Projekt und kein offizielles Qwen-Desktopprodukt. Strata-Repository
Der entscheidende technische Perspektivwechsel: Einen PC nicht bloß als GPU mit zu wenig Speicher zu betrachten. Ein Desktop verfügt außerdem über Systemspeicher, CPU-Vektoreinheiten und den Seiten-Cache des Betriebssystems. Bei manchen Vorgängen sind diese Ressourcen langsamer als GPU-Speicher, aber nicht für jede Art von Arbeit gleichermaßen ungeeignet. Eine große Tabellenabfrage und eine dichte Matrixmultiplikation brauchen nicht dieselbe Platzierungsstrategie.
Genau deshalb ist die Schlagzeile interessant. Das Modell bleibt groß; die Laufzeitumgebung verändert, wie viel davon zu einem bestimmten Zeitpunkt den schnellsten Speicher benötigt. Das eröffnet einen praktikablen Weg zu lokaler Inferenz, beweist aber nicht, dass jeder gewöhnliche Laptop das Modell gut ausführen kann.
Die spärliche Architektur schafft die Möglichkeit
Qwens Architektur kombiniert Gated-DeltaNet-Blöcke im Stil rekurrenter Netze mit Qwen Sparse Attention, gerouteten Experten und N-Gramm-Einbettungen. Der technische Bericht erläutert, weshalb diese Komponenten auf effizientere Skalierung ausgelegt sind. Strata hat diese Modellkomponenten nicht erfunden, sondern entwickelt eine Ausführungsstrategie für ihre unterschiedlichen Zugriffsmuster. Bericht zur Qwen-Architektur
Das Routing ist wichtig: Jede der 48 Schichten hat 512 geroutete Experten; pro Schicht werden 10 geroutete Experten aktiviert, zusätzlich zu einem gemeinsamen Experten. Über alle Schichten hinweg sind somit 24.576 geroutete Experten gespeichert. Das bedeutet nicht, dass für ein Token im gesamten Modell nur 10 dieser 24.576 Experten zum Einsatz kommen. Konfiguration der Qwen-Architektur
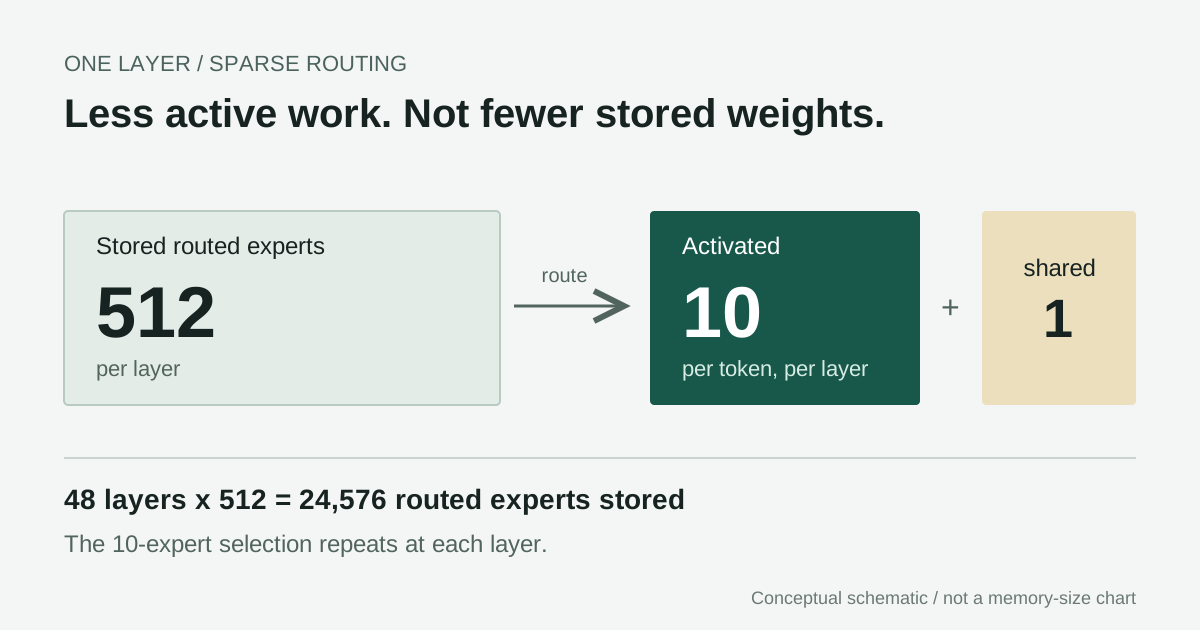
Die Auswahl verringert die aktive Arbeit, nicht den gespeicherten Bestand. Dieses Diagramm zeigt eine Schicht, nicht das gesamte Modell mit 48 Schichten.
Betrachten wir die Konsequenz unabhängig von jeder Geschwindigkeitsbehauptung: Wird ein Experte selten ausgewählt, ist es womöglich keine gute Nutzung der Kapazität, ihn dauerhaft im teuren Beschleunigerspeicher zu halten. Wird eine andere Komponente bei jedem Schritt verwendet, dürfte es kostspielig sein, sie wiederholt zu verschieben. Ein guter Scheduler muss diese Fälle unterscheiden und anschließend die unvermeidlichen Cache-Fehltreffer verwalten.
Deshalb sollte man ein spärliches Modell der 180B-Klasse nicht allein anhand der Parameterzahl mit einem dichten 180B-Modell vergleichen. Umgekehrt verschleiert die Bezeichnung „6B-Modell“ Speicherbedarf, Routing, Kontextzustand und Zugriffskosten für verteilte Gewichte. Beide Vereinfachungen verdecken das eigentliche technische Problem.
GPU, RAM und SSD übernehmen unterschiedliche Aufgaben
In der dokumentierten Basiskonfiguration hält die GPU häufig genutzte Rechenoperationen und einen Cache oft verwendeter gerouteter Experten vor. Der Systemspeicher enthält die Gewichte der gerouteten Experten; die CPU berechnet Experten, die im GPU-Cache fehlen, direkt vor Ort. Eine separate, speicherabgebildete N-Gramm-Tabelle verbleibt auf der SSD, wobei benötigte Zeilen über den Betriebssystem-Cache bereitgestellt werden. Überblick über Stratas Ausführung
Der CPU-Pfad ist bedeutender, als die allgemeine Bezeichnung „Offloading“ vermuten lässt. Während der Dekodierung muss bei einem Cache-Fehltreffer nicht einfach jeder fehlende Experte erst zur GPU kopiert werden, bevor es weitergeht. CPU- und GPU-Arbeit können sich überlappen. Der Kompromiss: CPU-Leistung und Systemspeicherbandbreite beeinflussen nun direkt die Ausgabegeschwindigkeit.
Die N-Gramm-Komponente hat wiederum ein anderes Zugriffsmuster. Einige Zeilen nachzuschlagen ist nicht dasselbe wie die gesamte Tabelle zu durchsuchen. Daher kann ein quantisierter N-Gramm-Teil mit 28.8 GB auf der SSD verbleiben, ohne dass daraus folgt, das gesamte Modell werde für jedes generierte Token von der Festplatte gelesen. Ein langsames Laufwerk oder starker Druck auf den Seiten-Cache kann die Reaktionsfähigkeit dennoch beeinträchtigen.
Auch Prefill unterscheidet sich von der Dekodierung. Bei der Verarbeitung des anfänglichen Prompts sind größere Stapel und die Überlappung von Expertentransfers mit anderen Schichtoperationen möglich. Die Erzeugung des jeweils nächsten Tokens reagiert empfindlich auf Latenz. Die ausführliche Projektdokumentation beschreibt unterschiedliche Kernel, Zeitplanung und Cache-Verhalten für diese Phasen. Eine einzelne Durchsatzzahl kann beides nicht zusammenfassen. Details zur Strata-Implementierung
Meine Einschätzung: Die Innovation ist ein abgestimmtes System, kein einzelner Komprimierungstrick. Quantisierung verringert den Speicherbedarf der Gewichte; Caching vermeidet wiederholte Zugriffe auf häufig genutzte Gewichte; die CPU verarbeitet Fehltreffer; spärliche Abfragen ersparen das vollständige Laden einer riesigen Tabelle. Fällt einer dieser Vorteile weg, wird ein Desktop mit begrenztem Speicher zu einem deutlich weniger überzeugenden Host.
Spekulation spart nur dann Arbeit, wenn die Prüfung den Entwurf akzeptiert
Strata nutzt außerdem die Multi-Token-Prediction-Komponente des Modells, um kurze Fortsetzungen vorzuschlagen und sie mit dem Zielmodell zu prüfen. Statt für jedes einzelne Ausgabetoken einen vollständigen Durchlauf des Zielmodells zu bezahlen, kann ein erfolgreicher Entwurf dazu führen, dass dieser Durchlauf mehrere Tokens akzeptiert. Das Repository beschreibt Entwürfe mit bis zu drei Tokens in seinem MTP-Pfad. MTP-Design und Implementierung
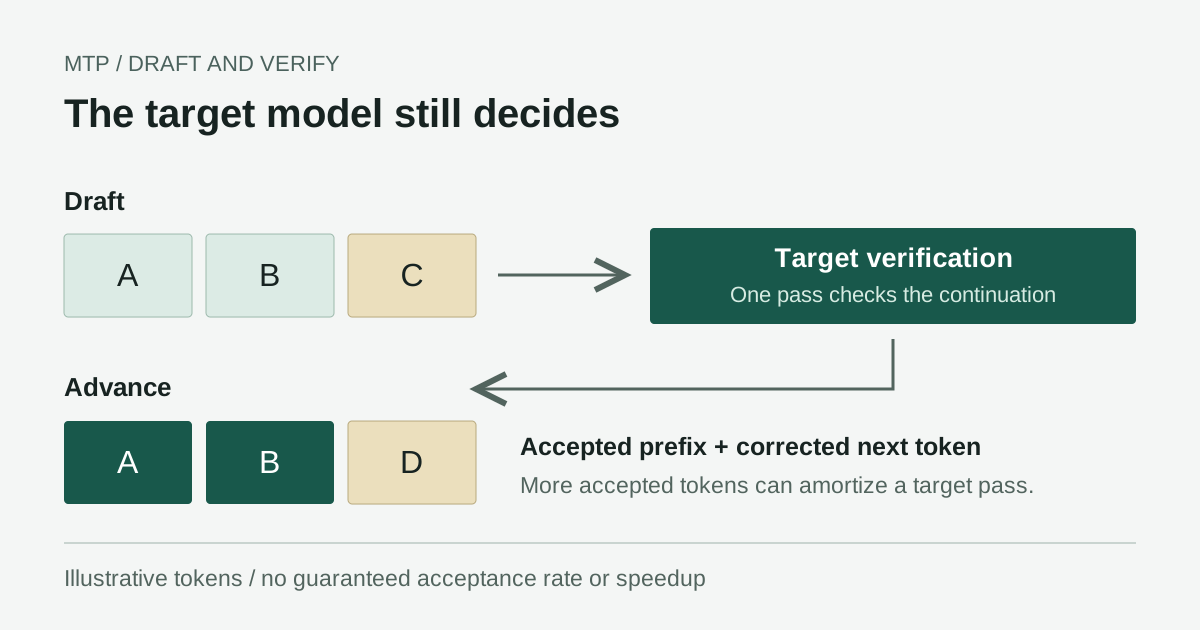
Das Beispiel veranschaulicht die Prüfung, keine garantierte Akzeptanzrate und keine gemessene Beschleunigung.
Diese Beschleunigung ist an Bedingungen geknüpft. Vorhersehbarer Code oder wiederholter Text lässt sich womöglich leichter entwerfen als ein unbekannter Übergang in einer Argumentation. Prompt-Formulierung, Sampling, Ausgabelänge und Modellvariante können die Akzeptanz verändern. Ein Schlagzeilenwert aus einem einzelnen Prompt ist daher nicht ohne Weiteres auf eine andere Sprache oder Aufgabe übertragbar.
Die Prüfung bezieht sich auf das tatsächlich ausgeführte Modell. Sie macht keine bei der Quantisierung verlorenen Informationen rückgängig und belegt keine Gleichwertigkeit mit den ursprünglichen BF16-Gewichten. Diese beiden Fragen müssen getrennt bleiben: Spekulative Ausführung und die Qualität eines Modells mit reduzierter Präzision beantworten unterschiedliche Fragen.
Eine weitere Unterscheidung betrifft die Wiederverwendung des Caches. Ein unverändertes Gesprächspräfix kann wiederholte Arbeit sparen, aber eine Folgefrage mit warmem Cache und ein neuer langer Prompt sind keine gleichwertigen Tests. Halten Sie bei lokalen Vergleichen fest, ob das Präfix wiederverwendet wurde. Das Projekt dokumentiert das Caching an Nachrichtengrenzen ausdrücklich. Verhalten des Präfix-Caches
„12-GB-GPU“ bedeutet nicht „12-GB-Installation“
Die veröffentlichten GGUF-Quantisierungen teilen das Modell in einen Haupt-Teil und einen festen N-Gramm-Teil mit 28.8 GB auf. Die folgenden Dateigrößen sind dezimale GB und Downloadgrößen, keine Anforderungen an den GPU-Speicher. Der optionale Vision-Projektor benötigt zusätzlich etwa 0.91 GB; Hilfsdownloads und temporäre Konvertierungsdateien brauchen weiteren Speicherplatz. Quantisierungsdateien von ISTA-DASLab
| Variante | Durchschnittliche Bits pro Kerngewicht | Haupt-Teil | N-Gramm-Teil | Gesamtdownload |
|---|---|---|---|---|
| Q2_0 | 2.40 | 37.6 GB | 28.8 GB | 66.4 GB |
| IQ2_XS | 2.50 | 39.2 GB | 28.8 GB | 68.0 GB |
| IQ3_XXS | 3.00 | 47.0 GB | 28.8 GB | 75.8 GB |
| IQ3_S | 3.50 | 54.8 GB | 28.8 GB | 83.6 GB |
Der Formatname allein beschreibt nicht jedes Tensor präzise. Der Haupt-Teil verwendet gemischte Formate, während der N-Gramm-Teil IQ4_NL nutzt. „Zwei-Bit-Modell“ ist eine bequeme Kurzform, aber irreführend, wenn sie nahelegt, der gesamte Download verwende genau zwei Bits pro Parameter. Methodik der Quantisierung
Für einen ersten Versuch mit dem vollständigen Modell bilden eine unterstützte GPU mit mindestens 12 GB und 64 GB Systemspeicher eine glaubwürdigere Planungsgrundlage als die GPU-Schlagzeile allein. Das Repository behandelt auch Pfade mit weniger RAM und eine beschnittene Coder-Variante. Das sind andere Konfigurationen und kein Beleg dafür, dass ein Rechner mit 32 GB dasselbe Erlebnis mit dem vollständigen Modell bietet. Strata-Modellauswahl
Vor dem Experimentieren würde ich 100-150 GB freien SSD-Speicher einplanen. Das ist ein vorsichtiger Richtwert, keine feste Herstelleranforderung: Die tatsächliche Summe hängt von der gewählten Quantisierung, dem MTP-Helfermodell, optionalen Vision-Dateien und Build- beziehungsweise Konvertierungs-Caches ab. Manche Q2-CPU-Optimierungspfade können eine beträchtliche zusätzliche Expert-Kopie erfordern. Prüfen Sie den gewählten Pfad, statt von einem universellen Speicherwert auszugehen.
Bevor Sie Hardware auswählen, legen Sie fest, welche Konfiguration Sie brauchen: vollständiges oder beschnittenes Modell, kurzer oder langer Kontext, Vision oder Text sowie dauerhafter Durchsatz oder gelegentliche Nutzung. Diese Entscheidungen bestimmen, wo der Engpass liegt; der folgende Benchmark beschreibt ein einzelnes konkretes System.
Erst eine festgelegte Basiskonfiguration installieren, dann optimieren
Der dokumentierte Standardpfad deckt Windows 10/11 und Ubuntu 22.04/24.04 mit unterstützten NVIDIA- und ausgewählten AMD-GPUs ab. Die NVIDIA-Anleitung verlangt Treiber 580 oder neuer. Für macOS und andere Backends, die aus dem Quellcode erstellt werden, gelten separate Anforderungen; die folgenden Befehle sind kein universeller Einrichtungsweg. Offizielle Installationsanleitung
Unter Windows vor dem Download prüfen
Installieren Sie Git aus der offiziellen Distribution, falls es fehlt. Klonen Sie in PowerShell das Upstream-Repository und legen Sie die hier geprüfte Revision fest:
git clone https://github.com/Niko1221/Strata.git
cd Strata
git checkout fb58e0dbc8399662c0e47c76578c6e878b14f6cf
.\START-HERE.bat --check
Die Prüfung vermeidet den umfangreichen Modelldownload, aber der Launcher kann Python und eine private Umgebung einrichten. Verhalten der Setup-Prüfung
Lesen Sie den Hardwarebericht, prüfen Sie die Setup-Skripte und bestätigen Sie den freien Speicherplatz, bevor Sie fortfahren. Starten Sie dann die interaktive Einrichtung:
.\START-HERE.bat
Für einen ersten Versuch mit 64 GB ist IQ2_XS eine sinnvolle Ausgangsvariante unter den dokumentierten Optionen. Verwenden Sie 32,768 Tokens Kontext, ausschließlich Text und lassen Sie Experimental Speed Projection ausgeschaltet. Mit dieser kleineren Basiskonfiguration lassen sich Fehler leichter eingrenzen, als wenn Sie mit maximalem Kontext, Vision und sämtlichen aktivierten Optimierungen beginnen.
Rechnen Sie mit Downloads und der Installation von Abhängigkeiten, nicht mit einer winzigen, eigenständigen ausführbaren Datei. Je nach GPU-Pfad verwendet das Setup eine vorbereitete Engine oder Build-Werkzeuge. Prüfen Sie Aufforderungen zu Treibern, Compilern oder Administratorrechten; deaktivieren Sie weder Virenschutz noch Browser-Schutz, um eine Installation zu erzwingen. Beziehen Sie benötigte Treiber vom Hardwarehersteller.
Für spätere Starts verwenden Sie denselben Launcher. So öffnen Sie die Einrichtung erneut oder vermeiden einen Portkonflikt:
.\START-HERE.bat --setup
.\START-HERE.bat --port 8081
Unter Ubuntu das dokumentierte Einrichtungsskript verwenden
git clone https://github.com/Niko1221/Strata.git
cd Strata
git checkout fb58e0dbc8399662c0e47c76578c6e878b14f6cf
./setup.sh
Wählen Sie das Backend passend zur GPU. AMDs ROCm-Pfad und NVIDIAs CUDA-Pfad sind nicht austauschbar. Behandeln Sie Aufforderungen des Paketmanagers oder zur Compilerinstallation als Änderungen an Ihrem eigenen Rechner, die geprüft werden müssen. Die festgelegte Revision macht diesen Artikel reproduzierbar; neuere Versionen können die Unterstützung verbessern. Lesen Sie deren Versionshinweise, bevor Sie bewusst aktualisieren.
Erst eine Antwort bestätigen, dann einen Agenten verbinden
Sobald das Laden abgeschlossen ist, öffnen Sie im lokalen Browser http://127.0.0.1:8080 oder den gewählten alternativen Port. Senden Sie eine kurze, nicht sensible Frage und bestätigen Sie, dass eine Antwort vollständig erzeugt wird. Probieren Sie erst danach einen längeren Prompt, die Wiederverwendung des Folgefrage-Caches und Ihre gewünschte Sprache aus. Beobachten Sie beim ersten Laden Speicherverbrauch und Serverprotokolle.
Die dokumentierte kompatible API umfasst GET /v1/models und POST /v1/chat/completions. Ermitteln Sie die bereitgestellte Modellkennung, statt einen geratenen Alias in einen anderen Client zu kopieren:
$base = "http://127.0.0.1:8080"
$models = Invoke-RestMethod "$base/v1/models"
$models.data | Select-Object id
Verwenden Sie die zurückgegebene Kennung, wenn Sie einen kompatiblen Client konfigurieren. Eine erfolgreiche Modelllistenabfrage bestätigt die Erkennung, nicht die Generierungsqualität; aussagekräftig ist zunächst eine vollständig abgeschlossene Chat-Antwort. Lassen Sie Datei-Schreibzugriffe oder Shell-Ausführung durch Agenten bei diesem ersten Test deaktiviert.
Geht der Grafikkartenspeicher aus, verringern Sie zuerst den Kontext und schalten Sie Vision aus. Wird der Prozess beendet oder lagert der Rechner stark auf die Festplatte aus, untersuchen Sie den Systemspeicher und nicht nur den VRAM. Bei fehlenden Laufzeitbibliotheken konsultieren Sie die Anweisungen für das jeweilige Backend, statt beliebige DLLs zu installieren. Das Projekt bietet eine nach Symptomen gegliederte Anleitung. Strata-Fehlerbehebung
Auf dem Mac Modellunterstützung und Strata-Unterstützung auseinanderhalten
Apple Silicon verwendet gemeinsamen Speicher statt der getrennten GPU-VRAM- und Systemspeicher-Anordnung aus dem Desktop-Benchmark. Der festgelegte Strata-Installer dokumentiert keinen unterstützten macOS-Pfad; eine Supportanfrage für den Mac ist kein abgeschlossener Port. Upstream-Anfrage zu Mac
Mac-Nutzende können zwei unterschiedliche Experimente meinen. Ein Community-Fork namens Strata-macOS behält Oberfläche und Python-API bei und ergänzt ein Metal-Backend für kleinere GGUF-Modelle; die dokumentierten Tests verwenden Qwen2.5, nicht die ursprüngliche Flash-Next-Konfiguration. Der Fork portiert ausdrücklich weder Stratas CUDA-Expert-Streaming noch den MTP-Pfad. Betrachten Sie ihn nicht als Ein-Klick-Installation des hier besprochenen Modells. Community-Fork und Umfang
Für Qwen3.8-Flash-Next selbst gibt es als separaten experimentellen Weg einen kompatiblen llama.cpp-Metal-Build mit den aufgeteilten GGUF-Dateien des Herausgebers. Das ist nicht Strata auf dem Mac; die folgende Windows-Geschwindigkeitstabelle ist nicht darauf übertragbar.
Die separate Metal-Laufzeitumgebung erstellen
Verwenden Sie einen Apple-Silicon-Mac, ein natives ARM64-Terminal, Apples Befehlszeilen-Entwicklerwerkzeuge, Git und CMake. Fehlt CMake, installieren Sie es über die offizielle Distribution oder einen vertrauenswürdigen Paketmanager. Die geprüfte Build-Dokumentation von llama.cpp aktiviert Metal unter macOS standardmäßig. Durch Festlegen der Engine-Revision wird außerdem verhindert, dass ein künftig veränderlicher Branch das Beispiel unbemerkt ändert. Build-Anleitung für llama.cpp Metal
git clone https://github.com/ggml-org/llama.cpp.git
cd llama.cpp
git checkout 71ad0590f4808b6202f9213d166913858c73b1bc
cmake -B build -DCMAKE_BUILD_TYPE=Release -DGGML_METAL=ON
cmake --build build --config Release -j 4
./build/bin/llama-cli --version
Laden Sie beide IQ2_XS-Teildateien aus der Dateiliste des Herausgebers in ein Verzeichnis herunter und behalten Sie ihre ursprünglichen Namen bei. Die zweite Teildatei wird auch dann benötigt, wenn ihre Abfragezeilen auf dem Laufwerk verbleiben. Ersetzen Sie den unten stehenden Beispielmodellpfad durch den tatsächlichen Pfad zur ersten Teildatei auf Ihrem Mac:
./build/bin/llama-cli \
  -m "/path/to/IQ2_XS/Qwen3.8-Flash-Next-GSQ-RCO-IQ2_XS-00001-of-00002.gguf" \
  -lm mmap --lazy-mode on -ngl 99 \
  --ctx-size 4096 --n-predict 128 \
  -p "Explain sparse expert routing in three sentences."
Der Herausgeber dokumentiert das Laden aufgeteilter Dateien und die mmap-/lazy-Flags; die geprüfte Engine bietet diese Optionen. Dadurch bleibt die N-Gramm-Tabelle bei Bedarf verfügbar, statt vollständig im Speicher liegen zu müssen. Es handelt sich um llama.cpp-Optionen, nicht um Optionen des Strata-Launchers. Beispiel zum Laden von GGUF
Die Kapazität bleibt wichtig: Der Hauptteil von IQ2_XS ist 39.2 GB groß, noch ohne Laufzeitstatus und macOS-Overhead. Ein Mac mit 16 GB oder 24 GB ist daher keine glaubwürdige Ausgangsbasis für vollständige Speicherresidenz in diesem Beispiel; selbst 64 GB sind nur ein Planungswert, keine Garantie, dass es funktioniert. Prüfen Sie in der Aktivitätsanzeige Speicherdruck und Auslagerung, beginnen Sie mit 4K Kontext und brechen Sie ab, wenn der Speicherdruck dauerhaft hoch bleibt. Versuchen Sie nicht, einen fehlgeschlagenen Lauf durch Änderungen an Kernel-Speicherlimits zu erzwingen.
Bestätigen Sie, dass die Protokolle Metal auswählen und eine schlüssige reine Textantwort abgeschlossen wird, bevor Sie weiter experimentieren. Testen Sie anschließend längere Prompts, bevor Sie spekulative Dekodierung oder Vision hinzufügen. Dieser Weg umfasst weder Intel-Macs noch verteilte Ausführung über mehrere Macs oder MLX-Konvertierungen. Hier liegt kein Mac-Durchsatzwert vor; die Ergebnisse hängen vom genauen Chip, der Größe des gemeinsamen Speichers, der Engine, der Quantisierung und dem Kontext ab.
Das veröffentlichte Tempo ist ermutigend, doch die Latenz bis zum ersten Token erzählt eine andere Geschichte
Für einen reproduzierbaren Vergleich verwendet die Tabelle den Benchmark vom 29. September 2026 mit Engine 0.1.26, statt spätere README-Schlagzeilen zu vermischen. Das Testsystem hatte eine RTX 5070 mit 12 GB an PCIe 5.0 x16, einen Ryzen 5 7600 mit sechs Kernen, 64 GB DDR5-5200 und Windows 10. Getestet wurde mit Greedy-Generierung, aktiviertem MTP, deaktivierten Bildern und 256 generierten Tokens. Benchmarkbedingungen
| Variante | Dekodierung mit kurzem Prompt, Tokens/s | Dekodierung mit langem Prompt, Tokens/s | Prefill mit mittlerem Prompt, Tokens/s | Erstes Token bei langem Prompt, Sekunden |
|---|---|---|---|---|
| Q2_0 | 92.97 | 73.73 | 2170.85 | 62.48 |
| IQ2_XS | 78.60 | 62.72 | 2092.02 | 74.85 |
| IQ3_XXS | 61.64 | 48.95 | 1745.16 | 81.71 |
| IQ3_S | 53.30 | 45.51 | 1624.07 | 90.72 |
Die kurzen, mittleren und langen Stufen enthalten 3,562, 31,566 beziehungsweise 128,478 Prompt-Tokens. Jede Zelle entspricht einem einzelnen Lauf, nicht einem Mittelwert mit Konfidenzintervall. Beim IQ2_XS-Lauf wird das dokumentierte Swift-1.5-Fine-Tuning verwendet; er ist deshalb kein kontrollierter Vergleich, bei dem sich nur die Quantisierung gegenüber dem Basismodell unterscheidet. Die Werte sind der veröffentlichten Ergebnismatrix entnommen. Maschinenlesbare Messwerte
Beim Q2_0-Fall mit langem Prompt vergehen 62.48 Sekunden bis zum ersten Token, obwohl die anschließende Dekodierung 73.73 Tokens/s erreicht. Wer auf ein neues Dokument wartet, merkt diese erste Minute. Bei einem laufenden Gespräch mit wiederverwendbarem Kontext kann das Erlebnis anders ausfallen. Beides sollte nicht hinter einer maximalen Tokens-pro-Sekunde-Angabe verschwinden.
Die Zahlen stützen eine eng umrissene, aber nützliche Schlussfolgerung: Auf dem vom Autor spezifizierten Desktop erreichten ausgewählte quantisierte Konfigurationen interaktive Generierungsgeschwindigkeiten. Sie belegen nicht dasselbe Ergebnis auf einem Rechner mit geringerer Bandbreite, auf Koreanisch, bei gesampelter Argumentation, mit aktivierter Vision oder unter gleichzeitiger Nutzung durch mehrere Personen. Tokens sind keine Wörter, und die Tokenisierung nach Sprache erschwert beiläufige Vergleiche zusätzlich.
Auch die native Kontextlänge des Modells von 262,144 Tokens und Angaben zu erweitertem Kontext garantieren nicht, dass Ihre gewählte Strata-Konfiguration diese Länge problemlos bedienen kann. Laufzeitstatus, Cache-Platzierung und verfügbarer RAM bleiben relevant. Beginnen Sie klein und vergrößern Sie den Kontext nur, wenn die Arbeitslast die zusätzliche Latenz und den Speicherbedarf rechtfertigt.
Qualität und „Geschwindigkeits“-Funktionen getrennt prüfen
Der Herausgeber der Quantisierung veröffentlicht nützliche Qualitätsvergleiche, doch es sind keine End-to-End-Benchmarks von Strata. Beispielsweise beträgt sein LiveCodeBench-v6-Wert 87.43 für BF16 und 81.14 für Q2_0. Das ist ein Anlass, die für Sie wichtigen Aufgaben zu testen, aber kein Grund, jede Ausgabe mit wenigen Bits für unbrauchbar oder alle Varianten für gleichwertig zu erklären. Veröffentlichte Quantisierungsevaluierung
Bei Experimental Speed Projection ist besondere Vorsicht geboten. Das Projekt beschreibt eine optionale Control-Vector-Funktion, die das Modellverhalten ändert; es handelt sich nicht einfach um eine unsichtbare arithmetische Optimierung. Lassen Sie sie für die Basiskonfiguration ausgeschaltet und legen Sie ihre Verwendung bei Vergleichen offen. Eine schnellere Antwort aufgrund veränderter Inhalte misst nicht dasselbe wie eine schnellere Ausführung gleichwertiger Arbeit. Details zur experimentellen Funktion
Dokumentieren Sie für Ihre eigene Evaluierung den Repository-Commit, die Engine-Version, Quantisierung und Fine-Tuning, GPU und VRAM, CPU, RAM-Takt, SSD, Treiber, Kontexteinstellung und aktivierte Funktionen. Messen Sie dann mindestens drei neue Prompts und drei Folgeanfragen mit Cache und berichten Sie Median und Spannweite, statt den besten Lauf auszuwählen. Notieren Sie Prompt- und Ausgabe-Tokenzahlen zusammen mit der Zeit bis zum ersten Token, Dekodierungsrate und Gesamtdauer.
Kombinieren Sie Geschwindigkeitsprüfungen mit aufgabenspezifischen Korrektheitstests: Codeantworten kompilieren und testen, Dokumentantworten mit der Quelle vergleichen und bei mehrsprachigen Ausgaben Sprache und Terminologie prüfen. Halten Sie neben erfolgreichen Durchläufen auch Fehlschläge, Zeitüberschreitungen und Speichermangel fest.
Lokale Ausführung verschafft Kontrolle, beseitigt aber nicht alle Sicherheitsrisiken
Behalten Sie die standardmäßige Loopback-Adresse bei. Einen lokalen Modellserver im LAN oder Internet bereitzustellen, ändert dessen Bedrohungsmodell; eine kompatible API ist nicht automatisch ein authentifizierter Dienst. Stratas Sicherheitsrichtlinie beschreibt die lokale Bindung und ihren Sicherheitsumfang, behauptet jedoch kein unabhängiges externes Sicherheitsaudit. Strata-Sicherheitsrichtlinie
Lokale Generierung kann die Abhängigkeit von einem gehosteten Inferenzanbieter verringern, doch der Datenschutz hängt weiterhin vom gesamten Arbeitsablauf ab. Chatprotokolle, Client-Anwendungen, Websuche, externe Tools und Backups können Daten außerhalb des Modellprozesses versenden oder speichern. Prüfen Sie diese Wege, bevor Sie einem Agenten vertrauliche Dokumente geben. „Läuft lokal“ ist eine nützliche Architektureigenschaft, aber keine umfassende Datenschutz-Zertifizierung.
Auch die Lizenzierung besteht aus mehreren Ebenen. Die Codelizenz von Strata ersetzt nicht die Bedingungen qwen-community-1.0 des Modells. Quantisierte Gewichte heben die Verpflichtungen für das ursprüngliche Modell nicht auf. Lesen Sie die geltenden Lizenzen vor einer Weitergabe oder kommerziellen Bereitstellung, statt anzunehmen, ein offenes Repository bedeute uneingeschränkte Nutzung. Qwen-Modelllizenz
Daraus ergibt sich eine andere Art des persönlichen KI-Computers
Die wichtigste Schlussfolgerung lautet nicht, dass Cloud-Inferenz überholt wäre. Ein Desktop hat weiterhin Grenzen bei gleichzeitiger Bereitstellung, Latenz bis zum ersten Token, Energieverbrauch, Wartung und Modellqualität. Ein gehostetes System kann die bessere Wahl bleiben, wenn Verfügbarkeit oder hohes Anfragevolumen wichtiger sind als Kontrolle über die Ausführungsumgebung.
Strata deutet darauf hin, dass die Inferenz für Endverbraucher ebenso stark durch Orchestrierung wie durch GPU-Kapazität begrenzt sein könnte. Eine bessere Nutzung von CPU, RAM und spärlichen Speicherzugriffen kann eine Modellklasse erschließen, die eine vereinfachte Rechnung mit vollständiger GPU-Residenz verwerfen würde. Systemspeicherbandbreite wird damit Teil der Spezifikation eines KI-Computers und ist kein nachträglicher Gedanke.
Das ist eine Schlussfolgerung aus Architektur und veröffentlichten Ergebnissen, keine Garantie für jedes künftige Modell. Sie setzt voraus, dass Modelle spärliche, cachefähige oder abfrageorientierte Komponenten bieten, die eine Laufzeitumgebung nutzen kann. Ein dichtes Modell mit anderen Zugriffsmustern übernimmt diesen Vorteil nicht bloß deshalb, weil es eine ähnliche Parameterzahl hat.
Für einzelne Forschende oder Entwickler ist ein begrenzter Pilotversuch der realistische nächste Schritt: eine festgelegte Version, kurzer Kontext, ein unterstützter Rechner, einige repräsentative Aufgaben und eine ehrliche Aufzeichnung von Qualität und Latenz. Aussagekräftig ist der Meilenstein gerade dann, wenn er so beschrieben wird. Ein sehr großes Modell ist durch sorgfältige Platzierung und Prüfung zu einer plausiblen Desktop-Arbeitslast geworden, nicht durch das Verschwinden der Hardwaregrenzen.
Einrichtungsentscheidungen zusammen mit Forschungsnotizen festhalten
Wenn Sie lokale KI-Konfigurationen vergleichen, bewahren Sie Quellenlinks, Hardwaredetails, Beobachtungen und offene Fragen gemeinsam auf. Telli.sh kann dabei helfen, diese Notizen und Zusammenfassungen zu organisieren, ohne eine integrierte Strata-Anbindung zu suggerieren. Telli.sh-Konto erstellen