[本地 AI 实践笔记 01] Strata 的下一场考验:让大模型在你的 PC 上真正有用
Strata 的 0.2 测试版已成为桌面应用。三个公开的消费级硬件案例,展示了它能做什么、内存代价是什么,以及本地 AI 的下一步。
最有意思的本地 AI 演示,是下周还能继续使用的那一个。让大模型在游戏 PC 上给出聪明的回答,是一个里程碑;明天能重新打开同一段对话、找到模型文件,并安全地让它修改项目,才是实用工具的起点。
Strata 在 2026 年 10 月 19 日发布 0.2.0-beta,向第二个阶段迈进:桌面应用、Terminal 界面,以及单独打包的引擎。到 10 月 23 日,0.2.3 已经发布。选择下载文件时,测试版的准确名称很重要:这是 0.2 版本系列,并不是已经宣布的未来 2.0。测试版发布说明、10 月 23 日发布说明
这是“本地 AI 实践笔记”的第一篇,我们关注的是:这些变化能给已经拥有一台电脑的人带来什么。我们会把新界面与三个公开的硬件案例联系起来,区分模型选项与不同的架构,并探讨哪些进展能让本地推理成为可靠的日常服务。
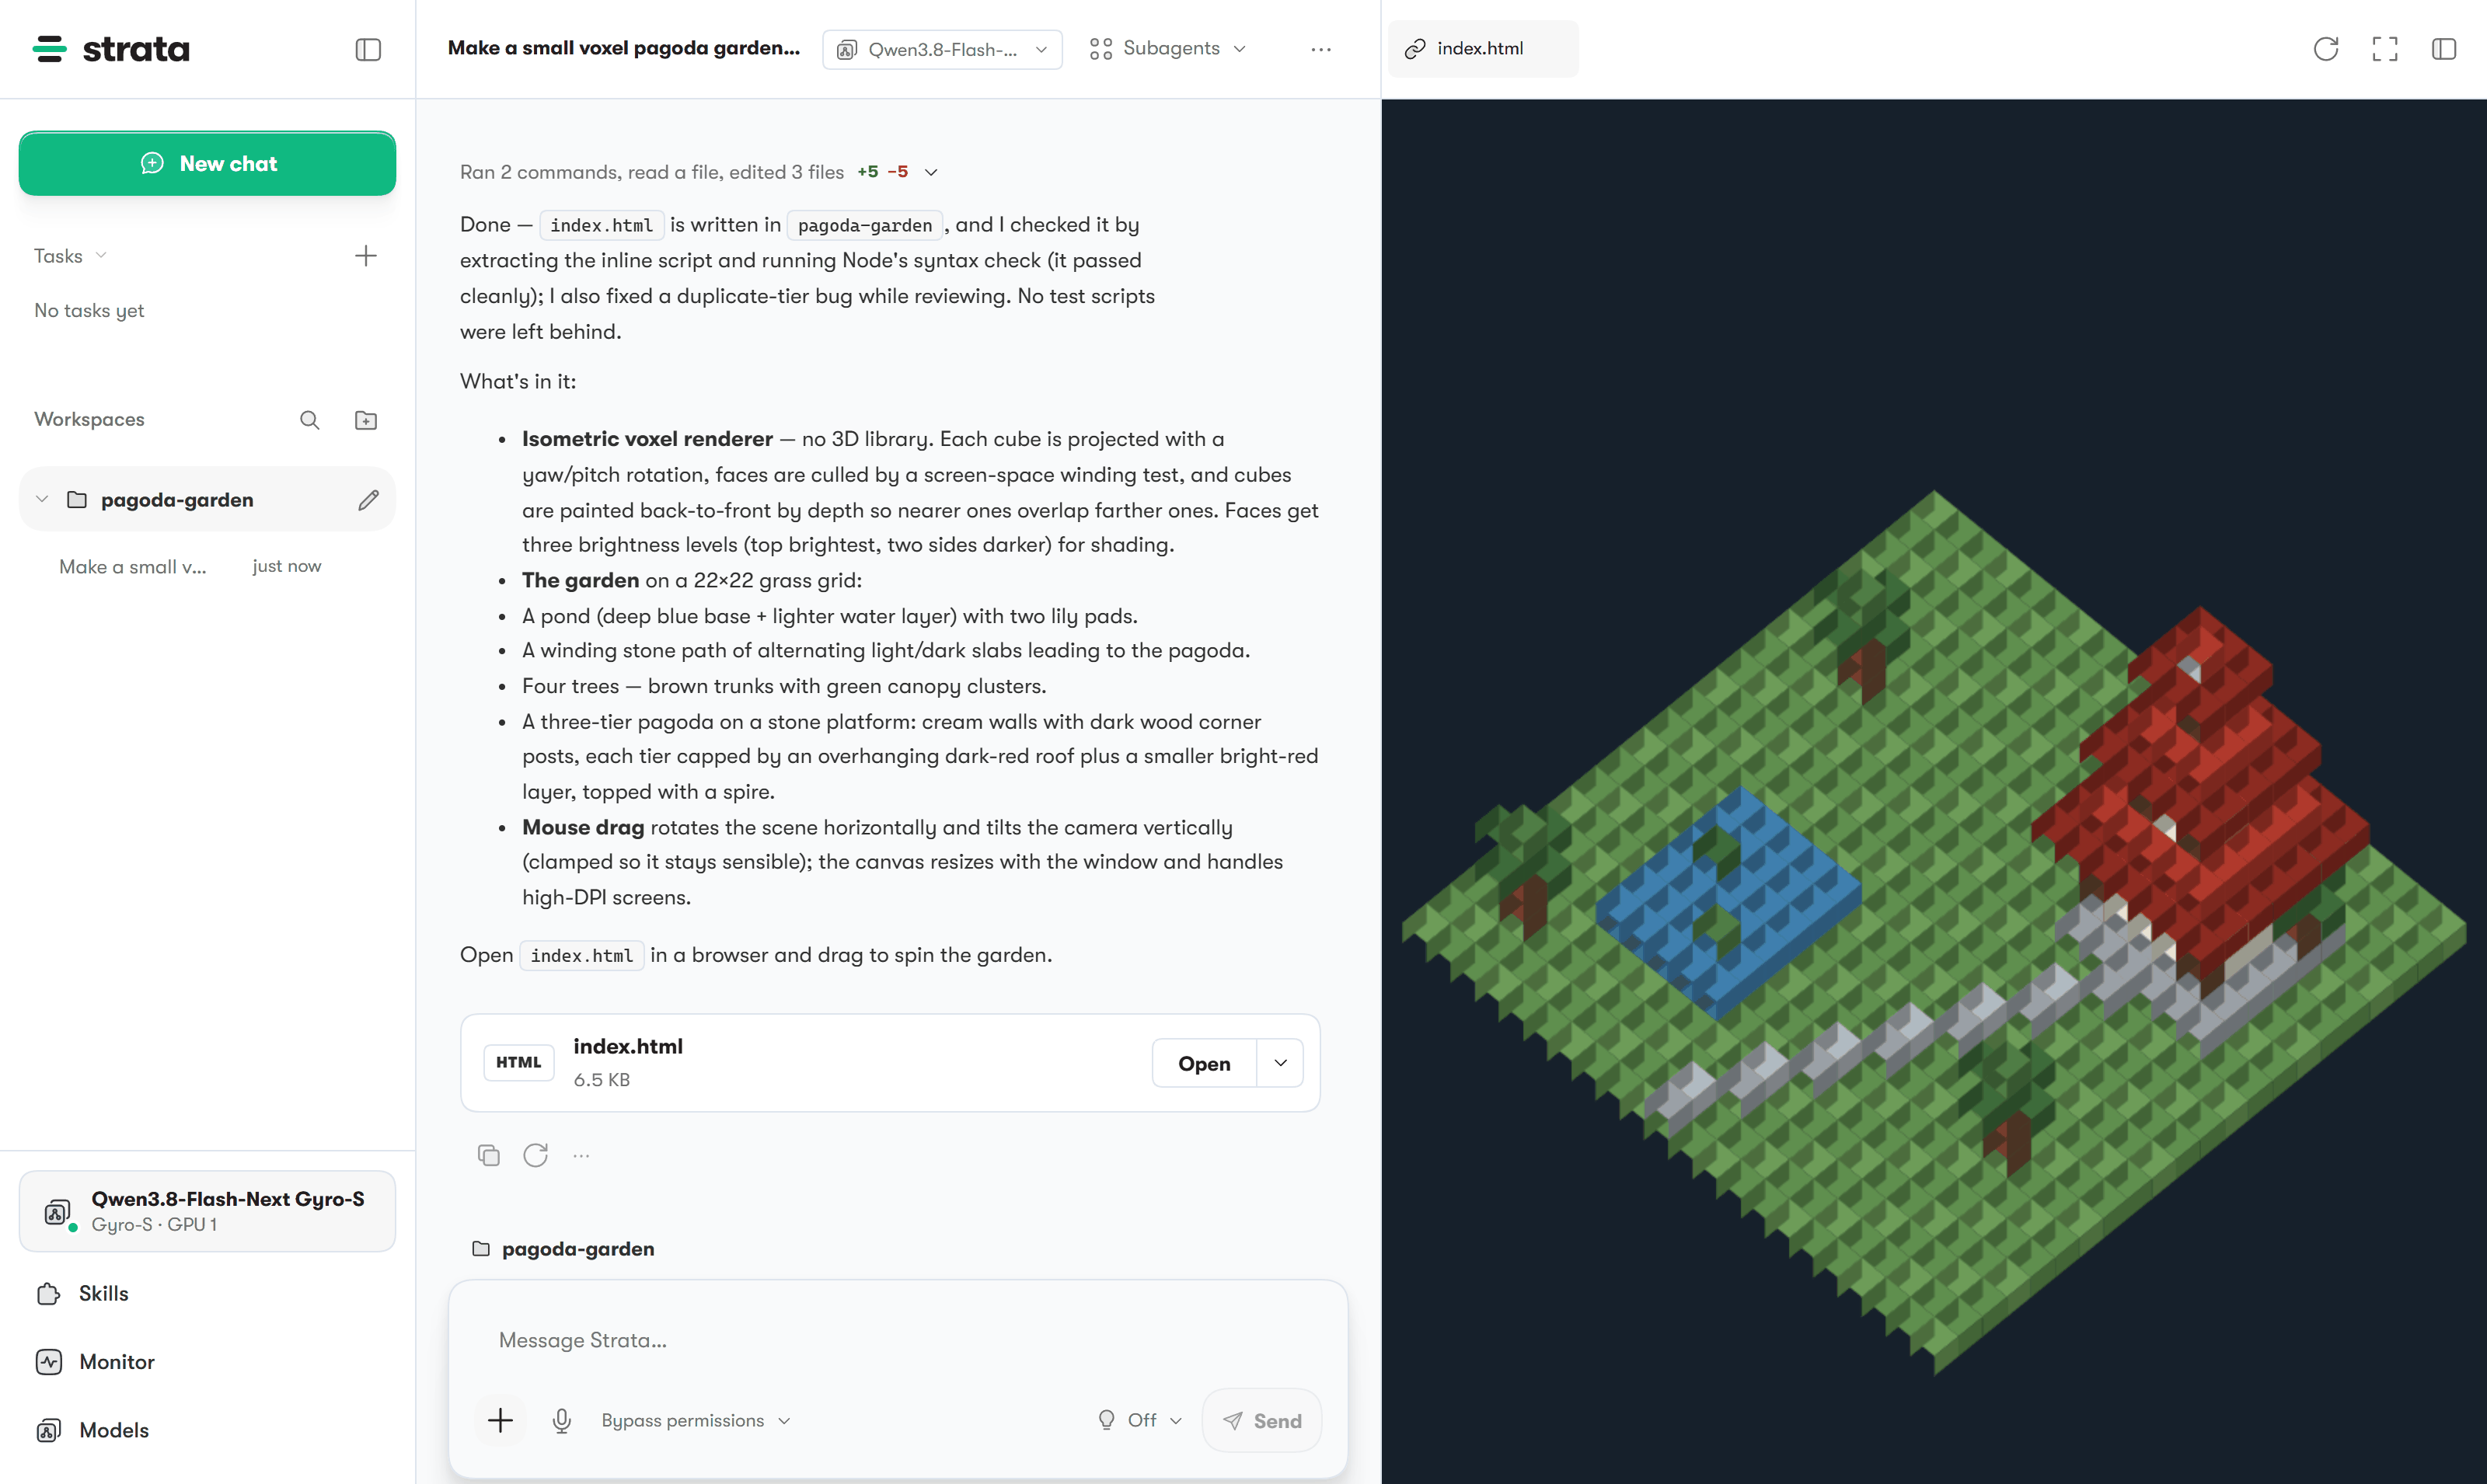
来自 0.2.3 代码仓库的 Strata 官方截图,展示编程对话与 HTML 预览。这张图片用于说明界面,并非本文进行的测试。© 2026 Niko1221 and the Strata contributors; 来源、MIT license。

测试版让引擎变成了可以反复使用的工具
桌面应用把模型选择、存储管理、聊天、硬件监控和编程工作区整合在一起。Manual 权限模式会在修改前询问;权限更宽松的 Bypass 模式则给智能体更大的自由。Terminal 提供引导式的 strata launch 流程,以及与编程客户端的连接。两者共享底层引擎。0.2.0-beta 功能说明
对开发者来说,一个直观的示例场景是:在可以随时丢弃的项目中要求编写一个小解析器,检查建议生成的文件,运行测试,再带着失败用例继续对话。对经常处理文档的人来说,类似的第一项任务,是围绕提供的段落提出范围明确的问题,然后要求给出支持答案的准确引文。这两种场景都不需要把模型变成自主员工。
实际改进在于连续性。图形化模型选择器降低了以不兼容配置启动的可能性;硬件监控有助于解释其他应用为什么会影响性能;保存的预设能把一次成功实验变成可重复的操作。这些功能不会增强模型的推理能力。它们减少的是从拥有这项能力到负责任地使用它之间的工作量。
我们的看法是:本地 AI 的下一轮竞争,就在于缩短这段距离。好的使用体验会让有效配置易于保留,让失败易于理解,让高风险操作易于审查。
整台电脑的内存体系都成为模型的一部分
Strata 的主要目标是 Qwen3.8-Flash-Next,其核心拥有 1,250 亿参数。它的执行策略使用 GPU 显存承担公共计算和经常需要的专家,使用系统 RAM 与 CPU 执行其他专家,并从 SSD 访问 n-gram 查找表。更大显存的显卡会有帮助,但电脑的 RAM 和存储设备仍然处于推理路径之中。项目概览、执行设计
可以把 PC 想象成拥有多张工作台的车间。最快的工作台空间有限,因此运行时必须决定哪些工作值得留在那里。改进这种决策,可以让现有硬件发挥更大作用,却不能让所有工作台都变得一样快。
有三个量值得分别关注。下载文件占用存储空间。加载的权重和运行时缓冲区消耗内存。随着对话增长,上下文窗口会增加工作状态。因此,仅凭文件大小,既无法知道需要多少显存,也无法知道第一个答案会多快出现。
项目当前给出的入门建议是:RAM 与显存合计至少 32 GB,常见配置需要大约 80 GB 可用磁盘空间。这些是入门指引,并不保证所有模型、上下文长度和操作系统都能在这个额度内运行。不应把一台基础的 16 GB 笔记本当成与下文台式机同等的配置。硬件要求
更多模型名称,不一定意味着更多模型架构
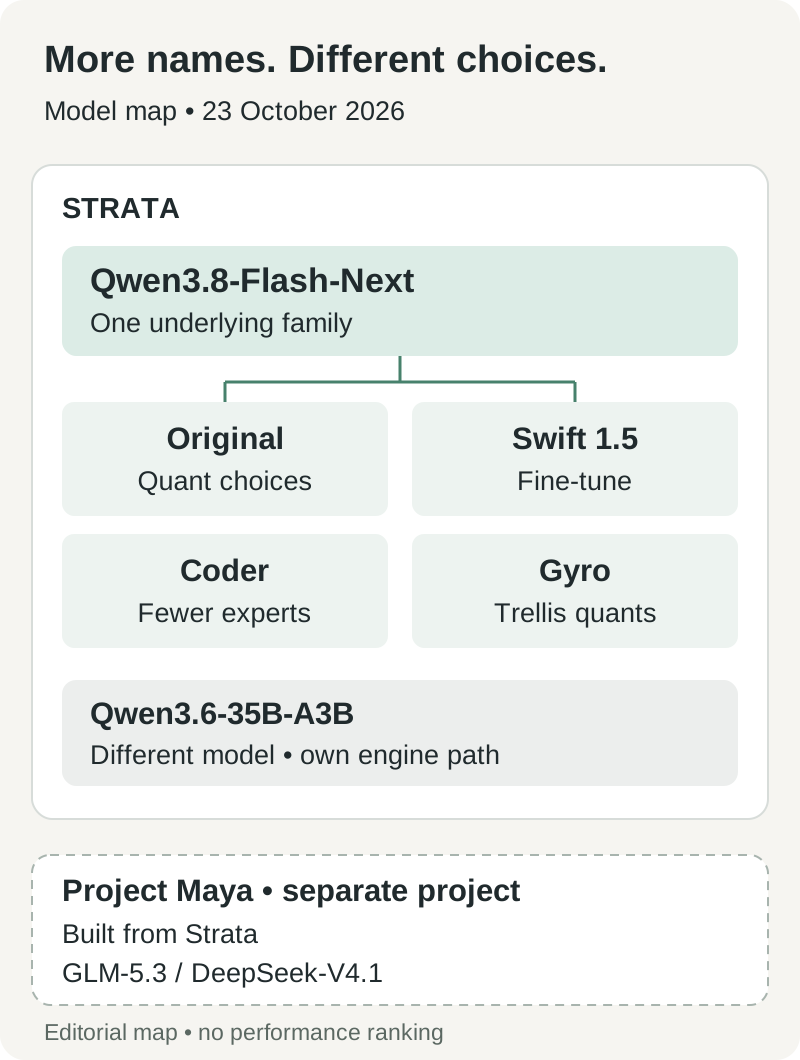
根据文档中的模型关系绘制的原创编辑示意图,核对日期为 10 月 23 日。分支表示谱系和运行时支持,不代表质量相同或文件可以互换。
原版 Flash-Next、Swift 1.5、Coder 和 Gyro,回答的是同一个底层家族中的不同需求。Swift 通过微调改变行为。Coder 移除了被选定为对编程用途较少帮助的专家。Gyro 改变了权重的表示方式。如果把这些名称当成四个毫不相关的基础模型,模型目录就会显得比实际更广泛。模型指南
这些差异会产生实质影响。Coder 在每层的 512 个专家中保留 256 个,项目提醒其通用能力和非英语表现会减弱。一个因为适合编程桌面硬件而选中的模型,不应自动成为多语言文档问答的默认模型。Swift 缩短推理过程,可以减少整体耗时,而不必让硬件生成每个独立 token 的速度变快。版本取舍
Gyro-S 的下载大小为 58.5 GB,但文档给出的 RAM 与显存合计权重内存需求是 27.6 GB。它的 n-gram 表仍放在 SSD 上。项目评估认为,其质量低于更大的低比特选项;适配更少的内存也有代价。Gyro 文档
这里也确实有第二个不同的模型:Qwen3.6-35B-A3B,这是一个总参数 350 亿、激活参数 30 亿的混合专家模型,由单独的引擎路径处理。其文档选项包括在受支持的 NVIDIA 和 AMD 配置上处理图像与并发请求;Mac 引擎不运行它。如果最大的宣传参数量并不是你的真实需求,这个区别就让它成为值得评估的替代选择。Qwen3.6 支持说明
三台公开的机器,展示三种不同的实用价值
以下案例由社区贡献者或项目自身发布。它们测量的是特定配置,并非本文进行的上机测试。目的是展示可行的工作与成本,而不是使用不同的提示词给三台电脑排名。
| 公开案例 | 模型与上下文条件 | 报告结果 | 帮助判断什么 |
|---|---|---|---|
| 社区,10 月 9 日:RTX 3060 12 GB、Core i7-12700、64 GB DDR4-3200、NVMe、Windows 11 | Strata 0.1.41;原版 Q2_0;131,072 token 窗口;4,096 token 的无缓存新提示词,输出 256 token;关闭推理和视觉;运行三次 | 中位数:输出 42.9 token/秒;首 token 等待 4.7 秒;总计 10.6 秒 | 较老的 12 GB 显卡,搭配充足的系统 RAM,也能支持交互式短任务 |
| 社区,10 月 9—10 日:RX 9060 XT 16 GB、Ryzen 7 9800X3D、64 GB DDR5-6000、Windows 11 | 引擎 0.1.40.3;IQ2_XS;122,880 token 窗口;prefill 8,192;8,019 token 的无缓存新输入,低推理设置;运行三次 | 中位数:提示词 879.4 token/秒,输出 56.3 token/秒,总计 11.212 秒 | 对文档规模的输入而言,提示词配置可能与更快的显卡同样重要 |
| 项目测量,截至 10 月 23 日已写入文档:M4 Mac mini、32 GB 统一内存 | Gyro-S;SSD 专家流式加载;11—12 GB 专家内存区;无草稿层;120 token 故事;未注明总窗口大小 | 五组交错配对运行的中位数:输出 9.14 token/秒;另一个 4,065 token 提示词的读取速度为 109 token/秒 | 小型电脑也能运行大模型,但需要接受等待时间上的取舍 |
来源:RTX 3060 报告、RX 9060 XT 报告、Mac 测量。这些报告早于当前应用版本,或使用不同条件。
RTX 3060 案例的价值,在于它包含了输出前的等待时间。一个每秒显示约 43 token 的界面,仍可能在读取问题时停顿。报告还记录了热降速和未经控制的后台活动;它的价值是圈定一台机器的现实表现,而不是给出理想化的 GPU 规格。
对 Radeon 用户来说,还有超出循环测速的具体工作流证据。贡献者通过编程客户端,让每个模型对三个合成 TypeScript 任务各运行三次,IQ2_XS 和 IQ3_XXS 均通过了全部九次任务运行。IQ2 配置更快完成了这些范围明确的任务,同时占用更少的主机内存。这支持尝试可测试的编程工作,但并不证明它们在陌生代码仓库中拥有相同质量。编程对比与测试材料
Mac 案例回答了另一个问题:相对紧凑的 32 GB 系统,到底能不能参与?在公开的流式配置下,可以。但 Mac 文档中另一个约 30K token 的 IQ3_XXS 提示词,需要 5.6 分钟才出现首个输出。可以耐心等待的批处理任务,与对中断敏感的助手,有着不同的延迟预算。Mac 流式测量
读者应该带走的选择标准就在这里。用短问题了解交互表现,用长文档了解提示词成本,用可验证的任务判断答案是否有用。没有一个数字能代替这三项判断。
10 月的修复说明,配置记录里必须有版本号
10 月 23 日的发布说明称,在 Windows Strix Halo 测试机上使用 IQ3_S 时,回答速度提升了 6—19%,测量方式是与 0.2.2 进行三组配对运行。该版本也提供 Intel Arc Linux SYCL 引擎包,测试显卡为 A750。DFlash2 草稿生成仅限 Terminal,且需要主动启用;由于替代方案尚未在所有工作负载上胜出,Auto 仍会选择 MTP。0.2.3 测量与限制
这些改进旁边,还有普通的软件维护工作。10 月 20 日的 v0.2.1.2 标签解决了 Strix Halo 的 Windows 启动问题。硬件指南解释了此前的问题:注册专家内存区耗尽了可用 GPU 显存,导致缓存没有剩余槽位。在纠正内存归属之前,仅有受支持的芯片和安装程序还不够。v0.2.1.2、Strix Halo 启动问题说明
目前也仍有不完善之处。10 月 23 日创建的 Issue #3810 报告了一次 Windows CUDA 配置崩溃,涉及打包的视觉元数据。在本文研究截止时,这是一份等待解决的用户报告,而非所有 Windows 安装都会失败的证据。如果你的使用路径与之相符,请先查看该 Issue 和后续发布说明,再决定是否花几小时重新调整模型。Windows 配置问题报告
升级也值得注意。0.2.3 说明要求 0.2.0-beta 至 0.2.1.2 的用户重新运行 Terminal 安装程序,因为这些版本无法自行切换 Control 组件。安装程序会保留模型和设置。Mac 用户应确认所需的已签名文件是否真的已经发布:同一发布说明的已知限制部分写道,发布时 Mac 构建仍在签名中。升级说明
从一项有用的任务和短上下文开始
你不需要复现超大上下文演示,才能知道这件事是否值得。一个成功的小闭环,就能建立包含失败与修正在内的基线。在投入更多存储空间,或让智能体广泛行动之前,先获得这条基线。
- 选择文档中与你的硬件匹配的路径。 打开官方发布页面,选择匹配的操作系统和 GPU 安装包。分别记录应用与引擎版本。在评估升级时,保留已经能正常工作的安装环境。
- 根据空闲内存、语言和任务选择模型。 第一次尝试时关闭高负载应用。从推荐尺寸、约 8K 上下文、一个并发请求开始。模型文件放在本地 SSD 上。
- 使用引导式设置。 桌面模型选择器或
strata launch会提供模型、存储、上下文、图像和访问设置。第一次编程练习保留仅本地访问和 Manual 权限。Terminal 指南 - 提出可以验证的要求。 试一个带测试的小函数、针对给定文档的三个问题,或一张包含已知标签的截图。保存提示词,并把答案与实际来源或测试输出进行核对。
- 测量完整等待时间。 记录启动时间、首个输出时间、任务总耗时、内存峰值和正确性。然后分别用一次可利用缓存的追问、一次全新提示词重复测试。比较期间保持草稿生成与推理设置不变。
- 一次只增加一个复杂因素。 只有任务需要时才增大上下文。分别评估图像、其他模型或编程客户端连接,这样一旦出现退步,就有具体方向可查。
为了生成可分享的性能报告,Strata 提供 strata bench run。它的标准化协议在 10 月 23 日仍是等待试点验证的草案,并明确把模型加载与计时推理分开。关键习惯现在就有价值:在结果旁附上硬件、量化方式、实际生效的设置和任务结果。基准测试协议
推理留在本地,边界上的决策依然存在
Strata 的隐私文档称,它没有使用情况遥测,下载完成的模型可以离线运行。网页搜索、打开的页面、远程模型服务、隧道和配置的工具,在使用时会建立外部连接。因此,私密的模型对话,也需要私密的外围工作流。网络与下载行为
这对文档和编程示例尤其重要。能够读文件、运行命令的助手,拥有超出文本生成的能力。提供机密材料前,请检查工作目录、建议执行的准确命令,以及任何外部工具端点。保留原始文件和版本历史,让错误修改仍可恢复。
默认推理监听地址是 127.0.0.1;开放网络监听会改变谁能够访问它。Strata 说明了 API 密钥与独立共享监听器,但启用访问的人仍需负责这项决定。兼容 API 让连接客户端更方便,并不意味着所有可能的客户端配置都能保持私密。安全政策
Project Maya 展示了这条思路能走多远,以及代价是什么
更广泛的进展,是这种运行时策略正被适配到其他模型家族。Project Maya 明确将 Strata 列为其引擎、服务器和仪表盘的起点,并为自己的模型进行了大量开发。其文档目标包括 GLM-5.3-Flash,321B,以及 DeepSeek-V4.1-Flash-1017,748B。它是独立项目,并不是 Strata 模型菜单里的一个选项。Maya 模型与致谢
GLM Maya-S 的下载大小为 96.5 GB;DeepSeek Maya-S 选项占用 340 GB,包含 Engram 表。一个社区案例将一张 RTX 5090 与 Ryzen 9 7950X、96 GB RAM 搭配,报告 GLM Maya-M 达到每秒 30 token 以上。这些条件说明,描述消费级配置时,只说“一张 GPU”并不完整。Maya 文件与硬件报告
机会确实存在:一台机器可以结合多个存储与计算层级,服务完整权重超过加速器显存容量的模型。成本也随之增长。数百 GB 下载、模型专用内核、额外系统内存和实验性平台支持,都意味着实际投入。成功移植一个大模型,并不代表已经得到适用于所有架构的通用加载器。
对大多数读者而言,Maya 首先是一项值得关注的进展,还不是建议替换现有方案的对象。真正有用的问题是:另一个模型能否解决当前模型失败的任务,而且收益足以证明新增硬件和维护成本值得?参数量本身回答不了这个问题。
下一个里程碑是可靠完成工作,公开提案正指向那里
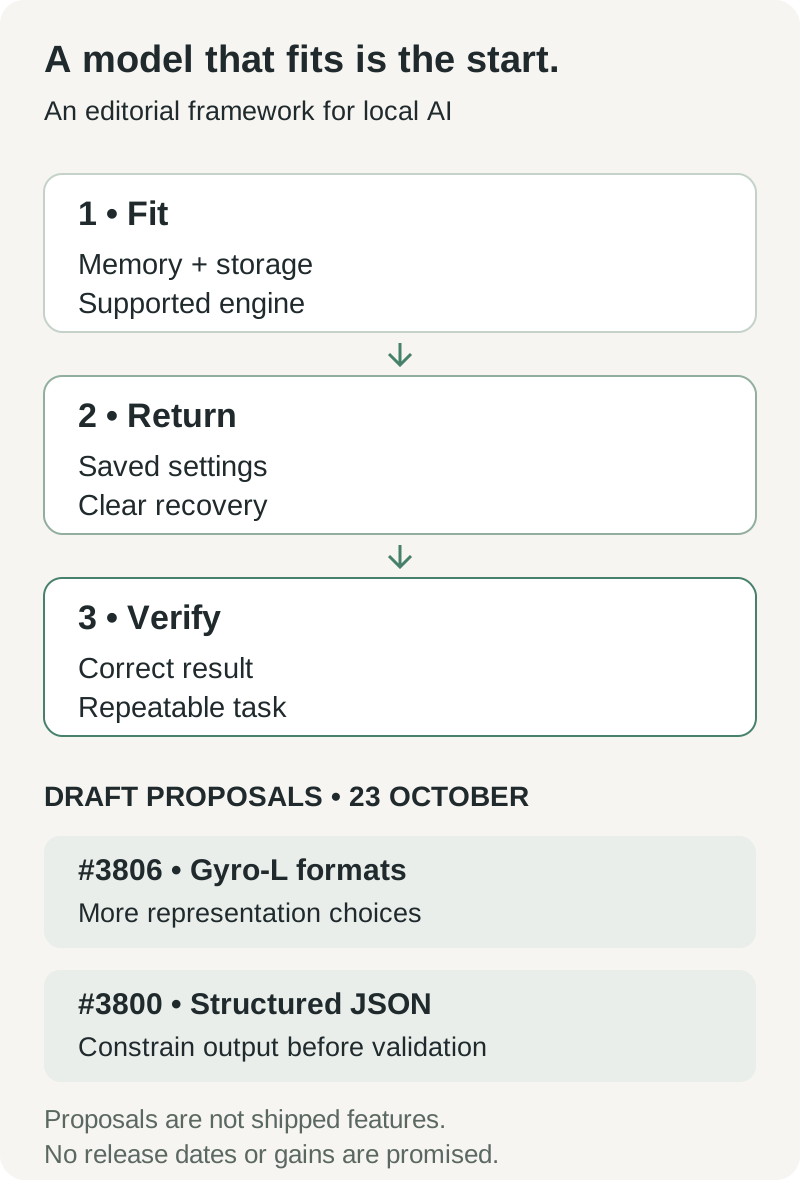
原创编辑框架。上方流程说明采用标准;下方列出 10 月 23 日核对的公开提案。这不是承诺的发布时间表,也不是性能预测。
两个尚未合并的草案拉取请求,比想象中的 2.0 路线图更有参考价值。#3806 提议支持 Gyro-L 目前尚不支持的 trellis 格式。#3800 提议对结构化 JSON 输出进行 token 屏蔽,减少无效生成造成的整次请求重试。两者在 10 月 23 日均为草案,不能列入已发布能力。Gyro-L 提案、结构化输出提案
如果这类工作最终进入可靠版本,两类本地工作负载将受益。更好的格式支持,让用户有更多方法在内存与质量之间取舍。更可靠的结构化输出,则帮助文档提取、标注和工具调用生成可供其他程序安全验证的数据。第二项改进在视频中不那么耀眼,但在重复工作流中可能更有价值。
我们的预期是有条件的:运行时越能保留有效配置、约束内存使用,并从失败中恢复,个人推理就越有用。更多后端移植和更聪明的草稿生成,只有在读者能把它们与实际任务联系起来时,才有帮助。桌面模型要靠产出可检查、可重复的工作成果,赢得自己的位置。
因此,下一台本地 AI 电脑面临的问题很简单:明天,你能否再把同一项有用的任务交给它,并对整个过程足够信任,愿意继续使用?
来源与阅读说明
研究截止日期:2026 年 10 月 23 日。此后,发布状态、Issue 状态和可用文件都可能变化。上述测量保留了原始发布日期与配置;本文没有进行新的推理基准测试。
- Strata 0.2.0-beta、v0.2.1.2,以及 0.2.3 发布说明。
- Strata 模型指南、Qwen3.6 支持说明,以及 Gyro 文档。
- 社区基准测试汇总、Mac 文档,以及基准测试协议草案。
- Project Maya、Strata 官方截图,以及代码仓库许可证。
把本地 AI 的选择与依据保存在一起
比较配置时,请把来源链接、硬件设置、任务结果和修正记录放在一起。随着配置不断演进,Telli.sh 可以帮助整理这些研究笔记与摘要。创建 Telli.sh 账户