[Notas de campo sobre IA local 01] O próximo teste do Strata: tornar um modelo grande útil no seu PC
O beta 0.2 do Strata virou um aplicativo desktop. Três exemplos publicados em hardware de consumo mostram o que funciona, o custo de memória e o futuro da IA local.
A demonstração de IA local mais interessante é aquela que você ainda consegue usar na semana seguinte. Um modelo grande produzindo uma resposta inteligente em um PC gamer é um marco; abrir a mesma conversa amanhã, encontrar os arquivos do modelo e permitir que ele edite um projeto com segurança são os primeiros passos de uma ferramenta útil.
O Strata se aproximou dessa segunda categoria com o 0.2.0-beta em 19 de outubro de 2026: um aplicativo desktop, uma interface Terminal e mecanismos distribuídos em pacotes separados. Em 23 de outubro, o 0.2.3 já havia chegado. O nome real do beta importa na hora de escolher o download: esta é a linha 0.2, e não o anúncio de uma futura versão 2.0. Lançamento beta, lançamento de 23 de outubro
Esta primeira edição de Notas de campo sobre IA local examina o que essa mudança oferece a quem já tem um computador. Vamos relacionar a nova interface a três exemplos de hardware publicados, separar variantes de modelos de arquiteturas diferentes e examinar os avanços que podem tornar a inferência local um serviço confiável no dia a dia.
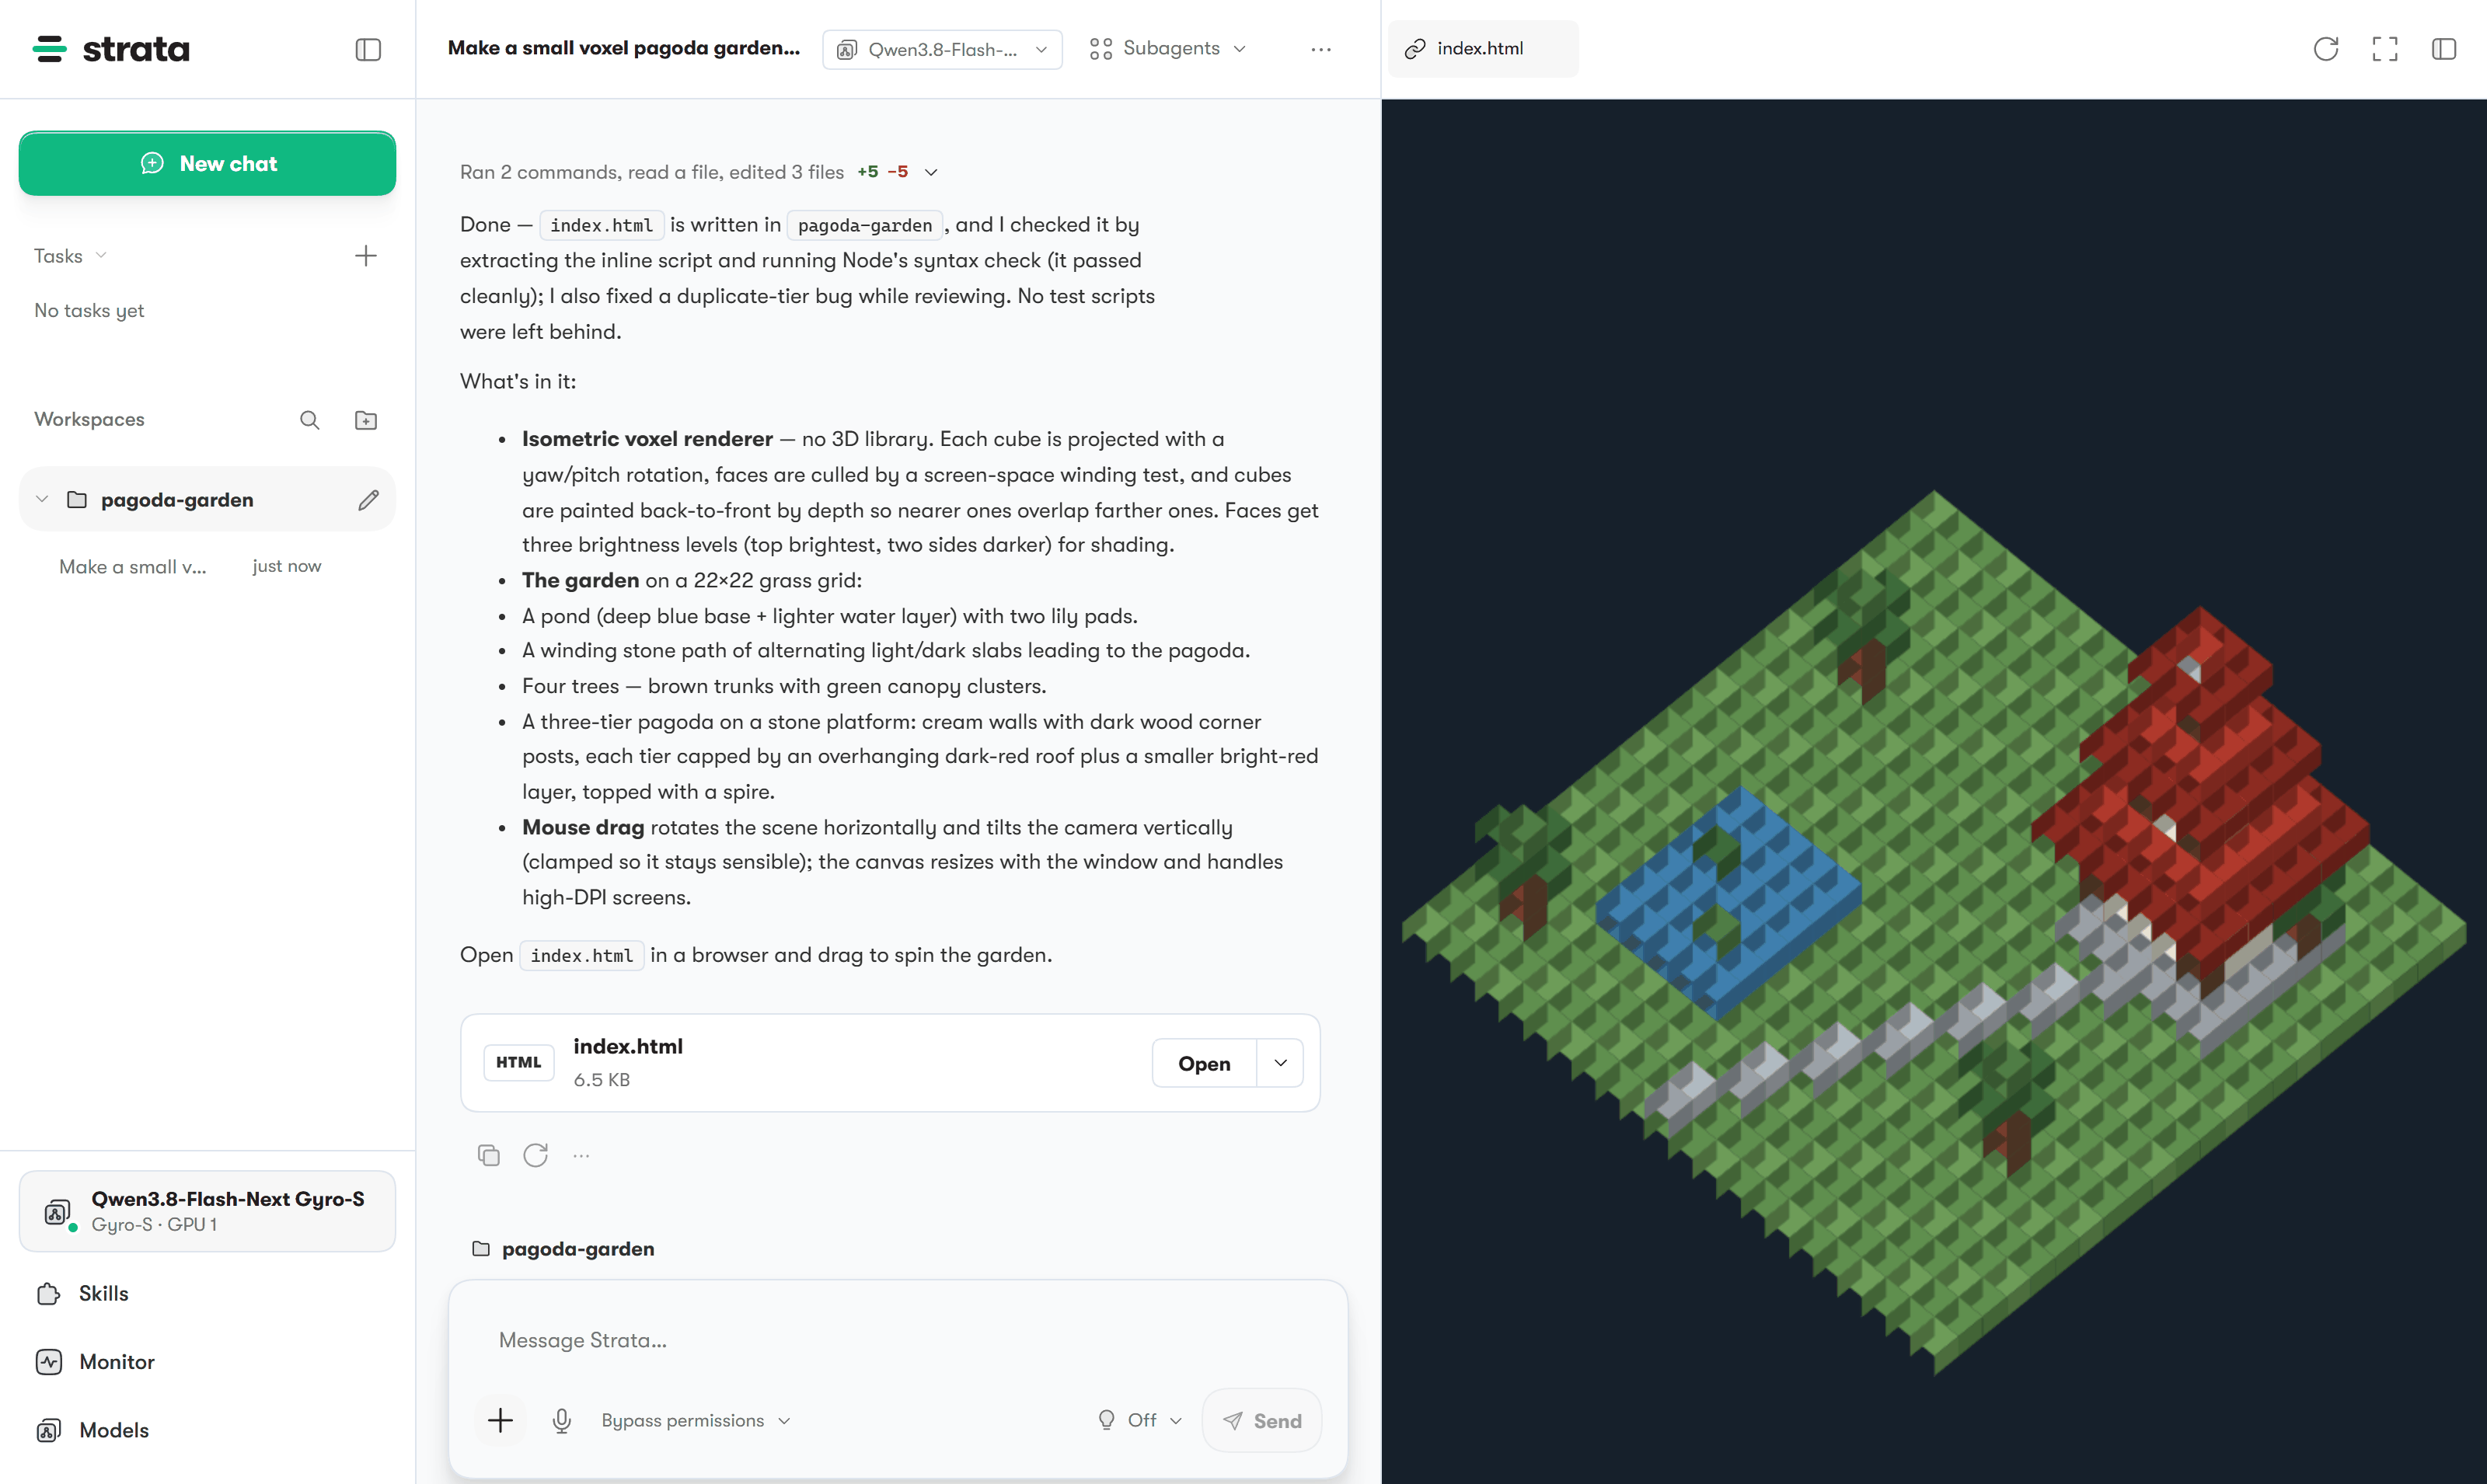
Captura oficial do Strata no repositório 0.2.3, mostrando uma conversa de programação e uma prévia HTML. Ela ilustra a interface, não um teste realizado para este artigo. © 2026 Niko1221 e os colaboradores do Strata; fonte, licença MIT.

O beta transformou o mecanismo em algo a que você pode voltar
O aplicativo desktop reúne seleção de modelos, gerenciamento de armazenamento, chat, monitoramento de hardware e um espaço de trabalho para programação. O modo de permissão Manual pede confirmação antes das alterações; o modo Bypass, mais permissivo, dá maior liberdade ao agente. O Terminal oferece um fluxo guiado com strata launch e conexões com clientes de programação. Ambos compartilham o mecanismo subjacente. Recursos do 0.2.0-beta
Para um desenvolvedor, isso cria um exemplo de uso direto: pedir um pequeno parser em um projeto descartável, inspecionar os arquivos propostos, executar os testes e continuar a conversa com um exemplo que falha. Para quem trabalha com muitos documentos, uma primeira tarefa equivalente é uma pergunta delimitada sobre um trecho fornecido, seguida de um pedido da citação exata que sustenta a resposta. Nenhum dos cenários exige transformar o modelo em um funcionário autônomo.
A melhoria prática é a continuidade. Um seletor gráfico de modelos reduz a chance de iniciar uma configuração incompatível; um monitor de hardware ajuda a explicar por que outro aplicativo altera o desempenho; uma predefinição salva transforma um experimento bem-sucedido em algo repetível. Esses recursos não aumentam a capacidade de raciocínio do modelo. Eles reduzem o trabalho entre ter essa capacidade disponível e usá-la com responsabilidade.
Nossa leitura é esta: a próxima disputa da IA local será por essa distância. A experiência vencedora facilitará manter uma boa configuração, entender uma falha e revisar uma ação arriscada.
Todo o sistema de memória do computador passa a fazer parte do modelo
O principal alvo do Strata é o Qwen3.8-Flash-Next, cujo núcleo tem 125 bilhões de parâmetros. Sua estratégia de execução usa a memória da GPU para cálculos comuns e especialistas frequentemente necessários, RAM do sistema e execução na CPU para outros especialistas, e acesso ao SSD para a tabela de consulta de n-gramas. Uma placa de vídeo maior ajuda, mas a RAM e o armazenamento continuam no caminho da inferência. Visão geral do projeto, projeto de execução
Pense no PC como uma oficina com várias bancadas. A mais rápida tem espaço limitado, então o runtime precisa decidir qual trabalho merece permanecer ali. Melhorar essa decisão pode tornar o hardware existente mais útil; não pode tornar todas as bancadas igualmente rápidas.
Três grandezas merecem atenção separada. O download ocupa armazenamento. Os pesos carregados e os buffers do runtime consomem memória. A janela de contexto acrescenta estado de trabalho conforme a conversa cresce. Portanto, o tamanho de um arquivo, sozinho, não informa quanta VRAM você precisa nem em quanto tempo aparece a primeira resposta.
A orientação inicial atual do projeto é de pelo menos 32 GB de RAM e VRAM somadas, com cerca de 80 GB livres em disco para a configuração habitual. São orientações de entrada, não uma promessa de que qualquer modelo, tamanho de contexto ou sistema operacional caiba nesse limite. Um notebook básico de 16 GB não deve ser tratado como equivalente aos desktops abaixo. Requisitos de hardware
Mais nomes de modelos nem sempre significam mais arquiteturas
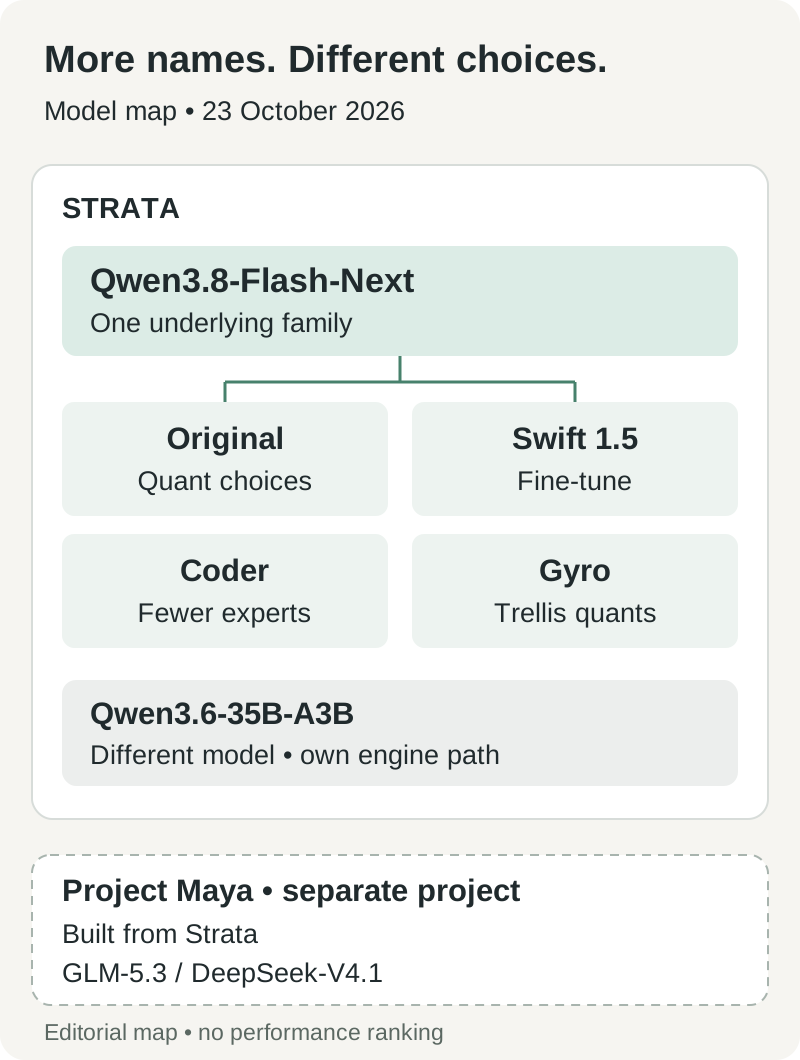
Mapa editorial original das relações documentadas entre modelos, verificado em 23 de outubro. Os ramos mostram linhagem e suporte do runtime, não qualidade equivalente ou arquivos intercambiáveis.
As opções Flash-Next original, Swift 1.5, Coder e Gyro respondem a perguntas diferentes sobre a mesma família. Swift altera o comportamento por meio de ajuste fino. Coder remove especialistas selecionados como menos úteis para seu foco em programação. Gyro muda a representação dos pesos. Tratar esses nomes como quatro modelos fundamentais sem relação faz o catálogo parecer mais amplo do que é. Guia de modelos
Essas diferenças têm consequências. O Coder mantém 256 dos 512 especialistas de cada camada, e o projeto alerta para desempenho inferior em tarefas gerais e em idiomas além do inglês. Um modelo escolhido porque cabe em um desktop de programação não deve virar automaticamente o padrão para perguntas sobre documentos multilíngues. O raciocínio mais curto do Swift pode reduzir o tempo total sem fazer o hardware gerar cada token mais rapidamente. Compromissos entre versões
O Gyro-S exige um download de 58,5 GB, embora seu requisito documentado de memória para pesos, somando RAM e VRAM, seja de 27,6 GB. Sua tabela de n-gramas permanece no SSD. A avaliação do projeto situa sua qualidade abaixo das opções maiores de baixa precisão; caber em menos memória tem um preço. Documentação do Gyro
Também existe de fato um segundo modelo: Qwen3.6-35B-A3B, uma mistura de especialistas com 35 bilhões de parâmetros e 3 bilhões ativos, atendida por um caminho de mecanismo separado. As opções documentadas incluem imagens e solicitações simultâneas nas configurações NVIDIA e AMD compatíveis; o mecanismo do Mac não o executa. Essa distinção o torna uma alternativa útil a avaliar quando o maior número de parâmetros da manchete não é sua necessidade real. Suporte ao Qwen3.6
Três máquinas documentadas mostram três tipos diferentes de utilidade
Os exemplos abaixo foram publicados por colaboradores da comunidade ou pelo próprio projeto. São medições de configurações específicas, não testes práticos feitos para este artigo. O objetivo é mostrar trabalhos plausíveis e seu custo, não classificar três computadores com prompts incompatíveis.
| Exemplo publicado | Modelo e condições de contexto | Resultado relatado | O que ajuda você a decidir |
|---|---|---|---|
| Comunidade, 9 de outubro: RTX 3060 12 GB, Core i7-12700, 64 GB DDR4-3200, NVMe, Windows 11 | Strata 0.1.41; Q2_0 original; janela de 131.072 tokens; prompt novo de 4.096 tokens, 256 tokens de saída; raciocínio e visão desativados; três execuções | Mediana de 42,9 tokens de saída/s; 4,7 segundos até o primeiro token; 10,6 segundos no total | Uma placa antiga de 12 GB pode sustentar tarefas curtas e interativas quando acompanhada de bastante RAM do sistema |
| Comunidade, 9–10 de outubro: RX 9060 XT 16 GB, Ryzen 7 9800X3D, 64 GB DDR5-6000, Windows 11 | Mecanismo 0.1.40.3; IQ2_XS; janela de 122.880 tokens; prefill 8.192; entrada nova de 8.019 tokens, raciocínio baixo; três execuções | Mediana de 879,4 tokens de prompt/s, 56,3 tokens de saída/s, 11,212 segundos no total | A configuração do prompt pode importar tanto quanto uma placa mais rápida para entradas do tamanho de documentos |
| Medição do projeto, documentada até 23 de outubro: Mac mini M4, 32 GB de memória unificada | Gyro-S; streaming de especialistas pelo SSD; arena de especialistas de 11–12 GB; sem camada de rascunho; história de 120 tokens; janela total não especificada | Mediana de 9,14 tokens de saída/s em cinco pares intercalados; um prompt separado de 4.065 tokens lido a 109 tokens/s | Uma máquina compacta pode executar um modelo grande, em troca de maior tempo de espera |
Fontes: relato da RTX 3060, relato da RX 9060 XT, medições no Mac. Esses relatos são anteriores à versão atual do aplicativo ou usam condições diferentes.
O exemplo da RTX 3060 é útil porque inclui a espera antes da saída. Uma interface exibindo aproximadamente 43 tokens por segundo ainda pode pausar enquanto lê a pergunta. O relato também registra redução de desempenho por temperatura e atividade em segundo plano sem controle; seu valor é delimitar uma máquina de forma realista, em vez de apresentar uma especificação idealizada de GPU.
Para o usuário de Radeon, há evidência de um fluxo concreto além de um ciclo de medição de velocidade. O colaborador executou três tarefas sintéticas de TypeScript três vezes por modelo por meio de um cliente de programação, com IQ2_XS e IQ3_XXS aprovados nas nove execuções cada. A configuração IQ2 terminou essas tarefas delimitadas mais rápido, consumindo menos memória do sistema. Isso sustenta experimentar tarefas de programação verificáveis; não estabelece qualidade equivalente em um repositório desconhecido. Comparação de programação e casos de teste
O exemplo do Mac responde a outra pergunta: um sistema relativamente compacto de 32 GB consegue participar? Sim, na configuração de streaming publicada. Mas um prompt IQ3_XXS separado, de cerca de 30 mil tokens, levou 5,6 minutos até a primeira saída na documentação do Mac. Uma tarefa em lote que pode esperar e um assistente sensível a interrupções têm exigências de latência diferentes. Medições de streaming no Mac
Essa é a escolha que o leitor deve guardar. Use uma pergunta curta para descobrir o comportamento interativo, um documento longo para descobrir o custo do prompt e uma tarefa verificada para descobrir se as respostas são úteis. Nenhum número representa os três aspectos.
As correções de outubro mostram por que registrar os números de versão
A versão de 23 de outubro relata uma melhoria de 6–19% na velocidade das respostas em sua máquina de teste Windows Strix Halo com IQ3_S, medida em três execuções pareadas contra a 0.2.2. Ela também inclui um pacote de mecanismo Intel Arc Linux SYCL, tendo a A750 como placa testada. A geração de rascunhos DFlash2 está disponível apenas no Terminal e exige ativação; Auto continua selecionando MTP porque a alternativa não venceu em todos os tipos de carga. Medições e limites da 0.2.3
Essas melhorias convivem com a manutenção comum de software. A tag v0.2.1.2, de 20 de outubro, corrigiu a inicialização do Strix Halo no Windows. O guia de hardware explica o problema anterior: registrar a arena de especialistas esgotava a memória disponível da GPU, sem deixar espaço para o cache. Um chip compatível e um instalador não bastavam até que a gestão da memória fosse corrigida. v0.2.1.2, explicação da inicialização no Strix Halo
Também há arestas atuais. A issue #3810, aberta em 23 de outubro, relata uma falha na configuração CUDA do Windows envolvendo os metadados de visão incluídos no pacote. Era um relato de usuário aguardando solução na data de corte da pesquisa, não uma prova de que toda instalação no Windows falha. Se seu caminho coincidir com esse caso, confira a issue e as notas de versões posteriores antes de passar horas reajustando um modelo. Relato de configuração no Windows
Atualizações também merecem atenção: as notas da 0.2.3 orientam usuários da 0.2.0-beta até a 0.2.1.2 a executar novamente o instalador do Terminal, pois essas versões não conseguem trocar os componentes Control por conta própria. O instalador preserva modelos e configurações. No Mac, verifique se o artefato assinado desejado realmente foi disponibilizado: a seção de limites conhecidos da mesma versão dizia que as compilações para Mac ainda estavam sendo assinadas na publicação. Instruções de atualização
Comece com uma tarefa útil e um contexto curto
Você não precisa reproduzir uma demonstração de contexto enorme para descobrir se vale a pena. Um pequeno ciclo bem-sucedido fornece uma referência, incluindo falhas e correções, antes de comprometer mais armazenamento ou deixar um agente agir amplamente.
- Escolha o caminho documentado para seu hardware. Abra a página oficial de versões e selecione o pacote correspondente ao sistema operacional e à GPU. Registre separadamente as versões do aplicativo e do mecanismo. Preserve uma instalação que já funciona enquanto avalia a atualização.
- Selecione o modelo pela memória livre, pelo idioma e pela tarefa. Feche aplicativos pesados no primeiro teste. Comece pelo tamanho recomendado, com contexto de aproximadamente 8K e uma solicitação simultânea. Mantenha os arquivos do modelo em um SSD local.
- Use a configuração guiada. O seletor do aplicativo desktop ou
strata launchapresenta configurações de modelo, armazenamento, contexto, imagens e acesso. Mantenha acesso apenas local e permissões Manual no primeiro exercício de programação. Guia do Terminal - Pergunte algo que você possa verificar. Experimente uma pequena função com testes, três perguntas sobre um documento fornecido ou uma captura de tela com rótulos conhecidos. Salve o prompt e confira a resposta com a fonte real ou com a saída dos testes.
- Meça toda a espera. Registre inicialização, tempo até a primeira saída, duração total da tarefa, pico de memória e correção. Depois, repita uma vez com uma continuação em cache e outra com um prompt novo. Mantenha as configurações de rascunho e raciocínio inalteradas durante a comparação.
- Acrescente complexidade uma variável de cada vez. Aumente o contexto somente quando a tarefa exigir. Avalie imagens, outro modelo ou uma conexão com um cliente de programação separadamente, para que uma regressão tenha uma origem concreta a investigar.
Para relatórios de desempenho compartilháveis, o Strata oferece strata bench run. Seu protocolo padronizado ainda era um rascunho aguardando validação piloto em 23 de outubro e separa explicitamente o carregamento do modelo da inferência cronometrada. O hábito importante já é útil: anexar hardware, quantização, configurações efetivas e resultados das tarefas à medição. Protocolo de benchmark
Manter a inferência local ainda deixa decisões nas bordas
A documentação de privacidade do Strata afirma que não há telemetria de uso e que os modelos baixados podem rodar offline. Pesquisa na web, páginas abertas, serviços remotos de modelos, túneis e ferramentas configuradas criam conexões externas quando usados. Uma conversa privada com o modelo também precisa, portanto, de um fluxo de trabalho privado ao redor. Comportamento de rede e downloads
Isso é especialmente relevante para os exemplos com documentos e programação. Um assistente que pode ler arquivos e executar comandos tem capacidades além da geração de texto. Revise a pasta de trabalho, o comando exato proposto e qualquer endpoint de ferramenta externa antes de fornecer material confidencial. Preserve os originais e o histórico de versões para que uma edição incorreta continue recuperável.
O listener padrão de inferência usa 127.0.0.1; abrir um listener de rede muda quem pode acessá-lo. O Strata documenta chaves de API e seu listener separado de compartilhamento, mas a decisão continua pertencendo à pessoa que habilita o acesso. Uma API compatível facilita conectar um cliente, sem tornar privada toda configuração possível desse cliente. Política de segurança
O Project Maya mostra até onde a ideia vai — e quanto custa
O movimento mais amplo é a adaptação da estratégia de runtime a outras famílias de modelos. O Project Maya credita explicitamente o Strata como ponto de partida para seu mecanismo, servidor e dashboard, com trabalho substancial para seus próprios modelos. Seus alvos documentados incluem GLM-5.3-Flash, 321B, e DeepSeek-V4.1-Flash-1017, 748B. Trata-se de um projeto separado, não de uma opção no menu de modelos do Strata. Modelos e créditos do Maya
O download do GLM Maya-S tem 96,5 GB; a opção DeepSeek Maya-S ocupa 340 GB incluindo tabelas Engram. Um exemplo da comunidade combina uma RTX 5090 com um Ryzen 9 7950X e 96 GB de RAM, relatando mais de 30 tokens por segundo no GLM Maya-M. Essas condições explicam por que “uma GPU” é uma descrição incompleta de uma configuração de consumo. Arquivos do Maya e relatos de hardware
A oportunidade é real: uma máquina pode combinar vários níveis de armazenamento e computação para servir um modelo cujos pesos completos excedem a memória do acelerador. O custo também cresce. Centenas de gigabytes de downloads, kernels específicos por modelo, memória livre no sistema e suporte experimental a plataformas são compromissos importantes. Uma adaptação bem-sucedida de um modelo grande não estabelece um carregador universal para qualquer arquitetura.
Para a maioria dos leitores, o Maya é um desenvolvimento a acompanhar antes de ser uma recomendação de substituição. A pergunta útil é se um modelo diferente resolve uma tarefa em que o atual falha, com benefício suficiente para justificar o hardware e a manutenção adicionais. A contagem de parâmetros sozinha não responde.
O próximo marco é trabalho confiável, e as propostas públicas apontam nessa direção
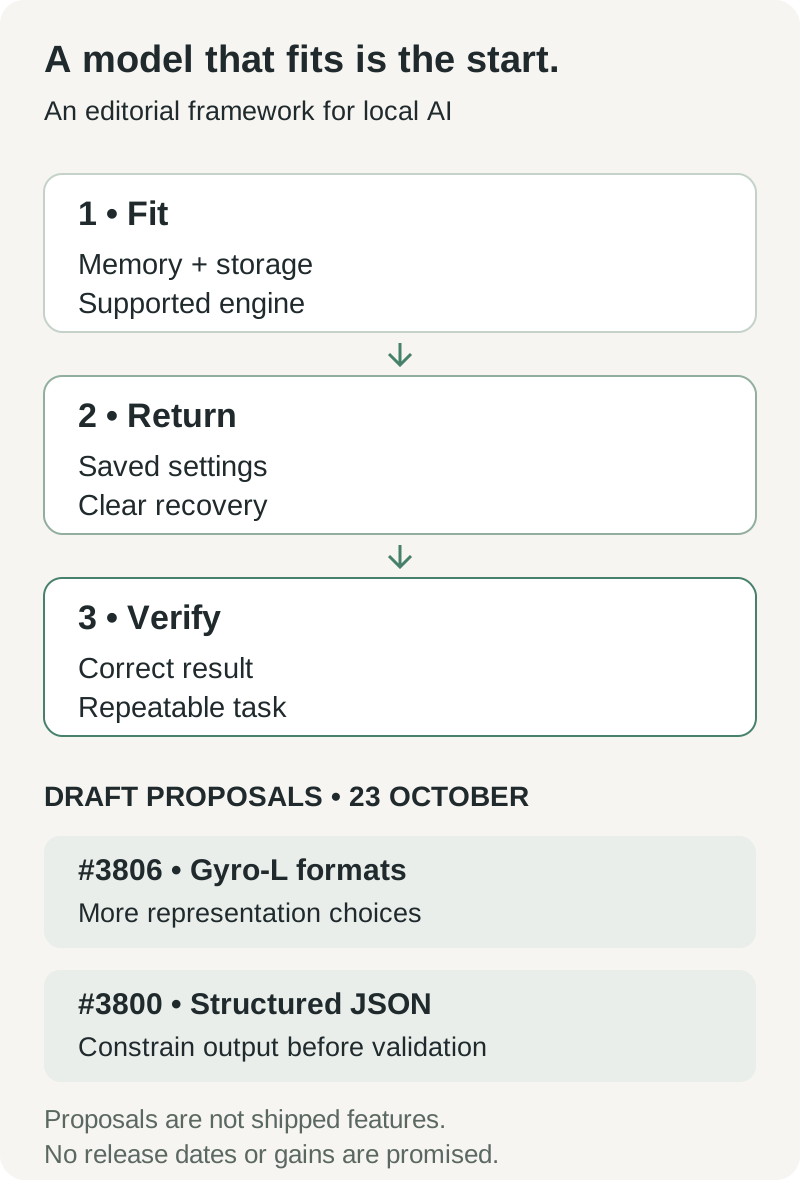
Estrutura editorial original. A sequência superior descreve critérios de adoção; a linha inferior identifica propostas públicas verificadas em 23 de outubro. Não é um cronograma prometido de lançamentos nem uma previsão de desempenho.
Dois pull requests abertos como rascunho oferecem sinais mais concretos que um roteiro imaginário da versão 2.0. O #3806 propõe suporte aos formatos trellis do Gyro-L, atualmente sem suporte. O #3800 propõe mascaramento de tokens para saídas JSON estruturadas, reduzindo a necessidade de repetir solicitações inteiras após gerações inválidas. Ambos eram rascunhos em 23 de outubro; nenhum pertence à lista de capacidades já lançadas. Proposta do Gyro-L, proposta de saída estruturada
Se trabalhos assim chegarem a uma versão confiável, dois tipos de tarefas locais serão beneficiados. Melhor suporte a formatos oferece mais maneiras de equilibrar memória e qualidade. Saídas estruturadas mais confiáveis ajudam extração de documentos, rotulagem e chamadas de ferramentas a produzir dados que outro programa possa validar com segurança. A segunda melhoria impressiona menos em vídeo, mas pode ser mais valiosa em um fluxo repetido.
Nossa expectativa é condicional: a inferência pessoal fica mais útil quando os runtimes preservam configurações funcionais, limitam seu uso de memória e se recuperam de falhas. Mais adaptações de backends e rascunhos mais inteligentes só ajudam quando o leitor consegue relacioná-los a uma tarefa real. Um modelo desktop conquista seu espaço ao produzir trabalho que você consegue conferir e repetir.
A pergunta para o próximo computador com IA local é simples: você consegue entregar a ele a mesma tarefa útil amanhã e confiar no processo o suficiente para continuar usando?
Fontes e notas de leitura
Data de corte da pesquisa: 23 de outubro de 2026. O estado de versões, issues e artefatos disponíveis pode mudar depois dessa data. As medições acima mantêm suas datas originais de publicação e configurações; nenhum novo benchmark de inferência foi realizado para este artigo.
- Strata 0.2.0-beta, v0.2.1.2 e notas da versão 0.2.3.
- Guia de modelos do Strata, suporte ao Qwen3.6 e documentação do Gyro.
- Coleção de benchmarks da comunidade, documentação do Mac e rascunho do protocolo de benchmark.
- Project Maya, captura oficial do Strata e licença do repositório.
Guarde suas decisões sobre IA local junto das evidências
Ao comparar configurações, mantenha juntos os links das fontes, os ajustes de hardware, os resultados das tarefas e as correções. O Telli.sh pode ajudar a organizar essas notas de pesquisa e resumos conforme sua configuração evolui. Crie uma conta no Telli.sh