[Praxisnotizen zur lokalen KI 01] Stratas nächste Bewährungsprobe: ein großes Modell auf dem eigenen PC sinnvoll nutzen
Stratas 0.2-Beta wurde zur Desktop-App. Drei veröffentlichte Beispiele mit Consumer-Hardware zeigen, was funktioniert, wie viel Speicher es kostet und wohin sich lokale KI entwickelt.
Die interessanteste Demo lokaler KI ist die, die sich auch nächste Woche noch nutzen lässt. Ein großes Modell, das auf einem Gaming-PC eine kluge Antwort erzeugt, ist ein Meilenstein. Doch erst wenn man morgen dasselbe Gespräch wieder öffnen, die Modelldateien finden und das Modell sicher an einem Projekt arbeiten lassen kann, entsteht ein nützliches Werkzeug.
Mit 0.2.0-beta vom 19. Oktober 2026 machte Strata einen Schritt in diese Richtung: eine Desktop-App, eine Terminal-Oberfläche und separat bereitgestellte Engines. Bis zum 23. Oktober folgte 0.2.3. Beim Herunterladen zählt die tatsächliche Versionsbezeichnung: Es handelt sich um die Versionsreihe 0.2, nicht um eine angekündigte künftige Version 2.0. Beta-Veröffentlichung, Veröffentlichung vom 23. Oktober
Dieser erste Teil unserer Praxisnotizen zur lokalen KI untersucht, was diese Veränderung Menschen mit einem bereits vorhandenen Computer bringt. Wir verbinden die neue Oberfläche mit drei veröffentlichten Hardware-Beispielen, unterscheiden Modellvarianten von eigenständigen Architekturen und betrachten Entwicklungen, die lokale Inferenz zu einem verlässlichen Dienst im Alltag machen könnten.
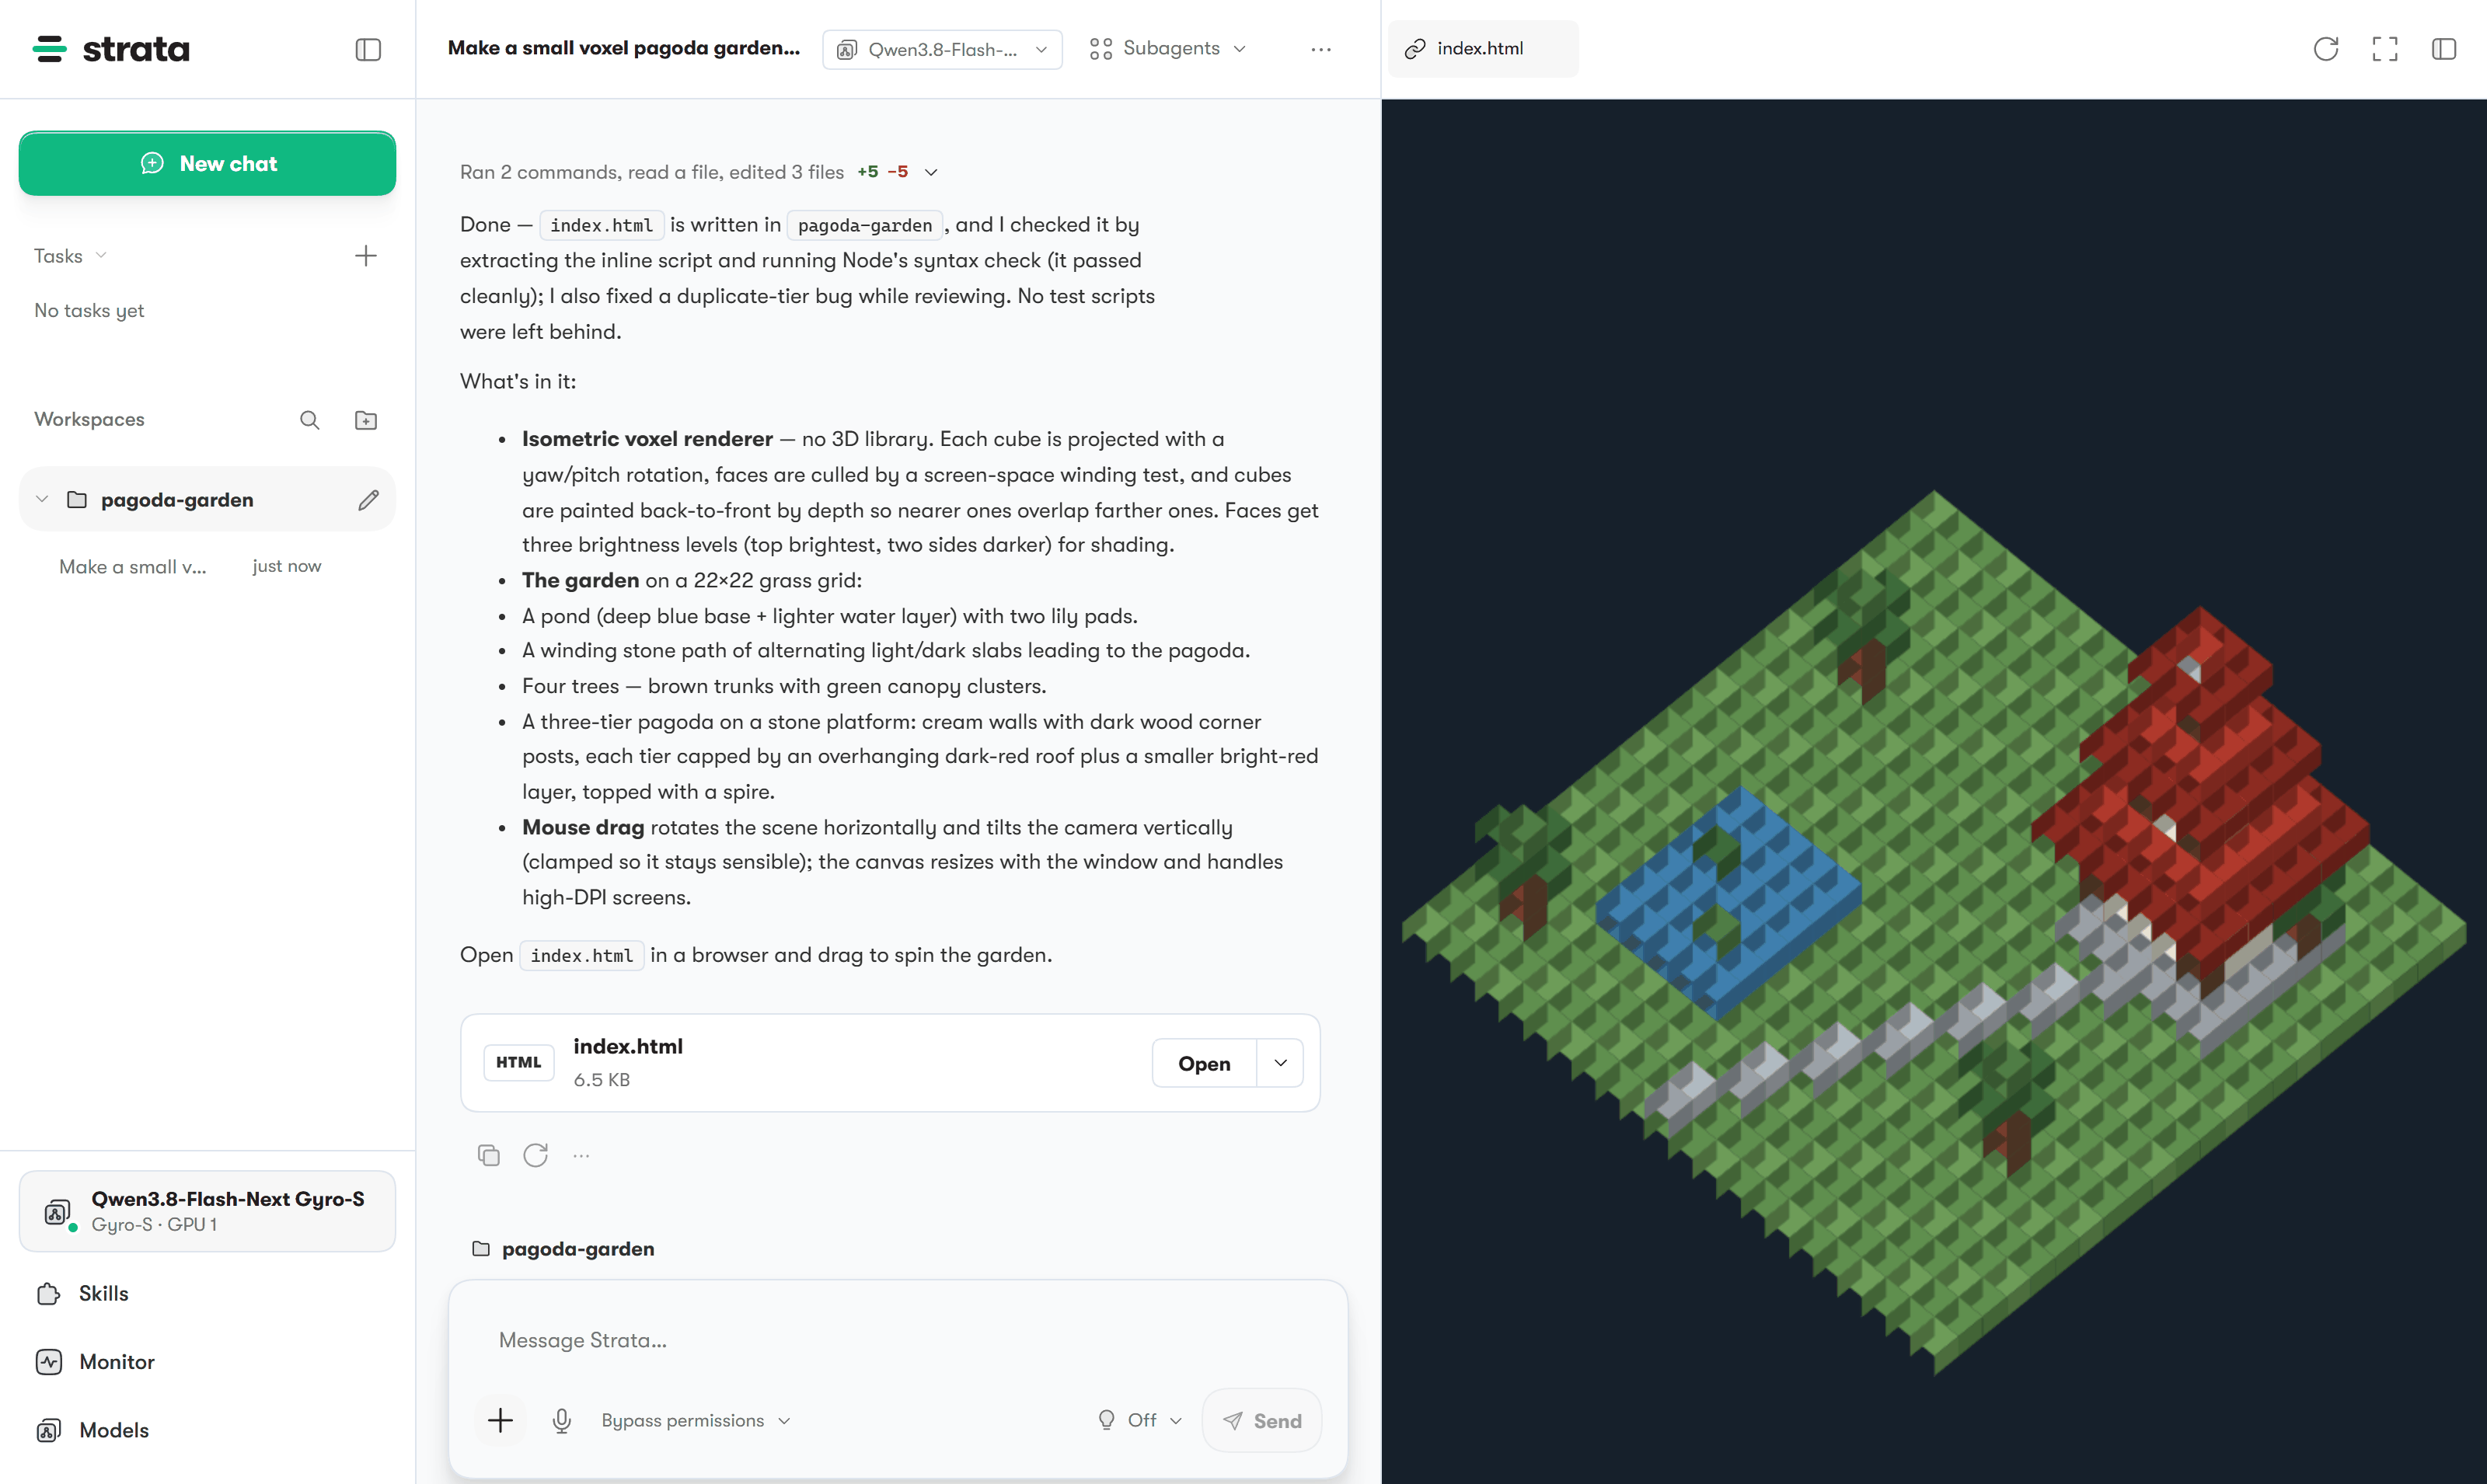
Offizieller Strata-Screenshot aus dem Repository zur Version 0.2.3 mit Programmiergespräch und HTML-Vorschau. Er veranschaulicht die Oberfläche; er stammt nicht aus einem Test für diesen Artikel. © 2026 Niko1221 und die Strata-Mitwirkenden; Quelle, MIT-Lizenz.

Die Beta macht aus der Engine ein Werkzeug, zu dem man zurückkehren kann
Die Desktop-App vereint Modellauswahl, Speicherverwaltung, Chat, Hardware-Überwachung und eine Programmierumgebung. Im Berechtigungsmodus Manual fragt sie vor Änderungen nach; der großzügigere Modus Bypass räumt dem Agenten mehr Freiheit ein. Das Terminal bietet einen geführten Ablauf mit strata launch und Verbindungen zu Programmierclients. Beide nutzen dieselbe zugrunde liegende Engine. Funktionshinweise zu 0.2.0-beta
Für Entwickler ergibt sich daraus ein einfaches Anwendungsbeispiel: in einem entbehrlichen Testprojekt einen kleinen Parser anfordern, die vorgeschlagenen Dateien prüfen, die Tests ausführen und anschließend mit einem fehlschlagenden Beispiel weiterarbeiten. Wer viel mit Dokumenten arbeitet, beginnt entsprechend mit einer klar begrenzten Frage zu einem bereitgestellten Abschnitt und fordert danach das genaue Belegzitat an. Keines dieser Szenarien verlangt, das Modell zu einem autonomen Mitarbeiter zu machen.
Der praktische Fortschritt liegt in der Kontinuität. Eine grafische Modellauswahl senkt das Risiko, eine inkompatible Konfiguration zu starten. Die Hardware-Überwachung hilft zu erklären, warum eine andere Anwendung die Leistung verändert. Ein gespeichertes Profil macht aus einem gelungenen Experiment einen wiederholbaren Ablauf. Diese Funktionen verbessern nicht das Denkvermögen des Modells. Sie verringern den Aufwand zwischen der verfügbaren Fähigkeit und ihrem verantwortungsvollen Einsatz.
Unsere Einschätzung: Im nächsten Wettbewerb um lokale KI geht es um genau diesen Abstand. Eine überzeugende Bedienung macht es leicht, gute Konfigurationen aufzubewahren, Fehler zu verstehen und riskante Aktionen zu prüfen.
Das gesamte Speichersystem des Computers wird Teil des Modells
Stratas Hauptziel ist Qwen3.8-Flash-Next, dessen Kern 125 Milliarden Parameter umfasst. Seine Ausführungsstrategie nutzt GPU-Speicher für gemeinsame Berechnungen und häufig benötigte Experten, System-RAM und CPU-Ausführung für andere Experten sowie SSD-Zugriffe für die n-Gramm-Nachschlagetabelle. Eine größere Grafikkarte hilft, doch RAM und Massenspeicher des Rechners bleiben Teil des Inferenzpfads. Projektübersicht, Ausführungsdesign
Stellen Sie sich den PC als Werkstatt mit mehreren Arbeitsflächen vor. Die schnellste Fläche ist begrenzt, also muss die Laufzeitumgebung entscheiden, welche Arbeit dort bleiben sollte. Bessere Entscheidungen können vorhandene Hardware nützlicher machen; sie machen nicht jede Arbeitsfläche gleich schnell.
Drei Größen verdienen getrennte Aufmerksamkeit. Der Download belegt Massenspeicher. Die geladenen Gewichte und Laufzeitpuffer verbrauchen Arbeitsspeicher. Das Kontextfenster fügt mit wachsendem Gespräch weiteren Arbeitszustand hinzu. Die Dateigröße allein verrät daher weder den nötigen VRAM noch die Wartezeit bis zur ersten Antwort.
Das Projekt nennt derzeit als Einstieg mindestens 32 GB RAM und VRAM zusammen sowie etwa 80 GB freien Massenspeicher für die übliche Einrichtung. Das sind Einstiegsrichtwerte und keine Zusage, dass jedes Modell, jede Kontextlänge und jedes Betriebssystem damit auskommt. Ein einfaches Notebook mit 16 GB sollte nicht mit den folgenden Desktop-Rechnern gleichgesetzt werden. Hardware-Anforderungen
Mehr Modellnamen bedeuten nicht immer mehr Modellarchitekturen
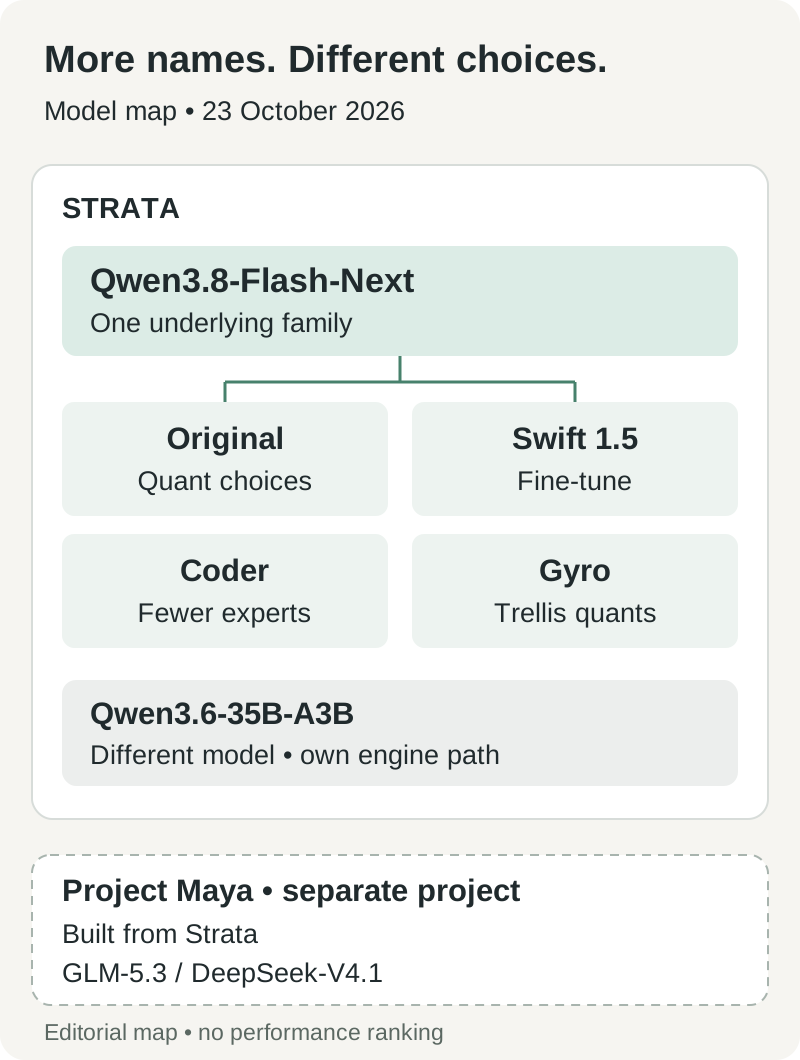
Eigene redaktionelle Übersicht der dokumentierten Modellbeziehungen, geprüft am 23. Oktober. Die Zweige zeigen Abstammung und Laufzeitunterstützung, nicht gleiche Qualität oder austauschbare Dateien.
Das ursprüngliche Flash-Next, Swift 1.5, Coder und Gyro beantworten unterschiedliche Fragen innerhalb derselben grundlegenden Familie. Swift verändert das Verhalten durch Feinabstimmung. Coder entfernt Experten, die für seinen Programmierfokus als weniger nützlich ausgewählt wurden. Gyro verändert die Darstellung der Gewichte. Wer diese Namen als vier unabhängige Basismodelle behandelt, lässt den Katalog breiter erscheinen, als er ist. Modellleitfaden
Diese Unterschiede haben Folgen. Coder behält 256 der 512 Experten jeder Schicht; das Projekt warnt vor schwächerer allgemeiner Leistung und schwächerer Leistung außerhalb des Englischen. Ein Modell, das wegen seiner Eignung für einen Programmier-PC ausgewählt wurde, sollte nicht automatisch zum Standard für mehrsprachige Dokumentfragen werden. Swifts kürzeres Schlussfolgern kann die Gesamtdauer senken, ohne dass die Hardware jedes einzelne Token schneller erzeugt. Abwägungen zwischen den Versionen
Gyro-S benötigt einen Download von 58,5 GB, während der dokumentierte Speicherbedarf seiner Gewichte über RAM und VRAM hinweg 27,6 GB beträgt. Seine n-Gramm-Tabelle bleibt auf der SSD. In der Bewertung des Projekts liegt seine Qualität unter der größerer Varianten mit niedriger Bitbreite. Ein geringerer Speicherbedarf hat seinen Preis. Gyro-Dokumentation
Es gibt außerdem tatsächlich ein zweites Modell: Qwen3.6-35B-A3B, ein Mixture-of-Experts-Modell mit 35 Milliarden Parametern, davon 3 Milliarden aktiv, das über einen separaten Engine-Pfad läuft. Seine dokumentierten Möglichkeiten umfassen Bilder und gleichzeitige Anfragen auf unterstützten NVIDIA- und AMD-Konfigurationen; die Mac-Engine führt es nicht aus. Damit ist es eine sinnvolle Alternative zur Prüfung, wenn die größte öffentlich beworbene Parameterzahl nicht Ihre eigentliche Anforderung ist. Qwen3.6-Unterstützung
Drei veröffentlichte Rechner zeigen drei Arten von Nutzen
Die folgenden Beispiele wurden von Community-Mitwirkenden oder vom Projekt selbst veröffentlicht. Sie messen bestimmte Konfigurationen und sind keine praktischen Tests für diesen Artikel. Sie sollen plausible Aufgaben und deren Kosten zeigen, nicht drei Computer anhand nicht vergleichbarer Prompts in eine Rangliste bringen.
| Veröffentlichtes Beispiel | Modell- und Kontextbedingungen | Berichtetes Ergebnis | Wobei es bei der Entscheidung hilft |
|---|---|---|---|
| Community, 9. Oktober: RTX 3060 12 GB, Core i7-12700, 64 GB DDR4-3200, NVMe, Windows 11 | Strata 0.1.41; ursprüngliches Q2_0; Fenster mit 131.072 Token; neuer Prompt mit 4.096 Token, 256 Ausgabetoken; Schlussfolgern und Bildverarbeitung aus; drei Durchläufe | Median: 42,9 Ausgabetoken/s; 4,7 Sekunden bis zum ersten Token; 10,6 Sekunden insgesamt | Eine ältere 12-GB-Karte ermöglicht interaktive kurze Aufgaben, wenn viel System-RAM hinzukommt |
| Community, 9.–10. Oktober: RX 9060 XT 16 GB, Ryzen 7 9800X3D, 64 GB DDR5-6000, Windows 11 | Engine 0.1.40.3; IQ2_XS; Fenster mit 122.880 Token; Prefill 8.192; neue Eingabe mit 8.019 Token, geringes Schlussfolgern; drei Durchläufe | Median: 879,4 Prompt-Token/s, 56,3 Ausgabetoken/s, 11,212 Sekunden insgesamt | Bei Eingaben in Dokumentlänge kann die Prompt-Konfiguration ebenso wichtig sein wie eine schnellere Karte |
| Projektmessung, bis zum 23. Oktober dokumentiert: M4 Mac mini, 32 GB gemeinsamer Speicher | Gyro-S; Experten-Streaming von SSD; Expertenarena mit 11–12 GB; keine Draft-Schicht; Geschichte mit 120 Token; Gesamtfenster nicht angegeben | Median: 9,14 Ausgabetoken/s über fünf abwechselnd gemessene Paare; ein separater Prompt mit 4.065 Token wurde mit 109 Token/s eingelesen | Ein kompakter Rechner kann ein großes Modell ausführen, muss dafür aber längere Wartezeiten hinnehmen |
Quellen: RTX-3060-Bericht, RX-9060-XT-Bericht, Mac-Messungen. Diese Berichte stammen aus der Zeit vor der aktuellen App-Version oder unterscheiden sich von ihr.
Das RTX-3060-Beispiel ist nützlich, weil es die Wartezeit vor der Ausgabe berücksichtigt. Auch eine Oberfläche mit ungefähr 43 Token pro Sekunde kann pausieren, während das Modell die Frage liest. Der Bericht vermerkt außerdem thermisch bedingte Verlangsamung und unkontrollierte Hintergrundaktivität. Sein Wert liegt in einer realistischen Einordnung eines konkreten Rechners, nicht in einer idealisierten GPU-Spezifikation.
Beim Radeon-Nutzer gibt es Belege für einen konkreten Arbeitsablauf jenseits einer Geschwindigkeitsschleife. Der Mitwirkende führte über einen Programmierclient drei synthetische TypeScript-Aufgaben je Modell dreimal aus; sowohl IQ2_XS als auch IQ3_XXS bestanden alle neun Aufgabenläufe. Die IQ2-Konfiguration erledigte diese begrenzten Aufgaben schneller und benötigte weniger Host-Speicher. Das spricht dafür, überprüfbare Programmieraufgaben auszuprobieren. Es belegt keine gleichwertige Qualität in einem unbekannten Repository. Programmiervergleich und Testfälle
Das Mac-Beispiel beantwortet eine andere Frage: Kann ein relativ kompaktes System mit 32 GB überhaupt mitmachen? Ja, unter der veröffentlichten Streaming-Konfiguration. Ein separater IQ3_XXS-Prompt mit ungefähr 30.000 Token in der Mac-Dokumentation benötigte allerdings 5,6 Minuten bis zur ersten Ausgabe. Eine geduldig ausführbare Stapelaufgabe und ein Assistent, bei dem Unterbrechungen stören, haben unterschiedliche Latenzbudgets. Mac-Streaming-Messungen
Diese Unterscheidung sollten Leser mitnehmen. Eine kurze Frage zeigt das interaktive Verhalten, ein langes Dokument die Kosten der Prompt-Verarbeitung und eine überprüfte Aufgabe den Nutzen der Antworten. Keine einzelne Kennzahl ersetzt alle drei.
Die Oktober-Korrekturen zeigen, warum Versionsnummern in die Einrichtungsnotizen gehören
Die Veröffentlichung vom 23. Oktober meldet auf dem Windows-Testrechner mit Strix Halo und IQ3_S eine um 6–19 % höhere Antwortgeschwindigkeit, gemessen in drei gepaarten Durchläufen gegen 0.2.2. Sie enthält außerdem ein Intel-Arc-Linux-Paket mit SYCL-Engine; getestet wurde die A750. DFlash2-Drafting ist nur im Terminal und nach ausdrücklicher Aktivierung verfügbar. Auto wählt weiterhin MTP, weil die Alternative nicht bei allen Aufgaben gewonnen hat. Messungen und Grenzen von 0.2.3
Zu diesen Verbesserungen kommt gewöhnliche Softwarewartung. Das Tag v0.2.1.2 vom 20. Oktober behob den Windows-Start auf Strix Halo. Der Hardware-Leitfaden erklärt das frühere Problem: Die Registrierung der Expertenarena schöpfte den verfügbaren GPU-Speicher aus, sodass für den Cache keine Plätze mehr blieben. Ein unterstützter Chip und ein Installationsprogramm reichten nicht aus, solange die Speicherzuständigkeit nicht korrigiert war. v0.2.1.2, Erklärung des Strix-Halo-Startproblems
Auch aktuell gibt es raue Kanten. Das am 23. Oktober eröffnete Issue #3810 meldet einen Absturz bei der Windows-CUDA-Einrichtung im Zusammenhang mit den mitgelieferten Bildmetadaten. Zum Recherchestichtag dieses Artikels war das eine noch ungelöste Nutzermeldung und kein Beweis dafür, dass jede Windows-Installation scheitert. Wenn Ihre Einrichtung dazu passt, prüfen Sie das Issue und spätere Versionshinweise, bevor Sie stundenlang das Modell neu abstimmen. Windows-Einrichtungsbericht
Auch Updates verdienen Aufmerksamkeit: Die Hinweise zu 0.2.3 fordern Nutzer von 0.2.0-beta bis 0.2.1.2 auf, das Terminal-Installationsprogramm erneut auszuführen, weil diese Versionen Control-Komponenten nicht selbst wechseln können. Dabei bleiben Modelle und Einstellungen erhalten. Prüfen Sie auf dem Mac, ob das gewünschte signierte Paket tatsächlich verfügbar ist: Laut den bekannten Einschränkungen derselben Veröffentlichung wurden die Mac-Builds bei Erscheinen noch signiert. Update-Anleitung
Beginnen Sie mit einer nützlichen Aufgabe und einem kurzen Kontext
Sie müssen keine riesige Kontextdemo nachstellen, um herauszufinden, ob sich das lohnt. Ein kleiner erfolgreicher Durchlauf liefert eine Ausgangsbasis einschließlich Fehlern und Korrekturen, bevor Sie mehr Speicher belegen oder einem Agenten weitreichende Aktionen erlauben.
- Wählen Sie den dokumentierten Weg für Ihre Hardware. Öffnen Sie die offizielle Release-Seite und wählen Sie das passende Betriebssystem- und GPU-Paket. Notieren Sie App- und Engine-Version getrennt. Bewahren Sie eine funktionierende Installation auf, während Sie ein Update prüfen.
- Wählen Sie das Modell nach freiem Speicher, Sprache und Aufgabe. Schließen Sie für den ersten Versuch speicherintensive Anwendungen. Beginnen Sie mit der empfohlenen Größe, etwa 8K Kontext und einer gleichzeitigen Anfrage. Speichern Sie die Modelldateien auf einer lokalen SSD.
- Nutzen Sie die geführte Einrichtung. Die Modellauswahl der Desktop-App oder
strata launchbietet Einstellungen für Modell, Speicher, Kontext, Bilder und Zugriff. Behalten Sie für die erste Programmierübung den rein lokalen Zugriff und Manual-Berechtigungen bei. Terminal-Leitfaden - Stellen Sie eine überprüfbare Aufgabe. Versuchen Sie eine kleine Funktion mit Tests, drei Fragen zu einem bereitgestellten Dokument oder einen Screenshot mit bekannten Beschriftungen. Speichern Sie den Prompt und prüfen Sie die Antwort anhand der tatsächlichen Quelle oder Testausgabe.
- Messen Sie die gesamte Wartezeit. Erfassen Sie Startdauer, Zeit bis zur ersten Ausgabe, gesamte Aufgabendauer, maximalen Speicherbedarf und Korrektheit. Wiederholen Sie den Versuch dann einmal mit einer zwischengespeicherten Nachfrage und einmal mit einem neuen Prompt. Lassen Sie die Drafting- und Schlussfolgerungseinstellungen während dieses Vergleichs unverändert.
- Erhöhen Sie die Komplexität jeweils nur an einer Stelle. Vergrößern Sie den Kontext nur, wenn die Aufgabe es verlangt. Prüfen Sie Bilder, ein anderes Modell oder eine Programmierclient-Verbindung getrennt, damit sich eine Verschlechterung konkret zuordnen lässt.
Für teilbare Leistungsberichte bietet Strata strata bench run. Das standardisierte Protokoll war am 23. Oktober weiterhin ein Entwurf, dessen Pilotvalidierung noch ausstand, und trennt das Laden des Modells ausdrücklich von der zeitlich gemessenen Inferenz. Die wichtige Gewohnheit ist schon jetzt nützlich: Dokumentieren Sie Hardware, Quantisierung, wirksame Einstellungen und Aufgabenergebnisse zusammen mit der Messung. Benchmark-Protokoll
Auch bei lokaler Inferenz bleiben Entscheidungen an den Rändern
Laut Stratas Datenschutzdokumentation gibt es keine Nutzungstelemetrie, und heruntergeladene Modelle können offline laufen. Websuche, geöffnete Seiten, entfernte Modelldienste, Tunnel und konfigurierte Werkzeuge stellen bei ihrer Nutzung externe Verbindungen her. Ein privates Modellgespräch braucht daher auch einen privaten Arbeitsablauf rundherum. Netzwerk- und Download-Verhalten
Das betrifft besonders die Dokument- und Programmierbeispiele. Ein Assistent, der Dateien lesen und Befehle ausführen darf, kann mehr als Text erzeugen. Prüfen Sie seinen Arbeitsordner, den genauen vorgeschlagenen Befehl und jeden externen Werkzeug-Endpunkt, bevor Sie vertrauliches Material bereitstellen. Bewahren Sie Originale und Versionsverlauf auf, damit sich falsche Änderungen rückgängig machen lassen.
Der Standard-Listener für Inferenz verwendet 127.0.0.1; ein Netzwerk-Listener verändert den Kreis der Zugriffsberechtigten. Strata dokumentiert API-Schlüssel und seinen separaten Freigabe-Listener, doch die Entscheidung bleibt bei der Person, die den Zugriff aktiviert. Eine kompatible API erleichtert den Anschluss eines Clients; sie macht nicht jede denkbare Client-Konfiguration privat. Sicherheitsrichtlinie
Project Maya zeigt, wie weit die Idee trägt – und was sie kostet
Die weiterreichende Entwicklung besteht darin, dass die Laufzeitstrategie auf andere Modellfamilien übertragen wird. Project Maya nennt Strata ausdrücklich als Ausgangspunkt seiner Engine, seines Servers und seines Dashboards und beschreibt umfangreiche Anpassungen für die eigenen Modelle. Zu den dokumentierten Zielen gehören GLM-5.3-Flash mit 321B und DeepSeek-V4.1-Flash-1017 mit 748B. Maya ist ein eigenständiges Projekt und keine Auswahl im Strata-Modellmenü. Maya-Modelle und Danksagungen
Der Download von GLM Maya-S umfasst 96,5 GB; die DeepSeek-Maya-S-Option belegt 340 GB einschließlich Engram-Tabellen. Ein Community-Beispiel kombiniert eine RTX 5090 mit einem Ryzen 9 7950X und 96 GB RAM und meldet für GLM Maya-M mehr als 30 Token pro Sekunde. Diese Bedingungen erklären, warum „eine GPU“ eine unvollständige Beschreibung einer Consumer-Konfiguration ist. Maya-Dateien und Hardware-Berichte
Die Chance ist real: Ein Rechner kann mehrere Speicher- und Rechenebenen kombinieren, um ein Modell auszuführen, dessen vollständige Gewichte den Beschleunigerspeicher übersteigen. Die Kosten wachsen ebenfalls. Hunderte Gigabyte an Downloads, modellspezifische Kernel, freies System-RAM und experimentelle Plattformunterstützung sind erhebliche Verpflichtungen. Eine erfolgreiche Portierung eines großen Modells belegt keinen universellen Loader für jede Architektur.
Für die meisten Leser ist Maya zunächst eine Entwicklung, die man beobachten sollte, bevor sie als Ersatz empfohlen werden kann. Entscheidend ist, ob ein anderes Modell eine Aufgabe löst, an der das bisherige scheitert, und ob der Nutzen den zusätzlichen Hardware- und Wartungsaufwand rechtfertigt. Die Parameterzahl allein beantwortet diese Frage nicht.
Der nächste Meilenstein ist verlässliche Arbeit – darauf weisen die öffentlichen Vorschläge hin
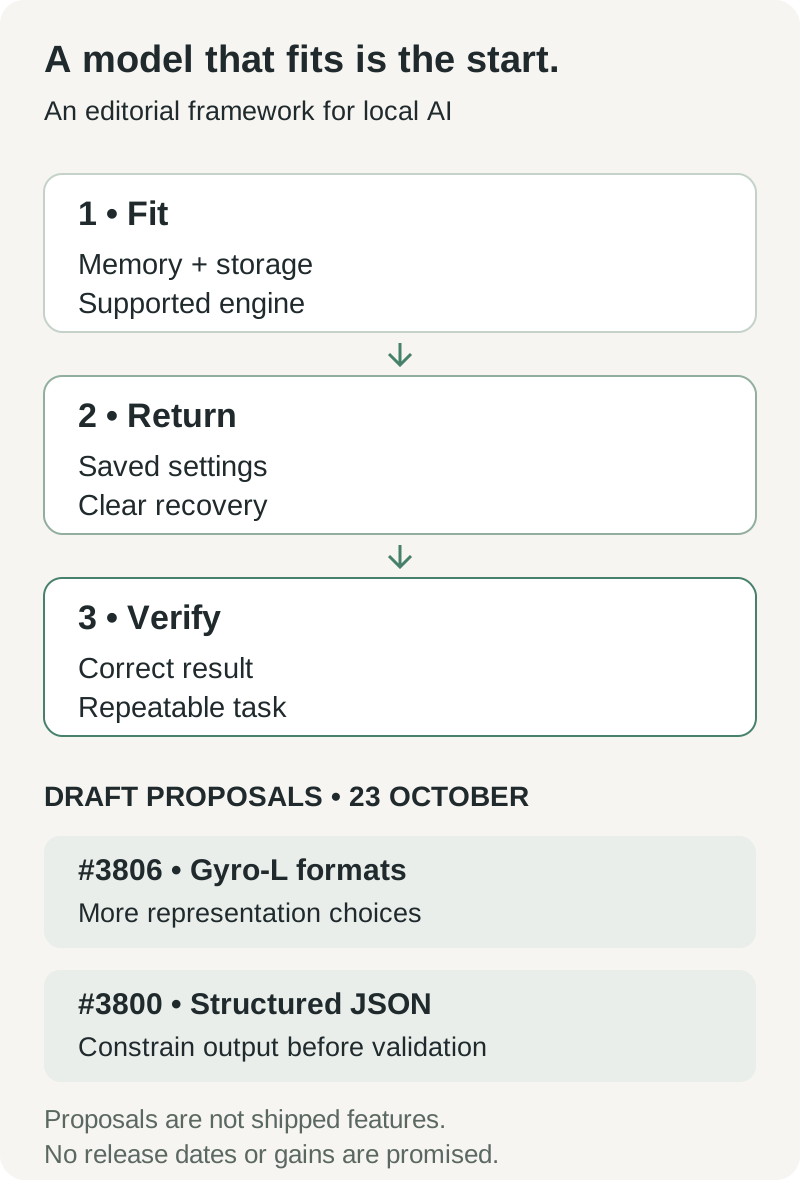
Eigener redaktioneller Rahmen. Die obere Abfolge beschreibt Kriterien für den praktischen Einsatz; die untere Reihe nennt öffentliche Vorschläge, geprüft am 23. Oktober. Sie stellt weder einen zugesagten Veröffentlichungsplan noch eine Leistungsprognose dar.
Zwei offene Pull Requests im Entwurfsstadium liefern konkretere Signale als eine ausgedachte Roadmap für 2.0. #3806 schlägt Unterstützung für die derzeit nicht unterstützten Trellis-Formate von Gyro-L vor. #3800 schlägt Token-Maskierung für strukturierte JSON-Ausgaben vor, damit ungültige Generierungen seltener eine vollständige Wiederholung der Anfrage erfordern. Beide waren am 23. Oktober Entwürfe; keiner gehört in eine Liste bereits veröffentlichter Funktionen. Gyro-L-Vorschlag, Vorschlag für strukturierte Ausgaben
Wenn solche Arbeiten eine zuverlässige Veröffentlichung erreichen, profitieren zwei Arten lokaler Aufgaben. Bessere Formatunterstützung gibt Nutzern mehr Möglichkeiten, Speicherbedarf gegen Qualität abzuwägen. Verlässlichere strukturierte Ausgaben helfen bei der Extraktion aus Dokumenten, der Kennzeichnung und bei Werkzeugaufrufen, Daten zu erzeugen, die ein anderes Programm sicher validieren kann. Die zweite Verbesserung wirkt im Video weniger spektakulär, kann aber für wiederkehrende Abläufe wertvoller sein.
Unsere Erwartung ist an Bedingungen geknüpft: Persönliche Inferenz wird nützlicher, wenn Laufzeitumgebungen funktionierende Konfigurationen bewahren, ihren Speicherbedarf begrenzen und sich von Fehlern erholen. Weitere Backend-Portierungen und raffinierteres Drafting helfen nur, wenn Leser sie mit einer tatsächlichen Aufgabe verbinden können. Ein Desktop-Modell verdient seinen Platz durch Arbeit, die sich prüfen und wiederholen lässt.
Die Frage an den nächsten Computer für lokale KI ist deshalb einfach: Können Sie ihm morgen dieselbe nützliche Aufgabe geben und dem Ablauf genug vertrauen, um ihn weiter zu nutzen?
Quellen und Hinweise zur Lektüre
Recherchestichtag: 23. Oktober 2026. Veröffentlichungsstatus, Issue-Status und verfügbare Pakete können sich nach diesem Datum ändern. Die obigen Messungen behalten ihre ursprünglichen Veröffentlichungsdaten und Konfigurationen; für diesen Artikel wurde kein neuer Inferenzbenchmark durchgeführt.
- Strata 0.2.0-beta, v0.2.1.2 und Versionshinweise zu 0.2.3.
- Strata-Modellleitfaden, Qwen3.6-Unterstützung und Gyro-Dokumentation.
- Community-Benchmark-Sammlung, Mac-Dokumentation und Entwurf des Benchmark-Protokolls.
- Project Maya, offizieller Strata-Screenshot und Repository-Lizenz.
Bewahren Sie Ihre Entscheidungen zur lokalen KI zusammen mit den Belegen auf
Wenn Sie Konfigurationen vergleichen, halten Sie Quellenlinks, Hardware-Einstellungen, Aufgabenergebnisse und Korrekturen zusammen. Telli.sh kann Ihnen helfen, diese Recherchenotizen und Zusammenfassungen zu organisieren, während sich Ihre Einrichtung weiterentwickelt. Ein Telli.sh-Konto erstellen