Strata 0.2.17 想多占一些内存:你的工作电脑该答应吗?
Strata 的新内存预算可以减少 SSD 读取,另一项默认设置则保护输出保真度。了解兼顾日常工作的电脑该选什么设置,以及如何验证取舍。
本地模型回答得更快,并不代表这台电脑用起来更舒服。如果同一台机器还要运行浏览器、编辑器和视频通话,这两种结果就应该放在同一套基准测试里考察。
2026 年 11 月 20 日发布的 Strata 0.2.17让这种取舍变得格外明显。对于无法把全部专家权重留在 RAM 中的特定模型文件,面向性能的配置提高了常驻内存分配量。同时,在用户报告回答质量下降之后,版本又默认关闭了另一项优化。
真正有用的问题是:这台 PC 是推理专用设备,还是你仍要用来工作的电脑?这次更新值得你验证两者的区别,而不是把更高的每秒 token 数当作全部结果。
需要了解的三点: 64 GiB 示例仅针对受支持的 Unsloth 文件和明确列出的硬件配置;应用可以保留原先更适合工作的预算;内存常驻与跳过模型路径是两种不同的控制。
多用 7 GiB,可能大幅减少 SSD 读取
Strata 是一套本地模型运行时,通过协调机器资源执行受支持的模型。0.2.16所述的引擎迁移之后,新应用和 Terminal 的版本为 0.2.17,引擎与 Control 更新器的版本为 0.1.63。此次发布提供 Windows、Linux、Mac 和 DGX Spark 下载,但提供某个操作系统的安装包,不等于所有模型和执行路径都能在该系统的每台机器上运行。
内存改动针对的是专家权重无法全部常驻 RAM 时的 Unsloth UD-Q4_K_XL 和 UD-IQ4_XS 文件。新设置规则会从 RAM 总量中减去 17 GiB 以及流式 KV 缓存,再决定保留多少专家权重。旧规则减去的是 24 GiB。这是特定执行路径的常驻预算,并不保证整个模型、缓存和操作系统都能装进这个数字所代表的空间。
为什么多出几 GiB 会有影响?如果所需权重已经在内存中,运行时就不必再次从存储设备读取。负载较高的提示词可能在大量访问中反复获得这一收益。因此,这种关系比拿 7 GiB 与单个输入文件的大小做比较复杂得多,还取决于任务会用到哪些专家,以及运行时此前已经缓存了什么。
维护者的示例使用实际的 64 GiB 内存限制、UD-Q4_K_XL、RTX PRO 4500 Blackwell 显卡和约 65K token 的提示词。发布说明中的表格给出了以下结果。这些是项目针对该配置的测量值,不是对所有 64GB 电脑的性能预测。
| 专家权重常驻预算 | 指定提示词的 SSD 读取量 | 解码速度 | 报告的空闲 RAM | 随后运行的 8 GiB 程序 |
|---|---|---|---|---|
| 40 GiB,旧示例 | 97.7 GB | 57.7 token/秒 | 16.6 GiB | 继续运行 |
| 47 GiB,新示例 | 37.0 GB | 84.2 token/秒 | 9.3 GiB | 继续运行 |
| 52 GiB,额外测试 | 0.9 GB | 83.4–88.6 token/秒 | 6.6 GiB | 被强制终止 |
最后一行尤其值得关注。把存储读取量压到接近零,并没有换来同样显著的解码提速,而且另一个程序无法继续运行。这张表说明,应该通过测量选择预算,而不是一味把分给推理的内存拉到最大。
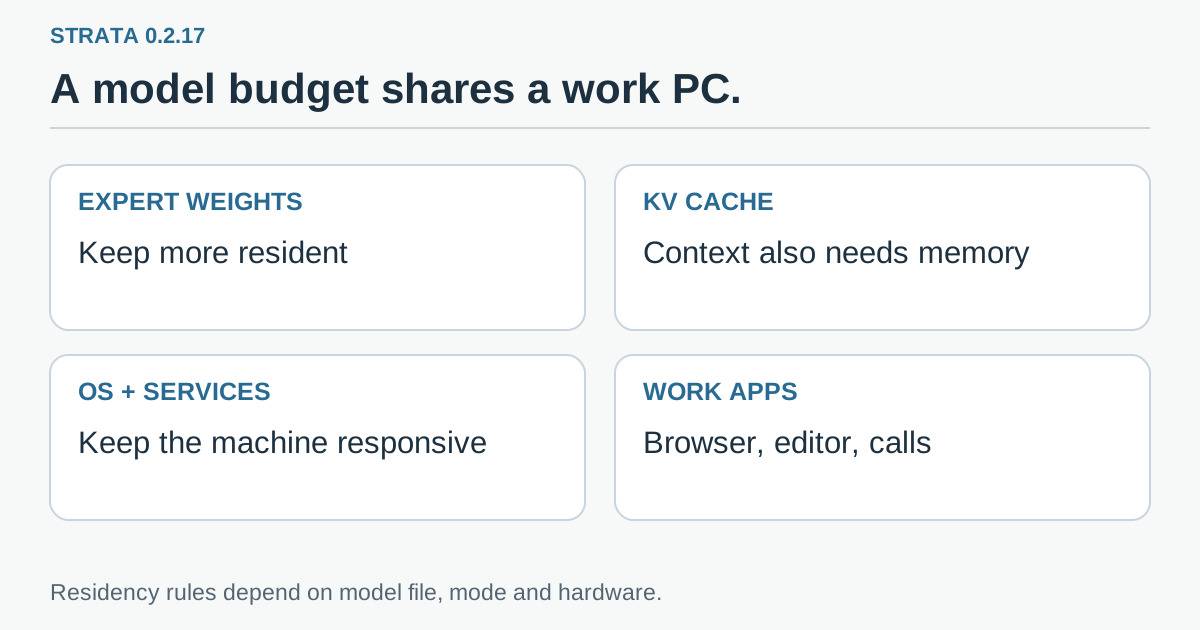 原创说明图:专家权重、运行时不断变化的缓存和日常应用共享机器的内存。发布说明中的常驻规则只适用于明确列出的模型路径。
应用的工作预留空间值得先用起来
以开发者工作站为例:浏览器已经开了很久,IDE 正在为代码库建立索引,本地助手则要根据一份大文档准备回答。如果 IDE 开始使用交换空间,或者视频会议变得不稳定,那么助手单独运行时最快的配置就没那么有用了。正确的基准应该是整个工作过程。
Strata 应用提供一个名为“Leave 20% for my work”的选项。按照发布说明,它保留旧预算:在 64 GiB 示例中是 40 GiB。Terminal、strata serve、Docker 和应用的全性能模式采用新分配量。用户指定的预算或显式预留设置具有优先权。现有的 0.2.16 安装在更新后执行第一条 Strata 命令时,可以自动完成一次预算迁移,无需另外运行设置流程,前提是分配量此前没有由用户明确设定。
当两个人都说自己测试了默认配置时,这种差异很重要。一人可能使用桌面应用的工作预留模式,另一人则从 Terminal 启动服务器。他们运行相同版本的应用,却可能采用不同的常驻策略。比较结果之前,除了版本,也应记录启动模式。
发布说明还列出了例外。Strix Halo 等 CPU 与 GPU 共享内存的机器,以及双卡分层执行路径,继续保留旧的预留量。其余列出的模型文件——IQ2_XS、IQ3_XXS、IQ3_S 和 Q2_0——在两个版本中都不采用这项常驻预算。因此,照搬某个示例的内存规则,不能代替核实确切的模型配置。
在 Windows 上,新引擎还把初始申请量限制为当前可用空闲内存减去 4.25 GiB。因而,已经运行许多应用的机器可能以低于示例中 47 GiB 的分配量启动。发布说明明确指出,示例没有测量这种 Windows 行为。它还调整了系统报告约 63.1 GiB 时,对标称 64GB Windows 机器的分类方式。这些细节有助于解释实际分配量为何不同,却不能把公开测试变成 Windows 基准测试。
我们的实用建议是:对于日常需要交互操作的电脑,从预留选项开始。让预期任务实际运行,再有意识地比较更大的分配量,而不是借用那些碰巧为了测试而关闭的应用所释放的内存。
快速回答与忠实回答,需要分别控制
第二项主要变化涉及 Expert 设置中的“Skip rarely used parts of the model”,对应 STRATA_ROUTE_TAIL_SKIP。它不是 RAM 预算。
发布说明解释说,在相关路由条件下,这项优化可以省略原本需要复制并计算的部分专家工作。以前它会在 NVIDIA 和 Radeon RX 9000 路径上默认启用。维护者在收到质量损失报告后改变了自动行为:在 0.2.17 中,除非用户显式启用,否则它处于关闭状态。
把所需权重保存在离处理器更近的地方,与决定不执行一部分模型运算,有着重要区别。前者改变数据从哪里获取,后者改变计算本身。即使两者都能提高吞吐量,也不应把它们对输出的风险当成同一种技术来评估。
在维护者使用 RTX 5090、UD-Q4_K_XL 和 DFlash2 的示例中,五类请求经过两轮测试,关闭路径跳过时平均解码速度为 73.4 token/秒,开启时为 94.5 token/秒。同一份记录还包含强制 token 的差异测量。这是项目发布的配置比较,并不是在评价这些回答在你的应用里是否有用、安全或正确。
对日常使用的影响是:更新后某条路径的吞吐量可能下降,同时恢复更完整的路由行为。这可能正是预期结果。如果用途是核对精确数字、生成结构化输出或遵循复杂指令,那么保留期望的行为,可能比更快地输出文字更重要。
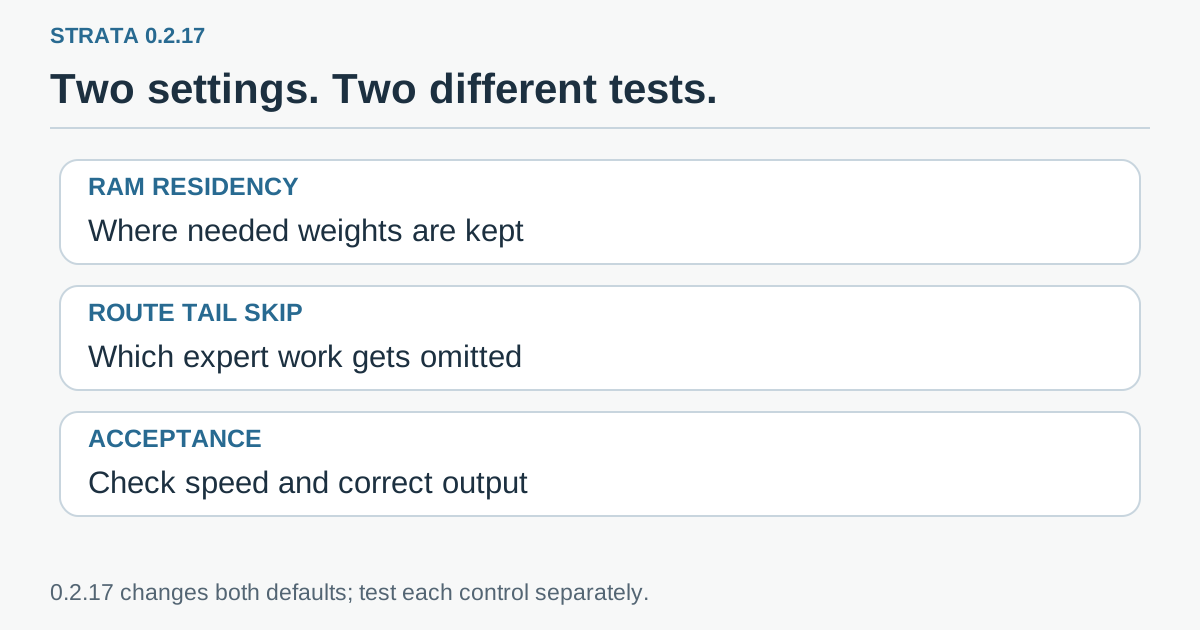 原创评估清单:将资源压力和回答质量分开测量。调整内存常驻与调整路径跳过,是两项不同的实验。
旧的自定义设置也是升级历史的一部分
自动默认值与显式选择,并不按同一种方式迁移。如果你从未改动路径设置,或者使用自动值,新的自动行为就是关闭。如果曾经明确选择 rank 7 或其他 rank,发布说明表示该选择会被保留。显式的零也仍然表示关闭。
这能保护有意做出的配置,但也意味着把两台机器升级到同一版本,并不一定使它们的行为一致。其中一台可能还保留着几个月前某人启用的实验设置。诊断回归问题之前,先检查哪些设置被沿用了下来。
发布说明将 strata launch --set STRATA_ROUTE_TAIL_SKIP=7列为启用 rank-7 行为的方法。应把它看作自愿选择的实验,而不是每个人都要执行的升级步骤。如果你要解决的是输出不一致,首先应确认路径优化已经关闭,而不是为了找回旧吞吐量就将它打开。
0.2.17 还有其他默认值改动,包括针对不同硬件的提示词读取与解码变化,其中一些会改变生成的文字。这也是不要同时改动多个设置、再把所有差异都归因于 RAM 的另一个理由。版本、模型文件、硬件路径和显式覆盖项,共同构成实际接受测试的配置。
把准备一直开着的应用也纳入比较
一次有用的测试不需要实验室,但需要一个可以重复验证的问题。对于工作电脑,应问:在整机仍然可用的情况下,助手能否完成代表性任务?对于专用服务器,则应问:所选预算能否在不发生内存故障的情况下,支撑计划同时运行的服务?
- 写下起始配置。 记录应用和引擎版本、操作系统、RAM、GPU、确切的模型文件、启动模式、上下文大小,以及显式内存或路径设置。比较过程中保持模型和量化不变。
- 选择三种代表性任务。 例如一个简短问题、一项长文档请求,以及必需字段已知的结构化提取。这些是建议的测试案例,并非我们为本文实际执行的任务。
- 建立工作预留模式的基准。 保持浏览器、编辑器和其他常用应用打开。观察空闲内存、存储活动、首次响应延迟、生成速度,以及这些应用是否保持响应。
- 只调整常驻量。 保持相同的路径设置,比较面向性能的分配量。留意任务执行期间,以及之后启动另一个普通应用时的内存压力。
- 评估输出。 检查必需事实、格式、指令遵循和多次重复的一致性。即使结构化提取在语法上有效,只要漏掉必需项,也应视为失败。
- 需要时单独测试路径跳过。 固定已经选定的常驻预算。将结果与验收示例比较,再判断吞吐量提升是否值得接受观察到的变化。
对于长文档,要同时记录冷启动和重复请求。缓存会使第二次运行看起来与第一次非常不同。不要把一种配置预热后的结果,与另一种配置第一次接触该文档时的结果混在一起。
还应记录失败,而不是让它们消失在平均值中。如果快速回答之后发生内存不足,对后台服务而言就不是好结果。对于工作笔记本,即便另一项设置在解码速度上胜出,编辑器能够不中断地运行,也可能才是决定性结果。
更好的设置,会给真正的工作留出空间
Strata 0.2.17 让本地推理更像是在管理一台小型共享电脑,而不只是给单个加速器跑分。内存就像共用的桌面:放上更多模型资料可以减少往返存储的次数,但真正的工作也需要地方展开。
对于专用机器,新分配方式值得用来测量更少的读取是否改善了服务的工作负载。对于日常工作站,预留选项是合理的起点。两种情况下,都应把输出保真度作为独立的验收标准。只有完整任务得到了改善,而不仅仅是 token 计数更好看,更快的设置才真正值得采用。
来源与官方媒体
- Strata 0.2.17 发布说明,2026 年 11 月 20 日:设置、限定条件的测量与升级行为.
- Strata 0.2.16 引擎迁移说明.
- Strata 官方界面图片。该链接展示实际产品;文章所附图形为原创解释图。
上述测量归属于项目,并保留其硬件与模型条件。评估流程是向读者建议的工作方法。
Telli.sh 建议: 把配置、代表性提示词与比较笔记保存在一起,让下一次更新从有用的基准出发。使用 Telli.sh 创建第一篇笔记。