O Strata 0.2.17 quer mais RAM. Seu PC de trabalho deve ceder esse espaço?
O novo orçamento de memória do Strata pode reduzir as leituras do SSD, enquanto outro padrão protege a fidelidade das respostas. Veja qual configuração faz sentido em um PC compartilhado e como avaliar a troca.
Um modelo local pode responder mais rápido e tornar o restante do computador menos confortável de usar. Em uma máquina que também roda navegador, editor e videochamadas, esses dois resultados precisam entrar no mesmo teste.
O Strata 0.2.17, lançado em 20 de novembro de 2026, deixa essa troca especialmente clara. Para determinados arquivos de modelos cujos pesos dos especialistas não cabem todos na RAM, a configuração voltada ao desempenho aumenta a alocação residente. A versão também desativa uma otimização separada após relatos de respostas piores.
A pergunta útil é se seu PC é dedicado à inferência ou continua sendo sua máquina de trabalho. A atualização oferece um motivo para testar essa diferença, em vez de aceitar um número maior de tokens por segundo como resultado completo.
Três pontos importantes: o exemplo de 64 GiB vale para arquivos Unsloth compatíveis e uma configuração de hardware específica; o aplicativo pode preservar o orçamento anterior, mais adequado ao trabalho cotidiano; e a residência na memória e a omissão de rotas do modelo são controles diferentes.
Sete GiB a mais podem evitar muitas leituras do SSD
O Strata é um ambiente de execução local que coordena os recursos da máquina para rodar modelos compatíveis. Após a transição de mecanismo descrita na versão 0.2.16, o aplicativo e a versão Terminal passam para 0.2.17. Os mecanismos e o atualizador Control estão na versão 0.1.63. Há downloads para Windows, Linux, Mac e DGX Spark, mas um download para determinado sistema operacional não significa que todos os modelos e caminhos de execução funcionem em qualquer máquina.
A mudança de memória se aplica aos arquivos Unsloth UD-Q4_K_XL e UD-IQ4_XS quando seus especialistas não podem permanecer todos na RAM. A nova regra subtrai 17 GiB e qualquer cache KV carregado continuamente do armazenamento do total de RAM para decidir quantos pesos dos especialistas manter. A regra anterior subtraía 24 GiB. Trata-se de um orçamento de residência para um caminho de execução específico, não de uma promessa de que o modelo inteiro, o cache e o sistema operacional caberão nessa quantidade.
Por que alguns GiB extras podem importar? Se um peso necessário já está na memória, o ambiente evita buscá-lo novamente no armazenamento. Uma solicitação exigente pode aproveitar essa vantagem ao longo de muitos acessos. A relação, portanto, é mais complexa do que comparar sete GiB com o tamanho de um arquivo de entrada. Ela também depende de quais especialistas a carga utiliza e do que já está em cache.
O exemplo do mantenedor usa um limite real de memória de 64 GiB, UD-Q4_K_XL, uma placa RTX PRO 4500 Blackwell e uma solicitação com cerca de 65K tokens. A tabela da versão apresenta os resultados abaixo. São medições do projeto nessa configuração, não uma previsão para todo computador com 64GB.
| Orçamento de especialistas residentes | Leituras do SSD para a solicitação indicada | Taxa de decodificação | RAM livre informada | Programa de 8 GiB iniciado depois |
|---|---|---|---|---|
| 40 GiB, exemplo anterior | 97.7 GB | 57.7 tokens/s | 16.6 GiB | Continuou funcionando |
| 47 GiB, novo exemplo | 37.0 GB | 84.2 tokens/s | 9.3 GiB | Continuou funcionando |
| 52 GiB, teste adicional | 0.9 GB | 83.4–88.6 tokens/s | 6.6 GiB | Foi encerrado à força |
A última linha é a mais interessante. Reduzir o tráfego de armazenamento quase a zero não produziu um aumento igualmente expressivo na velocidade de decodificação, e outro programa falhou. A tabela favorece um orçamento medido, em vez de destinar à inferência o máximo possível de memória.
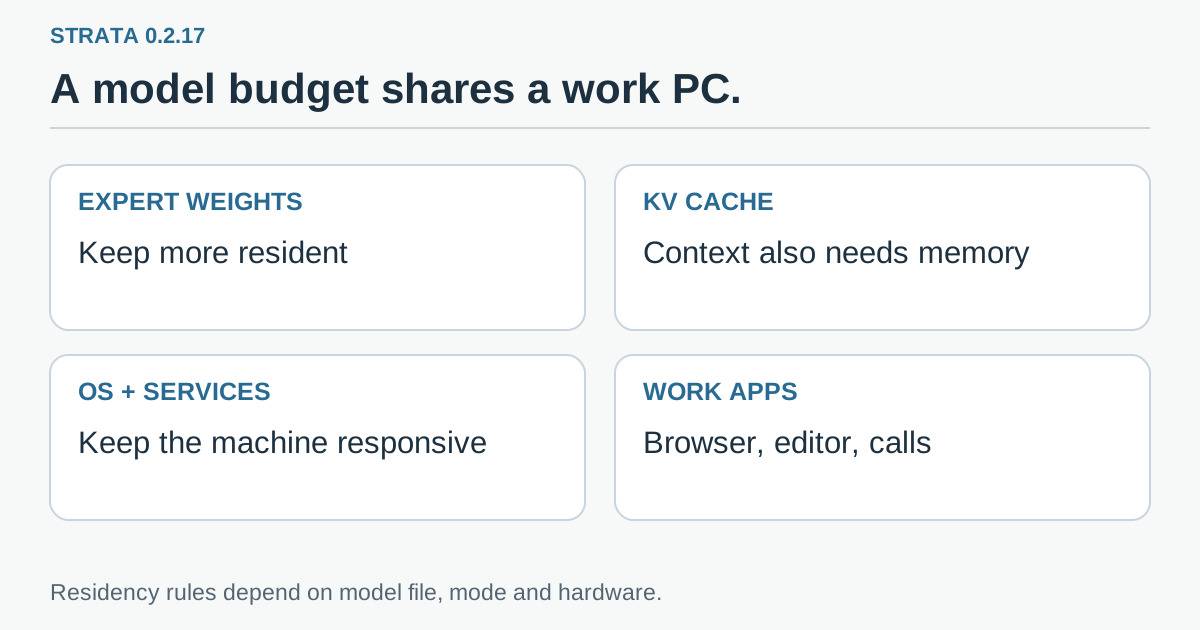 Gráfico explicativo original: os pesos dos especialistas, o cache variável do ambiente e os aplicativos cotidianos compartilham a memória. A regra de residência da versão se aplica apenas aos caminhos de modelos indicados.
A reserva para o trabalho é um bom ponto de partida
Considere uma estação de desenvolvimento ilustrativa. Ela mantém uma longa sessão do navegador, um IDE indexando um repositório e um assistente local preparando uma resposta a partir de um documento extenso. A configuração isolada mais rápida do assistente perde utilidade se o IDE começar a usar intensamente a memória de troca ou se uma videochamada ficar instável. A referência adequada é a sessão de trabalho inteira.
O aplicativo Strata oferece uma opção chamada “Leave 20% for my work”. Segundo as notas, ela mantém o orçamento anterior: 40 GiB no exemplo de 64 GiB. Terminal, strata serve, Docker e o modo de desempenho máximo do aplicativo usam a nova alocação. Um orçamento ou uma reserva definidos explicitamente pelo usuário têm prioridade. Instalações 0.2.16 existentes podem receber essa migração única de orçamento no primeiro comando Strata após a atualização, sem uma nova configuração separada, a menos que o usuário tenha definido a alocação explicitamente.
Essa diferença importa quando duas pessoas dizem ter testado os padrões. Uma pode estar usando o modo de reserva do aplicativo de desktop, enquanto outra inicia um servidor pelo Terminal. A mesma versão pode tomar decisões diferentes sobre residência. Registre o modo de inicialização junto com a versão antes de comparar resultados.
A versão também descreve exceções. Máquinas com memória compartilhada entre CPU e GPU, como Strix Halo, e o caminho de divisão de camadas entre duas placas mantêm a reserva anterior. Os outros arquivos citados — IQ2_XS, IQ3_XXS, IQ3_S e Q2_0 — não recebem esse orçamento de residência em nenhuma das duas versões. Copiar a regra de memória de um exemplo não substitui a verificação da configuração exata do modelo.
No Windows, o novo mecanismo também limita sua alocação inicial à memória livre disponível menos 4.25 GiB. Uma máquina ocupada pode, portanto, iniciar abaixo dos 47 GiB anunciados. As notas dizem expressamente que esse comportamento do Windows não foi medido no exemplo. Elas também ajustam a classificação de uma máquina Windows nominalmente de 64GB quando o sistema informa cerca de 63.1 GiB. Esses detalhes ajudam a entender uma alocação observada diferente; não transformam o teste publicado em um benchmark de Windows.
Nossa recomendação prática é começar pela opção de reserva em um computador de uso interativo. Experimente a alocação maior como uma comparação deliberada, com a carga pretendida em execução, em vez de aproveitar a memória de aplicativos fechados apenas para o teste.
Respostas rápidas e respostas fiéis precisam de ajustes separados
A segunda grande mudança envolve “Skip rarely used parts of the model”, uma opção Expert representada por STRATA_ROUTE_TAIL_SKIP. Ela não é o orçamento de RAM.
As notas explicam que, na condição de roteamento correspondente, a otimização pode omitir trabalho de especialistas que, de outra forma, seria copiado e calculado. Antes, ela operava por padrão nos caminhos NVIDIA e Radeon RX 9000. Os mantenedores alteraram o comportamento automático após relatos de perda de qualidade. Na 0.2.17, ela fica desativada, a menos que o usuário a tenha habilitado explicitamente.
Há uma diferença importante entre manter um peso necessário mais perto do processador e decidir não executar uma parte do trabalho do modelo. A primeira opção muda onde os dados são encontrados. A segunda muda o cálculo. Mesmo quando ambas aumentam a vazão, os riscos para as respostas não devem ser avaliados como se fossem a mesma técnica.
No exemplo do mantenedor com RTX 5090, UD-Q4_K_XL e DFlash2, cinco tipos de solicitação em duas rodadas produziram médias de 73.4 tokens/s com a omissão de rotas desligada e 94.5 com ela ligada. As mesmas notas incluem uma medição de divergência com tokens forçados. É uma comparação de configurações publicada pelo projeto, não uma nota sobre a utilidade, segurança ou correção das respostas em sua aplicação.
A consequência prática é que atualizar pode reduzir a vazão em determinado caminho enquanto restaura um roteamento mais completo. Esse pode ser o resultado pretendido. Se seu caso envolve conferir números exatos, gerar saída estruturada ou seguir uma instrução difícil, preservar o comportamento desejado pode valer mais do que receber texto mais rápido.
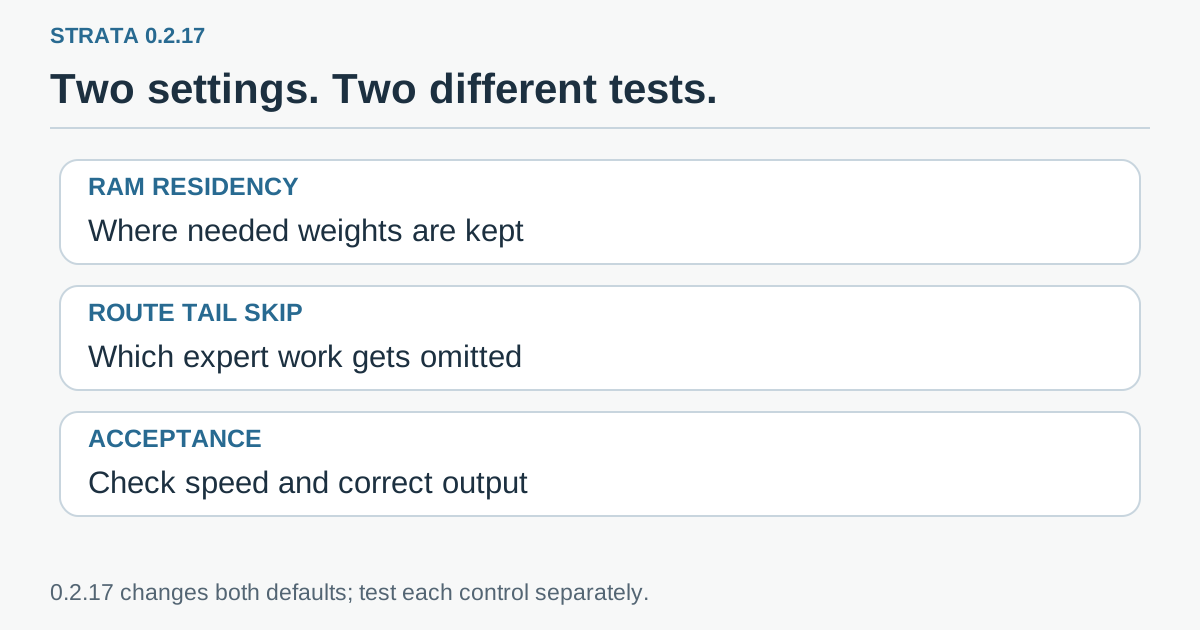 Lista de avaliação original: meça a pressão sobre os recursos separadamente da qualidade das respostas. Alterar a residência em memória e alterar a omissão de rotas são experimentos distintos.
Configurações personalizadas fazem parte do histórico de atualização
Padrões automáticos e escolhas explícitas não migram da mesma forma. Se você nunca mudou o ajuste de rotas, ou usava seu valor automático, o novo comportamento automático fica desligado. Se escolheu explicitamente o rank 7 ou outro rank, as notas dizem que essa escolha permanece. Um zero explícito continua desligado.
Isso preserva uma configuração deliberada, mas também significa que atualizar duas máquinas não necessariamente faz seus comportamentos convergirem. Uma delas pode manter um experimento antigo que alguém ativou meses atrás. Antes de diagnosticar uma regressão, confira quais ajustes foram preservados.
A versão documenta strata launch --set STRATA_ROUTE_TAIL_SKIP=7 como forma de habilitar o comportamento de rank 7. Trate isso como um experimento opcional, não como uma etapa de atualização que todos devem executar. Se você está tentando resolver respostas inconsistentes, primeiro confirme que a otimização de rotas está desligada, em vez de ativá-la para recuperar uma taxa antiga de geração.
Há outros padrões na 0.2.17, incluindo mudanças de leitura de prompts e decodificação específicas de hardware. Algumas podem alterar o texto gerado. É mais um motivo para não mudar vários ajustes de uma vez e atribuir toda a diferença à RAM. Versão, arquivo do modelo, caminho de hardware e substituições explícitas compõem a configuração que você realmente testou.
Compare mantendo abertos os aplicativos que pretende usar
Um teste útil não precisa de laboratório, mas precisa de uma pergunta repetível. Em um PC de trabalho, pergunte se o assistente conclui uma tarefa representativa enquanto o restante da máquina continua utilizável. Em um servidor dedicado, avalie se o orçamento escolhido sustenta os serviços simultâneos previstos sem falhas de memória.
- Anote a configuração inicial. Registre as versões do aplicativo e do mecanismo, sistema operacional, RAM, GPU, arquivo exato do modelo, modo de inicialização, tamanho de contexto e ajustes explícitos de memória ou rotas. Mantenha o modelo e a quantização iguais durante a comparação.
- Escolha três trabalhos representativos. Por exemplo, uma pergunta curta, uma solicitação sobre um documento longo e uma extração estruturada com campos obrigatórios conhecidos. São casos sugeridos, não tarefas executadas para este artigo.
- Estabeleça a referência com reserva para o trabalho. Mantenha abertos navegador, editor e outros aplicativos habituais. Observe memória livre, atividade de armazenamento, demora inicial da resposta, taxa de geração e se os aplicativos continuam responsivos.
- Altere apenas a residência. Compare a alocação voltada ao desempenho com o mesmo ajuste de rotas. Acompanhe a pressão de memória durante a tarefa e quando outro aplicativo habitual for aberto depois.
- Avalie a resposta. Confira os fatos exigidos, a formatação, o cumprimento das instruções e a consistência entre repetições. Considere falha uma extração sintaticamente válida que omita um item obrigatório.
- Teste a omissão de rotas separadamente, se precisar. Mantenha o orçamento de residência escolhido. Compare os resultados com seus exemplos de aceitação e decida se o ganho de vazão compensa as mudanças observadas.
Para um documento longo, registre tanto o início a frio quanto uma solicitação repetida. O cache pode tornar a segunda execução muito diferente da primeira. Não misture o resultado a quente de uma configuração com o primeiro contato de outra com o documento.
Registre também as falhas em vez de escondê-las nas médias. Uma resposta rápida seguida de falta de memória não é um bom resultado para um serviço em segundo plano. Uma sessão de edição sem interrupções pode ser decisiva em um notebook de trabalho, mesmo que outro ajuste vença na coluna de taxa de decodificação.
O melhor ajuste deixa espaço para seu trabalho real
O Strata 0.2.17 faz a inferência local parecer menos um benchmark isolado de acelerador e mais a administração de um pequeno computador compartilhado. A memória é uma mesa comum: colocar mais material do modelo nela pode reduzir as idas ao armazenamento, mas o trabalho ainda precisa de espaço para acontecer.
Em uma máquina dedicada, a nova alocação é motivo para medir se menos leituras melhoram a carga atendida. Em uma estação de uso cotidiano, a reserva é um ponto de partida sensato. Nos dois casos, mantenha a fidelidade das respostas como um critério de aceitação independente. Um ajuste mais rápido merece seu lugar quando melhora a tarefa completa, não apenas o contador de tokens.
Fontes e mídia oficial
- Strata 0.2.17, 20 de novembro de 2026: configurações, medições contextualizadas e comportamento de atualização.
- Notas da transição de mecanismo do Strata 0.2.16.
- Ilustração oficial da interface do Strata. O link mostra o produto real; os gráficos incluídos são explicações originais.
As medições acima são atribuídas ao projeto e preservam suas condições de hardware e modelo. O procedimento de avaliação é uma sugestão de fluxo de trabalho para o leitor.
Recomendação Telli.sh: Guarde juntas suas configurações, prompts representativos e notas de comparação para que a próxima atualização parta de uma referência útil. Crie sua primeira nota com o Telli.sh.