Nova-3 本月迎来第 58 种语言。但只有 10 种能出现在同一个句子里。
2026 年 8 月 4 日,Deepgram 为 Nova-3 新增了旁遮普语和尼泊尔语;8 月 7 日又新增亚美尼亚语,并改进了泰米尔语、印尼语和白俄罗斯语。九个月前这个模型只覆盖 31 种语言,如今官方文档列出了 58 种。但语码转换依然只支持其中 10 种,而 8 月自家的更新日志显示:印尼语只在批处理中改进,白俄罗斯语只在流式中改进。本文梳理语音识别语言覆盖的扩张速度,以及「支持」这个词究竟掩盖了什么。
2026 年 8 月 4 日,Deepgram 把旁遮普语和尼泊尔语加进了它的 Nova-3 语音识别模型。三天后,它又加入了亚美尼亚语,同时为泰米尔语、印尼语和白俄罗斯语提供了改进后的单语模型。
两条更新日志,加起来十一行文字,没有发布会,也没有新闻稿。但对任何要用这些语言开会的人来说,这是本月语音识别领域最有分量的一件事。
比这两条记录更值钱的,是它们背后的节奏。2025 年 12 月,Deepgram 自己的发布说明写着 Nova-3 共支持 31 种语言。今天,也就是 2026 年 8 月 31 日,我们在 Deepgram 的 Models & Languages Overview 里统计不重复的基础语言代码,得到的数字是 58。整个行业都在以这个速度前进,而它已经悄悄改变了你对一份转录稿应有的期待。
这篇文章做三件事。用一手资料给这轮扩张标上确切的数字和日期。解释为什么一个「支持语言数」的头条数字本身几乎毫无意义——以及你必须改问的三个问题。最后具体拆解:当会议室里坐着说旁遮普语、尼泊尔语、亚美尼亚语、泰米尔语或印尼语的人时,8 月的这些更新到底改变了什么。
TL;DR:
- 58 对 31。Nova-3 的文档在 2025 年 12 月 10 日列出 31 种语言,2026 年 8 月 31 日列出 58 个不重复的基础语言代码——九条带日期的更新日志里累计新增 39 种语言。
- 覆盖率不是一个数字。Deepgram 的
language=multi语码转换模式恰好覆盖 10 种语言(英语、西班牙语、法语、德语、印地语、俄语、葡萄牙语、日语、意大利语、荷兰语)。其余 48 种只能一次处理一种语言。- 批处理和流式是两个产品。8 月 7 日的发布改进了泰米尔语的两条路径,印尼语只改了批处理,白俄罗斯语只改了流式。同一条更新日志,三种不同结果。
- 单语模型依然更强。对 Nova-3 的 58 种语言中的 48 种来说,专用模型不只是比多语模式更好——它是唯一存在的选项。
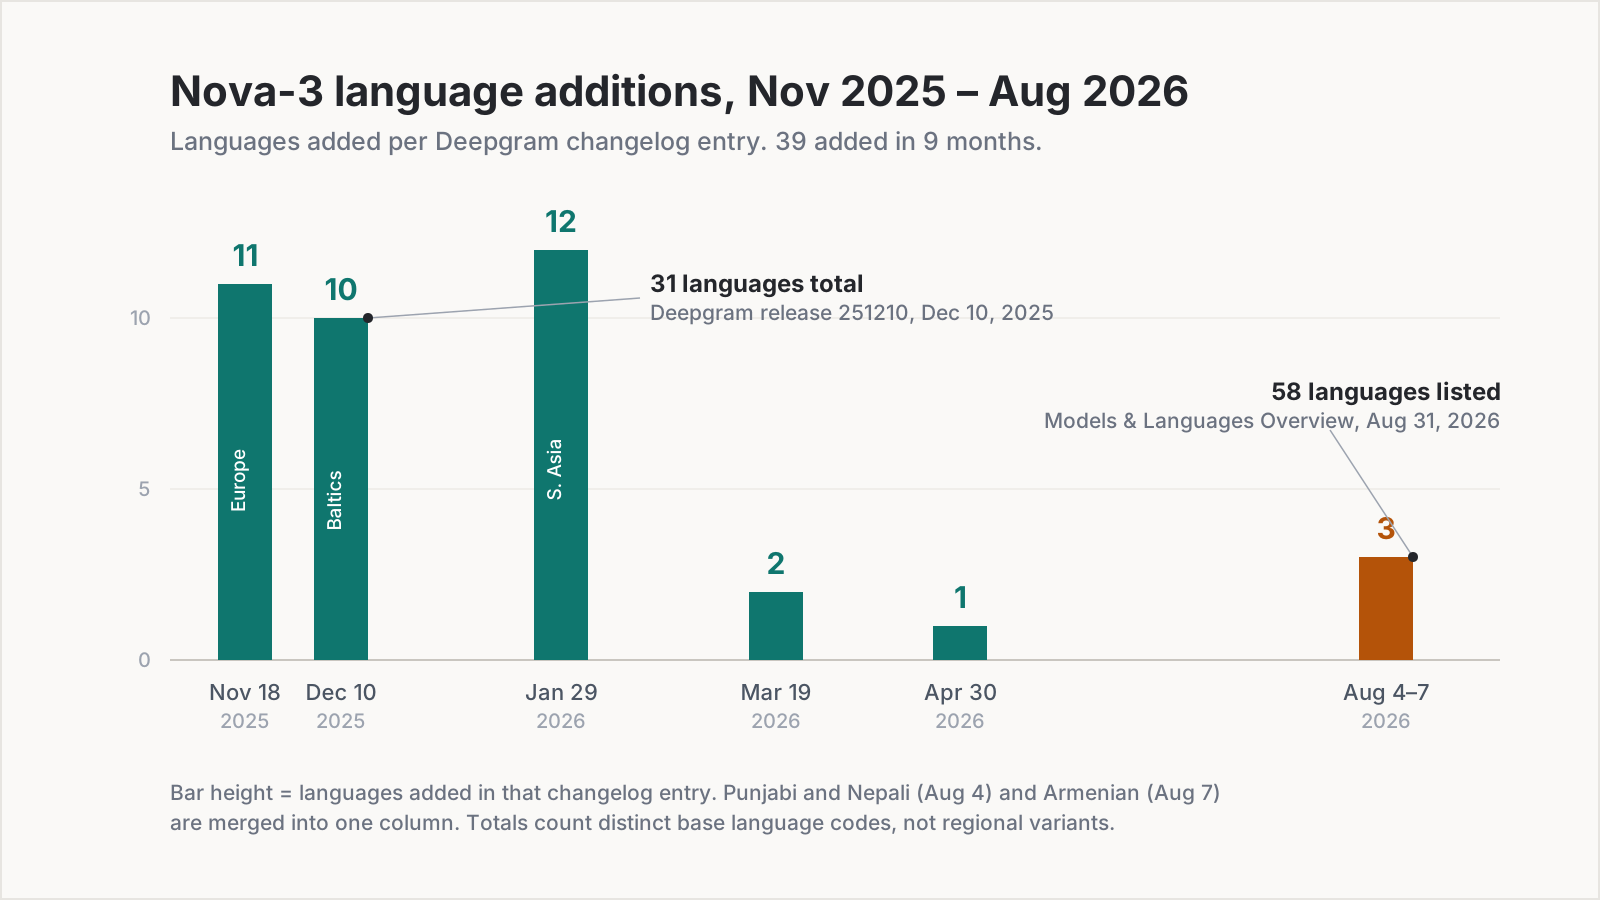
图表:Telli.sh 制作,数据来自 2025 年 11 月 18 日至 2026 年 8 月 10 日的 Deepgram 更新日志,以及 2026 年 8 月 31 日取回的 Models & Languages Overview。
12 月三十一种,8 月五十八种
语音识别厂商很少像宣传准确率那样宣传语言覆盖。它藏在发布说明里,一次几种,累积效应很容易被忽略,除非你回头把它们一条条加起来。所以我们加了。
Deepgram 编号 251118、日期为 2025 年 11 月 18 日的发布,为 Nova-3 的单语支持一口气增加了 11 种语言——保加利亚语、捷克语、芬兰语、印地语、匈牙利语、日语、韩语、波兰语、俄语、乌克兰语和越南语。三周后的 251210 发布,日期 2025 年 12 月 10 日,又在南欧、波罗的海和东南亚方向补上 10 种:希腊语、罗马尼亚语、斯洛伐克语、加泰罗尼亚语、立陶宛语、拉脱维亚语、爱沙尼亚语、佛兰芒语、瑞士德语和马来语。那条发布说明里有整个故事中最有用的一句话:「Nova-3 现已支持 31 种语言。」
此后新增就没停过。2026 年 1 月 29 日的 260129 发布又添了 12 种,其中包括白俄罗斯语、孟加拉语、波斯尼亚语和克罗地亚语。2026 年 3 月 19 日的 260319 带来泰语和粤语。2026 年 4 月 30 日的 260430 加入古吉拉特语。然后是 8 月:4 日的旁遮普语和尼泊尔语,7 日的亚美尼亚语。
把 2025 年 11 月 18 日到 2026 年 8 月 10 日这段时间里有据可查的新增加起来,是不到九个月内的 39 种语言。大致相当于每七天就有一种新语言上线,持续不断,而且只来自一家厂商。
这里有个细节值得留意,因为它说明了这些发布是怎么真正抵达你手里的。云端更新日志把旁遮普语和尼泊尔语的上线日期记为 2026 年 8 月 4 日。而打包同一批模型的私有化部署版本 260812,日期是 8 月 12 日。托管 API 和容器镜像之间隔了八天。如果你在自己的硬件上跑 Deepgram,「支持」这件事比别人晚了一周多才发生。
「支持」不是一件事——它是三个问题
现在说说头条数字掩盖的那部分。当厂商说某种语言已支持时,这一个词至少在同时干三件活,而这三件活经常各走各的。
你能实时用它,还是只能事后用?批处理转录和流式转录跑的是不同的模型,受不同的约束。流式模型必须在听完整句之前就把词定下来;批处理模型拿到的是完整录音。厂商是分开发布这两套的,而且并不总是同时发布。
这个模型到底有多好?「支持」只告诉你一个语言代码会被接受,并不保证输出能拿去当董事会记录用。上个月才加进来的语言,和已经迭代过四轮的语言,在同一张表格的同一格里长得一模一样。
它能和另一种语言混着说吗?这一条几乎没人会去查,直到它出问题。转录一场所有人都说尼泊尔语的会议,和转录一场大家在句子中途就在尼泊尔语和英语之间来回切换的会议,是两个不同的技术问题,而第二个问题被解决的语言范围要窄得多。
8 月自家的更新日志,是我们这一年里见过的关于第一个问题最干净的例证。8 月 7 日那条更新改进了四件事,而且改得并不平均。
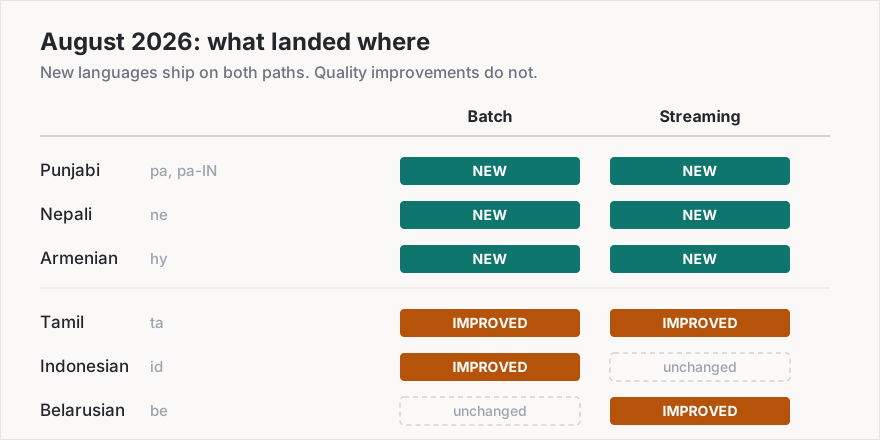
图表:Telli.sh 制作,数据来自 2026 年 8 月 4 日和 8 月 7 日的 Deepgram 更新日志。
旁遮普语、尼泊尔语和亚美尼亚语在两条路径上同时到位——Deepgram 明确写道,这些语言的批处理和流式模型均已可用。泰米尔语在批处理和流式两边都拿到了改进模型。印尼语拿到的是改进后的批处理模型,流式那边没有任何新东西。白俄罗斯语拿到的是改进后的流式模型,批处理那边没有任何新东西。
如果你要转录录好的印尼语访谈,8 月 7 日对你是个好日子。如果你要开印尼语的实时会议,8 月 7 日什么都没变。这两个事实并排住在同一条更新日志的同一个项目列表里,而任何对那条日志的摘要都不会告诉你哪一条适用于你。
这种不对称并不是厂商偷懒。它恰恰反映出:这真的是两套不同的模型,有各自的训练和验证预算。这也是「按单个语言而不是按头条数字去读厂商更新日志」这件事最有力的论据。
覆盖悬崖:58 种语言,10 种对话
现在轮到第三个问题,最有意思的落差就在这里。
Deepgram 的多语语码转换模式只需一个参数 language=multi 就能启用,它让一次请求就能处理说话人在句子内部切换语言的情况。这功能是真的好用,而且在 Nova-2、Nova-3 和 Flux Multilingual 上都有。它也比单语目录窄得多。
在 Nova-3 上,language=multi 恰好覆盖十种语言:英语、西班牙语、法语、德语、印地语、俄语、葡萄牙语、日语、意大利语和荷兰语。在 Nova-2 上,同一个参数只覆盖两种——西班牙语和英语。
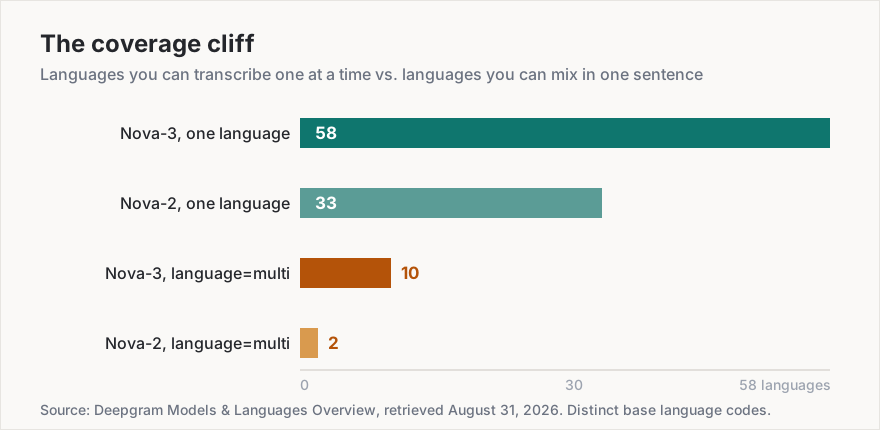
图表:Telli.sh 制作,数据来自 2026 年 8 月 31 日取回的 Deepgram Models & Languages Overview。计数为不重复的基础语言代码,不含地区与文字变体。
我们把它叫作覆盖悬崖:厂商列出的语言,和你那场真实、杂乱、夹着半句英文的会议实际被处理成的语言,两者之间的那道落差。五十八种语言站在悬崖顶上。掉下去还活着的有十种。
对于站错边的那 48 种语言——旁遮普语、尼泊尔语、亚美尼亚语、泰米尔语、孟加拉语、泰语、韩语、越南语、马来语,以及其余那些——专用单语模型不仅仅是更好的选择。它是唯一的选择。根本不存在一条语码转换路径供你比较。
说到这里就是重点了,而它和多语模式一定更强的直觉正好相反:对世界上大多数语言而言,单语模型才是高阶选项,不是退而求其次的备胎。专用模型是在一种语言的音系、一种语言的词汇分布、一种语言的数字与日期表达上训练出来的。多语模型必须同时把十种语言绷在一起,然后逐词判断自己听到的是哪一种。当你知道这场会议说的是泰米尔语,把这件事告诉引擎并不是你在接受某种限制——那是你能拿到的、准确率最高的配置。
language=multi(语码转换) | 专用单语模型 | |
|---|---|---|
| Nova-3 语言覆盖 | 10 种语言 | 58 种语言 |
| Nova-2 语言覆盖 | 2 种语言(西班牙语 + 英语) | 33 种语言 |
| 处理句中切换 | 支持 | 不支持——非本语言的语音会导致质量下降 |
| 单一已知语言的准确率 | 较低;模型要在候选语言之间仲裁 | 较高;模型是专门化的 |
| 关键词提示 | Nova-3 Multi 支持,最多 500 个 token(约 100 词),自 2025 年 12 月 10 日起 | 支持 |
| 推荐的流式设置 | 按 Deepgram 指南设为 endpointing=100 | 默认 endpointing |
| 是否支持旁遮普语、尼泊尔语、亚美尼亚语、泰米尔语 | 否 | 是 |
这张表的实用读法是:如果你的会议真的是一句英语一句西班牙语地混着来,那就用 multi,并接受准确率上的代价。如果你的会议是泰米尔语、偶尔夹几个英文外来词——绝大多数所谓「多语」会议其实就是这样——那就设 language=ta,让专用模型好好干活。
这个月,谁真的开上了更好的会
架构说够了。2026 年 8 月有六种语言改变了状态,而每一个语言代码背后,都是一群长期只能忍受糟糕转录、或者干脆没有转录的人。
| 语言 | 代码 | 使用人数 | 2026 年 8 月的变化 |
|---|---|---|---|
| 旁遮普语 | pa、pa-IN | 约 1.25 亿 | Nova-3 新增,批处理与流式(8 月 4 日) |
| 尼泊尔语 | ne | 约 1600 万 | Nova-3 新增,批处理与流式(8 月 4 日) |
| 亚美尼亚语 | hy | 约 670 万 | Nova-3 新增,批处理与流式(8 月 7 日) |
| 泰米尔语 | ta | 约 7500 万母语者 | 模型改进,批处理与流式(8 月 7 日) |
| 印尼语 | id | 约 1.99 亿(含第二语言使用者) | 仅批处理模型改进(8 月 7 日) |
| 白俄罗斯语 | be | 约 760 万 | 仅流式模型改进(8 月 7 日) |
使用人数:Ethnologue 数据经 Wikidata 汇总(属性 P1098),2026 年 8 月 31 日取回。数值已取整。
粗略算下来,一周之内约有 4.3 亿人的母语获得了可测量的语音识别提升,其中约 1.48 亿人——说旁遮普语、尼泊尔语和亚美尼亚语的那部分——从在 Nova-3 上根本没有一等公民选项,变成了批处理和流式两条路径都有。
想想这在一个真实房间里意味着什么。昌迪加尔一支工程团队的每日站会,过去要么为了迁就工具而改用第二语言,要么干脆不做记录,现在能产出实时转录稿。加德满都一家 NGO 的现场复盘,从某个人的手写笔记变成可检索的记录。亚美尼亚的一场法律取证,可以现场转录,而不必按分钟计费送出去人工听写。
还有一个二阶效应,它比转录稿本身更重要。一旦某种语言的语音能被实时机读,下游的一切就会同时解锁:给远程参会者的实时翻译、自动摘要、抽取的行动项、跨一整年会议的搜索。语音识别是整条链路的瓶颈环节。每一种跨过这道坎的语言,都会直接继承当初为英语搭好的全部流水线。
如果你的团队里有人习惯性地切回英语,理由是「这工具不支持我们的语言」,那么这次更新终结的正是这个妥协。
多语会议该怎么选语言设置
引擎的改进只有在你把会话配置对了才有意义,而默认设置对多语团队来说经常是错的。五个步骤,按顺序来:
- 先判断这场会议是有一门主导语言,还是真的在混用。泰米尔语会议里偶尔冒几个英文外来词,那是一种语言。西班牙语和英语整句整句地交替,那是两种。只有第二种情况才需要语码转换。
- 如果是一种语言,就把它明确设出来。用
model=nova-3配上具体代码——旁遮普语用language=pa,尼泊尔语用language=ne,亚美尼亚语用language=hy。不要把它留给自动检测;答案你本来就知道,告诉模型不花你一分钱。 - 如果确实在混用,先拿这些语言去对那份十种语言的名单。只有当会议室里的每一种语言都出现在英语、西班牙语、法语、德语、印地语、俄语、葡萄牙语、日语、意大利语、荷兰语之中时,才设
language=multi。只要有一种不在,multi就帮不了你,此时主导语言的专用模型就是你能拿到的最优解。 - 实时会话使用
multi时,把endpointing设为 100。Deepgram 自己的语码转换指南专门针对语码转换场景推荐 100 毫秒,而不是更高的默认值。过长的 endpointing 会让切换语言后的短语被吸进错误的分段里。 - 在做出任何承诺之前,分别验证批处理和流式。正如 8 月 7 日所展示的,一条路径的改进不等于另一条路径的改进。拿同一段 10 分钟样本分别跑两条路径再对比,而不是假设某条更新日志适用于你这条路径。
我们在 6 月写过这个话题的另一个切面——Deepgram 年中更新:自适应实时会话与说话人分离,其中包括 UpdateListen 控制指令,它让一个正在运行的会话无需重连就能更改语言提示。上面的第 2 步和这个能力配合得很好:开场就把语言明确设好,如果房间里的语言真的变了,就在会议中途调整。
结论:覆盖率不再是一个数字,而是一张矩阵
比较语音引擎时,人的本能是去找那个最大的数字。OpenAI Whisper 的分词器从 2022 年起就声明了 100 个语言 token——几乎是 Nova-3 那 58 种的两倍——而这个对比几乎什么都说明不了,因为 Whisper 没有原生流式路径,声明一个 token 也不等于交付一个经过验证的生产模型。Nova-3 列出的语言更少,但它是按语言、按模式、带着确切日期的证据交付出来的。
真正描述一个引擎覆盖能力的东西不是一个计数。它是一张矩阵:语言 × 模式 × 质量档位。五十八种语言,一次一种。其中十种可以混说。同一次发布、同一天里,一种语言只在批处理改进,另一种只在流式改进。
所以,下次做厂商评估时该带去的问题不是「你们支持多少种语言」。而是:针对我这门语言、我这条路径,截至哪一天?
Telli.sh 在这里的位置:以上全部是引擎层的细节,而我们认为大多数团队根本不该需要知道这些。Telli.sh 就架在那一层之上,替你做出上面编号列表里的那些选择——会议只有一种语言时挑选专用模型,让批量上传和实时会话各走各的正确路径,并且在 8 月这类引擎改进发布的当周就继承它们,而不是等到你下一次迁移。在转录稿之上,我们提供实时翻译,支持 44 种目标语言和 15 种界面语言,所以从华沙远程加入你旁遮普语站会的那位同事,能在会议进行的同时用波兰语读到内容。
参考来源
- Deepgram changelog, August 4, 2026 — Nova-3 Model Update —— 旁遮普语(
pa、pa-IN)与尼泊尔语(ne),批处理与流式均已可用 - Deepgram changelog, August 7, 2026 — Nova-3 Adds Armenian, Plus Improved Models for Tamil, Indonesian, and Belarusian —— 新增亚美尼亚语(
hy);泰米尔语与印尼语的批处理模型改进;泰米尔语与白俄罗斯语的流式模型改进 - Deepgram Models & Languages Overview —— 完整的 Nova-3 与 Nova-2 语言表以及
multi语言清单,2026 年 8 月 31 日取回 - Deepgram Multilingual Codeswitching guide ——
language=multi用法与endpointing=100建议,2026 年 8 月 31 日取回 - Deepgram Self-Hosted release 251210, December 10, 2025 —— 「Nova-3 现已支持 31 种语言」;多语关键词提示最多 500 个 token
- Deepgram Self-Hosted release 251118, November 18, 2025 —— 11 种新语言,以及 36 种语言的检测模型
- Deepgram Self-Hosted release 260129, January 29, 2026 —— 12 种 Nova-3 新语言,含白俄罗斯语、孟加拉语、波斯尼亚语、克罗地亚语
- Deepgram Self-Hosted release 260319, March 19, 2026 —— 泰语与粤语
- Deepgram Self-Hosted release 260430, April 30, 2026 —— 古吉拉特语
- Deepgram Self-Hosted release 260812, August 12, 2026 —— 尼泊尔语与旁遮普语的私有化部署打包版本,比云端条目晚八天
- OpenAI Whisper tokenizer language table —— 声明了 100 个语言 token,2026 年 8 月 31 日取回
- Wikidata property P1098 (number of speakers) ——
pa、ne、hy、ta、id、be的 Ethnologue 使用人数数据,2026 年 8 月 31 日取回 - 我们 2026 年 6 月对 Deepgram 实时会话与说话人分离更新的报道