O Nova-3 ganhou seu 58º idioma neste mês. Só 10 deles funcionam na mesma frase.
Em 4 de agosto de 2026 a Deepgram adicionou punjabi e nepali ao Nova-3; em 7 de agosto acrescentou armênio e melhorou tâmil, indonésio e bielorrusso. Nove meses atrás o modelo cobria 31 idiomas — hoje a documentação lista 58. Mas a alternância de idiomas dentro da frase ainda funciona em exatamente 10, e o próprio changelog de agosto mostra o indonésio melhorando em lote enquanto o bielorrusso melhorou só em streaming. Um olhar sobre o ritmo da cobertura de idiomas no reconhecimento de fala — e sobre o que a palavra “suportado” está escondendo.
Em 4 de agosto de 2026, a Deepgram adicionou punjabi e nepali ao seu modelo de reconhecimento de fala Nova-3. Três dias depois acrescentou o armênio, junto com modelos monolíngues melhorados para tâmil, indonésio e bielorrusso.
Duas entradas de changelog, onze linhas de texto entre as duas, nenhum comunicado à imprensa. E, ainda assim, para quem conduz reuniões nesses idiomas, é a coisa mais importante que aconteceu ao reconhecimento de fala neste mês.
O padrão por trás dessas entradas vale mais do que as entradas em si. Em dezembro de 2025, as próprias notas de versão da Deepgram colocavam o Nova-3 em 31 idiomas no total. Contando os códigos de idioma base distintos no Models & Languages Overview da Deepgram hoje, 31 de agosto de 2026, chega-se a 58. Esse é o ritmo em que a indústria inteira se move, e ele mudou silenciosamente o que você deveria esperar de uma transcrição.
Este post faz três coisas. Coloca números e datas nessa expansão a partir de fontes primárias. Explica por que uma contagem de idiomas de manchete é quase inútil sozinha — e quais são as três perguntas que você precisa fazer no lugar. E percorre o que as adições de agosto mudam concretamente para uma reunião com falantes de punjabi, nepali, armênio, tâmil ou indonésio na sala.
Resumo:
- 58 contra 31. A documentação do Nova-3 listava 31 idiomas no total em 10 de dezembro de 2025 e 58 códigos de idioma base distintos em 31 de agosto de 2026 — 39 idiomas adicionados ao longo de nove entradas datadas de changelog.
- Cobertura não é um número só. O modo de alternância de idiomas
language=multida Deepgram cobre exatamente 10 idiomas (inglês, espanhol, francês, alemão, hindi, russo, português, japonês, italiano e holandês). Os outros 48 são só um idioma por vez.- Lote e streaming são produtos separados. A versão de 7 de agosto melhorou o tâmil nos dois, o indonésio só em lote e o bielorrusso só em streaming. Mesma entrada de changelog, três resultados diferentes.
- O monolíngue ainda vence. Para 48 dos 58 idiomas do Nova-3, um modelo dedicado não é apenas melhor que o modo multilíngue — é a única opção que existe.
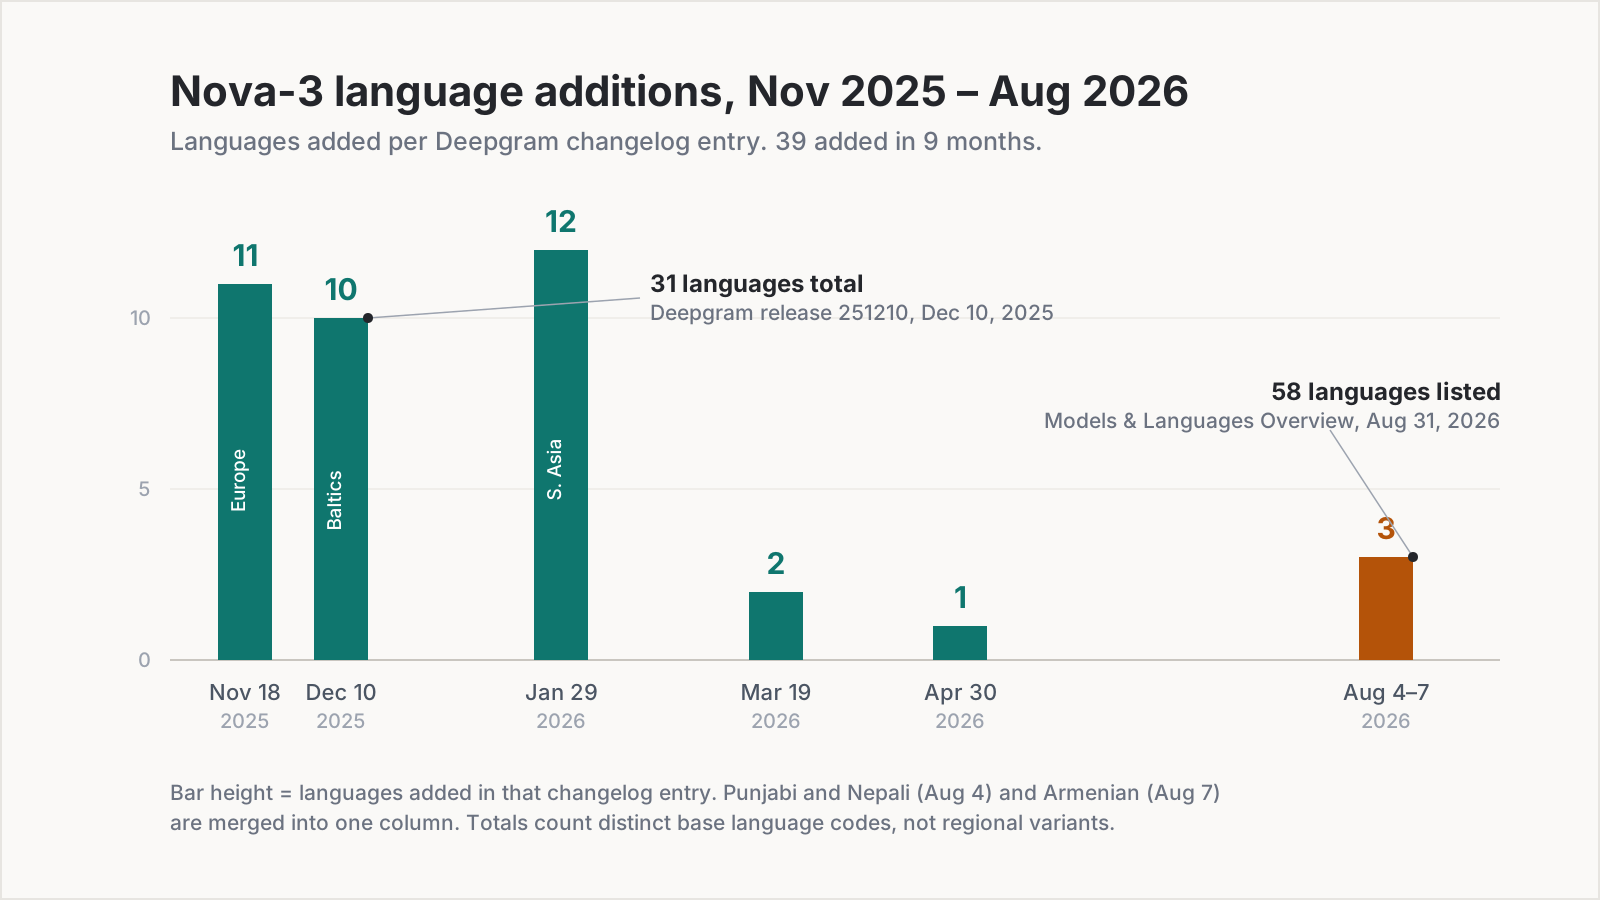
Gráfico: Telli.sh, construído a partir das entradas de changelog da Deepgram datadas de 18 de novembro de 2025 a 10 de agosto de 2026, e do Models & Languages Overview consultado em 31 de agosto de 2026.
Trinta e um idiomas em dezembro, cinquenta e oito em agosto
Fornecedores de reconhecimento de fala raramente anunciam cobertura de idiomas do jeito que anunciam acurácia. Ela chega em notas de versão, um punhado por vez, e o efeito cumulativo passa fácil despercebido a menos que você volte e some tudo. Foi o que fizemos.
A versão 251118 da Deepgram, datada de 18 de novembro de 2025, expandiu o suporte monolíngue do Nova-3 com 11 novos idiomas — búlgaro, tcheco, finlandês, hindi, húngaro, japonês, coreano, polonês, russo, ucraniano e vietnamita. A versão 251210, três semanas depois, em 10 de dezembro de 2025, adicionou mais 10 pelo sul da Europa, pelos países bálticos e pelo Sudeste Asiático: grego, romeno, eslovaco, catalão, lituano, letão, estoniano, flamengo, alemão suíço e malaio. Essa nota de versão contém a frase mais útil de toda esta história: “o Nova-3 agora suporta 31 idiomas no total”.
Dali em diante as adições não pararam. A versão 260129, em 29 de janeiro de 2026, trouxe mais 12, incluindo bielorrusso, bengali, bósnio e croata. A versão 260319, em 19 de março de 2026, trouxe tailandês e cantonês. A versão 260430, em 30 de abril de 2026, adicionou guzerate. E então agosto: punjabi e nepali no dia 4, armênio no dia 7.
Some as adições documentadas de 18 de novembro de 2025 a 10 de agosto de 2026 e você tem 39 idiomas em pouco menos de nove meses. Isso é, grosso modo, um idioma novo a cada sete dias, de forma sustentada, vindo de um único fornecedor.
Aqui vai um detalhe que vale notar, porque diz algo sobre como essas versões chegam de fato até você. O changelog da nuvem data a adição de punjabi e nepali em 4 de agosto de 2026. A versão self-hosted que empacota os mesmos modelos, a 260812, é datada de 12 de agosto. Oito dias de atraso entre a API hospedada e a imagem de contêiner. Se você roda a Deepgram no seu próprio hardware, o “suportado” chegou mais de uma semana depois do que para todo mundo.
“Suportado” não é uma coisa só — são três perguntas
Agora a parte que os números de manchete escondem. Quando um fornecedor diz que um idioma é suportado, essa única palavra está fazendo pelo menos três trabalhos, e eles se descolam o tempo todo.
Dá para usar em tempo real, ou só depois do fato? Transcrição em lote e transcrição em streaming rodam modelos diferentes com restrições diferentes. Um modelo de streaming tem de se comprometer com as palavras antes de ouvir o fim da frase; um modelo em lote recebe a gravação inteira. Os fornecedores entregam os dois separadamente, e nem sempre entregam juntos.
Quão bom é o modelo, de verdade? “Suportado” diz que um código será aceito, não que a saída serve para uma reunião de conselho. Um idioma adicionado no mês passado e um idioma que já passou por quatro rodadas de melhoria aparecem na mesma célula da mesma tabela.
Dá para misturar com outro idioma? Essa é a que quase ninguém verifica até quebrar. Transcrever uma reunião em que todos falam nepali é um problema técnico diferente de transcrever uma reunião em que as pessoas alternam entre nepali e inglês no meio da frase, e o segundo problema está resolvido para bem menos idiomas.
O próprio changelog de agosto é a ilustração mais limpa da primeira pergunta que vimos em um ano. A entrada de 7 de agosto melhorou quatro coisas, e não as melhorou de maneira uniforme.
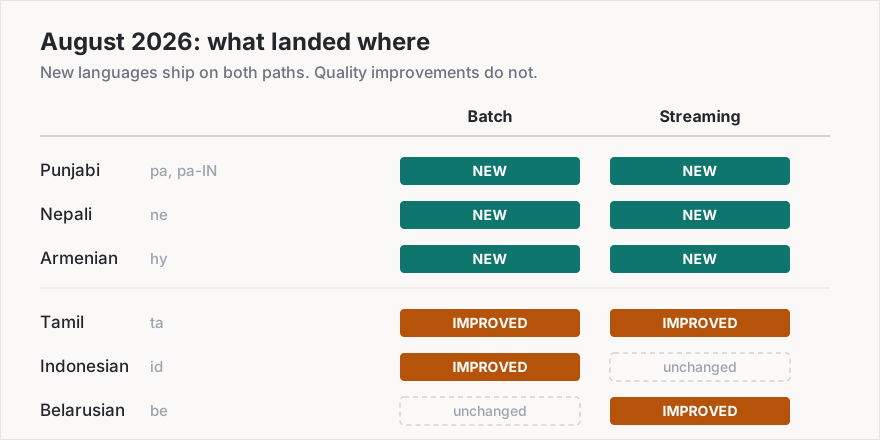
Gráfico: Telli.sh, a partir das entradas de changelog da Deepgram de 4 e 7 de agosto de 2026.
Punjabi, nepali e armênio chegaram pelos dois caminhos — a Deepgram afirma sem rodeios que “os modelos de lote e de streaming estão ambos disponíveis para esses idiomas”. O tâmil ganhou um modelo melhorado tanto em lote quanto em streaming. O indonésio ganhou um modelo em lote melhorado e nada de novo para streaming. O bielorrusso ganhou um modelo de streaming melhorado e nada de novo para lote.
Se você transcreve entrevistas gravadas em indonésio, 7 de agosto foi um bom dia para você. Se você conduz reuniões ao vivo em indonésio, 7 de agosto não mudou nada. Os dois fatos moram dentro de uma mesma lista de bullets em uma mesma entrada de changelog, e nenhum resumo dessa entrada vai lhe dizer qual dos dois se aplica a você.
Essa assimetria não é desleixo. Ela reflete o fato de que esses realmente são modelos diferentes, com orçamentos diferentes de treinamento e validação, e é o argumento isolado mais forte a favor de ler changelogs de fornecedores no nível de cada idioma, e não no nível da manchete.
O penhasco de cobertura: 58 idiomas, 10 conversas
Agora a terceira pergunta, que é onde mora a lacuna interessante.
O modo multilíngue de alternância de idiomas da Deepgram é ativado com um único parâmetro, language=multi, e permite que uma requisição lide com falantes trocando de idioma dentro de uma frase. É genuinamente útil e está disponível no Nova-2, no Nova-3 e no Flux Multilingual. Também é bem mais estreito que o catálogo monolíngue.
No Nova-3, language=multi cobre exatamente dez idiomas: inglês, espanhol, francês, alemão, hindi, russo, português, japonês, italiano e holandês. No Nova-2, o mesmo parâmetro cobre dois — espanhol e inglês.
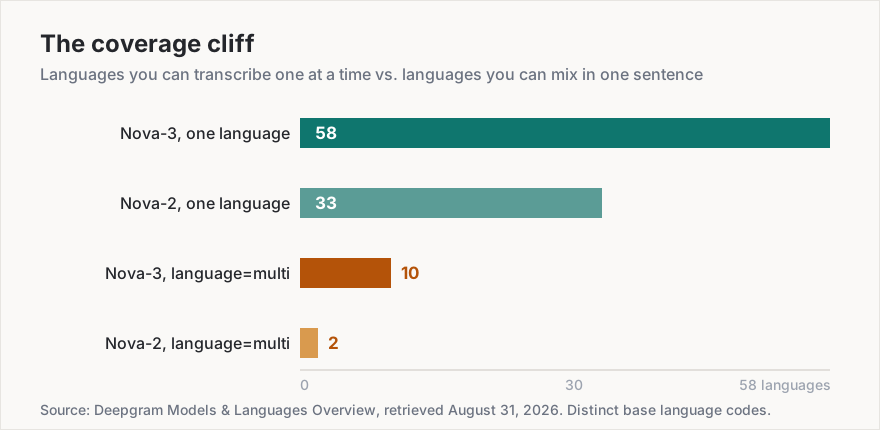
Gráfico: Telli.sh, a partir do Deepgram Models & Languages Overview, consultado em 31 de agosto de 2026. As contagens são de códigos de idioma base distintos, excluindo variantes regionais e de escrita.
Chame de penhasco de cobertura: a queda entre o idioma que o fornecedor lista e o idioma em que a sua reunião real, bagunçada e meio em inglês é de fato atendida. Cinquenta e oito idiomas ficam no alto desse penhasco. Dez sobrevivem à queda.
Para os 48 idiomas do lado errado — punjabi, nepali, armênio, tâmil, bengali, tailandês, coreano, vietnamita, malaio e o resto — o modelo monolíngue dedicado não é apenas a melhor escolha. É a única escolha. Não existe um caminho de alternância de idiomas com o qual compará-lo.
Aqui está o ponto, e ele vai contra a intuição de que um modo multilíngue é estritamente mais capaz: para a maioria dos idiomas do mundo, o modelo monolíngue é a opção avançada, não o plano B. Um modelo dedicado é treinado na fonética de um idioma, na distribuição de vocabulário de um idioma, nos números e nas datas de um idioma. O modelo multilíngue precisa segurar dez dessas coisas em tensão e decidir, palavra por palavra, qual delas está ouvindo. Quando você sabe que a reunião é em tâmil, dizer isso ao motor não é uma limitação que você aceita — é a configuração de maior acurácia disponível para você.
language=multi (alternância de idiomas) | Modelo de idioma dedicado | |
|---|---|---|
| Cobertura de idiomas no Nova-3 | 10 idiomas | 58 idiomas |
| Cobertura de idiomas no Nova-2 | 2 idiomas (espanhol + inglês) | 33 idiomas |
| Lida com troca no meio da frase | Sim | Não — fala em outro idioma degrada o resultado |
| Acurácia em um único idioma conhecido | Menor; o modelo arbitra entre candidatos | Maior; o modelo é especializado |
| Keyterm prompting | Sim no Nova-3 Multi, até 500 tokens (~100 palavras), desde 10 de dez. de 2025 | Sim |
| Configuração de streaming recomendada | endpointing=100, conforme o guia da Deepgram | Endpointing padrão |
| Disponível para punjabi, nepali, armênio, tâmil | Não | Sim |
A leitura prática dessa tabela: se a sua reunião realmente mistura inglês e espanhol frase a frase, use multi e aceite a troca em acurácia. Se a sua reunião é em tâmil com estrangeirismos ocasionais em inglês — que é o que a maior parte das reuniões “multilíngues” de fato é —, defina language=ta e deixe o modelo dedicado fazer o trabalho dele.
Quem realmente ganha uma reunião melhor neste mês
Chega de arquitetura. Seis idiomas mudaram de estado em agosto de 2026, e por trás de cada código há uma população que vinha transcrevendo reuniões mal, ou simplesmente não vinha transcrevendo.
| Idioma | Código | Falantes | O que mudou em agosto de 2026 |
|---|---|---|---|
| Punjabi | pa, pa-IN | ~125 milhões | Novo no Nova-3, em lote e streaming (4 de ago.) |
| Nepali | ne | ~16 milhões | Novo no Nova-3, em lote e streaming (4 de ago.) |
| Armênio | hy | ~6,7 milhões | Novo no Nova-3, em lote e streaming (7 de ago.) |
| Tâmil | ta | ~75 milhões de nativos | Modelo melhorado, em lote e streaming (7 de ago.) |
| Indonésio | id | ~199 milhões incl. segunda língua | Só o modelo em lote melhorado (7 de ago.) |
| Bielorrusso | be | ~7,6 milhões | Só o modelo de streaming melhorado (7 de ago.) |
Números de falantes: contagens do Ethnologue conforme agregadas no Wikidata (propriedade P1098), consultadas em 31 de agosto de 2026. Arredondados.
São aproximadamente 430 milhões de pessoas cujo idioma ganhou reconhecimento de fala mensuravelmente melhor em uma única semana, e cerca de 148 milhões delas — os falantes de punjabi, nepali e armênio — saíram de não ter nenhuma opção de primeira classe no Nova-3 para ter uma, tanto em lote quanto em streaming.
Pense no que isso significa dentro de uma sala. A daily de um time de engenharia em Chandigarh, antes conduzida em uma segunda língua para agradar à ferramenta ou deixada sem transcrição, agora produz uma transcrição em tempo real. O debriefing de campo de uma ONG em Katmandu vira um registro pesquisável em vez das anotações manuscritas de alguém. Um depoimento jurídico em armênio pode ser transcrito ao vivo, em vez de ser enviado para transcrição manual a um valor por minuto.
Há um efeito de segunda ordem que importa mais que a própria transcrição. Assim que a fala em um idioma se torna legível por máquina em tempo real, tudo o que vem depois se destrava de uma vez: tradução ao vivo para participantes remotos, resumos automáticos, itens de ação extraídos, busca em um ano de reuniões. O reconhecimento de fala é o estágio-gargalo. Todo idioma que o atravessa herda o pipeline inteiro que foi construído para o inglês.
Se você está num time em que alguém habitualmente muda para o inglês porque “a ferramenta não fala a nossa língua”, esta é a atualização que encerra esse acordo específico.
Como escolher a configuração de idioma para uma reunião multilíngue
As melhorias do motor só ajudam se você configurar a sessão corretamente, e os padrões são frequentemente errados para times multilíngues. Cinco passos, nesta ordem:
- Determine se a reunião tem um idioma dominante ou se mistura de verdade. Estrangeirismos ocasionais em inglês numa reunião em tâmil são um idioma. Alternar frases inteiras entre espanhol e inglês são dois. Só o segundo caso precisa de alternância de idiomas.
- Se for um idioma só, defina esse idioma explicitamente. Use
model=nova-3com o código específico —language=papara punjabi,language=nepara nepali,language=hypara armênio. Não deixe na detecção automática; você já sabe a resposta, e dizê-la ao modelo não custa nada. - Se misturar de verdade, confira o idioma contra a lista dos dez. Defina
language=multisó se todo idioma na sala aparecer entre inglês, espanhol, francês, alemão, hindi, russo, português, japonês, italiano e holandês. Se algum não aparecer,multinão vai ajudar, e o modelo do idioma dominante é a sua melhor opção disponível. - Para sessões ao vivo usando
multi, definaendpointing=100. O próprio guia de alternância de idiomas da Deepgram recomenda 100 ms especificamente para code-switching, contra o padrão mais alto. Um endpointing mais longo faz uma frase em outro idioma ser absorvida pelo segmento errado. - Verifique lote e streaming separadamente antes de prometer qualquer coisa. Como 7 de agosto demonstrou, uma melhoria em um não é uma melhoria no outro. Rode a mesma amostra de 10 minutos pelos dois caminhos e compare, em vez de supor que uma entrada de changelog se aplica ao seu caminho.
Cobrimos uma fatia diferente disso em junho — a atualização de meio de ano da Deepgram sobre sessões ao vivo adaptativas e diarização, incluindo o controle UpdateListen, que deixa uma sessão em andamento mudar as dicas de idioma sem reconectar. O passo 2 acima e essa capacidade se combinam bem: defina o idioma explicitamente no início e ajuste no meio da reunião se a sala realmente mudar.
O essencial: cobertura deixou de ser um número e virou uma matriz
O instinto ao comparar motores de fala é procurar o maior número. O tokenizador do Whisper, da OpenAI, declara 100 tokens de idioma desde 2022 — quase o dobro dos 58 do Nova-3 — e essa comparação não diz quase nada, porque o Whisper não tem caminho nativo de streaming e um token declarado não é um modelo validado em produção. O Nova-3 lista menos idiomas e os entrega, por idioma, por modo, com evidência datada.
O número que descreve a cobertura real de um motor não é uma contagem. É uma matriz: idioma × modo × faixa de qualidade. Cinquenta e oito idiomas, um de cada vez. Dez deles misturáveis. Um idioma melhorado em lote e não em streaming, outro em streaming e não em lote, na mesma versão, no mesmo dia.
Então a pergunta a levar para a sua próxima avaliação de fornecedor não é “quantos idiomas vocês suportam”. É: para o meu idioma, no meu caminho, em que data?
Onde a Telli.sh entra: tudo acima é detalhe da camada de motor, e achamos que a maioria dos times não deveria precisar saber nada disso. A Telli.sh fica em cima dessa camada e toma as decisões da lista numerada acima por você — escolhendo o modelo dedicado quando a reunião tem um idioma só, mantendo uploads em lote e sessões ao vivo em seus caminhos corretos, e herdando melhorias do motor como as de agosto na semana em que saem, em vez de na sua próxima migração. Sobre a transcrição, rodamos tradução ao vivo para 44 idiomas de destino e uma interface em 15 idiomas, de modo que a pessoa que entra na sua daily em punjabi lá de Varsóvia leia tudo em polonês enquanto acontece.
Começar uma nota de reunião com tradução ao vivo
Fontes
- Deepgram changelog, August 4, 2026 — Nova-3 Model Update — punjabi (
pa,pa-IN) e nepali (ne), com lote e streaming ambos disponíveis - Deepgram changelog, August 7, 2026 — Nova-3 Adds Armenian, Plus Improved Models for Tamil, Indonesian, and Belarusian — armênio (
hy) novo; modelos em lote melhorados para tâmil e indonésio; modelos de streaming melhorados para tâmil e bielorrusso - Deepgram Models & Languages Overview — tabelas completas de idiomas do Nova-3 e do Nova-2 e a lista de idiomas do
multi, consultado em 31 de agosto de 2026 - Deepgram Multilingual Codeswitching guide — uso de
language=multie a recomendação deendpointing=100, consultado em 31 de agosto de 2026 - Deepgram Self-Hosted release 251210, December 10, 2025 — “o Nova-3 agora suporta 31 idiomas no total”; keyterm prompting multilíngue de até 500 tokens
- Deepgram Self-Hosted release 251118, November 18, 2025 — 11 novos idiomas, mais o modelo de detecção de 36 idiomas
- Deepgram Self-Hosted release 260129, January 29, 2026 — 12 novos idiomas no Nova-3, incluindo bielorrusso, bengali, bósnio e croata
- Deepgram Self-Hosted release 260319, March 19, 2026 — tailandês e cantonês
- Deepgram Self-Hosted release 260430, April 30, 2026 — guzerate
- Deepgram Self-Hosted release 260812, August 12, 2026 — o pacote self-hosted de nepali e punjabi, oito dias depois da entrada da nuvem
- OpenAI Whisper tokenizer language table — 100 tokens de idioma declarados, consultado em 31 de agosto de 2026
- Wikidata property P1098 (number of speakers) — contagens de falantes derivadas do Ethnologue para
pa,ne,hy,ta,id,be, consultado em 31 de agosto de 2026 - Our June 2026 coverage of Deepgram's live-session and diarization updates