Nova-3 a ajouté sa 58e langue ce mois-ci. Seules 10 d'entre elles fonctionnent dans la même phrase.
Le 4 août 2026, Deepgram a ajouté le pendjabi et le népalais à Nova-3 ; le 7 août, l'arménien, avec des modèles améliorés pour le tamoul, l'indonésien et le biélorusse. Il y a neuf mois, le modèle couvrait 31 langues — aujourd'hui la documentation en liste 58. Mais l'alternance codique ne fonctionne que dans 10 d'entre elles, et le changelog d'août montre que l'indonésien ne s'est amélioré qu'en traitement par lots et le biélorusse qu'en streaming. Un état des lieux du rythme de la couverture linguistique en reconnaissance vocale, et de ce que le mot « pris en charge » dissimule réellement.
Le 4 août 2026, Deepgram a ajouté le pendjabi et le népalais à son modèle de reconnaissance vocale Nova-3. Trois jours plus tard, l'arménien s'y est ajouté, accompagné de modèles monolingues améliorés pour le tamoul, l'indonésien et le biélorusse.
Deux entrées de changelog, onze lignes de texte à elles deux, aucun communiqué de presse. Et pourtant, pour quiconque anime des réunions dans ces langues, c'est l'événement le plus lourd de conséquences survenu en reconnaissance vocale ce mois-ci.
Le schéma derrière ces entrées vaut plus que les entrées elles-mêmes. En décembre 2025, les notes de version de Deepgram plaçaient Nova-3 à 31 langues au total. En comptant aujourd'hui, le 31 août 2026, les codes de langue de base distincts dans le Models & Languages Overview de Deepgram, on arrive à 58. C'est le rythme auquel avance toute la filière, et il a discrètement changé ce que vous devez attendre d'une transcription.
Cet article fait trois choses. Il met des chiffres et des dates sur cette expansion à partir de sources primaires. Il explique pourquoi un simple nombre de langues affiché en vitrine ne vous apprend presque rien — et quelles trois questions il faut poser à la place. Et il détaille ce que les ajouts d'août changent concrètement pour une réunion réunissant des locuteurs de pendjabi, de népalais, d'arménien, de tamoul ou d'indonésien.
L'essentiel :
- 58 contre 31. La documentation de Nova-3 annonçait 31 langues au total le 10 décembre 2025 et 58 codes de langue de base distincts le 31 août 2026 — 39 langues ajoutées au fil de neuf entrées de changelog datées.
- La couverture n'est pas un chiffre unique. Le mode d'alternance codique
language=multide Deepgram couvre exactement 10 langues (anglais, espagnol, français, allemand, hindi, russe, portugais, japonais, italien, néerlandais). Les 48 autres ne fonctionnent qu'une langue à la fois.- Traitement par lots et streaming sont deux produits distincts. La version du 7 août a amélioré le tamoul dans les deux modes, l'indonésien en lots seulement et le biélorusse en streaming seulement. Une même entrée de changelog, trois résultats différents.
- Le monolingue reste devant. Pour 48 des 58 langues de Nova-3, un modèle dédié n'est pas seulement meilleur que le mode multilingue — c'est la seule option qui existe.
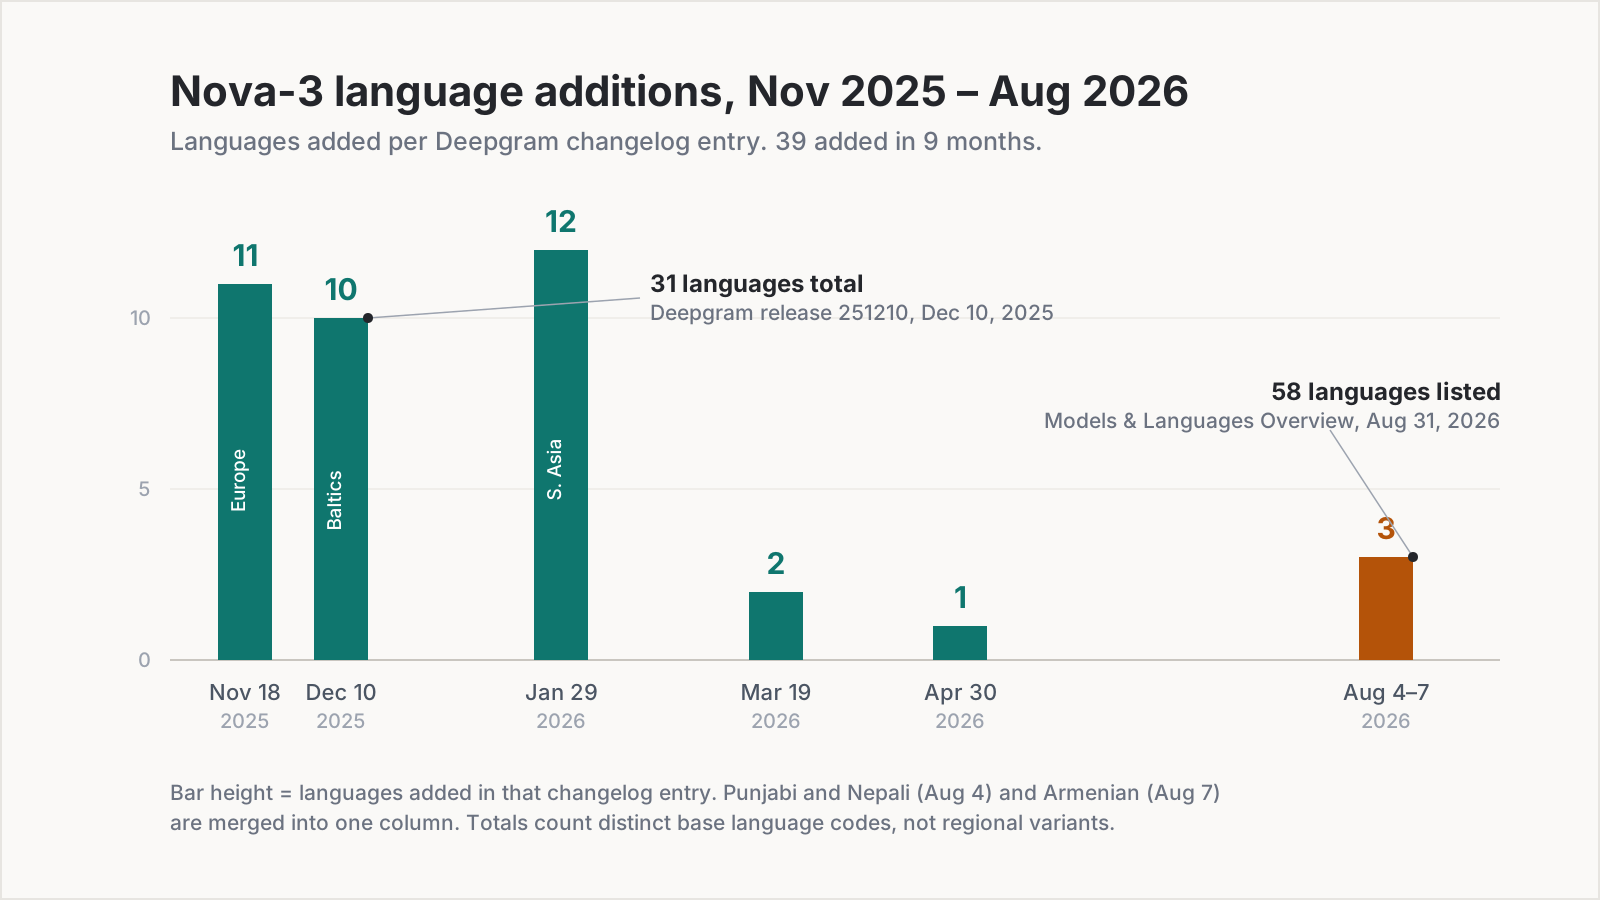
Graphique : Telli.sh, établi à partir des entrées de changelog Deepgram datées du 18 novembre 2025 au 10 août 2026 et du Models & Languages Overview, consulté le 31 août 2026.
Trente et une langues en décembre, cinquante-huit en août
Les éditeurs de reconnaissance vocale annoncent rarement la couverture linguistique comme ils annoncent la précision. Elle arrive dans les notes de version, par petites poignées, et l'effet cumulé passe facilement inaperçu si l'on ne remonte pas le fil pour additionner. C'est ce que nous avons fait.
La version 251118 de Deepgram, datée du 18 novembre 2025, a étendu la prise en charge monolingue de Nova-3 avec 11 nouvelles langues : bulgare, tchèque, finnois, hindi, hongrois, japonais, coréen, polonais, russe, ukrainien et vietnamien. La version 251210, trois semaines plus tard le 10 décembre 2025, en a ajouté 10 autres réparties entre l'Europe du Sud, les pays baltes et l'Asie du Sud-Est : grec, roumain, slovaque, catalan, lituanien, letton, estonien, flamand, suisse allemand et malais. Cette note de version contient la phrase la plus utile de toute l'histoire : « Nova-3 now supports 31 total languages. »
Ensuite, les ajouts n'ont pas cessé. La version 260129 du 29 janvier 2026 en a apporté 12 de plus, dont le biélorusse, le bengali, le bosnien et le croate. La version 260319 du 19 mars 2026 a amené le thaï et le cantonais. La version 260430 du 30 avril 2026 a ajouté le gujarati. Puis août : le pendjabi et le népalais le 4, l'arménien le 7.
Additionnez les ajouts documentés entre le 18 novembre 2025 et le 10 août 2026 : cela fait 39 langues en un peu moins de neuf mois. Soit environ une nouvelle langue tous les sept jours, sans interruption, chez un seul éditeur.
Voici un détail qui mérite l'attention, car il dit quelque chose de la façon dont ces versions vous parviennent réellement. Le changelog cloud date l'ajout du pendjabi et du népalais au 4 août 2026. La version auto-hébergée qui embarque les mêmes modèles, la 260812, est datée du 12 août. Huit jours d'écart entre l'API hébergée et l'image de conteneur. Si vous faites tourner Deepgram sur votre propre matériel, « pris en charge » est arrivé plus d'une semaine après tout le monde.
« Pris en charge » n'est pas une chose, mais trois questions
Passons à ce que les chiffres de vitrine dissimulent. Quand un éditeur annonce qu'une langue est prise en charge, ce seul mot occupe au moins trois fonctions, et elles se dissocient en permanence.
Pouvez-vous l'utiliser en temps réel, ou seulement après coup ? La transcription par lots et la transcription en streaming reposent sur des modèles différents, soumis à des contraintes différentes. Un modèle de streaming doit s'engager sur des mots avant d'avoir entendu la fin de la phrase ; un modèle par lots dispose de l'enregistrement entier. Les éditeurs les livrent séparément, et pas toujours ensemble.
Quelle est vraiment la qualité du modèle ? « Pris en charge » vous dit qu'un code sera accepté, pas que le résultat sera exploitable pour un conseil d'administration. Une langue ajoutée le mois dernier et une langue qui a connu quatre cycles d'amélioration figurent dans la même case du tableau.
Peut-elle être mélangée à une autre langue ? C'est le point que presque personne ne vérifie avant qu'il ne casse. Transcrire une réunion où tout le monde parle népalais est un problème technique différent de transcrire une réunion où les participants passent du népalais à l'anglais au milieu d'une phrase — et le second problème n'est résolu que pour bien moins de langues.
Le changelog d'août est la plus nette illustration de la première question que nous ayons vue depuis un an. L'entrée du 7 août a amélioré quatre choses, et elle ne les a pas améliorées de façon uniforme.
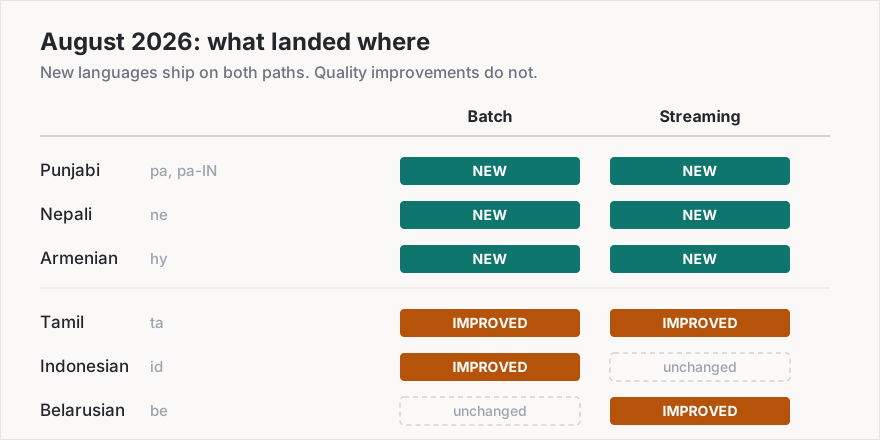
Graphique : Telli.sh, d'après les entrées de changelog Deepgram des 4 et 7 août 2026.
Le pendjabi, le népalais et l'arménien sont arrivés par les deux voies — Deepgram l'indique sans ambiguïté : « batch and streaming models are both available for these languages. » Le tamoul a reçu un modèle amélioré en lots et en streaming. L'indonésien a reçu un modèle par lots amélioré et rien de neuf en streaming. Le biélorusse a reçu un modèle de streaming amélioré et rien de neuf en lots.
Si vous transcrivez des entretiens enregistrés en indonésien, le 7 août fut une bonne journée pour vous. Si vous animez des réunions en indonésien en direct, le 7 août n'a rien changé. Les deux faits cohabitent dans une seule liste à puces, dans une seule entrée de changelog, et aucun résumé de cette entrée ne vous dira lequel vous concerne.
Cette asymétrie n'est pas de la négligence. Elle traduit le fait qu'il s'agit réellement de modèles différents, avec des budgets d'entraînement et de validation différents, et c'est le meilleur argument qui soit pour lire les changelogs des éditeurs au niveau de chaque langue plutôt qu'au niveau du titre.
La falaise de couverture : 58 langues, 10 conversations
Venons-en à la troisième question, là où se loge l'écart intéressant.
Le mode multilingue d'alternance codique de Deepgram s'active avec un seul paramètre, language=multi, et il permet à une même requête de traiter des locuteurs qui changent de langue à l'intérieur d'une phrase. Il est réellement utile, et il est disponible sur Nova-2, Nova-3 et Flux Multilingual. Il est aussi bien plus étroit que le catalogue monolingue.
Sur Nova-3, language=multi couvre exactement dix langues : anglais, espagnol, français, allemand, hindi, russe, portugais, japonais, italien et néerlandais. Sur Nova-2, le même paramètre en couvre deux — l'espagnol et l'anglais.
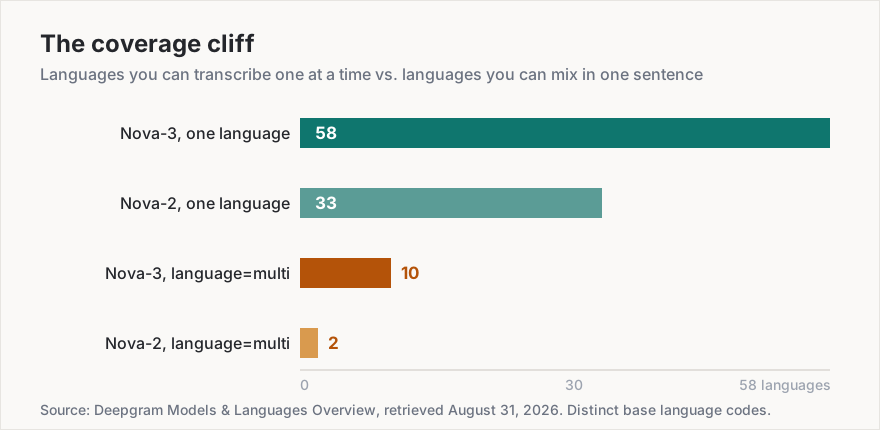
Graphique : Telli.sh, d'après le Models & Languages Overview de Deepgram, consulté le 31 août 2026. Les décomptes portent sur les codes de langue de base distincts, hors variantes régionales et variantes d'écriture.
Appelons cela la falaise de couverture : la chute entre la langue qu'un éditeur affiche dans sa liste et la langue dans laquelle votre réunion réelle, désordonnée, à moitié anglophone, est effectivement traitée. Cinquante-huit langues se tiennent en haut de cette falaise. Dix survivent à la chute.
Pour les 48 langues du mauvais côté — pendjabi, népalais, arménien, tamoul, bengali, thaï, coréen, vietnamien, malais et les autres — le modèle monolingue dédié n'est pas simplement le meilleur choix. C'est le seul. Il n'existe aucune voie d'alternance codique à laquelle le comparer.
Voici le point essentiel, et il va à l'encontre de l'intuition selon laquelle un mode multilingue serait forcément plus capable : pour la plupart des langues du monde, le modèle monolingue est l'option avancée, pas la solution de repli. Un modèle dédié est entraîné sur la phonétique d'une langue, sur la distribution lexicale d'une langue, sur les nombres et les dates d'une langue. Le modèle multilingue doit en maintenir dix en tension et décider, mot après mot, laquelle il est en train d'entendre. Quand vous savez que la réunion se tient en tamoul, le dire au moteur n'est pas une limitation que vous acceptez — c'est la configuration la plus précise dont vous disposez.
language=multi (alternance codique) | Modèle de langue dédié | |
|---|---|---|
| Couverture linguistique Nova-3 | 10 langues | 58 langues |
| Couverture linguistique Nova-2 | 2 langues (espagnol + anglais) | 33 langues |
| Gère les changements en milieu de phrase | Oui | Non — les passages hors langue dégradent le résultat |
| Précision sur une langue unique connue | Plus faible ; le modèle arbitre entre les candidates | Plus élevée ; le modèle est spécialisé |
| Keyterm prompting | Oui sur Nova-3 Multi, jusqu'à 500 jetons (environ 100 mots), depuis le 10 décembre 2025 | Oui |
| Réglage de streaming recommandé | endpointing=100 selon le guide de Deepgram | Endpointing par défaut |
| Disponible pour le pendjabi, le népalais, l'arménien, le tamoul | Non | Oui |
La lecture pratique de ce tableau : si votre réunion alterne vraiment phrase par phrase entre l'anglais et l'espagnol, utilisez multi et acceptez la perte de précision. Si votre réunion se tient en tamoul avec quelques emprunts anglais — ce que sont en réalité la plupart des réunions dites « multilingues » —, réglez language=ta et laissez le modèle dédié faire son travail.
Qui obtient réellement de meilleures réunions ce mois-ci
Assez d'architecture. Six langues ont changé de statut en août 2026, et derrière chaque code se trouve une population dont les réunions étaient jusqu'ici mal transcrites, ou pas du tout.
| Langue | Code | Locuteurs | Ce qui a changé en août 2026 |
|---|---|---|---|
| Pendjabi | pa, pa-IN | env. 125 millions | Nouveau sur Nova-3, lots et streaming (4 août) |
| Népalais | ne | env. 16 millions | Nouveau sur Nova-3, lots et streaming (4 août) |
| Arménien | hy | env. 6,7 millions | Nouveau sur Nova-3, lots et streaming (7 août) |
| Tamoul | ta | env. 75 millions de locuteurs natifs | Modèle amélioré, lots et streaming (7 août) |
| Indonésien | id | env. 199 millions, seconde langue incluse | Modèle par lots amélioré uniquement (7 août) |
| Biélorusse | be | env. 7,6 millions | Modèle de streaming amélioré uniquement (7 août) |
Chiffres de locuteurs : décomptes Ethnologue tels qu'agrégés sur Wikidata (propriété P1098), consultés le 31 août 2026. Arrondis.
Cela représente environ 430 millions de personnes dont la langue a bénéficié d'une reconnaissance vocale mesurablement meilleure en une seule semaine, et près de 148 millions d'entre elles — les locuteurs de pendjabi, de népalais et d'arménien — sont passées de l'absence totale d'option Nova-3 de premier rang à une option disponible en lots comme en streaming.
Voyez ce que cela veut dire dans une salle. Le point quotidien d'une équipe d'ingénierie de Chandigarh, jusqu'ici tenu dans une seconde langue pour arranger l'outillage ou laissé sans transcription, produit désormais un compte rendu en temps réel. Le débriefing de terrain d'une ONG de Katmandou devient un document consultable plutôt que les notes manuscrites de quelqu'un. Une déposition juridique en arménien peut être transcrite en direct au lieu d'être envoyée à une transcription manuelle facturée à la minute.
Il existe un effet de second ordre plus important que la transcription elle-même. Dès qu'une langue devient lisible par la machine en temps réel, tout l'aval se débloque d'un coup : traduction en direct pour les participants distants, résumés automatiques, actions extraites, recherche sur une année de réunions. La reconnaissance vocale est l'étape goulot. Chaque langue qui la franchit hérite de toute la chaîne construite pour l'anglais.
Si dans votre équipe quelqu'un bascule habituellement vers l'anglais parce que « l'outil ne gère pas notre langue », c'est la mise à jour qui met fin à ce compromis-là.
Comment choisir le réglage de langue pour une réunion multilingue
Les progrès du moteur ne servent que si la session est correctement configurée, et les valeurs par défaut sont souvent inadaptées aux équipes multilingues. Cinq étapes, dans l'ordre :
- Déterminez si la réunion a une langue dominante ou si elle mélange vraiment. Quelques emprunts anglais dans une réunion en tamoul, cela reste une langue. Alterner des phrases entières entre l'espagnol et l'anglais, cela fait deux. Seul le second cas exige l'alternance codique.
- S'il s'agit d'une seule langue, indiquez-la explicitement. Utilisez
model=nova-3avec le code précis —language=papour le pendjabi,language=nepour le népalais,language=hypour l'arménien. Ne laissez pas la détection automatique décider : vous connaissez la réponse, et la donner au modèle ne coûte rien. - Si le mélange est réel, confrontez les langues à la liste des dix. Ne réglez
language=multique si chaque langue présente dans la salle figure parmi l'anglais, l'espagnol, le français, l'allemand, le hindi, le russe, le portugais, le japonais, l'italien et le néerlandais. S'il en manque une,multine vous aidera pas, et le modèle de la langue dominante reste votre meilleure option disponible. - Pour les sessions en direct utilisant
multi, réglezendpointing=100. Le guide d'alternance codique de Deepgram recommande 100 ms spécifiquement pour ce cas, contre une valeur par défaut plus élevée. Un endpointing plus long laisse une phrase passée dans l'autre langue se faire absorber dans le mauvais segment. - Vérifiez les lots et le streaming séparément avant de promettre quoi que ce soit. Comme l'a montré le 7 août, une amélioration de l'un n'est pas une amélioration de l'autre. Faites passer le même échantillon de 10 minutes par les deux voies et comparez, plutôt que de supposer qu'une entrée de changelog s'applique à la vôtre.
Nous avions couvert un autre pan du sujet en juin — la mise à jour de mi-année de Deepgram sur les sessions en direct adaptatives et la diarisation, y compris la commande UpdateListen qui permet à une session en cours de modifier ses indications de langue sans se reconnecter. L'étape 2 ci-dessus et cette capacité se combinent bien : fixez la langue explicitement au démarrage, et ajustez-la en cours de réunion si la salle bascule vraiment.
L'essentiel : la couverture a cessé d'être un nombre pour devenir une matrice
Le réflexe, quand on compare des moteurs de reconnaissance vocale, est de chercher le plus gros chiffre. Le tokenizer de Whisper, chez OpenAI, déclare 100 jetons de langue depuis 2022 — presque le double des 58 de Nova-3 — et cette comparaison ne vous apprend presque rien, car Whisper n'a pas de voie de streaming native et un jeton déclaré n'est pas un modèle de production validé. Nova-3 liste moins de langues et les livre, langue par langue, mode par mode, avec des preuves datées.
Le nombre qui décrit la couverture réelle d'un moteur n'est pas un décompte. C'est une matrice : langue × mode × niveau de qualité. Cinquante-huit langues, une à la fois. Dix d'entre elles mélangeables. Une langue améliorée en lots et pas en streaming, une autre en streaming et pas en lots, dans la même version, le même jour.
La question à poser lors de votre prochaine évaluation d'éditeur n'est donc pas « combien de langues prenez-vous en charge ». C'est : pour ma langue, sur ma voie, à quelle date ?
Ce que Telli.sh apporte : tout ce qui précède relève de la couche moteur, et nous pensons que la plupart des équipes ne devraient pas avoir à en connaître un mot. Telli.sh se place au-dessus de cette couche et prend les décisions de la liste numérotée ci-dessus à votre place — en choisissant le modèle dédié quand la réunion se tient dans une seule langue, en maintenant les envois de fichiers et les sessions en direct sur leurs voies respectives, et en héritant des améliorations du moteur comme celles d'août dès la semaine de leur sortie plutôt qu'à votre prochaine migration. Par-dessus la transcription, nous ajoutons la traduction en direct vers 44 langues cibles et une interface en 15 langues, si bien que la personne qui rejoint votre point quotidien en pendjabi depuis Varsovie le lit en polonais pendant qu'il se déroule.
Démarrer une note de réunion traduite en direct
Sources
- Deepgram changelog, August 4, 2026 — Nova-3 Model Update — pendjabi (
pa,pa-IN) et népalais (ne), lots et streaming tous deux disponibles - Deepgram changelog, August 7, 2026 — Nova-3 Adds Armenian, Plus Improved Models for Tamil, Indonesian, and Belarusian — arménien (
hy) nouveau ; modèles par lots améliorés pour le tamoul et l'indonésien ; modèles de streaming améliorés pour le tamoul et le biélorusse - Deepgram Models & Languages Overview — tableaux complets des langues Nova-3 et Nova-2 et liste des langues
multi, consulté le 31 août 2026 - Deepgram Multilingual Codeswitching guide — usage de
language=multiet recommandationendpointing=100, consulté le 31 août 2026 - Deepgram Self-Hosted release 251210, December 10, 2025 — « Nova-3 now supports 31 total languages » ; keyterm prompting multilingue jusqu'à 500 jetons
- Deepgram Self-Hosted release 251118, November 18, 2025 — 11 nouvelles langues, plus le modèle de détection à 36 langues
- Deepgram Self-Hosted release 260129, January 29, 2026 — 12 nouvelles langues Nova-3 dont le biélorusse, le bengali, le bosnien et le croate
- Deepgram Self-Hosted release 260319, March 19, 2026 — thaï et cantonais
- Deepgram Self-Hosted release 260430, April 30, 2026 — gujarati
- Deepgram Self-Hosted release 260812, August 12, 2026 — le paquet auto-hébergé du népalais et du pendjabi, huit jours après l'entrée cloud
- OpenAI Whisper tokenizer language table — 100 jetons de langue déclarés, consulté le 31 août 2026
- Wikidata property P1098 (number of speakers) — décomptes de locuteurs issus d'Ethnologue pour
pa,ne,hy,ta,id,be, consultés le 31 août 2026 - Notre couverture de juin 2026 des mises à jour de Deepgram sur les sessions en direct et la diarisation