Mac 上的离线语音 AI 能等你说完吗?
Sophon-Realtime 的 Apple 芯片版本在本机处理语音交互。用一次模拟面试分别检验内存、响应延迟、回声和打断。
想象你坐在餐桌边练习求职面试。刚解释到自己如何解决一个难题,你停了一下想找个合适的词,面试官以为你说完了,立刻插进来。过了一会儿,你想纠正它,它却盖过你的声音继续说。即使事后回放时,语音应用的每条答案都好听,这两种问题也可能在对话中出现。
2026 年 11 月 13 日,Adventists AI 宣布推出 Sophon-Realtime 的本地 Mac 版本。它在搭载 Apple 芯片的 Mac 上,将 Flash-4bit 语音模型与 Apple 的 MLX 运行环境结合。项目建议使用至少 36 GB 统一内存,列出的功能包括对话轮次切换和用户打断,并称 Mac 安装会下载约 24 GB 的模型文件。11 月 14 日另行发布的托管 API 不会在你的 Mac 上运行这套语音交互。
真正值得检验的是,整套交互断网后还能不能像一场对话那样进行。做一次简短的模拟面试就能试出端倪。下面会把等待首段语音的时间和系统何时开口的决定分开看,再检验模型给电脑里的其他工作剩下多少资源。
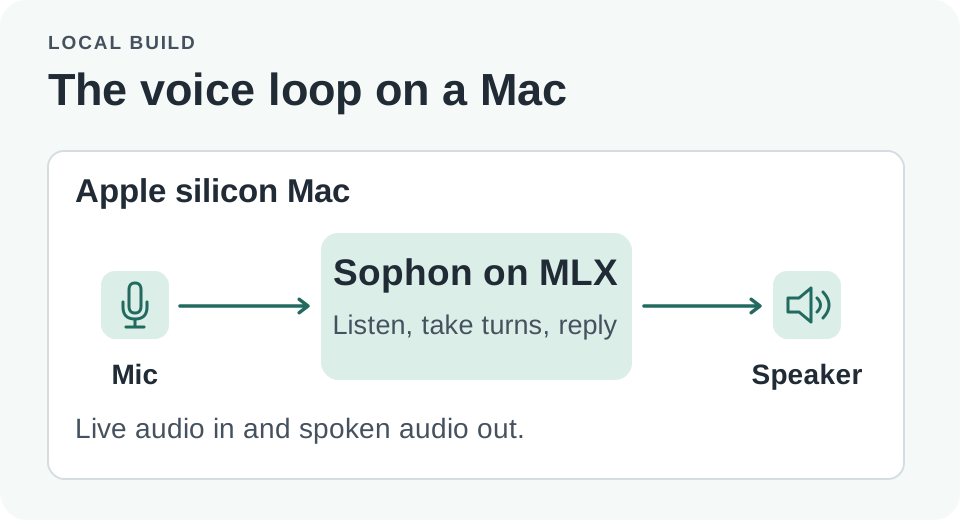
安装完成后,本地方案在设备上处理音频。托管 API 走的是服务端路径。
该怎样测量这一秒的响应时间?
项目的 Mac 模型卡报告,在配备 36 GB 内存的 M4 Max 上,如果模型有把握认为用户说完了,用户停声后约 0.9 至 1.1 秒可听到首段音频。需要更多时间判断时,项目记录的等待时间最长约为 2.5 秒。这些是该项目在特定配置下报告的结果。想复现前,先定义什么叫「停声」。录音上可以标记最后一个听得见的音节,系统则有自己判断发言结束的时刻。夹在两个时间点之间的,可能不过是人听起来很正常的一次停顿。
首段音频延迟涵盖从你说完到模型开始发出可听声音之间的过程。间隔有时用在模型运算,有时用在判断这一轮是否结束。即使模型很快,如果过早把安静当成回答完毕,每次停顿都可能被打断。反过来,一个表现得体的系统也许要多等一会儿,才能判断不明确的交接时刻。只看秒表,分辨不出哪次体验更好。
比如让系统问「你为什么选了缓存?」第一次简短回答,明确收尾,等应用回应。第二次说「我们选缓存是因为……」,稍停一下再接着说。第三次开着风扇,用同样的话再答一遍。应用在第一次测试里可能同样快,却在后两次表现很差。先确认它在合适的时候开口,再比较用了多少时间。
| 对话事件 | 应记录的观察 | 为什么重要 |
|---|---|---|
| 明确答完一个问题 | 最后一个音节到首段可听回应的时间 | 看说完后会不会等得太久 |
| 说到一半停顿 | 助手继续等待,还是已经开口? | 看系统是否把短暂安静当成让它接话 |
| 播放时提出纠正 | 多久停下、是否理解了修正 | 看使用者能否重新取得发言权 |
| 麦克风拾取了扬声器的声音 | 有没有自触发的回应或重复文本 | 看回声在实际房间里的表现 |
用自己的声音在家就能记录这些信息。报数字时要一并注明条件。扬声器和耳机产生的回声路径不同。开风扇是贴近实际使用的压力试验,条件达不到标准化语音基准的要求。家庭环境里的非受控试验也不适合用于比较服务器延迟。
测试打断要看两件事
Sophon 把 Mac 方案描述为全双工,并列出插话打断和回声消除功能。在交互应用里,打断要有用,既要停止正在播放的语音,也要保留新说的信息。如果听到「抱歉,我说的是周二」马上安静下来,后面却还围绕周四推理,系统只解决了其中一半。
模拟面试时,让应用提出一个较长的追问,然后说「等一下,我在讲数据库迁移,和客户发布活动无关。」记录它是否停下、是否确认听到了修正,以及下一道实际提出的问题是否采用了修正。分别用有意义的纠正和咳嗽之类的短声尝试打断,这两种信号不必按同一种事件处理。只看第一次就觉得表现不错,可能会忽略产品在真实房间里停止播放得过于频繁。
回声和插话打断需要分开测试。戴耳机测一次,再把扬声器调到舒适的音量测一次。如果助手的一声确认就能自行触发新一轮录音,调整麦克风位置或换用不同的回声消除实现,可能比缩小模型更管用。别在同一轮试验里同时换硬件、模型和音频设置,否则很难说下一次为什么变好或变坏。
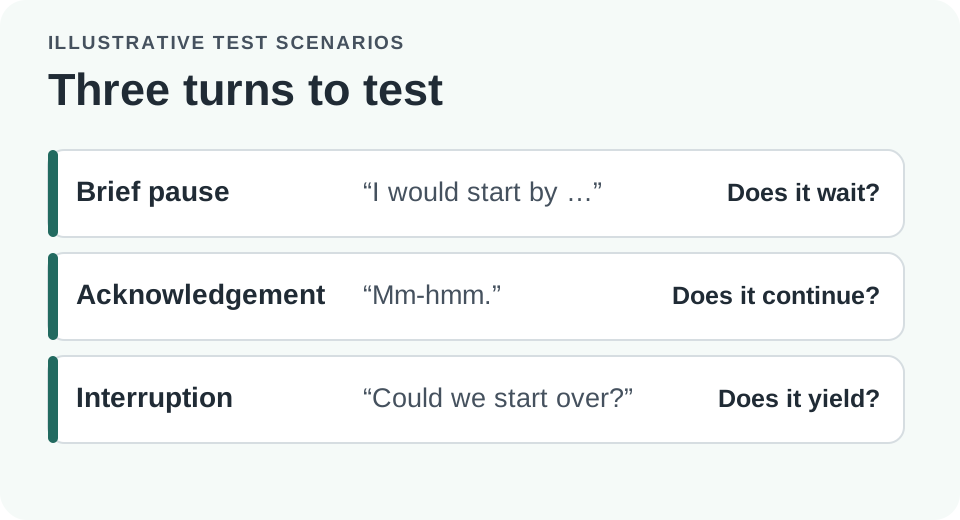
分别测试短暂停顿和有意纠正。二者都可能伴随安静片刻,应用的处理方式应该不同。
在 Mac 上运行,内存也是实际体验的一部分
Mac 安装指南介绍了在 Apple 芯片上使用 MLX 的方法,并建议至少 36 GB 统一内存。约 24 GB 的下载量指存储占用,模型活跃时的内存不一定恰好是 24 GB。实际会话中,模型、缓存、音频处理和其他应用都使用同一设备的资源。
第一次可以先关掉占内存的应用,用一段很短的问答来测。打开「活动监视器」,观察内存压力,以及交换空间用量会不会在运行中上升。然后打开平时会和助手并用的软件,再测一次。就算模型能加载,越来越大的内存压力或播放卡顿也可能让它不适合常用。要找的是用起来舒服的配置,刚好能把程序跑起来的最低配置并不等于官方建议。
项目在 11 月 16 日另行发布了面向消费级 GPU 的 4B 变体。发布说明把这些 GPU 运行方案和 Mac 上的 32B Flash-4bit MLX 版本分开介绍。另一个后端的显存要求较低,不会改变 Mac 的推荐配置。托管 API、服务器 GPU 和本地 MLX 的数据也可能基于不同模型和流量条件。先选定自己打算用的方案,再解读仓库里的数字。
语言支持也直接影响语音流程。仓库把韩语标为计划支持。首次试验可以选英语等有文档确认的语言,无须假设支持多语言的模型在每种语言的声音、识别和轮次控制上都一样好。如果你需要练习韩语面试,当前版本有助于学会怎样检验对话质量,韩语支持仍应在可用后单独验证。
下载完成后,再断网验证
按 Mac 指南做准备时,需要联网获取项目依赖和模型权重。使用项目记录的步骤,安装前审阅脚本,并了解本地文件存到哪里。麦克风权限和模型安装也是两件事。用自己能控制的音频起步,录制他人声音前应取得同意。
- 按 Mac 安装指南配置,条件允许时固定项目修订版本。等文档列出的下载全部完成,联网时先试一次受支持语言的对话。
- 安装完成后断网。开启一场新的本地会话,确认新说的问题会得到新回答,而非播放缓存示例。
- 在相同麦克风和扬声器设置下,做几次完整回答、中途停顿和出声纠正。记录设备型号、内存、错误和观察到的用时。
- 打开平时用的软件,选一小段再试。如果延迟升高或音频质量变差,先看内存压力和试验条件有哪些变化,再下结论。
11 月 14 日的托管 API 公告让开发者无须先安装本地模型就能试用项目。这适合做交互对照或开发集成。应用在这种用法下会把音频发给服务端,服务有自己的隐私和网络条件。从托管服务换到 Mac 命令行版本,变化的远不只同一个脚本能不能启动。
离线使用有助于减少发出设备的数据。演练敏感话题,或制作一个网络不好时仍要工作的原型,这一点尤其重要。文件仍可能写入本地磁盘,所以应检查所用客户端如何处理录音、转录和日志。断网试验能证明这段对话可以脱离网络运行,不能由此验证未来应用的所有隐私属性。
语音表单原型是另一个用例。假设用户要回答四道题,进入下一题之前可以纠正上一条。除了语音模型最新的理解,应用还应保存用户已经确认的答案。用户在播放中提出修正时,应先理解修正,再更新相应字段。免手操作的语音流程能让填写更轻松,至于哪个草稿答案何时写入正式记录,仍由应用负责。
比较两个构建版本前,先写下通过条件。例如,试验应在预设的停顿期间等待,收到明确纠正后停止播放,下一道问题应围绕纠正后的内容提出。另记完成次数,等到有足够多次可比较的重复时,再用中位数和范围描述用时。重试也要记录,别只挑最顺的一次。家庭小规模测试里,单次失败常常比一个平均数更能说明问题。
比较离线和在线方案时,尽量让两者做同一件事。对内存不足以在本地跑语音的原型,托管服务是一个可用的对照。如果语音、轮次配置、模型和设备访问方式不一样,应注明差异。某种方案的延迟更低,不能单凭这一点判断用户犹豫或断网时哪一种表现更好。结果用来指导你正在制作的应用,无须排出一个榜单。
还应给原型设计一条明确的恢复路径。比如用户打断正在说话的助手,接着什么也没说。一个简短的视觉提示或本地状态指示器,可以告诉用户系统正在听,而不是卡住了。音频设备被拔掉,或者模型因内存压力退出时,确认应用回到明确的空闲状态,再开始下一次会话。恢复时间与响应延迟应分开测。否则,正常问答中看起来很快的系统,一旦遇上真实对话里的意外,照样会让人难用。
好用的本地面试助手会给人留出说话的空间
最能暴露问题的测试也许不到一分钟。开始答题,停顿一下,把话说完,等助手开口,再趁它还在说时改一个细节。每一步都按你的预期进行时,语音才更像一种真正好用的交互方式,而不只是一连串音频文件。只要内存充足,Mac 版就提供了一种在本地做这个测试的办法。实际效果仍取决于机型、语言、房间和软件。
资料来源
把面试题、练习记录和本地试验的观察结果放在一起。用 Telli.sh 创建第一条笔记。