Uma IA de voz offline no Mac consegue esperar a vez?
A versão Apple Silicon do Sophon-Realtime processa a conversa no próprio Mac. Simule uma entrevista para distinguir memória, latência, eco e interrupções.
Imagine treinar para uma entrevista de emprego na mesa da cozinha. Você começa a explicar como resolveu um problema, faz uma pausa para encontrar a palavra certa e o entrevistador entra como se você tivesse acabado. Pouco depois, você tenta corrigir o entrevistador e ele continua falando por cima de você. Os dois problemas podem acontecer até em um app de voz cujas respostas soam excelentes quando você escuta depois.
Em 13 de novembro de 2026, a Adventists AI anunciou uma versão local do Sophon-Realtime para Mac. Ela combina o modelo de voz Flash-4bit com o ambiente de execução MLX da Apple em máquinas Apple Silicon. O projeto recomenda pelo menos 36 GB de memória unificada, lista a alternância entre falantes e a possibilidade de interromper entre os recursos e informa que a instalação para Mac baixa cerca de 24 GB de arquivos do modelo. A API hospedada anunciada separadamente em 14 de novembro leva o processamento da conversa ao serviço remoto.
A pergunta interessante é como a troca inteira funciona: sem rede, a interação se comporta como uma conversa? Uma entrevista simulada curta ajuda a descobrir. Vamos separar a espera até a primeira resposta falada da decisão de quando falar. Depois vamos ver quanta margem sobra para outras tarefas no computador.
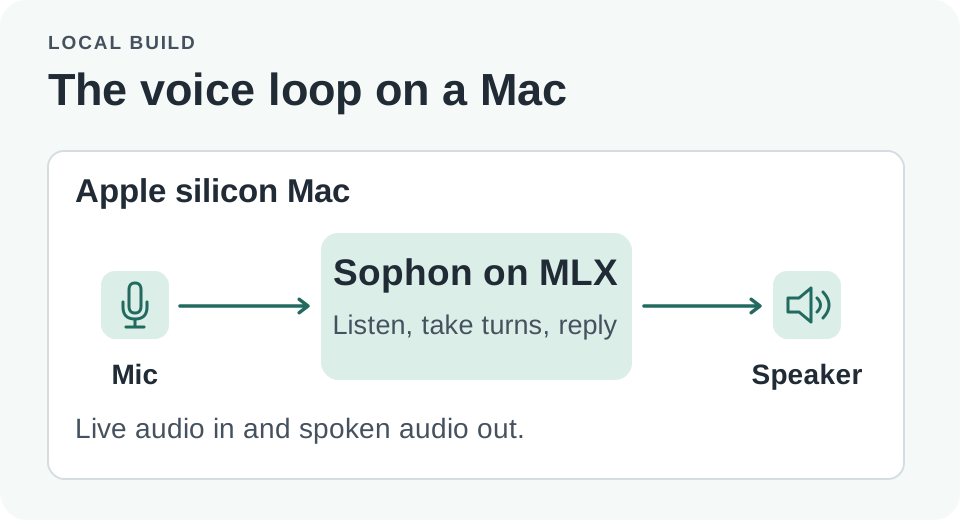
Depois da instalação, o fluxo local processa o áudio no dispositivo. A API hospedada usa o serviço remoto.
Como medir a estimativa de um segundo?
Para um M4 Max com 36 GB, a ficha do modelo para Mac informa de 0,9 a 1,1 segundo até o primeiro áudio depois que a pessoa para de falar, quando o modelo está confiante de que o turno terminou. Se ele precisa de mais tempo para decidir, a espera informada chega a cerca de 2,5 segundos. São os resultados do projeto para aquela configuração. Antes de reproduzir o teste, defina quando a fala termina. Em uma gravação, você pode marcar a última sílaba audível. O sistema decide por conta própria quando acaba o turno de entrada. Uma pausa que soa perfeitamente normal para uma pessoa pode separar esses dois momentos.
O atraso até o primeiro áudio abrange tudo o que acontece entre o fim da sua fala e o começo da saída audível do modelo. Parte do intervalo pode ser de processamento do modelo, e parte, de espera pela decisão de que o turno terminou. Até um modelo rápido pode interromper você em todas as pausas se interpretar cedo demais o silêncio como fim da resposta. Um sistema bem ajustado pode esperar um pouco mais para resolver uma transição incerta. O cronômetro sozinho não diz qual conversa funcionou melhor.
Considere a pergunta “por que vocês escolheram usar cache?”. Responda em poucas palavras, termine de forma clara e deixe o app falar. Na segunda tentativa, diga “escolhemos usar cache porque…” e faça uma pausa antes de continuar. Na terceira, dê a mesma resposta com um ventilador ligado perto de você. Um app pode manter o mesmo tempo até o primeiro áudio no primeiro teste e falhar nos outros dois. Compare os tempos depois de conferir que ele começou a falar no momento certo.
| Evento na conversa | O que registrar | Por que importa |
|---|---|---|
| Uma resposta claramente concluída | Tempo da última sílaba à primeira resposta audível | Indica se a espera depois de um turno completo parece longa |
| Uma pausa no meio da frase | O assistente esperou ou começou a responder? | Mostra se o silêncio é interpretado como permissão para falar |
| Uma correção durante a reprodução | Quanto tempo leva para calar e se entende a correção | Testa se a pessoa consegue retomar a fala |
| Reprodução captada pelo microfone | Respostas acionadas pelo próprio áudio ou texto repetido | Mostra como o eco se comporta naquele espaço |
Você pode coletar essas medidas em casa com a sua voz. Registre as condições ao lado dos números. Alto-falantes e fones criam caminhos diferentes para o eco. O ventilador serve como um teste prático sob ruído. Um benchmark padronizado de fala ou uma comparação com latência de servidor exige condições controladas.
O teste de interrupção tem duas partes
O projeto descreve a versão para Mac como full duplex e informa que ela aceita interrupções durante a resposta e cancela o eco. Em um app interativo, a interrupção funciona quando a saída para e a informação nova é incorporada. Um sistema que fica quieto logo depois de “desculpe, eu quis dizer terça-feira” e continua raciocinando sobre quinta-feira resolveu só a primeira metade do problema.
Na entrevista simulada, peça uma pergunta longa de acompanhamento e depois diga “espere, estou falando da migração do banco de dados, deixe de lado o lançamento para o cliente”. Veja se a resposta para, se o app reconhece a correção e se a pergunta seguinte leva a informação corrigida em conta. Tente interromper com uma correção que muda o sentido e com um som breve, como uma tosse. O app deveria conseguir tratar esses eventos de maneira diferente. Passar no primeiro teste pode esconder a facilidade com que ele corta o áudio em um ambiente real.
Eco e interrupção são testes separados. Faça os dois com fones e com os alto-falantes a um volume confortável. Se uma confirmação do assistente acionar sozinha uma nova gravação, mudar a posição do microfone ou o modo de cancelar o eco pode importar mais do que usar um modelo menor. Mude uma variável por vez entre hardware, modelo e configurações de áudio. Assim dá para saber por que o teste seguinte melhorou ou piorou.
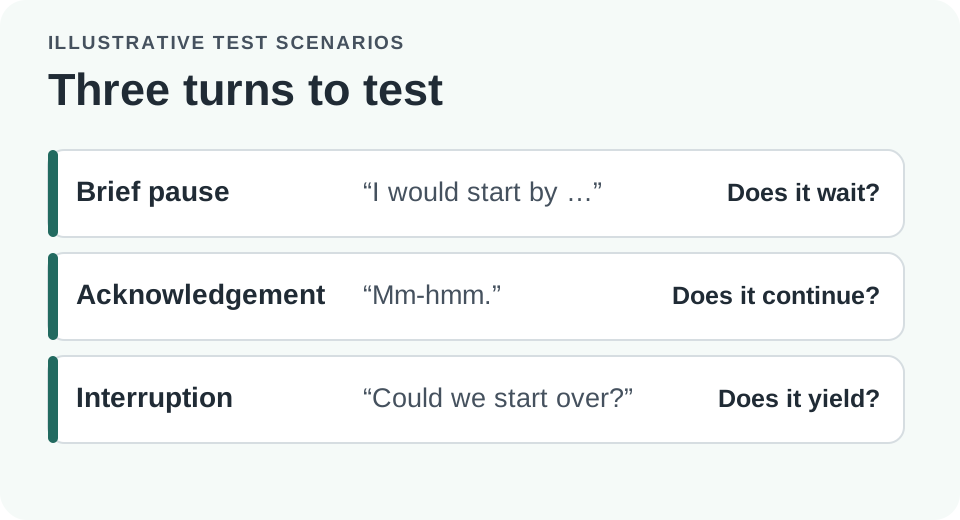
Teste separadamente uma pausa e uma correção intencional. As duas podem envolver silêncio, mas o app deve reagir de formas diferentes.
No Mac, a memória faz parte da experiência
O guia de instalação para Mac descreve a configuração com Apple Silicon e MLX e recomenda 36 GB ou mais de memória unificada. Os cerca de 24 GB de download indicam espaço de armazenamento. A memória ocupada durante a execução precisa ser medida à parte. O modelo, o cache, o processamento de áudio e os outros apps compartilham os recursos.
Um bom teste inicial fecha os apps que usam muita memória e segue um roteiro curto. No Monitor de Atividade, acompanhe a pressão da memória e veja se o uso de swap cresce. Depois abra os programas que você normalmente usaria ao lado do assistente e repita. Mesmo que o modelo carregue, uma pressão de memória crescente ou falhas na reprodução podem tornar o uso regular ruim. Procure uma configuração confortável. Conseguir abrir o programa é só a primeira verificação.
Em 16 de novembro, o projeto anunciou variantes separadas de 4 bilhões de parâmetros para GPUs de consumo. As notas de versão distinguem essas opções da versão 32B Flash-4bit MLX para Mac. Um requisito menor de VRAM em outro ambiente de execução mantém válida a recomendação para o Mac. A API hospedada, as GPUs de servidor e o MLX local também envolvem modelos e condições de carga diferentes. Escolha o ambiente que realmente pretende usar antes de interpretar os números do repositório.
A cobertura oficial de idiomas faz diferença em um fluxo de voz. O repositório lista o coreano como planejado. Use um idioma com suporte documentado, como o inglês, no primeiro teste. Para outros idiomas, verifique à parte a voz, o reconhecimento e a passagem de um falante para outro. Para quem precisa de entrevistas em coreano, a versão atual ajuda a planejar o teste da interação. A validação do coreano depende do suporte correspondente.
Confira o uso offline depois do download
A preparação exige rede para baixar dependências e pesos do modelo, como descreve o guia para Mac. Siga as instruções do projeto, revise os scripts antes de instalar e confira onde os arquivos locais ficarão. As permissões de microfone são independentes da instalação do modelo. Comece com áudio sob seu controle e peça consentimento antes de gravar outras pessoas.
- Siga o guia para Mac, fixando uma revisão específica do projeto quando for possível. Deixe os downloads terminarem e, com a rede conectada, teste uma troca em um idioma com suporte.
- Desconecte a rede depois de concluir a preparação. Abra uma sessão local nova e confirme que novas perguntas faladas recebem respostas novas, distintas das amostras em cache.
- Faça várias respostas completas, pausas no meio da frase e correções com as mesmas condições de microfone e alto-falante. Anote o dispositivo, a memória, os erros e os tempos observados.
- Repita um trecho curto com os apps do seu dia a dia abertos. Se a latência ou o áudio piorarem, confira a pressão da memória e o que mudou nas condições antes de concluir.
O anúncio da API hospedada de 14 de novembro oferece a quem desenvolve uma forma de testar o projeto sem instalar um modelo local. Isso serve para comparar uma interação ou elaborar uma integração. Nesse caminho, o app envia áudio a um serviço com condições próprias de privacidade e conexão. A troca entre o serviço hospedado e a linha de comando no Mac também muda o caminho dos dados e as dependências.
Usar o sistema offline pode reduzir a quantidade de dados que sai do dispositivo, o que ajuda a ensaiar uma história delicada ou criar um protótipo para conexões instáveis. O cliente ainda pode gravar dados em disco. Confira o que ele faz com gravações, transcrições e logs. Um teste desconectado demonstra que a conversa pode funcionar sem rede. Outras características de privacidade do futuro app exigem verificações próprias.
Um segundo uso é um protótipo de formulário por voz. Imagine que uma pessoa responde a quatro perguntas e pode corrigir a última resposta antes de avançar. O app deve guardar a resposta aceita separadamente da interpretação mais recente do modelo de voz. Se uma correção chegar durante a reprodução, ele só deve atualizar o campo certo depois de entendê-la. A conversa sem usar as mãos pode facilitar a interação. O aplicativo ainda decide quando uma resposta preliminar passa a fazer parte do registro.
Para comparar duas versões, escreva os critérios de aprovação antes de rodar qualquer uma. Por exemplo, o assistente precisa esperar a pausa planejada, parar de falar após uma correção real e fazer a próxima pergunta sobre o assunto corrigido. Registre à parte o número de testes concluídos. Se houver repetições comparáveis suficientes, use a mediana e a faixa de tempos. Registre novas tentativas e inclua as trocas com problemas. Em um teste doméstico pequeno, cada turno que deu errado costuma ensinar mais do que uma média.
Mantenha a comparação entre online e offline focada na mesma tarefa. Um serviço hospedado serve de referência para um protótipo em um dispositivo sem memória suficiente para executar o modelo de voz localmente. Informe diferenças na voz, na configuração de alternância, no modelo e no acesso ao dispositivo. Uma latência menor em uma configuração deixa em aberto qual funciona melhor se a pessoa hesitar ou precisar trabalhar sem internet. Use os resultados para orientar o aplicativo que você está construindo.
Também vale dar ao protótipo um caminho claro de recuperação. Imagine que a pessoa interrompe o assistente enquanto ele responde e depois não diz nada. Um sinal visual breve ou um indicador de estado local pode mostrar que o sistema está ouvindo. Se um dispositivo de áudio for desconectado ou se o modelo encerrar por pressão de memória, verifique se o app volta a um estado de espera conhecido antes de iniciar a próxima sessão. Meça a recuperação separadamente do atraso da resposta. Um sistema rápido nas trocas sem problemas ainda pode frustrar quando a conversa foge do roteiro.
Uma boa entrevista local dá espaço para quem fala
O teste mais revelador pode levar menos de um minuto. Comece a responder, faça uma pausa, termine, deixe o assistente iniciar a resposta e corrija um detalhe enquanto ele ainda fala. Se cada momento funcionar como esperado, a voz começa a servir de interface para uma conversa. A versão para Mac permite que quem tem memória suficiente faça esse teste localmente. O resultado ainda depende da máquina, do idioma, do ambiente e do software usados.
Fontes
- Projeto Sophon-Realtime e notas de versão de 13, 14 e 16 de novembro
- Guia oficial de instalação com Apple Silicon e MLX
Guarde juntas suas perguntas de entrevista, as anotações da prática e as observações dos testes locais. Crie sua primeira nota com o Telli.sh.