[Caderno de ideias de IA 01] SlideOn: um modelo de busca menor com dois controles úteis de custo
Conheça o SlideOn e o mSlideOn, da LightOn: modelos de recuperação esparsa para encontrar documentos em inglês e em vários idiomas, com um primeiro experimento prático e uma comparação clara de qualidade, velocidade e armazenamento.
Caderno de ideias de IA explora as ideias e as possibilidades práticas de modelos e ferramentas de IA que estão surgindo.
Você lembra que um documento explica como cancelar um pedido. A caixa de busca só lembra a palavra cancelamento. Infelizmente, o documento chama o mesmo processo de desistência. Uma coleção pode conter a resposta certa e, ainda assim, ser difícil de usar.
A LightOn apresentou o SlideOn e o mSlideOn em 19 de outubro de 2026 como dois modelos para recuperar documentos relevantes. O SlideOn se concentra no inglês; o mSlideOn amplia a abordagem para textos multilíngues, documentos longos e código. Seu atrativo particular são dois limites ajustáveis: quantas características uma consulta usa e quantas cada documento armazenado conserva. Anúncio da LightOn
Esta introdução explica onde os modelos se encaixam, o que esses controles alteram e como fazer uma pequena comparação antes de construir um serviço de busca. Você não precisa de um novo aplicativo de chat para entender a ideia. Comece com uma pergunta, alguns documentos e uma definição de resultado útil.
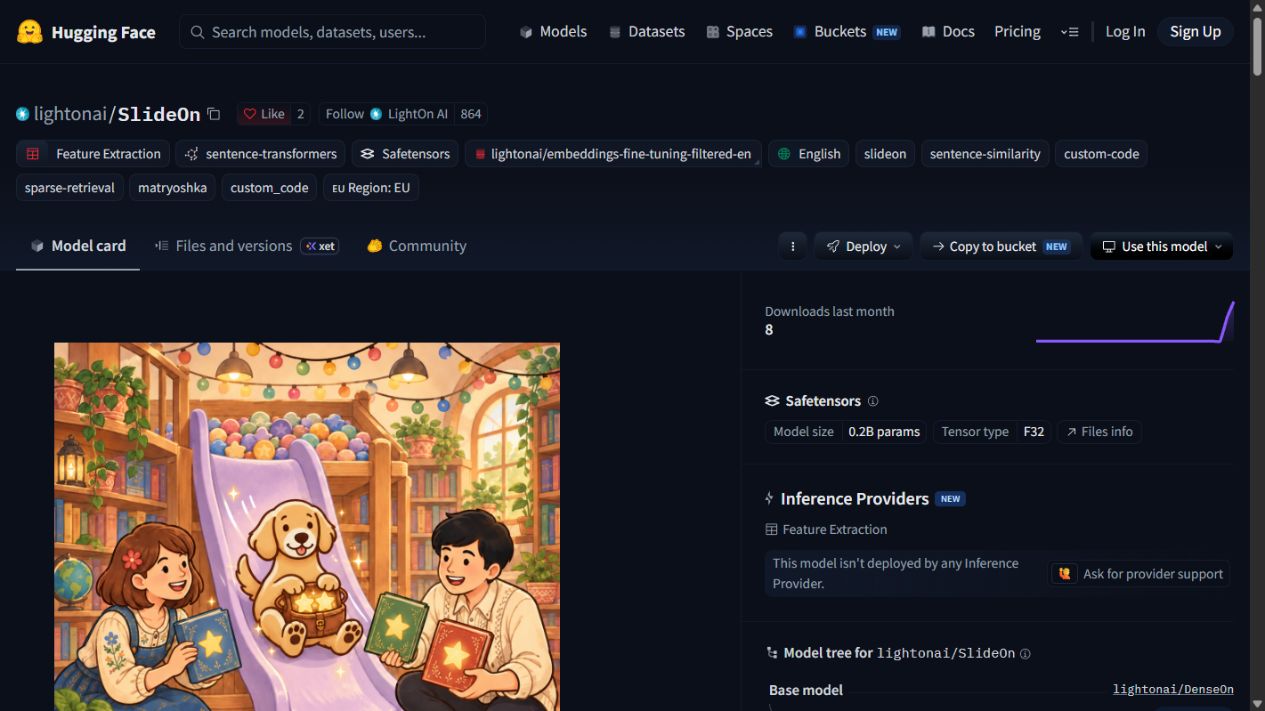 Tela pública da documentação do modelo capturada em 20 de outubro de 2026. Fonte: LightOn no Hugging Face. Esta é a página publicada do modelo, não um resultado de inferência local; a interface também mostra que um modelo disponível para download não precisa ter um provedor de inferência hospedada.
A busca precisa de uma boa seleção antes da resposta
Um recuperador ordena documentos conforme sua relevância para uma consulta. Ele não precisa escrever uma resposta, resumir os arquivos nem decidir se uma empresa deve mudar sua política. Sua tarefa imediata é mais específica: colocar as fontes mais relevantes perto do topo.
Pense em um manual interno com três páginas sobre devoluções, entregas e férias de funcionários. Uma pergunta sobre devolver um pedido danificado deve destacar a página de devoluções. Se o primeiro resultado tratar do calendário de férias, um gerador de respostas fluente já começará com a evidência errada.
Essa distinção torna a recuperação útil mesmo sem IA generativa. Um profissional de atendimento pode abrir diretamente o documento classificado. Um pesquisador pode reunir trechos para comparar. Uma ferramenta de programação pode localizar uma implementação provável antes da análise de uma pessoa.
Há também uma separação útil de responsabilidades. A recuperação ajuda a localizar evidências; o documento original continua sendo o lugar para conferir redação, datas e exceções. Um bom resultado facilita chegar à fonte, em vez de substituí-la por uma pontuação de confiança.
A busca esparsa mantém uma agenda seletiva
Imagine um índice de busca como uma agenda de endereços. Um índice convencional de palavras-chave registra quais documentos contêm determinado termo. Um modelo esparso aprendido cria outro tipo de agenda: atribui pesos a um conjunto relativamente pequeno de características aprendidas e usa as características ativas em comum para pontuar consultas e documentos.
A palavra esparso descreve essa seletividade. Uma representação pode ter muitas posições possíveis e usar apenas uma fração delas para determinado texto. Um índice invertido pode associar cada característica ativa aos documentos que a utilizam, ajudando o mecanismo de busca a se concentrar nas listas de ocorrências relevantes.
A documentação do SlideOn especifica 32,768 características aprendidas possíveis e controles independentes de poda para consultas e documentos. Essas posições são variáveis latentes aprendidas, não um dicionário transparente de palavras em inglês. Não interprete a característica 100 como um sinônimo garantido de “devoluções”. Documentação do SlideOn
Esse último detalhe importa ao explicar resultados. Representações esparsas podem tornar a busca econômica sem tornar toda decisão interna compreensível para humanos. A explicação prática para o usuário ainda deve ser um trecho relevante do documento original, com contexto suficiente para conferir a correspondência.
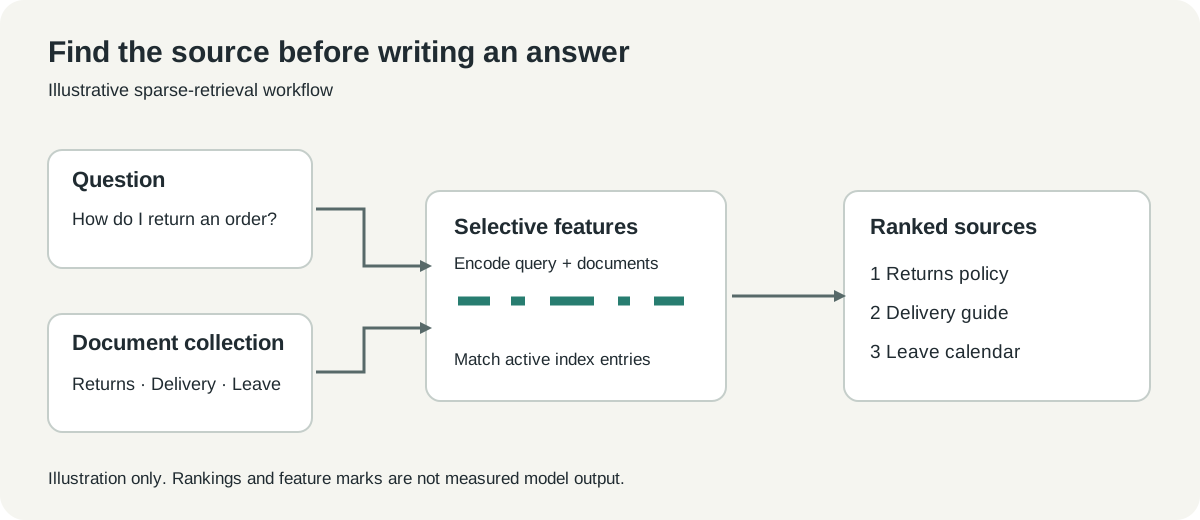 Diagrama explicativo original. As marcas de características ilustram o processo; não são ativações medidas do SlideOn.
Escolha o modelo para a coleção que você realmente tem
Os dois nomes indicam pontos de partida relacionados, não configurações de idioma intercambiáveis. No lançamento, a LightOn lista o SlideOn com 174 milhões de parâmetros e o mSlideOn com 339 milhões de parâmetros. O número maior, sozinho, não determina qual atenderá melhor à sua coleção. Lançamento de 19 de outubro
| Sua coleção | Primeiro candidato razoável | Pergunta a responder no teste |
|---|---|---|
| Artigos de ajuda em inglês | SlideOn | Recupera o artigo correto quando a consulta usa outras palavras? |
| Documentos em vários idiomas | mSlideOn | Cada idioma importante funciona isoladamente? As consultas entre idiomas atendem à necessidade? |
| Documentos técnicos longos | mSlideOn, com um plano deliberado de divisão em trechos | A seção relevante sobrevive ao pré-processamento e à classificação? |
| Código-fonte misturado com texto | mSlideOn como candidato | Os arquivos retornados ajudam alguém que conhece o repositório? |
O rótulo multilíngue é motivo para investigar, não um atalho para dispensar a avaliação. Um catálogo bilíngue pode conter cópias traduzidas, políticas regionais diferentes e termos sem equivalente literal único. São problemas de recuperação distintos, mesmo quando os documentos compartilham uma etiqueta de idioma.
Por exemplo, imagine procurar uma política de reembolso em francês com uma pergunta em inglês. Essa é uma tarefa entre idiomas. Procurar um documento francês com uma consulta em francês é uma tarefa no mesmo idioma. Registre-as separadamente: uma pontuação agregada pode esconder uma experiência fraca para um grupo de leitores.
A mesma lógica vale para código. Encontrar um arquivo sobre “recuperação de sessão” exige algo diferente de corresponder a um nome exato de função. Inclua consultas com identificadores exatos e perguntas descritivas na comparação, pois um sistema de busca útil costuma precisar das duas.
Seu primeiro experimento cabe em um notebook
Comece com texto público ou sintético e um ambiente Python limpo. O exemplo publicado usa o SparseEncoder do Sentence Transformers; ele é uma interface para carregar modelos, não um servidor de busca completo. O exemplo a seguir adapta a receita oficial, conferida em 20 de outubro de 2026. Uso documentado
- Abra a documentação do modelo e revise o código de inferência personalizado e as dependências do repositório. O carregador abaixo usa
trust_remote_code=True, que permite executar a implementação Python desse repositório; use uma revisão analisada para tornar o experimento repetível. - Crie um ambiente isolado e instale as versões de bibliotecas documentadas.
- Codifique uma consulta e alguns documentos curtos. Use os métodos de consulta e documento do modelo, em vez de acrescentar prefixos manualmente.
- Examine as pontuações ao lado dos textos reais. Esta primeira verificação trata da ordenação, não de um limiar universal de pontuação.
python -m venv .venv
# Activate .venv using the command for your shell.
python -m pip install "sentence-transformers>=6.1,<6.2" "transformers>=5.3,<6"
from sentence_transformers import SparseEncoder

model = SparseEncoder("lightonai/SlideOn", trust_remote_code=True)
documents = [
    "Customers may return a damaged order within the stated return period.",
    "Standard delivery takes three working days after dispatch.",
    "Staff should record annual leave in the shared calendar.",
]
queries = ["What should I do if my delivery arrives broken?"]

q = model.encode_query(queries, top_k=64)
d = model.encode_document(documents, top_k=512)
scores = model.similarity(q, d)
print(scores)
Os documentos acima são exemplos didáticos inventados. Não há saída alegada nem precisão medida associada a esse código. Verifique se o documento sobre devoluções fica em primeiro lugar; depois, teste paráfrases e alternativas propositalmente difíceis.
Não pare quando a consulta mais fácil funcionar. Pergunte sobre cancelar um pedido antes do despacho, uma encomenda danificada após a entrega e um reembolso depois do prazo indicado. Se a coleção não responder a uma pergunta, o teste deve revelar essa ausência, em vez de premiar um resultado atraente, mas irrelevante.
Dois limites respondem a duas perguntas de custo
A poda da consulta limita as características usadas ao fazer uma pergunta. A poda de documentos limita as características armazenadas para cada item indexado. Em um serviço grande, o primeiro limite afeta o trabalho repetido em cada busca; o segundo também afeta o índice que permanece entre buscas.
Um teste útil muda um limite de cada vez. Mantenha fixas as representações dos documentos ao ajustar a poda de consultas e repita com limites alternativos para os documentos. Se ambos mudarem simultaneamente, um resultado diferente pouco ajudará a identificar a causa.
Não existe uma configuração universal “pequena o bastante”. Um FAQ curto, um arquivo multilíngue e um repositório de software têm distribuições diferentes de idioma, extensão e repetição. Uma configuração que funciona para perguntas amplas pode perder o detalhe raro que distingue procedimentos quase idênticos.
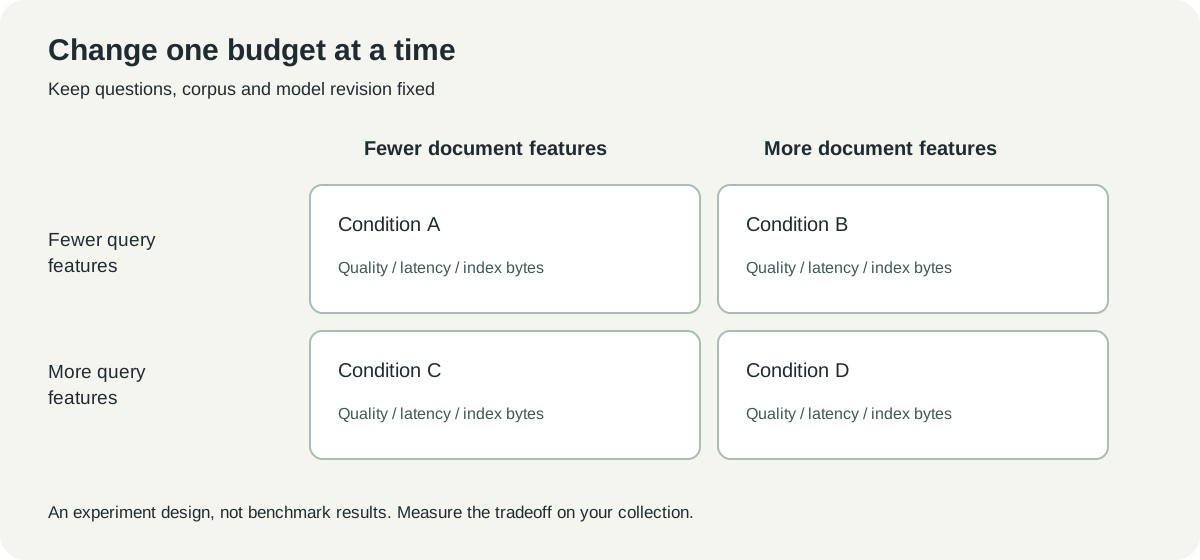 Plano de experimento original. São condições de comparação, não resultados de benchmark nem configurações recomendadas para produção.
Mantenha qualidade, tempo e armazenamento em colunas separadas. Se a busca acelerar enquanto o artigo relevante desaparecer da primeira página, a melhora de tempo tem um custo. Se um índice maior não trouxer benefício significativo para as perguntas reais, o armazenamento extra talvez não se justifique.
Um número de benchmark não mede o tempo de resposta
A documentação informa 56.68 nDCG@10 no BEIR-15 para a configuração sem poda do SlideOn. É um resultado atribuído de qualidade de classificação nos conjuntos do benchmark, não a probabilidade de determinada resposta estar correta. Também não é uma quantidade de milissegundos. Avaliação publicada
A discussão de eficiência da LightOn distingue um indicador aproximado de FLOPS de recuperação da latência medida, e a contagem de elementos não nulos dos documentos do tamanho do índice em bytes. Preserve essas distinções nas comparações. Um indicador matemático ajuda a explicar o mecanismo; uma medição operacional mostra o que seu sistema faz de fato.
Em uma avaliação pequena, um cronômetro também é insuficiente. Carregar o modelo, codificar documentos, construir o índice e repetir consultas são fases diferentes. Informe a inicialização a frio separadamente de uma busca com o sistema aquecido e esclareça se o tempo inclui a codificação da consulta.
A mesma atenção vale para as pontuações de qualidade. Um recuperador pode encontrar o documento correto e colocar o trecho errado no topo de um arquivo longo. Registre se a unidade avaliada é arquivo, seção ou passagem, e use a mesma unidade para todos os candidatos.
Três coleções práticas tornam visíveis as escolhas
Um manual de operações é um bom primeiro exemplo porque o resultado desejado costuma ser claro. Escreva perguntas sobre devoluções, atrasos de despacho e acesso à conta; identifique a página oficial para cada uma. Inclua perguntas com redação diferente dos títulos para testar mais do que correspondência de cabeçalhos.
Um arquivo multilíngue de projeto acrescenta outra dificuldade: o mesmo assunto pode aparecer em atas, um anúncio traduzido e um plano antigo. Use metadados para distinguir a política atual de discussões históricas. A similaridade semântica não decide qual versão uma organização deve seguir.
Uma coleção de documentação para desenvolvedores acrescenta sequências exatas e quase duplicatas. Uma pergunta sobre tempo limite pode exigir tanto um guia conceitual quanto uma chave de configuração. Mantenha a busca lexical como referência e verifique se uma abordagem híbrida justifica a complexidade nas suas perguntas reais.
Esses são cenários sugeridos de avaliação, não estudos de implementações em produção. Servem para tornar concretos os critérios de aceitação. Em cada caso, o artefato importante é uma lista de perguntas, fontes aceitas e classificações observadas que outra pessoa possa revisar.
Faça uma primeira comparação pequena o bastante para terminar
Use talvez 30 perguntas representativas, em vez de uma pilha ilimitada de consultas. Divida-as em consultas comuns, paráfrases, casos ambíguos e perguntas sem resposta na coleção. É uma proposta inicial, não um benchmark estatisticamente representativo.
Peça a um especialista para julgar os resultados esperados antes dos ajustes. Caso contrário, toda classificação surpreendente convida a reinterpretar o que a pergunta “realmente queria dizer”. Reserve perguntas intocadas para a verificação final, evitando que a configuração apenas memorize os exemplos de desenvolvimento.
Registre a revisão do modelo, as regras de pré-processamento, o tamanho dos trechos, a poda e a máquina. Alterar qualquer item pode mudar a comparação. Uma execução curta e repetível é mais útil do que uma pontuação grande cujas entradas desapareceram.
Por fim, examine a tela de resultados no tamanho em que será usada. Até um primeiro resultado correto falha quando o título fica irreconhecível por truncamento ou o resumo esconde a frase decisiva. A qualidade da recuperação encontra a qualidade da interface quando uma pessoa escolhe o que abrir.
Uma busca melhor encurta o caminho até a fonte
Na nossa visão, a ideia útil do SlideOn é separar qualidade e limites de recursos em controles testáveis. Esse é um ponto de partida mais prático do que presumir que todo problema de busca exige um modelo de respostas maior. Ele convida a um experimento modesto: preservar as perguntas, variar a representação e examinar o que as pessoas conseguem encontrar.
Comece pelo documento que sua equipe sempre tem dificuldade de localizar. Se o novo recuperador o destacar de forma confiável sob redações diferentes, você terá uma melhora concreta para desenvolver. O destino continua sendo uma fonte legível; o modelo encurta o caminho.
Fontes e mídia
Conferido em 20 de outubro de 2026. O exemplo de configuração adapta a documentação pública; não alegamos instalação, inferência local nem benchmark independente. Captura: página pública do modelo da LightOn no Hugging Face, registrada pelo autor. Os dois diagramas são originais. As fontes dos arquivos e os avisos de licença acompanham o registro de mídia.
- Lançamento da LightOn, 19 de outubro de 2026
- Documentação e uso do SlideOn
- Documentação e detalhes de idiomas do mSlideOn
- Repositório de treinamento e avaliação
Mantenha as perguntas ao lado das evidências
Guarde as consultas, os links das fontes e as notas de revisão juntos para que uma comparação futura responda às mesmas perguntas. O Telli.sh pode ajudar a organizar esse registro de pesquisa. Crie uma conta no Telli.sh