[KI-Ideen-Notizbuch 01] SlideOn: ein kleineres Suchmodell mit zwei nützlichen Kostenreglern
SlideOn und mSlideOn von LightOn: Sparse-Retrieval-Modelle für englische und mehrsprachige Dokumente, mit einem ersten praktischen Versuch und einem klaren Vergleich von Qualität, Tempo und Speicherbedarf.
Das KI-Ideen-Notizbuch erkundet die Ideen und praktischen Möglichkeiten hinter neu entstehenden KI-Modellen und Werkzeugen.
Sie erinnern sich an ein Dokument, das erklärt, wie man eine Bestellung storniert. Das Suchfeld kennt aber nur das Wort Stornierung. Im Dokument heißt derselbe Vorgang leider Widerruf. Eine Sammlung kann die richtige Antwort enthalten und trotzdem schwer zu nutzen sein.
LightOn stellte SlideOn und mSlideOn am 19. Oktober 2026 als zwei Modelle zum Auffinden relevanter Dokumente vor. SlideOn konzentriert sich auf Englisch; mSlideOn erweitert den Ansatz auf mehrsprachige Texte, lange Dokumente und Code. Besonders interessant sind zwei einstellbare Budgets: wie viele Merkmale eine Suchanfrage verwendet und wie viele Merkmale jedes gespeicherte Dokument behält. Ankündigung von LightOn
Diese Einführung erklärt, wo die Modelle einzuordnen sind, was diese Regler verändern und wie Sie einen kleinen Vergleich durchführen, bevor Sie einen Suchdienst aufbauen. Um die Idee zu verstehen, brauchen Sie keine neue Chat-Anwendung. Beginnen Sie mit einer Frage, einigen Dokumenten und einer Definition dafür, was ein brauchbares Ergebnis ist.
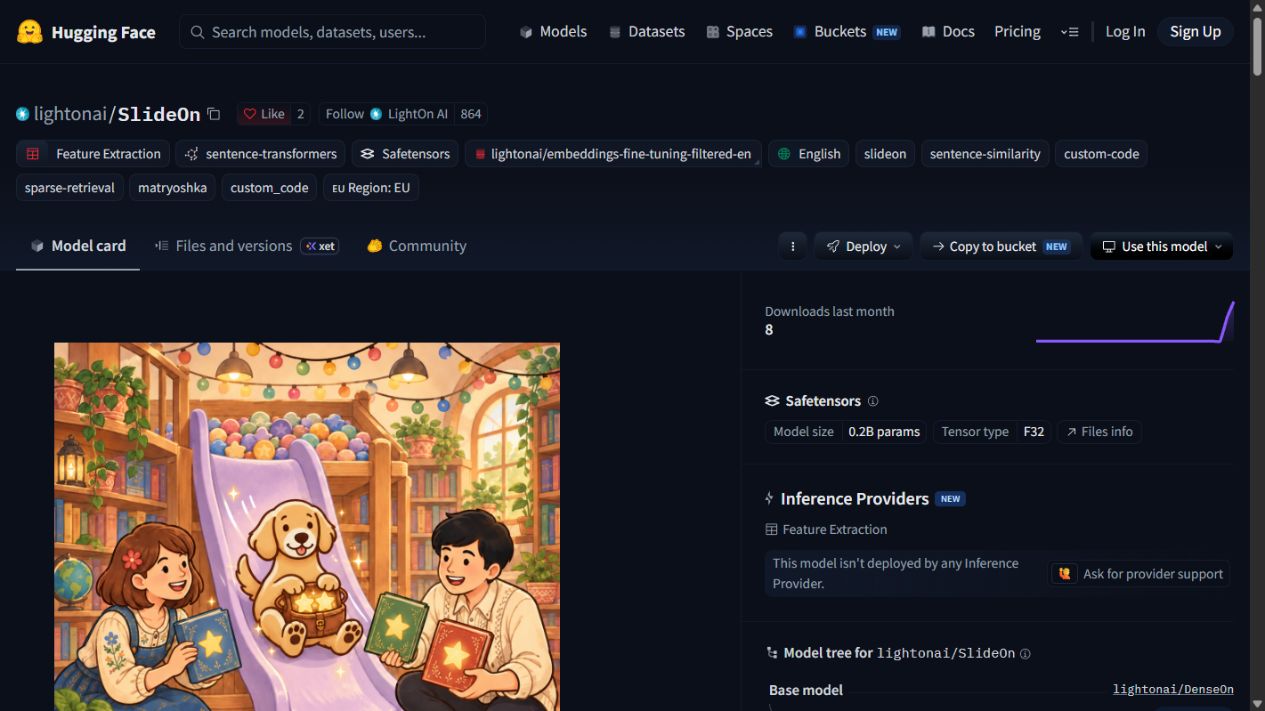 Aufnahme der öffentlichen Model Card vom 20. Oktober 2026. Quelle: LightOn auf Hugging Face. Zu sehen ist die veröffentlichte Modellseite, kein lokales Inferenzergebnis. Die Oberfläche zeigt außerdem, dass ein herunterladbares Modell nicht zwingend einen gehosteten Inferenzanbieter hat.
Vor einer Antwort braucht die Suche eine gute Vorauswahl
Ein Retriever ordnet Dokumente nach ihrer Relevanz für eine Suchanfrage. Er muss weder eine Antwort schreiben noch Dateien zusammenfassen oder entscheiden, ob ein Unternehmen seine Richtlinien ändern sollte. Seine unmittelbare Aufgabe ist enger gefasst: die relevantesten Quellen möglichst weit oben platzieren.
Stellen Sie sich ein internes Handbuch mit drei Seiten zu Rücksendungen, Versand und Mitarbeiterurlaub vor. Eine Frage zur Rücksendung einer beschädigten Bestellung sollte die Seite über Rücksendungen nach vorn bringen. Behandelt der erste Treffer stattdessen den Urlaubskalender, beginnt ein nachgeschalteter, sprachlich überzeugender Antwortgenerator bereits mit den falschen Belegen.
Diese Trennung macht Retrieval auch ohne generative KI nützlich. Eine Supportkraft kann das bestplatzierte Dokument direkt öffnen. Forschende können Textstellen zum Vergleich sammeln. Ein Programmierwerkzeug kann per Retrieval eine wahrscheinliche Implementierung finden, bevor ein Mensch sie prüft.
Damit lassen sich auch Verantwortlichkeiten sinnvoll trennen. Retrieval hilft, Belege zu finden; das Originaldokument bleibt die maßgebliche Stelle, um Wortlaut, Daten und Ausnahmen zu prüfen. Ein guter Treffer sollte den Weg zur Quelle verkürzen, statt sie durch einen Konfidenzwert zu ersetzen.
Sparse Search führt ein selektives Adressbuch
Stellen Sie sich einen Suchindex als Adressbuch vor. Ein klassischer Stichwortindex hält fest, welche Dokumente einen Begriff enthalten. Ein gelerntes Sparse-Modell erzeugt eine andere Art von Adressbuch: Es gewichtet eine relativ kleine Menge gelernter Merkmale und bewertet Anfragen und Dokumente anhand gemeinsam aktiver Merkmale.
Sparse bezeichnet diese Selektivität. Eine Repräsentation kann viele mögliche Positionen haben und für einen konkreten Text nur einen Bruchteil davon nutzen. Ein invertierter Index kann jedem aktiven Merkmal die Dokumente zuordnen, die es verwenden. So kann sich die Suchmaschine auf relevante Posting-Listen konzentrieren.
Die Model Card von SlideOn nennt 32,768 mögliche gelernte Merkmale sowie unabhängige Pruning-Regler für Anfragen und Dokumente. Diese Merkmalspositionen sind gelernte latente Größen, kein transparentes Wörterbuch englischer Begriffe. Merkmal 100 lässt sich daher nicht als garantiertes Synonym für „Rücksendungen“ deuten. SlideOn Model Card
Das ist wichtig, wenn Ergebnisse erklärt werden sollen. Sparse-Repräsentationen können eine ressourcensparende Suche ermöglichen, ohne jede interne Entscheidung verständlich zu machen. Die praktische Erklärung für Nutzende sollte weiterhin eine relevante Passage aus dem Quelldokument liefern, mit genügend Kontext, um die Übereinstimmung zu prüfen.
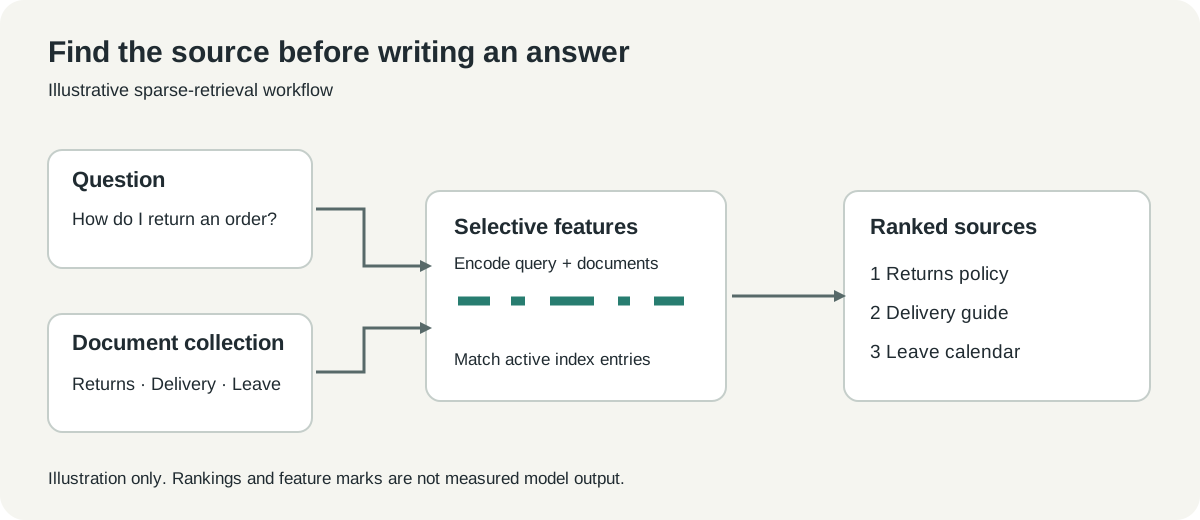 Eigene Erklärungsgrafik. Die beispielhaften Merkmalsmarkierungen veranschaulichen den Ablauf; sie sind keine gemessenen Aktivierungen von SlideOn.
Wählen Sie das Modell für Ihre tatsächliche Sammlung
Die beiden Namen bezeichnen verwandte Ausgangspunkte, keine austauschbaren Spracheinstellungen. LightOn nennt in der Veröffentlichung 174 Millionen Parameter für SlideOn und 339 Millionen Parameter für mSlideOn. Die größere Zahl allein zeigt nicht, welches Modell besser zu Ihrer Sammlung passt. Veröffentlichung vom 19. Oktober
| Ihre Sammlung | Sinnvoller erster Kandidat | Im Versuch zu klärende Frage |
|---|---|---|
| Englische Hilfeartikel | SlideOn | Findet es den richtigen Artikel, wenn die Frage anders formuliert ist? |
| Dokumente in mehreren Sprachen | mSlideOn | Funktioniert jede wichtige Sprache für sich, und verhalten sich sprachübergreifende Anfragen wie benötigt? |
| Lange technische Dokumente | mSlideOn mit bewusst geplanter Aufteilung in Abschnitte | Bleibt der relevante Abschnitt nach Vorverarbeitung und Ranking auffindbar? |
| Quellcode mit erklärendem Text | mSlideOn als Kandidat | Sind die gefundenen Dateien für jemanden nützlich, der das Repository kennt? |
Die Bezeichnung „mehrsprachig“ ist ein Anlass zur Prüfung, kein Ersatz für eine Bewertung. Ein zweisprachiger Katalog kann übersetzte Kopien, regional unterschiedliche Richtlinien und Begriffe ohne eindeutige wörtliche Entsprechung enthalten. Das sind verschiedene Retrieval-Probleme, selbst wenn die Dokumente dasselbe Sprachkennzeichen tragen.
Nehmen wir eine englische Frage zu einer französischen Erstattungsrichtlinie. Das ist eine sprachübergreifende Aufgabe. Ein französisches Dokument mit einer französischen Anfrage zu durchsuchen, ist dagegen eine gleichsprachige Aufgabe. Erfassen Sie beides getrennt: Ein Gesamtwert kann eine schwache Erfahrung für eine bestimmte Lesergruppe verdecken.
Dasselbe Prinzip gilt für Code. Eine Quelldatei zur „Sitzungswiederherstellung“ zu finden, erfordert etwas anderes als den Abgleich mit einem exakten Funktionsnamen. Nehmen Sie sowohl genaue Bezeichner als auch beschreibende Fragen in den Vergleich auf, denn ein brauchbares Suchsystem benötigt häufig beides.
Ihr erster Versuch passt in ein Notebook
Beginnen Sie mit öffentlichen oder synthetischen Texten und einer sauberen Python-Umgebung. Das veröffentlichte Beispiel verwendet SparseEncoder aus Sentence Transformers. Das ist eine Schnittstelle zum Laden des Modells, kein vollständiger Suchserver. Das folgende Beispiel ist eine Anpassung der offiziellen Anleitung, geprüft am 20. Oktober 2026. Dokumentierte Verwendung
- Öffnen Sie die Model Card und prüfen Sie den benutzerdefinierten Inferenzcode und seine Abhängigkeiten. Der folgende Loader verwendet
trust_remote_code=Trueund erlaubt damit die Ausführung der Python-Implementierung aus dem Repository. Verwenden Sie für einen reproduzierbaren Versuch eine geprüfte Revision. - Erstellen Sie eine isolierte Umgebung und installieren Sie den dokumentierten Versionsbereich der Bibliotheken.
- Kodieren Sie eine Anfrage und einige kurze Dokumente. Verwenden Sie die Methoden des Modells für Anfragen und Dokumente, statt Präfixe von Hand hinzuzufügen.
- Prüfen Sie die Scores neben dem tatsächlichen Dokumenttext. Bei diesem ersten Test geht es um die Rangfolge, nicht um einen universellen Schwellenwert.
python -m venv .venv
# Activate .venv using the command for your shell.
python -m pip install "sentence-transformers>=6.1,<6.2" "transformers>=5.3,<6"
from sentence_transformers import SparseEncoder

model = SparseEncoder("lightonai/SlideOn", trust_remote_code=True)
documents = [
    "Customers may return a damaged order within the stated return period.",
    "Standard delivery takes three working days after dispatch.",
    "Staff should record annual leave in the shared calendar.",
]
queries = ["What should I do if my delivery arrives broken?"]

q = model.encode_query(queries, top_k=64)
d = model.encode_document(documents, top_k=512)
scores = model.similarity(q, d)
print(scores)
Die obigen Dokumente sind erfundene Lehrbeispiele. Mit diesem Code wird weder ein konkretes Ergebnis noch eine gemessene Genauigkeit behauptet. Prüfen Sie zunächst, ob das Rücksendedokument auf dem ersten Platz landet, und versuchen Sie anschließend Umformulierungen und bewusst schwierige Alternativen.
Beenden Sie den Versuch nicht, sobald die einfachste Anfrage funktioniert. Fragen Sie nach einer Stornierung vor dem Versand, einem beschädigten Paket nach der Zustellung und einer Erstattung nach Ablauf der genannten Frist. Wenn die Sammlung eine Frage nicht beantwortet, sollte der Test diese Lücke sichtbar machen, statt einen ansprechenden, aber irrelevanten Treffer zu belohnen.
Zwei Budgets beantworten zwei unterschiedliche Kostenfragen
Anfrage-Pruning begrenzt die beim Stellen einer Frage verwendeten Merkmale. Dokument-Pruning begrenzt die für jeden indexierten Eintrag gespeicherten Merkmale. In einem großen Dienst betrifft das erste Budget die bei jeder Suche wiederholte Arbeit; das zweite beeinflusst zusätzlich den Index, der zwischen den Suchvorgängen bestehen bleibt.
Ein aussagekräftiger Versuch verändert jeweils nur ein Budget. Halten Sie die Dokumentrepräsentationen konstant, während Sie das Anfrage-Pruning anpassen. Wiederholen Sie den Versuch anschließend mit anderen Dokumentbudgets. Ändern Sie beides gleichzeitig, lässt sich aus einem abweichenden Ergebnis kaum ableiten, welche Änderung es verursacht hat.
Es gibt keine universelle Einstellung für „klein genug“. Eine kurze FAQ, ein mehrsprachiges Archiv und ein Software-Repository unterscheiden sich hinsichtlich Sprache, Länge und Wiederholungen. Eine Konfiguration, die bei allgemeinen Fragen funktioniert, kann ein seltenes Detail verlieren, das zwei fast identische Verfahren unterscheidet.
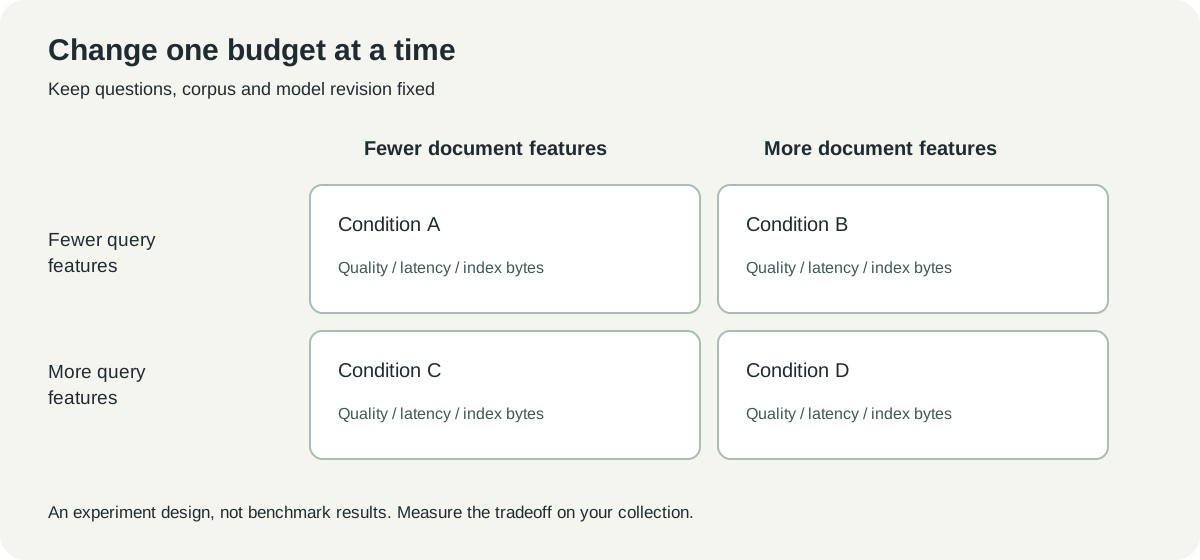 Eigener Versuchsplan. Die Felder zeigen Vergleichsbedingungen, keine Benchmark-Ergebnisse oder empfohlenen Produktionseinstellungen.
Führen Sie Qualität, Zeit und Speicherbedarf in getrennten Spalten. Wird die Suche schneller, während der relevante Artikel von der ersten Ergebnisseite verschwindet, ist der Zeitgewinn nicht kostenlos. Bringt ein größerer Index bei den tatsächlich gestellten Fragen keinen bedeutsamen Nutzen, rechtfertigt der zusätzliche Speicher möglicherweise nicht seinen Aufwand.
Ein Benchmark-Wert ist keine Messung der Antwortzeit
Die Model Card nennt für SlideOn ohne Pruning 56.68 nDCG@10 auf BEIR-15. Das ist ein dem Herausgeber zugeordnetes Ergebnis zur Ranking-Qualität über die Datensätze des Benchmarks hinweg, nicht die Wahrscheinlichkeit, dass eine bestimmte Antwort stimmt. Es ist auch keine Millisekundenangabe. Veröffentlichte Auswertung
LightOns Erläuterung zur Effizienz unterscheidet eine FLOPS-Näherungsgröße für Retrieval von gemessener Latenz sowie die Anzahl von Nichtnullwerten in Dokumenten von der Indexgröße in Bytes. Diese Trennung sollte in jeder Vergleichstabelle erhalten bleiben. Eine mathematische Näherungsgröße erklärt einen Mechanismus; eine Betriebsmessung zeigt, was Ihr System tatsächlich tut.
Auch bei einer kleinen Bewertung reicht eine Stoppuhr allein nicht. Erstmaliges Laden des Modells, Kodieren der Dokumente, Indexaufbau und wiederholte Suchanfragen sind unterschiedliche Phasen. Erfassen Sie den Kaltstart getrennt von einer Suche im bereits geladenen System und geben Sie an, ob die Zeitmessung auch die Kodierung der Anfrage umfasst.
Bei Qualitätswerten ist dieselbe Sorgfalt nötig. Ein Retriever kann das richtige Dokument finden und dennoch die falsche Passage innerhalb einer langen Datei nach oben stellen. Halten Sie fest, ob Sie Dateien, Abschnitte oder Textpassagen bewerten, und verwenden Sie für jeden Kandidaten dieselbe Einheit.
Drei praktische Sammlungen machen die Abwägungen sichtbar
Ein Betriebshandbuch eignet sich als erster Fall, weil das gewünschte Ergebnis häufig eindeutig ist. Formulieren Sie Fragen zu Rücksendungen, Versandverzögerungen und Kontozugriff und bestimmen Sie jeweils die verbindliche Seite. Nehmen Sie auch Fragen auf, deren Wortlaut von der Seitenüberschrift abweicht, damit Sie mehr als Titelabgleich testen.
Ein mehrsprachiges Projektarchiv bringt eine weitere Herausforderung mit: Dasselbe Thema kann in Besprechungsnotizen, einer übersetzten Ankündigung und einem älteren Plan vorkommen. Unterscheiden Sie mit Metadaten zwischen aktueller Richtlinie und historischer Diskussion. Semantische Ähnlichkeit entscheidet nicht, welche Version eine Organisation befolgen sollte.
Eine Sammlung mit Entwicklerdokumentation ergänzt exakte Zeichenfolgen und Beinahe-Duplikate. Eine Frage zu einem Timeout benötigt vielleicht sowohl einen konzeptionellen Leitfaden als auch einen Konfigurationsschlüssel. Behalten Sie die lexikalische Suche als Ausgangsvergleich und prüfen Sie an Ihren tatsächlichen Fragen, ob ein hybrider Ansatz seine zusätzliche Komplexität rechtfertigt.
Das sind vorgeschlagene Bewertungsszenarien, keine bereits eingesetzten Fallstudien. Sie sollen die Abnahmekriterien konkret machen. Das wichtigste Ergebnis ist jeweils eine Liste mit Fragen, akzeptierten Quellen und beobachteten Rangfolgen, die jemand anderes nachvollziehen kann.
Halten Sie den ersten Vergleich klein genug, um ihn abzuschließen
Beginnen Sie etwa mit 30 repräsentativen Fragen statt mit einer unbegrenzten Menge von Anfragen. Teilen Sie diese in gewöhnliche Nachschlagefragen, Umformulierungen, mehrdeutige Fälle und Fragen ohne Antwort in der Sammlung ein. Das ist ein Vorschlag für den Einstieg, kein statistisch repräsentativer Benchmark.
Lassen Sie die erwarteten Ergebnisse vor dem Tuning von einer fachkundigen Person bewerten. Andernfalls lädt jede überraschende Rangfolge zu einer neuen Erklärung ein, was die Frage „eigentlich gemeint“ habe. Halten Sie für die abschließende Prüfung separate, bis dahin unberührte Fragen zurück, damit die Einstellungen nicht bloß die Entwicklungsbeispiele auswendig lernen.
Dokumentieren Sie Modellrevision, Vorverarbeitungsregeln, Abschnittsgröße, Pruning-Einstellungen und Rechnerdetails. Jede dieser Änderungen kann den Vergleich beeinflussen. Ein kurzer, wiederholbarer Durchlauf ist nützlicher als ein großer Score, dessen Eingaben nicht mehr vorliegen.
Prüfen Sie schließlich die Ergebnisansicht in der Größe, in der Menschen sie verwenden werden. Selbst ein korrekter erster Treffer hilft nicht, wenn sein Titel bis zur Unkenntlichkeit abgeschnitten wird oder der Ausschnitt den entscheidenden Satz verbirgt. Suchqualität und Oberflächenqualität treffen in dem Moment aufeinander, in dem jemand entscheidet, was er öffnet.
Bessere Suche verkürzt den Weg zur Quelle
Aus unserer Sicht liegt SlideOns nützliche Idee darin, Qualitäts- und Ressourcenbudgets als getrennte, überprüfbare Regler bereitzustellen. Das ist ein praktischerer Ausgangspunkt als die Annahme, jedes Suchproblem brauche ein größeres Antwortmodell. Es lädt zu einem überschaubaren Versuch ein: Fragen beibehalten, Repräsentation verändern und prüfen, was Menschen tatsächlich finden können.
Beginnen Sie mit dem Dokument, das Ihr Team immer wieder nicht findet. Bringt der neue Retriever es bei unterschiedlichen Formulierungen zuverlässig nach vorn, haben Sie eine konkrete Verbesserung, auf der Sie aufbauen können. Das Ziel bleibt eine lesbare Quelle; das Modell soll den Weg dorthin verkürzen.
Quellen und Medien
Geprüft am 20. Oktober 2026. Das Einrichtungsbeispiel folgt der öffentlichen Model Card; eine Installation, lokale Inferenz oder ein unabhängiger Benchmark wird nicht behauptet. Screenshot: die öffentliche Modellseite von LightOn auf Hugging Face, aufgenommen vom Autor. Die beiden Diagramme sind eigene Grafiken. Quellen und Lizenzhinweise der Materialien stehen im Mediennachweis.
- Veröffentlichung von LightOn vom 19. Oktober 2026
- SlideOn Model Card und Verwendung
- mSlideOn Model Card und Sprachdetails
- Repository zu Training und Bewertung
Bewahren Sie Fragen und Belege gemeinsam auf
Speichern Sie den Fragensatz, Quellenlinks und Prüfnotizen zusammen, damit ein späterer Vergleich dieselben Fragen beantwortet. Telli.sh kann helfen, diese Rechercheunterlagen zu organisieren. Telli.sh-Konto erstellen