Sema4.ai 3.0: Ein Agent muss dieselbe Berechnung nicht immer neu erfinden
Sema4.ai 3.0 macht freigegebene Abfragen und Geschäftslogik zu gemeinsamen Teamressourcen. Wo Wiederverwendung hilft, was die Token-Angaben bedeuten und wie ein Pilot beginnt.
Am Montag trifft eine Rechnung ein. Am Dienstag kommt die nächste. Sollte ein KI-Agent jeden Morgen eine neue Methode erfinden, um dieselbe Steuerdifferenz zu berechnen?
Sema4.ai liefert mit seiner Veröffentlichung vom 29. Oktober 2026 ein überzeugendes Argument dafür, eine Antwort zu bewahren, sobald ein Team sie freigegeben hat. Die Plattform 3.0 des Anbieters von Unternehmensagenten bringt gemeinsame Arbeit und wiederverwendbare Ausführungseinheiten in dieselbe Betriebsumgebung. Ihr interessantestes Versprechen ist weniger glanzvoll als ein sprachgewandterer Chatbot: Wiederkehrende Geschäftsarbeit soll leichter prüfbar und günstiger ausführbar werden. Ankündigung von Sema4.ai
Für Finanz-, Einkaufs- und Betriebsteams verändert das die Kaufentscheidung. Sie müssen wissen, welche Teile eines Prozesses Modellurteile verdienen, welche etablierte Logik ausführen sollten und wer diese Grenze pflegt. Dieser Artikel erklärt diese Aufteilung, ordnet die gemeldeten Einsparungen ein und schlägt einen praktischen Pilotversuch vor, der sich auf Ausnahmen konzentriert, statt unbeaufsichtigt in den Produktivbetrieb zu springen.
 Eine 2024 fotografierte Rechnung veranschaulicht die Dokumenteingaben, die bei einem Abgleich geprüft werden müssen. Sie zeigt weder eine Sema4.ai-Oberfläche noch ein Kundenergebnis. Foto: Shams948, CC0; mit Rändern skaliert. Bildquelle · Lizenz und Bildhinweise. Offizielle Produktreferenz.

Die wertvolle Ressource ist die freigegebene Methode
Ein guter Prompt kann einer Person helfen, eine Frage zu beantworten. Ein gemeinsamer Geschäftsprozess braucht die Antwort auf eine andere Frage: Was passiert, wenn morgen eine andere Person fragt, mit einer etwas anderen Beschreibung und einem gerade aktualisierten Datensatz? Baut jeder Lauf Abfrage und Berechnung neu auf, muss das Team neben dem Ergebnis immer wieder auch die Methode prüfen. Dafür ist die Aufmerksamkeit von Fachleuten teuer eingesetzt.
Sema4.ai unterscheidet freigegebene Abrufmuster namens Verified Queries von freigegebenen Berechnungen und Transformationen namens Verified Logic. Die Funktionserklärung vom 29. Oktober beschreibt sie als geprüfte und versionierte Artefakte, die mit der Arbeit verbunden sind, die sie verwendet. Die Plattform bietet außerdem strukturierte DataFrames zur Verarbeitung von Datensätzen, ohne jede Zeile in den Modellkontext zu übernehmen. Funktionserklärung zu Sema4.ai 3.0
Entscheidend ist: Die wiederverwendbare Ressource ist die Methode mitsamt ihren Annahmen. Ein Modell kann eine mehrdeutige Lieferanten-E-Mail deuten, doch die freigegebene Rundungskonvention des Unternehmens sollte nicht von deren Formulierung abhängen. Ein Mensch kann eine strittige Belastung untersuchen, während derselbe etablierte Vergleich über die gewöhnlichen Einträge läuft. Diese Aufteilung setzt Urteilsvermögen dort ein, wo tatsächlich Unsicherheit besteht.
Stellen Sie sich eine Rezeptkarte für eine operative Entscheidung vor. Die Karte ist wertvoll, weil ein Team die Zutaten prüfen und die Anleitung überarbeiten kann; dieselbe Speisebeschreibung erneut auszudrucken, würde diese Verlässlichkeit nicht schaffen. Eine Versionsnummer hilft nur, wenn jemand weiß, warum das Rezept geändert wurde und welche Arbeit die frühere Version verwendete.
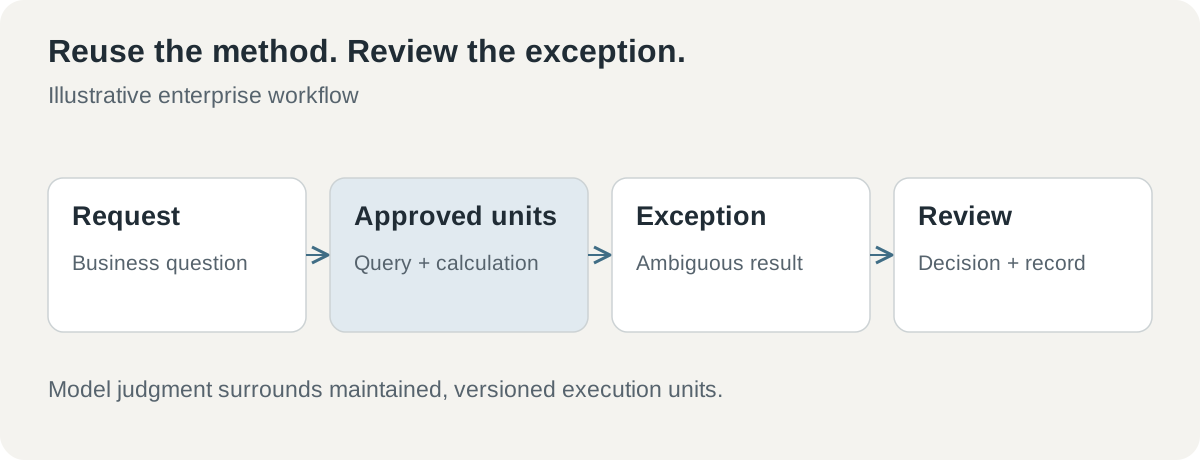 Beispielhafte Aufteilung der Verantwortung: Etablierte Abrufe und Berechnungen laufen als geprüfte Einheiten, während mehrdeutige Ausnahmen beurteilt und geprüft werden.
Die 80-%-Angabe gehört zu einer bestimmten Art von Arbeit
Sema4.ai meldet für Verified Queries 80 % weniger LLM-Token und eine 4× schnellere Ausführung, verglichen mit der Neuerzeugung von Abfragen durch frei arbeitende KI. Separat nennt das Unternehmen für Verified Logic 50 % weniger Token und eine 30 % schnellere Ausführung, verglichen mit der Codeerzeugung für wiederkehrende Arbeit. Dies sind Messwerte des Unternehmens vom 29. Oktober für bestimmte Ausführungsmuster. Sie zeigen nützlich an, wo Wiederverwendung helfen kann, sind aber keine Prognose für die gesamte Technologierechnung eines Unternehmens. Veröffentlichungsankündigung von Sema4.ai
Betrachten wir eine beispielhafte Arbeitslast, bei der die wiederholte Abfrageerzeugung 40 % der Modell-Token verbraucht. Wird dieser Anteil bei sonst gleichen Bedingungen um 80 % reduziert, sinkt der gesamte Token-Verbrauch um 32 %: 0,40 multipliziert mit 0,80. Entfallen nur 10 % auf die wiederholte Abfrageerzeugung, ergibt dieselbe Verbesserung dieser Komponente insgesamt eine Reduktion von 8 %. Beide Beispiele enthalten weder Plattformgebühren noch Wartung, menschliche Prüfung oder Datenzugriffskosten.
Die Geschwindigkeitsangabe verlangt dieselbe Sorgfalt. Verbringt ein fünfminütiger Prozess eine Minute mit der Abfrageerzeugung, verkürzt eine viermal schnellere Ausführung dieser Minute den Prozess auf vier Minuten und fünfzehn Sekunden, sofern die anderen Phasen unverändert bleiben. Das ist eine nützliche Verbesserung, aber keine vierfache Beschleunigung des gesamten Ablaufs. Teams sollten den vollständigen Weg von der Anfrage bis zum akzeptierten Ergebnis messen.
Token-Einsparungen haben über den Preis hinaus eine operative Bedeutung. Weniger neu erzeugte Methoden können weniger Gelegenheiten für subtil abweichende Verknüpfungen, Filter oder Rundungsentscheidungen bedeuten. Freigegebener Code kann jedoch beständig falsch liegen, wenn seine Annahmen veralten. Wiederverwendung bündelt Wert und Verantwortung im gemeinsamen Artefakt.
Ein Rechnungspilot sollte die Ausnahmen sichtbar machen
Stellen Sie sich einen Großhändler vor, der Lieferantenrechnungen mit Bestellungen und eingegangenen Mengen abgleicht. Dies ist ein beispielhafter Anwendungsfall, keine Aussage über eine neu vermessene Einführung. Ein sinnvoller Pilot würde freigegebene Datensätze abrufen, vereinbarte Mengen- und Preisprüfungen anwenden und einem Prüfer die verbleibenden Differenzen zeigen. Erfolgskriterium ist eine vertrauenswürdige Ausnahmewarteschlange statt einer möglichst beeindruckenden Gesprächsantwort.
Die freigegebene Abfrage sollte eine eindeutige geschäftliche Bedeutung haben. Schließt „offene Bestellung“ teilweise eingegangene Positionen aus? Sind Rücksendungen in der eingegangenen Menge enthalten? Bestimmt das Rechnungs- oder das Lieferdatum den relevanten Wechselkurs? Diese Fragen gehören in den gepflegten Prozess, weil zwei syntaktisch korrekte Abfragen unterschiedliche buchhalterische Fragen beantworten können.
Die Logik sollte auch erklären, welche Einheit sie vergleicht. Eine Schachtel mit zwölf Artikeln und zwölf Einzelartikel lassen sich nicht sicher durch den Vergleich eines rohen Mengenfelds zuordnen. Eine Toleranz von einer Währungseinheit bedeutet vor und nach Steuern etwas anderes. Ein Prüfer braucht ausreichend Quelldetails, um zu verstehen, warum ein Eintrag akzeptiert oder eskaliert wurde.
Wählen Sie für eine erste Bewertung eine kleine historische Stichprobe mit normalen Übereinstimmungen, Teillieferungen, doppelten Rechnungsreferenzen und einer strittigen Ausnahme. Lassen Sie den Fachexperten die erwartete Behandlung kennzeichnen, bevor er die Agentenausgabe prüft. So entsteht ein konkreter Vergleichsmaßstab für den eigenen Prozess des Teams. Messen Sie übersehene Ausnahmen ebenso sorgfältig wie unnötige Eskalationen; eine kurze Warteschlange ist nicht automatisch eine gute Warteschlange.
Einkauf und Logistik zeigen unterschiedliche Pflegeprobleme
Eine zweite beispielhafte Anwendung ist der Einkaufsvergleich. Ein Team könnte eine freigegebene Lieferantendatenabfrage und eine standardisierte Gesamtkostenberechnung wiederverwenden und einen Agenten zugleich um eine Erklärung unterschiedlicher Lieferzusagen bitten. Die Berechnung kann stabil sein, während die Beurteilung, ob ein vorgeschlagener Ersatz den Bedürfnissen des Käufers entspricht, Urteilsvermögen verlangt. Die abschließende Empfehlung sollte diese Trennung erhalten, damit ein Einkäufer Zahlen und Interpretation prüfen kann.
Das Pflegerisiko liegt hier in einer Richtlinienänderung. Eine Liste bevorzugter Lieferanten, eine Zahlungsbedingung oder eine Versandannahme kann sich ändern, ohne dass sich das zugrunde liegende Datenbankschema ändert. Ein Artefakt kann weiterhin fehlerfrei laufen und dabei die Regel des vergangenen Quartals anwenden. Einen Verantwortlichen und einen Termin zur erneuten Prüfung festzulegen, ist genauso wichtig wie die erste Ausgabe zu überprüfen.
Eine dritte beispielhafte Anwendung ist die Priorisierung von Logistikausnahmen. Eine etablierte Abfrage kann den Sendungsstatus zusammentragen, eine wiederholbare Prüfung einen verpassten Meilenstein erkennen und ein Modell die Ausnahme in eine verständliche Übergabe verwandeln. Die nützliche Ausgabe ist ein Fall mit belegenden Ereignissen, zuständigem Team und vorgeschlagenem nächsten Schritt. Eine autonome Nachricht, die einen neuen Liefertermin verspricht, würde eine separate Entscheidung über Befugnisse erfordern.
Diese Beispiele teilen ein Muster, sollten aber nicht jede Regel gemeinsam haben. Finanztoleranz, Einkaufspräferenz und Logistikeskalation haben unterschiedliche Verantwortliche und Folgen. Gute Wiederverwendung ist selektiv. Ein gemeinsamer Arbeitsbereich sollte diese Unterschiede leichter auffindbar machen, statt sämtliches Betriebswissen in ein riesiges Anweisungsdokument zu pressen.
Vergleichen Sie das Verantwortungsmodell, nicht nur das Chatfenster
Die Veröffentlichung von Sema4.ai positioniert gemeinsame Agenten, Fähigkeiten, Dateien, Geschäftskontext und Erinnerungen als Teamressourcen. Die Ankündigung beschreibt außerdem Interoperabilität mit Claude Cowork und Microsoft Copilot sowie einen Agent Inbox für Microsoft 365, Google Workspace und Webhooks. Praktisch stellt sich die Frage, wie ein Team einen einzigen freigegebenen Prozess beibehält, wenn Anfragen über unterschiedliche Oberflächen eingehen. Ankündigung von Sema4.ai, 29. Oktober 2026
Der folgende Vergleich betrifft die Wahl eines Betriebsansatzes und ist kein Funktionsbenchmark konkurrierender Produkte. Microsoft Copilot und Claude Cowork können die in der Veröffentlichung genannten vertrauten Einstiegspunkte sein; die Bewertung muss weiterhin klären, wo die operativen Ressourcen liegen. Ein SQL-Skript kann eine Berechnung bereits wiederholbar machen, doch die Verbindung dieses Skripts mit Interpretation, Ausnahmen und Prüfung bleibt Arbeit, die jemand übernehmen muss.
| Ansatz | Gute Ausgangsfrage | Verbleibende Verantwortung |
|---|---|---|
| Ein persönlicher Assistent in Microsoft Copilot oder Claude Cowork | Kann eine Person diese Anfrage leichter erledigen? | Entscheiden, welche Ergebnisse und Methoden gemeinsame Ressourcen werden |
| Ein gepflegter SQL-/Python-Ablauf | Kann eine definierte Berechnung konsistent laufen? | Eingaben, geschäftliche Bedeutung und Ausnahmebehandlung pflegen |
| Ein Sema4.ai-Teamablauf | Können gemeinsame Agenten geprüfte Geschäftsmethoden wiederverwenden? | Artefakte, Berechtigungen, Aktualisierungen und Abnahmekriterien verantworten |
So wird ein irreführender Wettstreit zwischen Gespräch und Code vermieden. Viele Teams brauchen beides. Der wertvolle Vergleich fragt, wie viel doppelte Arbeit ein vorgeschlagenes System beseitigt und wie klar es die Arbeit zeigt, die weiterhin einen Verantwortlichen braucht.
Beginnen Sie mit einem Prozess und einer klaren Prüfgrenze
Die offizielle Veröffentlichung bietet einen Weg zur Demo; Funktionsaktivierung und kommerzielle Bedingungen müssen für die Unternehmensumgebung geklärt werden. Planen Sie eine Einführung nicht unter der Annahme, dass jede 3.0-Funktion in jeder Tarifstufe zum selben Zeitpunkt erscheint. Eine fokussierte Demo-Anfrage hilft mehr als die allgemeine Bitte, „Finanzen zu automatisieren“. Sema4.ai-Veröffentlichung und Demo-Zugang
- Wählen Sie ein begrenztes Ergebnis. Nehmen Sie eine wiederkehrende Aufgabe, etwa das Erkennen von Rechnungsabweichungen in einer historischen Stichprobe. Halten Sie die akzeptierte Ausgabe und die Entscheidungen fest, die bei einem Menschen bleiben.
- Benennen Sie den Datenverantwortlichen. Bestimmen Sie freigegebene Systeme, erlaubte Felder, Aktualisierungserwartungen und die Bedeutung geschäftlicher Begriffe. Nutzen Sie nur den für den Pilotversuch nötigen Mindestzugriff.
- Bereiten Sie eine Vergleichsmenge vor. Nehmen Sie normale Fälle und bewusst schwierige Beispiele auf. Erfassen Sie erwartete Ergebnisse, bevor Sie den Ablauf abstimmen.
- Prüfen Sie die wiederverwendbaren Einheiten. Lassen Sie einen fachlich Verantwortlichen die Abfragebedeutung, Berechnungsannahmen und Transformationen freigeben. Halten Sie Version, Verantwortlichen und Prüfdatum zusammen fest.
- Prüfen Sie vor folgenreichen Aktionen. Vergleichen Sie Ergebnisse mit der gekennzeichneten Stichprobe, untersuchen Sie Ausnahmen und messen Sie die vollständige Laufzeit sowie die gesamten Betriebskosten.
- Testen Sie eine Änderung. Ändern Sie eine Richtlinienannahme oder ein Eingabeschema in einer kontrollierten Kopie. Überprüfen Sie, ob das Team betroffene Ressourcen identifizieren und erklären kann, welche Version ein früheres Ergebnis erzeugt hat.
Gerade der letzte Schritt ist aufschlussreich. Eine einmal funktionierende Implementierung kann dennoch schwer zu betreiben sein. Die Frage, wie sich eine Änderung ausbreitet, zeigt die Qualität von Verantwortlichkeiten, Dokumentation und Rücknahme deutlich früher als eine begeisternde Demo.
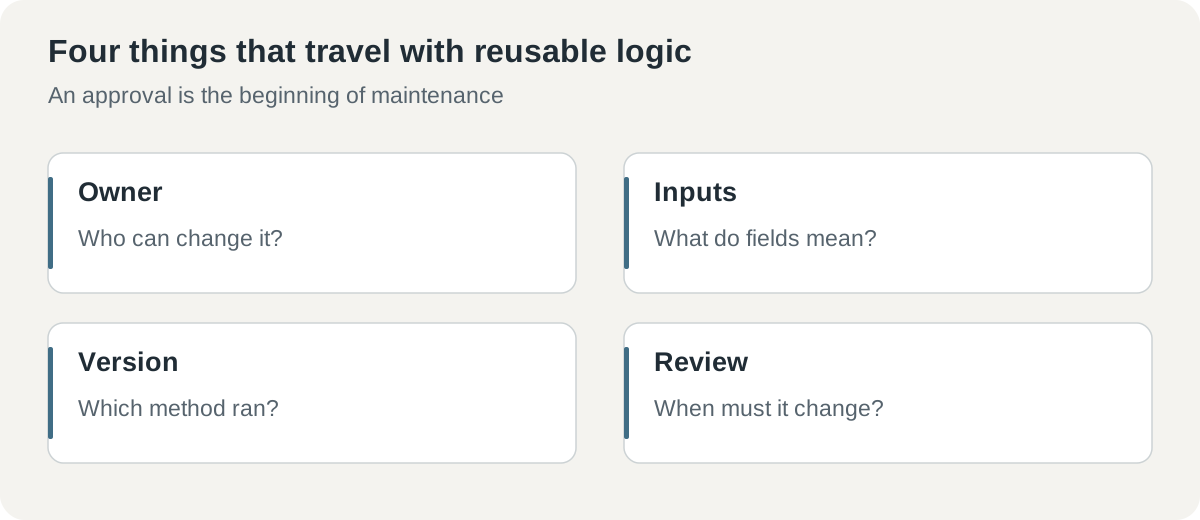 Wiederverwendung wird zur Teamressource, wenn Verantwortlicher, Eingabebedeutung, Version und Prüfgrenze mitgeführt werden.
Ein Prüfpfad braucht eine Frage, die er beantworten kann
Sema4.ai beschreibt erweiterte Prüfaufzeichnungen, die Arbeitsaktivitäten, Dokumente, Daten, Logik und Aktionen verbinden und die Untersuchung von Änderungen über den Agentenlebenszyklus hinweg ermöglichen. Das Unternehmen stellt dies als Unterstützung für Kontrollprüfungen dar, einschließlich SOX-bezogener Prüfbedürfnisse. Eine Protokollierungsfunktion ist keine pauschale Bescheinigung, dass ein bestimmter Buchhaltungsablauf seine Pflichten erfüllt. Funktionserklärung zu Sema4.ai 3.0, 29. Oktober 2026
Eine nützliche Bewertungsfrage ist präzise: Kann ein Prüfer anhand der damals verfügbaren Daten und Logik rekonstruieren, warum Rechnung 1042 eskaliert wurde? Die Antwort sollte eine spätere Korrektur des Lieferantendatensatzes überstehen. Ein attraktives Dashboard des aktuellen Zustands reicht nicht, wenn es im Entscheidungskontext von gestern stillschweigend heutige Quellwerte einsetzt.
Zugriff verdient dieselbe Aufmerksamkeit. Eine gemeinsame Fähigkeit kann breit nützlich sein, während die zugrunde liegenden Dokumente eingeschränkt bleiben. Fragen Sie, was geschieht, wenn die eine Analyse anfordernde Person die Zusammenfassung sehen darf, aber kein sensibles Quellfeld einsehen darf. Berechtigungsvererbung, Protokollzugriff und Aufbewahrungsregeln müssen zu den tatsächlichen Zuständigkeiten des Teams passen.
Der überzeugendste künftige Fortschritt wäre im besten Sinne unspektakulär: Ein Geschäftsverantwortlicher aktualisiert eine freigegebene Regel, betroffene Arbeit ist identifizierbar, Ausnahmen bleiben sichtbar und Prüfer können die Änderung erklären. Das ist ein dauerhafterer Reifemaßstab als die Häufigkeit, mit der ein Assistent Zuversicht äußert.
Wiederverwendung macht aus einer Antwort eine Verpflichtung
Unsere Einschätzung: Sema4.ai 3.0 ist relevant, weil es eine erfolgreiche Methode als etwas behandelt, das ein Team pflegen kann. Der unmittelbare Reiz liegt in weniger wiederholten Modellaufrufen. Die größere Chance ist eine Arbeitsvereinbarung darüber, was deterministisch bleiben sollte, wo Urteilsvermögen nötig ist und wer verantwortlich ist, wenn sich eines von beidem ändert.
Stellen Sie vor der Plattformwahl eine konkrete Frage: Wenn die Person, die den ursprünglichen Prompt geschrieben hat, nächsten Monat geht, kann das Team den Prozess dann noch verstehen, aktualisieren und begründen? Eine gute Automatisierungsinvestition erleichtert diese Antwort.
Quellen
- Veröffentlichungsankündigung zu Sema4.ai 3.0, 29. Oktober 2026.
- Funktionserklärung zu Sema4.ai 3.0, geprüft am 2. November 2026. Die Effizienzangaben sind Anbietervergleiche für die genannten Arbeitslasten; Szenarien und Rechnungen oben dienen der Veranschaulichung.
Bewahren Sie die Methode bei ihren Belegen auf
Telli.sh bietet eine Möglichkeit, autorisiertes Quellenmaterial, Prüfnotizen und die Begründung einer technischen Entscheidung aufzubewahren. Einen Notizbereich erstellen.