A Runway transmite um personagem digital a 24 fps. Quanto tempo ele leva para responder?
Um artigo da Runway separa o tempo de geração de vídeo ao vivo da espera que a pessoa sente em uma conversa.
Quando alguém termina uma pergunta, um personagem animado tem pouco tempo para dar sinal de que a ouviu. O vídeo pode rodar com fluidez depois que começa, mas a pausa antes da primeira resposta ainda pode dar a impressão de que a chamada caiu. Um artigo da Runway traz dados suficientes para entender de onde vem essa pausa.
A Runway lançou o Characters em 9 de março de 2026. A pré-publicação de 3 de novembro descreve o sistema por trás de um avatar de conversa que gera vídeo enquanto fala. É um relato técnico sobre um produto existente. Os autores da Runway relatam resultados do próprio sistema, incluindo como o vídeo roda em quatro GPUs NVIDIA H100. Os números ajudam uma equipe a fazer perguntas concretas em um piloto. Resultados em outro dispositivo, conexão ou aplicativo precisam ser medidos nesse contexto.
Servidor usado para testar hardware H100, o tipo de GPU do artigo da Runway. Imagem de contexto de 极客湾Geekerwan, redimensionada, CC BY 3.0. Fonte da imagem · Licença.

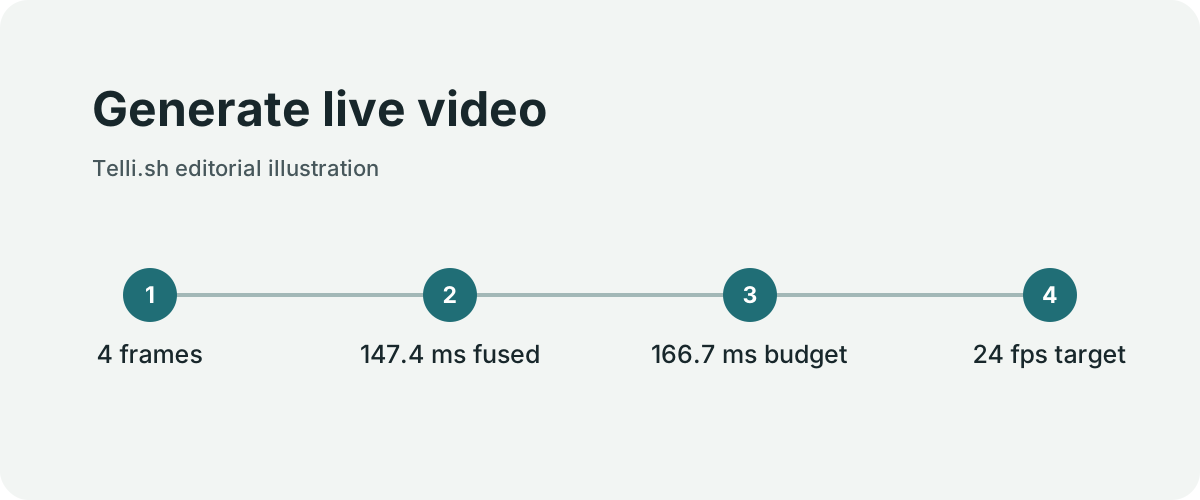
Cada lote de quadros tem cerca de 167 milissegundos
Geração de vídeo ao vivo. Ilustração original da Telli.sh.
A 24 quadros por segundo, um lote de quatro precisa ficar pronto a cada 167 milissegundos, aproximadamente. Se os lotes chegam mais devagar do que o player os consome, manter o movimento contínuo exige mais buffer, outro nível de qualidade ou algum ajuste. Um lote pode ocupar quase todos os 167 milissegundos mesmo quando o vídeo parece fluido.
Os autores descrevem um sistema com cerca de 57 bilhões de parâmetros que produz quadros de 704 por 1.088 pixels. Relatam medianas de 240,9 milissegundos por etapa de difusão na configuração de referência, 159,3 em uma configuração otimizada e 147,4 após uma fusão adicional. Uma representação latente sem ruído corresponde a quatro quadros, e a decodificação é uma fase separada que se sobrepõe. Os tempos da etapa medem algo diferente do tempo de resposta percebido pela pessoa.
Outra distinção é que a geração pode manter o ritmo depois que o primeiro lote começa. Nas condições medidas, o artigo relata 0,49 segundo para o pipeline de vídeo e cerca de 2,1 segundos de mediana para o turno completo. Processamento de fala, geração de diálogo, síntese de voz, transmissão e início da reprodução importam em uma conversa. As etapas podem se sobrepor, por isso subtrair o tempo do vídeo do total não revela o custo de uma etapa isolada.
| Métrica | A que pergunta responde | O que medir no piloto |
|---|---|---|
| Quadros por segundo | O vídeo mantém o movimento contínuo? | Quadros entregues e falhas durante uma resposta longa |
| Tempo até a primeira resposta reproduzível | Quanto dura o silêncio depois da pergunta? | Mediana e casos mais lentos nos dispositivos cliente |
| Resposta à interrupção | A pessoa pode voltar a falar sem esperar? | Tempo da interrupção até a parada do áudio |
| Sincronia de áudio e vídeo | A fala e o movimento coincidem? | Desalinhamento após interrupções, travamentos e retomadas |
Onde um personagem em movimento ajuda
Um piloto plausível é um ponto de orientação sobre produtos em museu ou showroom. Uma pessoa pergunta para que serve um controle, o aplicativo escolhe uma resposta curta de materiais aprovados e o personagem responde enquanto um diagrama continua visível na tela. Quem chega pode se beneficiar de um rosto claro, da direção do olhar ou de um sinal de quando falar. Se a conexão ficar instável, o sistema pode passar para uma explicação escrita.
Outro cenário é a simulação para funcionários. Uma pessoa ensaia como responder a um cliente frustrado e recebe retorno do aplicativo de treinamento. A coordenação do tempo é mais exigente do que em uma saudação pronta. O personagem precisa parar no meio de uma frase, aceitar interrupções e se recuperar ao entender algo errado. Além da latência, um teste útil registra se as pessoas se repetem ou falam enquanto o personagem ainda responde.
Consentimento e representação importam quando o avatar usa a imagem ou a voz de alguém real. Uma organização pode definir quem está autorizado a criar um personagem, onde a imagem pode aparecer e como removê-la. Uma figura claramente sintética ou um intérprete com permissão documentada ajuda a separar os resultados da interface das questões de licença posteriores.
O que os resultados em produção deixam em aberto
Medição do turno completo. Ilustração original da Telli.sh.
Os autores relatam que 99,5% das sessões com pelo menos um segundo tiveram média acima de 23,5 quadros por segundo. O denominador e a janela da média importam. Uma sessão pode superar a taxa média e ainda apresentar um travamento visível. Uma resposta também pode chegar rápido e perder fluidez depois. O artigo não oferece a cada comprador a distribuição dos tempos de primeira resposta com a quantidade de sessões simultâneas que ele espera.
Um piloto pequeno deve incluir uma conexão comum de escritório, uma conexão móvel limitada e os tipos de dispositivo que o público usa. Comece por voz e transcrição como referência e teste as mesmas solicitações com o personagem. Compare conclusão, abandono e interrupção. Mantenha as respostas previstas e a política de diálogo para atribuir diferenças à interface. Registre as respostas lentas junto com os exemplos bem-sucedidos.
A configuração de hardware do artigo não informa quanto uma conversa vai custar. Uma unidade útil é um exercício concluído ou uma pergunta do visitante respondida corretamente. O número de minutos gerados só importa depois de saber quantos foram úteis. Uma demonstração mostra aparência e movimento. Uma conversa medida pode mostrar se o aplicativo está pronto para o público.
Observe uma conversa quadro a quadro
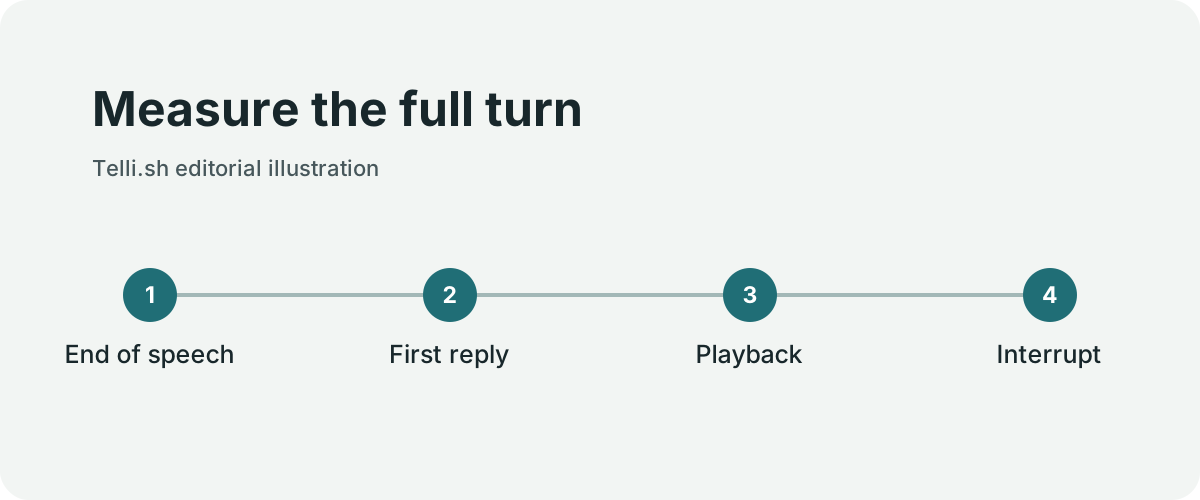
O artigo detalha duas distribuições de latência. Em 43 turnos marcados, a mediana entre o fim da fala do usuário e o áudio do avatar no cliente foi de 2,13 segundos, com percentis 10 e 90 de 1,45 e 3,00 segundos. Entre o primeiro áudio do agente e o primeiro quadro de fala capturado pelo LiveKit, a mediana foi de 493 milissegundos, com percentis de 421 e 562 milissegundos. O primeiro número é a pausa antes da resposta audível nas condições de teste. O segundo se refere ao início do vídeo de fala. A pessoa pode perceber os dois.
A taxa de quadros vem de outra coleta. Os autores dizem que registraram a telemetria dos workers durante sete semanas e definem quais sessões entraram na métrica. Um piloto em local movimentado pode complementar o resultado observando falhas de reprodução logo após uma interrupção ou durante a chegada simultânea de visitantes. Grave áudio e vídeo do cliente real para que a medição inclua rede e reprodução.
Para medir de forma justa, marque quando a pessoa termina de falar, quando o agente começa a responder e quando aparece o primeiro quadro em que fala. Repita perguntas com resposta esperada conhecida. Quem testa consegue distinguir uma resposta correta e lenta de outra rápida que não entendeu o pedido. Inclua algumas interrupções com o mesmo momento nas duas interfaces.
Compare custos por sessão concluída
A central de ajuda da Runway descreve uma cobrança inicial de 2 créditos e mais 2 a cada 6 segundos de sessão ativa. Ao preço informado de US$ 0,01 por crédito antes de impostos, 60 segundos ativos ilustram um custo de 22 créditos, ou US$ 0,22, nessas condições. É um exemplo do modelo de cobrança publicado. O total depende da conta, do tempo ativo, do preço vigente e de componentes cobrados separadamente.
Uma equipe que compara a interface com uma versão por voz pode acompanhar o custo por interação concluída. Algumas pessoas abandonam a sessão antes de o avatar terminar. Outras precisam de uma segunda conversa por problema de rede ou resposta pouco clara. Essas sessões consomem recursos mesmo sem concluir a tarefa. Inclua os abandonos no denominador da taxa de conclusão e as cobranças no gasto.
O custo de moderação e revisão também pode mudar. A empresa pode precisar verificar se a fala gerada segue a política, se o personagem sintético pode aparecer na região pretendida e como o público procura um atendente quando o sistema não tem resposta. Teste esses caminhos com o mesmo cuidado que a renderização. Uma alternativa bem planejada pode reduzir a interrupção causada por uma conexão lenta.
Faça uma comparação com medições
- Escolha uma interação aprovada com resposta correta e resultado esperado claros.
- Teste uma versão de referência por texto ou voz e outra com o avatar, mantendo a mesma fonte de resposta e a mesma política de diálogo.
- Repita as solicitações nos dispositivos e nas conexões do público. Inclua uma resposta longa, uma interrupção deliberada e uma breve queda de conexão.
- Registre início da resposta, início do vídeo de fala, falhas de reprodução, interrupções bem-sucedidas e conclusão da tarefa.
- Revise as falhas com as evidências de reprodução. Determine se o problema veio do reconhecimento de fala, da resposta, da sincronia, da rede ou da interface.
- Compare sessões concluídas e custo total das versões antes de ampliar a duração ou o volume de uso.
O teste pode mostrar quando o canal visual realmente ajuda. Um personagem pode deixar a troca de turnos mais clara para um público e criar espera desnecessária para outro. O resultado vale para a interação, a rede e os dispositivos que o produziram.
Veja a mudança de capacidade por trás dos tempos
Os autores descrevem a passagem de oito GPUs H100 para quatro por sessão em tempo real. Na configuração de quatro GPUs sem a otimização posterior por fusão, relatam 24,5 quadros por segundo. O resultado mostra que uma configuração específica de hardware e software cumpriu a meta com aquela carga. Ele não garante o comportamento com outra quantidade de sessões nem descreve o hardware alocado à conta de um cliente.
Um comprador pode perguntar qual parte do serviço inicia primeiro, o que acontece quando falta capacidade e como uma sessão se recupera. Um showroom pode aceitar uma interrupção visual breve se o áudio continuar e a pergunta receber resposta. Um aplicativo de treinamento sincronizado pode precisar pausar, mostrar uma situação clara e recomeçar de um ponto conhecido. Repita a ação após uma interrupção e confira se o aplicativo sabe o que a pessoa já ouviu.
A contrapartida aparece quando alguém interrompe no meio de uma frase. O sistema pode acumular áudio ou vídeo gerado para manter a reprodução fluida. Um buffer grande demais pode manter o personagem falando quando a pessoa tenta tomar a palavra. Um menor pode ficar mais sensível à variação da rede. Meça separadamente a parada efetiva e a próxima resposta audível.
Teste uma recuperação que a pessoa consiga entender
Em um piloto, passe a conexão normal para um perfil mais lento no meio de uma resposta. Registre se o áudio para, se a imagem congela e o que a interface comunica. Restaure a conexão normal e veja se o personagem retoma a resposta, pede para repetir a pergunta ou encaminha para outro canal. Cada resultado tem consequências diferentes para quem está diante de um quiosque.
Se o sistema não voltar, ofereça uma transcrição, um caminho escrito acessível ou atendimento humano se o aplicativo permitir. Uma tarefa curta talvez termine mesmo com falha de vídeo. Um exercício longo pode precisar voltar a um ponto salvo. O comportamento adequado depende de quanto da conversa já foi concluído.
Um teste de carga pode começar com três padrões de chegada. Compare uma sessão longa, várias sessões curtas independentes e um grupo que chega junto. Observe o início da primeira resposta e os casos mais lentos. Um fluxo estável que bate a meta depois de começar ainda pode ser ruim se a espera inicial aumentar muito durante um pico.
Fontes
Para guardar e encontrar as conversas e decisões que fazem parte do seu trabalho, crie uma conta na Telli.sh.