Runway streamt eine digitale Figur mit 24 Bildern pro Sekunde. Wie lange dauert die Antwort?
Ein Forschungspapier von Runway unterscheidet die Zeit für die Live-Videogenerierung von der Wartezeit, die eine Person im Gespräch erlebt.
Wenn ein Kunde seine Frage beendet, bleibt einer animierten Figur wenig Zeit für ein Signal, dass sie ihn verstanden hat. Das Video kann nach dem Start flüssig laufen und die Pause vor der ersten Antwort trotzdem wie eine unterbrochene Verbindung wirken. Ein neues Papier von Runway enthält genügend Zeitmessungen, um diese Pause genauer einzuordnen.
Runway startete Characters am 9. März 2026. Der Preprint vom 3. November beschreibt das System hinter einem Gesprächsavatar, der das Video beim Sprechen erzeugt. Es ist eine technische Beschreibung eines bestehenden Produkts. Die Autoren berichten von Ergebnissen ihres eigenen Systems, unter anderem vom Betrieb des Videos auf vier NVIDIA-H100-GPUs. Die Zahlen geben Teams konkrete Fragen für einen Pilotversuch. Für andere Geräte, Verbindungen und Anwendungen muss dort eigens gemessen werden.
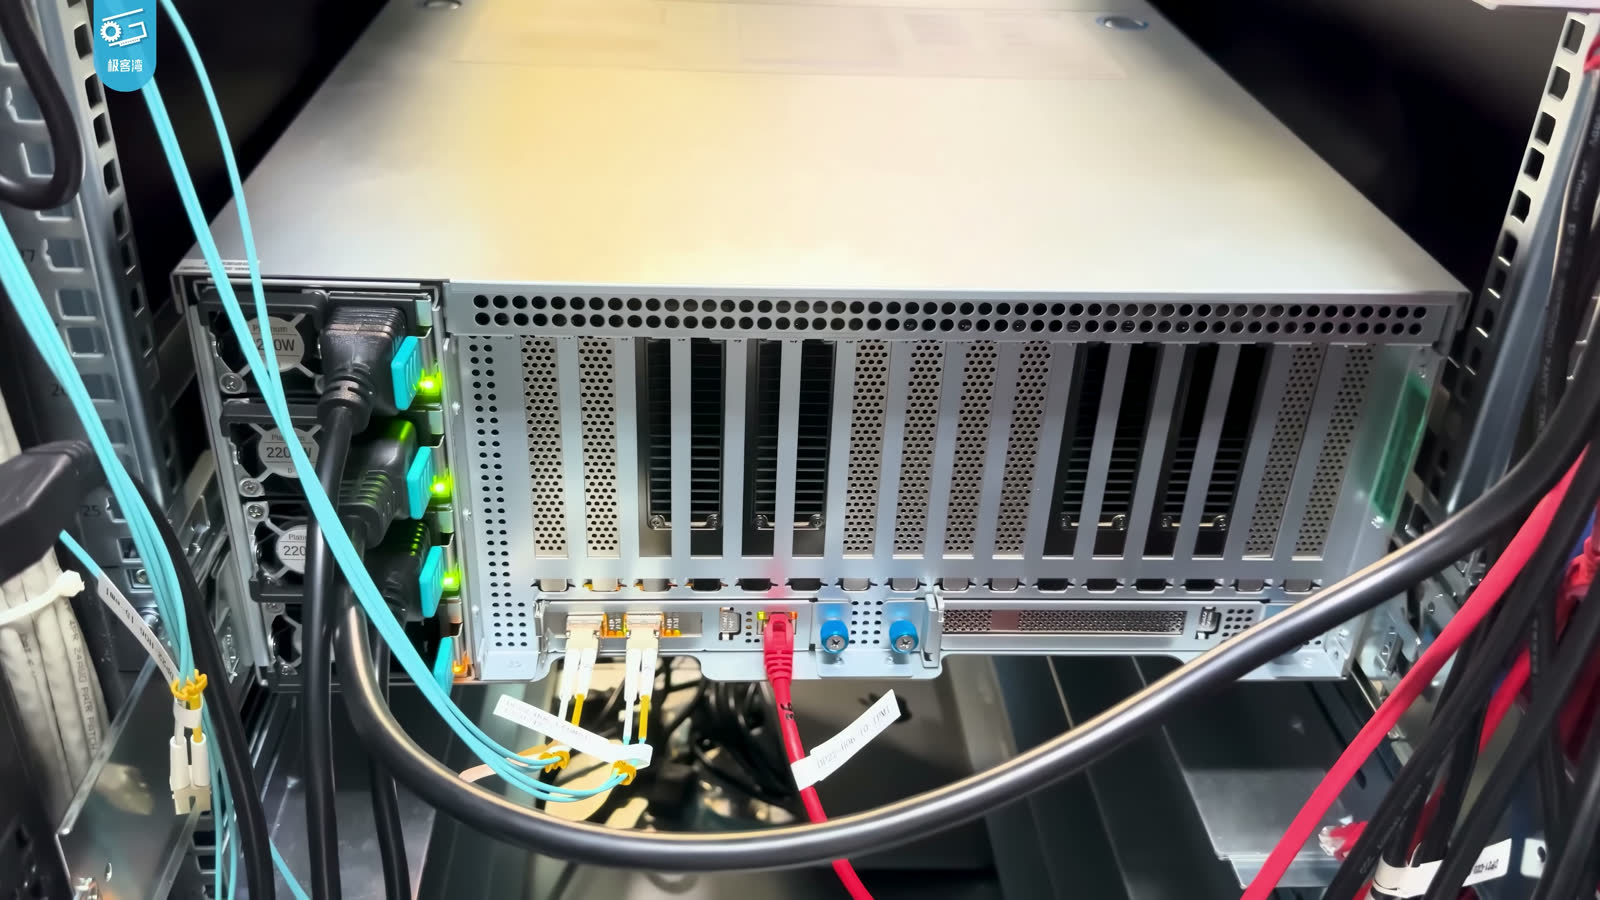
Ein Server für Tests mit H100-Hardware, dem im Runway-Papier verwendeten GPU-Typ. Kontext-Standbild von 极客湾Geekerwan, skaliert, CC BY 3.0. Bildquelle · Lizenz.

Jeder Bildblock hat rund 167 Millisekunden Zeit
Livevideo erzeugen. Eigene Darstellung von Telli.sh.
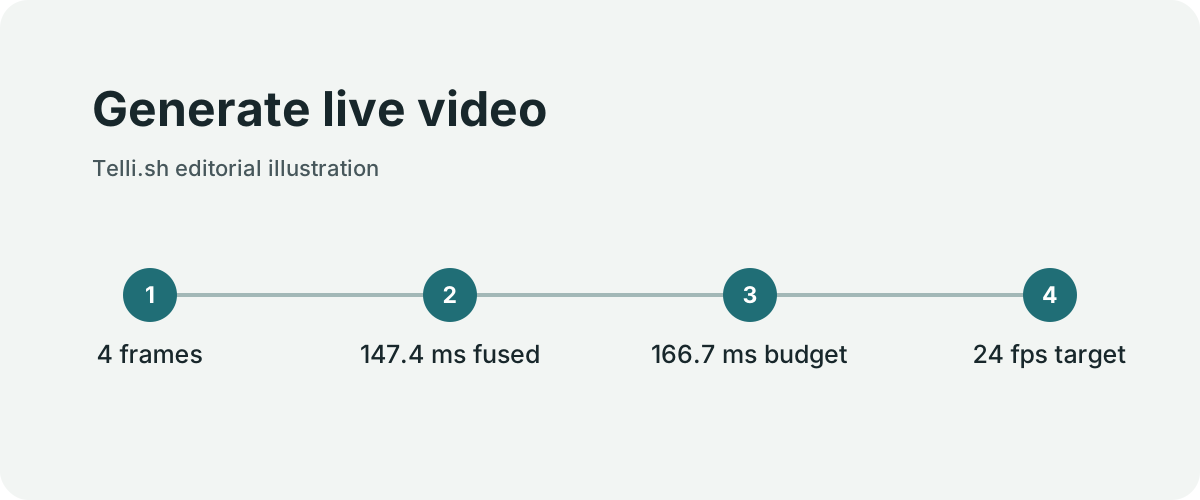
Bei 24 Bildern pro Sekunde muss etwa alle 167 Millisekunden ein Block aus vier Bildern bereitstehen. Treffen die Blöcke langsamer ein, als der Player sie verbraucht, braucht das System mehr Puffer, eine andere Qualitätseinstellung oder eine weitere Anpassung. Ein Block kann fast die vollen 167 Millisekunden benötigen, während die Wiedergabe trotzdem flüssig wirkt.
Die Autoren beschreiben ein System mit ungefähr 57 Milliarden Parametern, das Bilder mit 704 × 1.088 Pixeln erzeugt. Sie berichten von Medianzeiten für einen Diffusionsschritt von 240,9 Millisekunden in der Referenzkonfiguration, 159,3 Millisekunden in einer optimierten Konfiguration und 147,4 Millisekunden nach weiterer Fusion. Ein entrauschter latenter Block entspricht vier Bildern. Der Decoder arbeitet zeitlich überlappend. Die Schrittzeiten messen etwas anderes als die Antwortzeit aus Sicht der Nutzer.
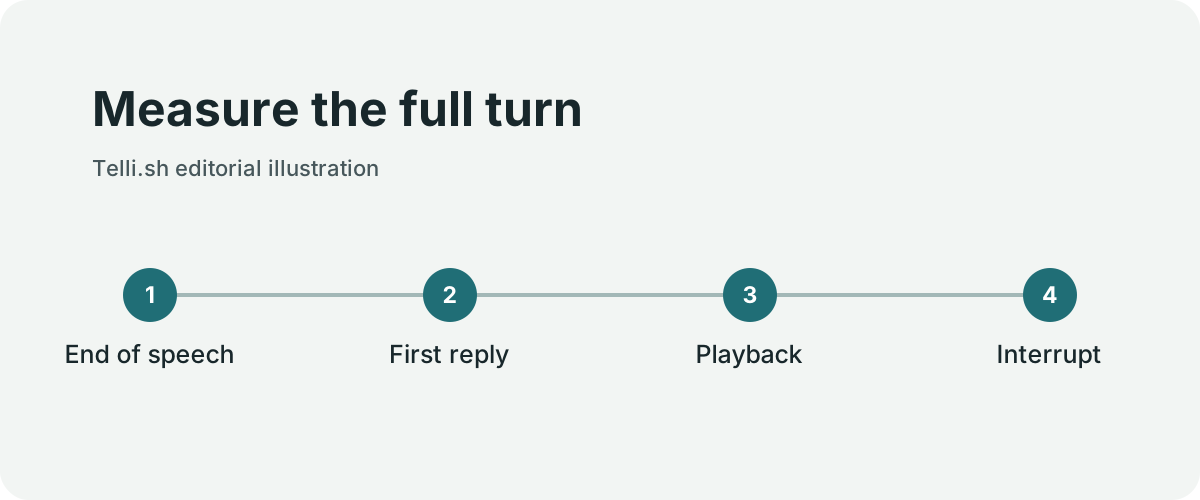
Ein weiterer Unterschied liegt darin, dass die Bilder nach dem ersten Block schnell genug erzeugt werden können. Im Papier stehen 0,49 Sekunden für die Videokette und etwa 2,1 Sekunden als Median eines vollständigen Gesprächswechsels unter den Messbedingungen. Sprachverarbeitung, Dialogerzeugung, Sprachsynthese, Übertragung und der erste brauchbare Moment der Wiedergabe gehören alle zur Interaktion. Die Phasen können sich überschneiden. Die Subtraktion der Videozeit vom Gesamtwert liefert daher keine Dauer für eine einzelne Phase.
| Messgröße | Was sie beantwortet | Was der Pilot messen sollte |
|---|---|---|
| Bilder pro Sekunde | Bleibt die Bewegung flüssig? | Ausgelieferte Bilder und Lücken in einer langen Antwort |
| Zeit bis zur ersten abspielbaren Antwort | Wie lange bleibt es nach einer Frage still? | Median und besonders langsame Fälle auf Clientgeräten |
| Reaktion auf Unterbrechung | Kann die Person gleich wieder sprechen? | Zeit von der Unterbrechung bis zum Stopp des Tons |
| Synchronität von Ton und Bild | Stimmen Sprache und Bewegung überein? | Abweichung nach Unterbrechungen, Hängern und Wiederanlauf |
Wann eine bewegte Figur einen Mehrwert bietet
Ein denkbarer Pilot ist eine Produktstation in einem Museum oder Ausstellungsraum. Ein Besucher fragt nach der Funktion eines Bedienelements. Die Anwendung wählt eine kurze Antwort aus freigegebenen Unterlagen, und die Figur antwortet, während eine Abbildung sichtbar bleibt. Ein vorbeikommender Besucher kann von einem gut erkennbaren Gesicht, Blickrichtung oder einem Signal zum Sprecherwechsel profitieren. Bei instabiler Verbindung kann das System eine schriftliche Erklärung anzeigen.
Ein zweiter Fall sind Rollenspiele für Beschäftigte. Eine Person übt, wie sie einem verärgerten Kunden antworten würde, und erhält Rückmeldung von der Schulungsanwendung. Das stellt höhere Anforderungen an das Timing als eine vorgegebene Begrüßung. Die Figur muss mitten im Satz anhalten, Unterbrechungen verarbeiten und nach einem Missverständnis weiterkommen. Ein brauchbarer Test erfasst neben der Latenz, ob Teilnehmer sich wiederholen oder der Figur ins Wort fallen.
Einwilligung und Nutzung der Darstellung werden wichtig, wenn der Avatar Bild oder Stimme einer echten Person verwendet. Eine Organisation kann regeln, wer eine Figur erstellen darf, wo das Abbild erscheinen darf und wie es entfernt wird. Eine klar synthetische Figur oder ein Darsteller mit dokumentierter Erlaubnis erleichtert es im Test, Erkenntnisse zur Oberfläche von späteren Lizenzfragen zu trennen.
Was die Produktionsmessung offenlässt
Gesprächswechsel messen. Eigene Darstellung von Telli.sh.
Laut den Autoren erreichten 99,5 % der Sitzungen von mindestens einer Sekunde durchschnittlich mehr als 23,5 Bilder pro Sekunde. Die Bezugsgruppe und die Mittelung sind wichtig. Eine Sitzung kann die durchschnittliche Bildrate erreichen und trotzdem sichtbar hängen. Eine Antwort kann rasch beginnen und dann ruckeln. Das Papier liefert nicht für jeden Kunden eine Verteilung der ersten Antwortzeiten bei seiner erwarteten Zahl gleichzeitiger Sitzungen.
Ein kleiner Pilot sollte eine gewöhnliche Büroverbindung, eine eingeschränkte Mobilverbindung und die tatsächlich verwendeten Geräteklassen umfassen. Beginnen Sie mit einer Referenz aus Sprache und Transkript und testen Sie dann dieselben Anfragen mit der Figur. Vergleichen Sie Abschluss, Abbruch und Unterbrechungen. Halten Sie Antworten und Dialogregeln gleich, damit sich Unterschiede der Oberfläche zuordnen lassen. Erfassen Sie langsame Antworten neben erfolgreichen Beispielen.
Die Hardwarekonfiguration im Papier sagt einem Käufer noch nicht, was ein Gespräch kostet. Brauchbare Einheiten sind ein abgeschlossener Trainingsdialog oder eine richtig beantwortete Besucherfrage. Die Anzahl erzeugter Minuten hilft erst, wenn klar ist, wie viele davon nützlich waren. Eine Videodemo zeigt Aussehen und Bewegung. Ein protokolliertes Gespräch zeigt, ob die Anwendung für ihre Zielgruppe bereit ist.
Vermessen Sie einen Gesprächswechsel Bild für Bild
Das Papier nennt zwei genauere Latenzverteilungen. Bei 43 markierten Gesprächswechseln lag der Median vom Ende der Nutzeräußerung bis zum ersten Ton des Avatars beim Client bei 2,13 Sekunden. Das 10. und 90. Perzentil betrugen 1,45 und 3,00 Sekunden. Vom ersten Agententon bis zum ersten Sprechbild, erfasst mit LiveKit, betrug der Median 493 Millisekunden. Die Perzentile lagen bei 421 und 562 Millisekunden. Der erste Wert erfasst unter Testbedingungen die Pause bis zur hörbaren Antwort. Der zweite betrifft den Beginn des sprechenden Bildes. Besucher können beides wahrnehmen.
Die Bildrate stammt aus einer anderen Erhebung. Laut den Autoren wurden sieben Wochen lang Telemetriedaten von Workern erfasst. Sie definieren auch, welche Sitzungen in die Kennzahl eingingen. Ein Pilot an einem stark besuchten Ort kann zusätzlich nach Wiedergabelücken direkt nach einer Unterbrechung oder bei einem plötzlichen Besucherandrang suchen. Zeichnen Sie Ton und Bild am tatsächlich verwendeten Client auf, damit Netzwerk und Wiedergabe in die Messung eingehen.
Markieren Sie das Ende der Nutzeräußerung, den Beginn der Agentenantwort und das erste sichtbare Sprechbild. Wiederholen Sie Fragen mit bekannter richtiger Antwort. So kann die Testperson eine richtige, langsame Antwort von einer schnellen, unpassenden unterscheiden. Fügen Sie einige Unterbrechungen ein, die in beiden Oberflächen zum gleichen Zeitpunkt erfolgen.
Vergleichen Sie die Kosten pro abgeschlossenem Gespräch
Runways Hilfe nennt 2 Credits zu Beginn und weitere 2 Credits pro 6 Sekunden aktiver Sitzungszeit. Bei den angegebenen 0,01 US-Dollar pro Credit vor Steuern ergeben 60 aktive Sekunden in diesem Beispiel 22 Credits oder 0,22 US-Dollar. Das Beispiel folgt dem veröffentlichten Abrechnungsmodell. Die tatsächlichen Kosten hängen vom Konto, von der aktiven Zeit, vom aktuellen Preis und von separat berechneten Teilen der Anwendung ab.
Beim Vergleich mit einer Sprachreferenz kann das Team die Kosten je abgeschlossenem Austausch erfassen. Manche Personen brechen vor Ende der Avatarantwort ab. Andere brauchen nach einem Netzproblem oder einer unklaren Antwort ein zweites Gespräch. Diese Sitzungen verbrauchen Ressourcen, auch wenn die ursprüngliche Aufgabe offen bleibt. Beziehen Sie abgebrochene Sitzungen in den Nenner der Abschlussquote und ihre Gebühren in die Ausgaben ein.
Auch Aufwand für Moderation und Inhaltsprüfung kann sich ändern. Das Unternehmen muss womöglich prüfen, ob die erzeugte Sprache den Regeln entspricht, ob eine synthetische Figur in der Zielregion erscheinen darf und wie Besucher bei einer offenen Frage einen Mitarbeiter erreichen. Testen Sie diese Abläufe so sorgfältig wie das Rendering. Ein sinnvoller Ausweichweg kann bei langsamer Verbindung die Unterbrechung abmildern.
Führen Sie einen Vergleich mit Messpunkten durch
- Wählen Sie eine freigegebene Interaktion mit klarer richtiger Antwort und einem überprüfbaren Erfolg.
- Testen Sie eine Text- oder Sprachreferenz und die Avatarversion mit denselben Antwortquellen und Dialogregeln.
- Wiederholen Sie jede Anfrage auf den Geräten und Verbindungen der Besucher. Nehmen Sie eine lange Antwort, eine gezielte Unterbrechung und einen kurzen Verbindungsabbruch auf.
- Protokollieren Sie Beginn der Antwort und des Sprechvideos, Wiedergabelücken, gelungene Unterbrechungen und den Aufgabenabschluss.
- Prüfen Sie Fehlschläge anhand der Wiedergabedaten. Unterscheiden Sie Probleme der Spracherkennung, Antworterzeugung, zeitlichen Steuerung, Verbindung und Oberfläche.
- Vergleichen Sie abgeschlossene Sitzungen und Gesamtkosten, bevor Sie längere oder stärker frequentierte Einsätze planen.
Der Test zeigt, wo der zusätzliche Bildkanal wirklich hilft. Für eine Zielgruppe kann eine Figur den Sprecherwechsel verdeutlichen, für eine andere eine unnötige Pause erzeugen. Das Pilotergebnis gehört zu der Interaktion, der Verbindung und den Geräten, mit denen es erzielt wurde.
Prüfen Sie die Kapazitätsänderung hinter der Zeitmessung
Die Autoren beschreiben eine Reduktion von acht auf vier H100-GPUs für eine einzelne Echtzeitsitzung. Der berichtete Vier-GPU-Aufbau erreicht ohne die spätere Fusionsoptimierung 24,5 Bilder pro Sekunde. Damit erfüllt eine bestimmte Hardware- und Softwarekonfiguration das Ziel für die gemessene Aufgabe. Das garantiert weder die Leistung für eine andere Zahl gleichzeitiger Anfragen noch eine konkrete Hardwarezuteilung pro Kundenkonto.
Käufer können fragen, welcher Teil des Dienstes zuerst startet, wie er auf knappe Kapazität reagiert und wie eine Sitzung wieder anläuft. Ein Ausstellungsraum kann einen kurzen Bildaussetzer verkraften, wenn der Ton weiterläuft und die Frage beantwortet wird. Eine synchronisierte Schulung muss womöglich pausieren, den Zustand klar anzeigen und an einem bekannten Punkt fortsetzen. Wiederholen Sie nach einer Unterbrechung dieselbe Aktion und prüfen Sie, ob die Anwendung erkennt, welchen Teil die Person schon gehört hat.
Der Zielkonflikt zeigt sich beim Unterbrechen mitten im Satz. Ein System kann erzeugten Ton oder Video puffern, damit es flüssig abspielt. Bei zu großem Puffer redet die Figur eventuell weiter, obwohl die Person übernehmen möchte. Ein kleinerer Puffer kann empfindlicher auf eine schwankende Verbindung reagieren. Messen Sie getrennt, wann der Ton tatsächlich stoppt und wann die nächste Antwort hörbar wird.
Testen Sie einen Wiederanlauf, den Besucher verstehen
Ein kleiner Besuchertest kann während einer Antwort von einer normalen auf eine langsamere Verbindung umschalten. Erfassen Sie, ob der Ton aussetzt, ob das Bild einfriert und was die Oberfläche mitteilt. Stellen Sie die normale Verbindung wieder her und prüfen Sie, ob die Figur an der Antwort weiterarbeitet, um eine Wiederholung bittet oder einen anderen Kanal anbietet. Diese Ergebnisse haben unterschiedliche Folgen für eine Person am Informationsstand.
Kann das System sich nicht erholen, geben Sie den Besuchern ein Transkript, einen zugänglichen schriftlichen Weg oder eine Übergabe an einen Menschen, sofern die Anwendung das unterstützt. Eine kurze Aufgabe lässt sich eventuell trotz Videoausfall beenden. Eine längere Übung muss womöglich zu einem Zwischenstand zurückkehren. Die passende Reaktion hängt davon ab, wie weit das Gespräch gekommen ist.
Ein gewöhnlicher Lasttest kann mit drei Ankunftsmustern beginnen. Vergleichen Sie eine lange Sitzung, mehrere unabhängige kurze Sitzungen und eine Gruppe, die gleichzeitig beginnt. Beobachten Sie die erste Antwort und die langsamsten Fälle. Eine flüssige Wiedergabe nach dem Start hilft wenig, wenn der Besucher bei einem Ansturm viel länger auf den Beginn warten muss.
Quellen
Wenn Sie die Gespräche und Entscheidungen hinter Ihrer Arbeit durchsuchbar festhalten möchten, erstellen Sie ein Telli.sh-Konto.