O robô que vence na demonstração pode perder na sua bancada
As avaliações distribuídas do RoboColosseum com robôs físicos mostram por que o desempenho varia conforme hardware, tarefa e ajuste fino. Monte um piloto em torno do trabalho que você precisa fazer.
Dois braços robóticos parecem igualmente convincentes no vídeo. Um perde a pegada em um recipiente desconhecido. O outro pega o objeto direito e o coloca na caixa errada. Para escolher, a equipe de operações precisa saber quais falhas aparecem na sua própria linha e o que é necessário para se recuperar.
O RoboColosseum é um projeto de pesquisa que compara políticas de controle em robôs físicos em diferentes locais. Na versão do arXiv de 2 de novembro, os autores relatam 5.699 comparações pareadas em 124 locais. Encontram pouca concordância entre as classificações em diferentes configurações físicas e mostram que o desempenho relativo pode mudar após o ajuste fino. Quem compra ou pesquisa pode usar esses dados para desenhar uma avaliação melhor antes de decidir com base em vídeos.
Um Unitree G1 à esquerda, uma das plataformas avaliadas, no Japan Mobility Show 2025. Foto de RuinDig/Yuki Uchida, redimensionada, CC BY 4.0. Fonte da imagem · Licença.

Uma classificação depende do robô, da tarefa e do ambiente
Avaliação de robô no local. Ilustração original da Telli.sh.
Uma política pode funcionar bem com certa combinação de robô, posição dos sensores e tarefa. Troque a garra ou mude por onde os objetos entram na área de trabalho, e outra habilidade pode determinar o sucesso. Uma política com ajuste fino também se comporta de modo diferente de uma usada como veio. Seu desempenho depende das demonstrações e do processo de adaptação.
O estudo compara as políticas nas mesmas condições locais. Na trilha aberta, as pessoas avaliam tentativas da mesma tarefa sem saber qual modelo produziu cada uma. A trilha de ajuste fino usa tarefas e demonstrações mais controladas. Isso separa duas perguntas sobre o que acontece com uma instrução nova e sobre como a política se adapta ao receber exemplos.
| O que um resultado descreve | O que a equipe ainda precisa saber |
|---|---|
| Uma configuração física de robô | Se o hardware e os sensores se parecem com os seus |
| Uma distribuição de tarefas | Quais objetos, disposições e exceções ela inclui |
| Uma política com ajuste fino | Quais demonstrações, tempo e recursos computacionais produziram o resultado |
| Um julgamento de preferência ou progresso | Com que frequência o ciclo termina sem intervenção |
| Um período de avaliação | Se a configuração corresponde à versão que será implantada |
O artigo relata pouca concordância entre classificações de quatro configurações físicas no estudo. O site do projeto pode mostrar um conjunto maior e mais recente de equipamentos ativos. Use o escopo do estudo para explicar seus números. O inventário atual de uma plataforma pública descreve o que ela oferece hoje, enquanto o artigo descreve um experimento em dado momento.
Observe como a falha acontece
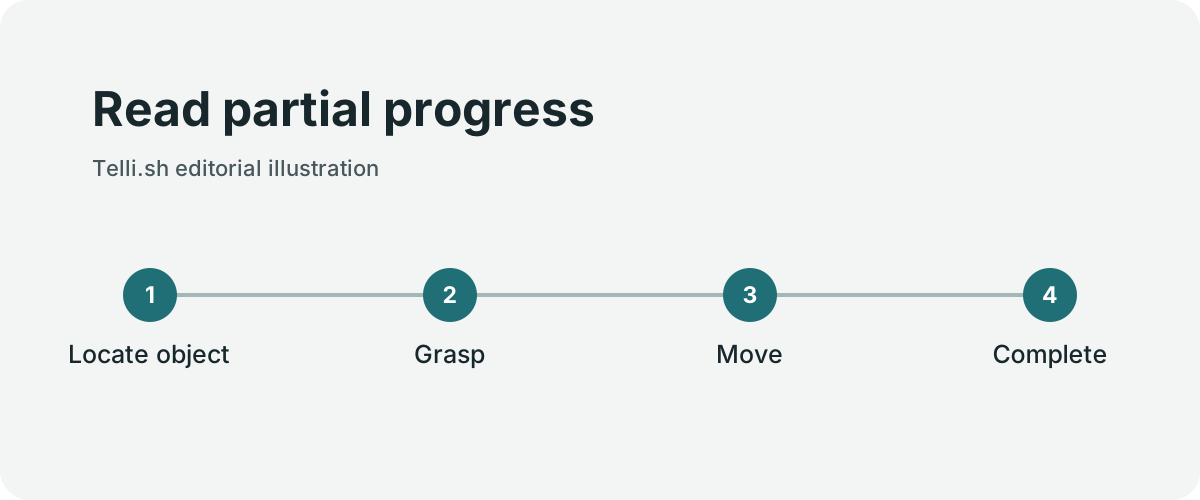
Leitura do progresso parcial. Ilustração original da Telli.sh.
O estudo relata que nenhuma política testada completou as cinco tarefas avaliadas em uma configuração específica do Unitree G1. As pontuações de progresso ainda variaram. A distinção ajuda a entender se o modelo erra no primeiro passo ou falha perto do fim. Ela se refere àquelas tarefas e políticas sob as condições do estudo.
Imagine uma triagem com cinco marcos. O robô identifica o objeto, se aproxima, segura, move e solta no lugar certo. Pode valer a pena melhorar um modelo que chega sempre à etapa de soltar se o último passo for simples. Se a falha derrubar um objeto pesado, o mesmo progresso alto traz pouco conforto operacional. O progresso parcial indica onde investigar. A consequência física indica se o comportamento é aceitável no trabalho.
Em uma demonstração curta, é fácil ignorar uma nova tentativa. Em uma linha movimentada, repetir toma tempo e pode exigir uma pessoa para preparar a área outra vez. Um sucesso em dez segundos seguido de um minuto de recuperação em parte das execuções pode resultar em produção menor que a de uma política mais lenta com menos intervenções. Meça sucesso e tempo de recuperação em ciclos suficientes para observar as interrupções relevantes.
A revisão visual é útil. Guarde clipes de uma amostra de sucessos completos, tentativas parciais e falhas de causas diferentes. Um vídeo que acaba depois da pegada pode deixar de fora a soltura. Quem vê a tentativa inteira pode distinguir um trabalho concluído de um movimento promissor.
Um piloto em campo pode aprender com a comparação da pesquisa
Comece pelo trabalho que o local realmente precisa. Um armazém pode lidar com um recipiente misto que contém embalagens reflexivas e caixas amassadas. Um laboratório pode precisar de uma sequência de transferências de ferramentas pequenas. A tarefa, o estado inicial e o resultado esperado tornam o teste repetível e ajudam fornecedores a entender o que melhorar.
- Escolha uma tarefa cujo sucesso seja observável. Anote a disposição inicial e a condição de conclusão. Inclua objetos representativos e alguns casos difíceis, mas legítimos.
- Registre robô, sensores, efetuador final, condições do local e versão da política. Quando possível, compare políticas na mesma configuração e com as mesmas instruções.
- Separe uma execução sem adaptação de outra após a adaptação. Registre quantas demonstrações foram necessárias, quanto trabalho a adaptação tomou e quais exemplos foram reservados para avaliação.
- Observe sucesso completo, progresso parcial, tempo e intervenções. Registre tentativas que falham na preparação ou exigem que um operador refaça o cenário.
- Repita em um turno ou local que mude uma condição relevante. Por exemplo, altere a combinação de objetos recebidos ou meça o comportamento quando a tarefa começa um pouco fora do centro.
- Avalie controles de implantação e segurança física com pessoal qualificado e procedimentos locais. O benchmark mede o comportamento da política. A avaliação no trabalho também precisa considerar pessoas e equipamentos perto do robô.
Para julgar diferenças qualitativas, tente revisar clipes anonimizados em pares. Dê a quem avalia uma definição escrita do comportamento aceitável e uma forma de marcar tentativas inseguras ou inutilizáveis. Guarde metadados suficientes para explicar discordâncias depois. O teste cego pode reduzir preferência pela marca, e critérios compartilhados ajudam pessoas em locais diferentes a julgar os mesmos resultados.
Compare as trilhas antes de comparar políticas
Open Track e Fine-tune Track fazem perguntas relacionadas com desenhos experimentais distintos. Na pré-publicação, o Open Track usa 5.699 comparações pareadas em 124 locais. Um teste pareado pode mostrar o desempenho de duas políticas com tarefa e local comparáveis. Esse número não implica que todo robô tenha feito toda tarefa em todos os locais.
O Fine-tune Track usa 100 demonstrações por tarefa em 20 tarefas na avaliação descrita no artigo. Os autores relatam que nenhuma das cinco tarefas avaliadas no Unitree G1 foi concluída, com médias de progresso entre 13,3% e 23,2%. Os resultados parciais dizem mais sobre a lacuna do que um único zero no fim. Eles mostram que uma política pode avançar pelos critérios de avaliação sem terminar a tarefa.
Os autores relatam um coeficiente de concordância de Kendall de 0,24 para as classificações de progresso entre quatro conjuntos de tarefas específicos de hardware. A medida expressa concordância entre classificações. Os conjuntos diferem tanto na forma física do robô quanto em tarefas e condições. A baixa concordância é um motivo para validar localmente a combinação escolhida. O estudo não isola o formato do robô como causa das diferenças.
Faça dois turnos comparáveis no teste em campo
Imagine que um centro de distribuição queira mover o mesmo inserto de embalagem de uma bandeja para uma caixa em dois turnos. A equipe nota que o turno da noite recebe outra bandeja e tem menos luz natural. Rode as duas políticas candidatas nas duas condições, no próprio local. Alterne a ordem dentro de cada turno, para que o estado da bateria, um suporte deslocado ou a experiência do operador não favoreçam sempre a mesma opção.
Anote a posição inicial do objeto, as configurações de sensores ou iluminação permitidas, como a pessoa deve intervir e o que conta como colocação completa. Guarde vídeos das falhas e notas sobre intervenções. Se uma política só melhora depois de mover a bandeja, a intervenção pode importar mais para a implantação do que a média final. A observação pode levar a mudar o suporte ou escolher casos melhores para o próximo teste.
Uma planilha útil dá crédito parcial a etapas observáveis. Uma garra que acha o inserto certo e não consegue levantá-lo precisa de outro ajuste que uma que o levanta e erra a caixa. Use uma definição simples por etapa, para que duas pessoas interpretem o teste de modo consistente. Acrescente uma categoria separada de parada segura. Parar porque uma pessoa entrou na área pode ter sido o comportamento correto, mesmo com a tarefa incompleta.
Decida que evidência sustenta o próximo passo
Uma demonstração bem-sucedida no laboratório pode justificar um teste no local, e um teste bem-sucedido pode justificar um piloto mais longo. Cada decisão tem seu próprio limite de aceitação. A equipe de compras pode pedir repetibilidade nos dois turnos mais comuns antes de discutir expansão para uma área imprevisível. Quem pesquisa pode pedir rótulos de falha e repetição das condições antes de concluir que uma política se transferiu para outro ambiente.
Quando os resultados discordarem, registre o que mudou e qual ação deu errado. Uma inversão de classificação pode revelar uma tarefa ausente do benchmark original. Isso ajuda a decidir se é preciso outro robô, outra política, uma célula de trabalho modificada ou um teste mais representativo.
Leia as inversões de classificação no artigo
O Fine-tune Track mostra casos concretos de mudanças de posição entre os quatro conjuntos de tarefas. π0.5 fica em primeiro lugar no progresso em Franka e Bimanual-YAM e em quarto no G1. GR00T N1.7 lidera o conjunto SO-101 e fica em quarto em Franka e Bimanual-YAM. Esses resultados se referem aos conjuntos e à métrica de progresso usados. Para compras, a ordem mostra como a classificação muda com a combinação de tarefas, condições e hardware.
O artigo também estuda como selecionar ativamente quais comparações executar. Na análise, cerca de 400 a 500 avaliações escolhidas de modo adaptativo chegaram a aproximadamente 90% de concordância com a classificação de todos os dados, contra cerca de 1.000 com seleção uniforme. É um resultado daquele desenho de avaliação. Ele sugere uma ideia para um piloto local. Dedique mais repetições a casos em que é difícil distinguir as melhores opções, mantendo uma quantidade mínima fixa de casos representativos.
Uma instalação pode separar uma rodada inicial e outra adaptativa. Na primeira, dê às duas opções os mesmos trabalhos com a mesma política de intervenção. Na segunda, repita condições em que a evidência inicial foi contraditória. Mantenha a regra original de aceitação. Se uma condição for excluída por segurança ou viabilidade, anote o motivo. O relatório final deve explicar como os testes adicionais mudaram a decisão.
Invista em informação sobre os trabalhos que mais importam
Avaliações distribuídas podem reunir condições que um laboratório só teria dificuldade para reproduzir. Um piloto local aprofunda as tarefas da sua equipe. As duas abordagens funcionam bem juntas. Use a evidência mais ampla para encontrar opções promissoras e desenhe sua própria avaliação para descobrir quais exceções determinam a utilidade do sistema.
A comparação mais forte é a que a equipe consegue repetir após uma nova política ou mudança de hardware. Guarde tarefa, configuração e exemplos de falha junto da pontuação. Se a classificação mudar, você terá informação suficiente para decidir se a mudança melhora seu trabalho.
Fontes
Para guardar e encontrar as conversas e decisões que fazem parte do seu trabalho, crie uma conta na Telli.sh.