Der Sieger einer Roboterdemo kann an Ihrer Werkbank verlieren
Die verteilten Versuche von RoboColosseum mit realen Robotern zeigen, wie sich die Leistung je nach Hardware, Aufgabe und Feinabstimmung ändert. Richten Sie den Pilottest an der Arbeit aus, die wirklich ansteht.
Zwei Roboterarme wirken im Video gleich überzeugend. Einer rutscht an einem ungewohnten Behälter ab. Der andere greift richtig und legt ihn in die falsche Kiste. Ein Betriebsteam, das zwischen beiden wählt, muss wissen, welche Fehler an der eigenen Anlage auftreten und wie sich der Betrieb danach wieder aufnehmen lässt.
RoboColosseum ist ein Forschungsprojekt, das Roboterstrategien auf physischer Hardware an verteilten Teststandorten vergleicht. In der arXiv-Fassung vom 2. November berichten die Autoren von 5.699 paarweisen Vergleichen an 124 Standorten. Die Rangfolgen stimmen zwischen Roboterbauformen nur schwach überein, und die relative Leistung kann sich nach der Feinabstimmung ändern. Für Einkauf und Forschung sind diese Befunde eine Grundlage, um bessere Tests als einen Vergleich von Demovideos zu entwerfen.
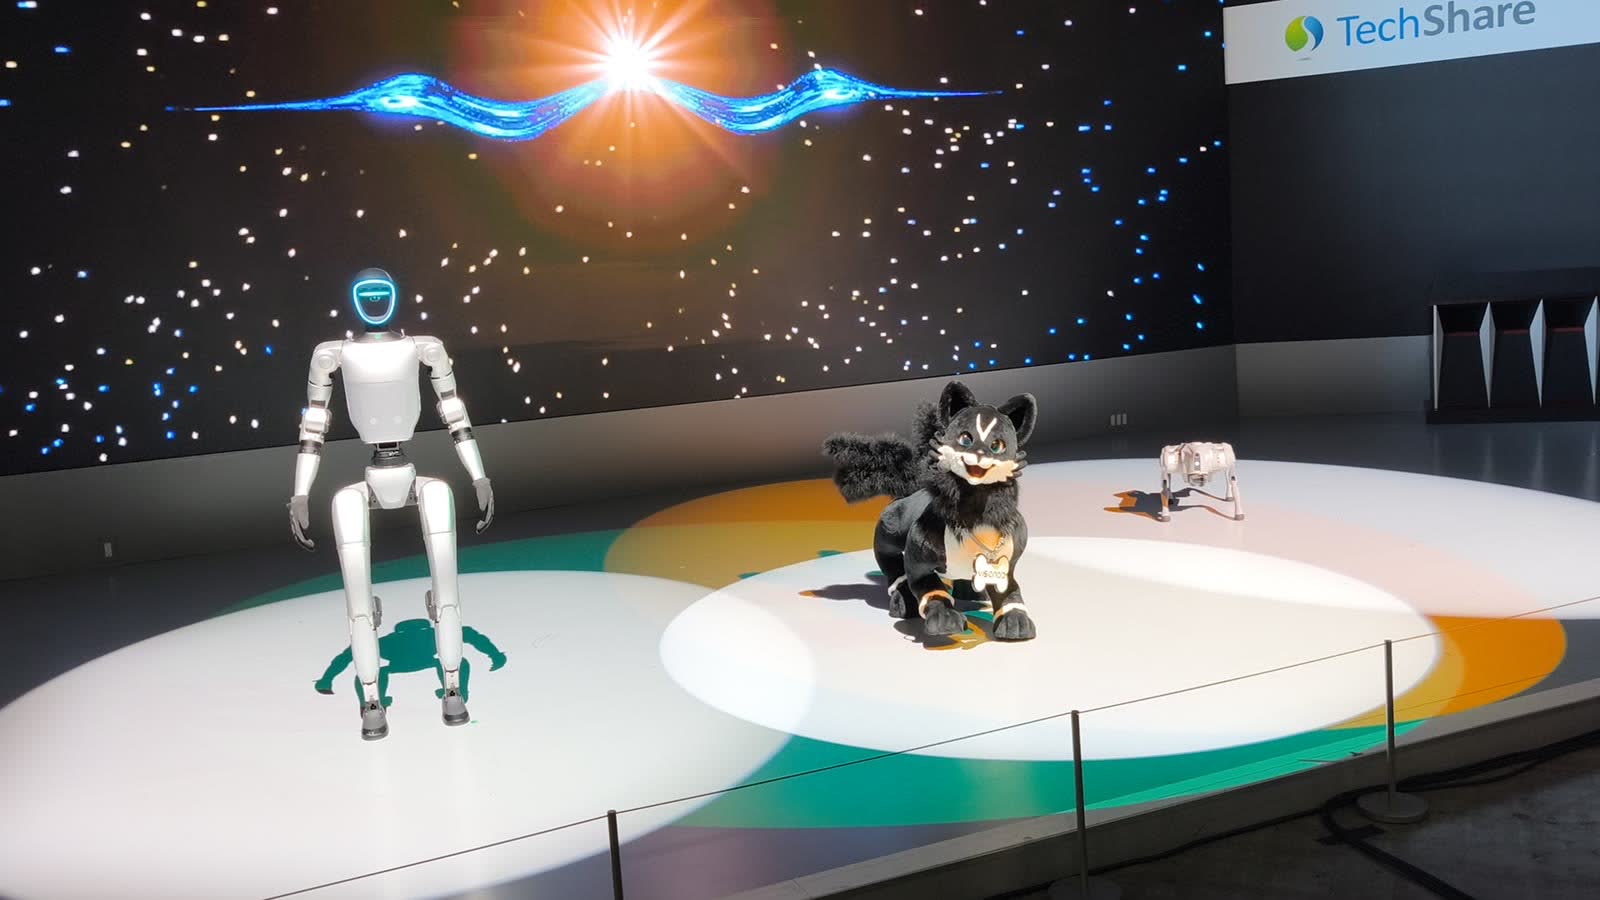
Ein Unitree G1 (links), eine der untersuchten Roboterplattformen, auf der Japan Mobility Show 2025. Foto von RuinDig/Yuki Uchida, skaliert, CC BY 4.0. Bildquelle · Lizenz.

Jede Rangfolge gehört zu einem Roboter, einer Aufgabe und einer Umgebung
Roboter vor Ort bewerten. Eigene Darstellung von Telli.sh.
Eine Steuerungsstrategie kann mit einer bestimmten Kombination aus Roboter, Sensorposition und Aufgabe gut funktionieren. Ändern sich Greifer oder Zuführung der Objekte, kann eine andere Fähigkeit den Ausschlag geben. Eine feinabgestimmte Strategie unterscheidet sich außerdem von einer direkt eingesetzten Strategie. Ihre Leistung hängt von den Demonstrationen und vom Anpassungsverfahren ab.
Die Studie vergleicht Strategien unter jeweils gleichen lokalen Bedingungen. Im offenen Teil vergleichen die Prüfer Versuche für dieselbe Aufgabe, ohne zu wissen, welches Modell welchen Versuch gesteuert hat. Für die Feinabstimmung verwendet die Studie einen stärker kontrollierten Satz von Aufgaben und Demonstrationen. So lässt sich unterscheiden, wie ein Modell mit einer neuen Anweisung umgeht und wie gut es sich anhand von Beispielen anpasst.
| Was ein Ergebnis beschreibt | Was das Einführungsteam noch wissen muss |
|---|---|
| Eine Roboterbauform | Ob ihre Hardware und Sensoren der eigenen Anlage ähneln |
| Eine Aufgabenverteilung | Welche Objekte, Anordnungen und Ausnahmefälle vorkommen |
| Eine feinabgestimmte Strategie | Welche Demonstrationen, welcher Zeitaufwand und welche Rechenleistung dafür nötig waren |
| Ein Urteil zu Präferenz oder Fortschritt | Wie oft ein vollständiger Zyklus ohne Eingriff gelingt |
| Einen Testzeitraum | Ob die Konfiguration der vorgesehenen Einsatzversion entspricht |
Das Papier berichtet von geringer Übereinstimmung der Rangfolgen über vier Roboterbauformen. Die Projektseite kann eine neuere und größere Auswahl aktiver Testhardware nennen. Für die Zahlen gilt der Umfang der Studie. Das aktuelle Inventar einer öffentlichen Plattform zeigt ihr heutiges Angebot, während das Papier ein Experiment zu einem bestimmten Zeitpunkt beschreibt.
Beobachten Sie, wie ein Fehler entsteht
Teilfortschritt ablesen. Eigene Darstellung von Telli.sh.
Laut Studie schloss keine der getesteten Strategien die fünf Aufgaben auf einem bestimmten Unitree-G1-Aufbau vollständig ab. Die Fortschrittswerte unterschieden sich trotzdem. So lässt sich erkennen, ob ein Modell bereits am Anfang scheitert oder erst kurz vor dem Ende. Der Befund gilt für diese Aufgaben und Strategien unter den Bedingungen der Studie.
Eine Sortieraufgabe kann fünf Stationen haben. Das Objekt muss erkannt, angefahren, gegriffen, bewegt und am richtigen Ort abgelegt werden. Eine Strategie, die zuverlässig bis zum Ablegen kommt, kann sich für weitere Arbeit lohnen, wenn nur ein einfacher letzter Schritt fehlt. Fällt dabei ein schweres Objekt herunter, bietet derselbe hohe Fortschrittswert kaum Sicherheit im Betrieb. Teilfortschritt zeigt, wo die Ursachenanalyse ansetzen kann. Die physischen Folgen bestimmen, ob das Verhalten für den Arbeitsplatz geeignet ist.
In einer kurzen Demo fällt ein neuer Versuch kaum auf. An einer ausgelasteten Anlage kostet er Zeit und kann eine manuelle Rücksetzung erfordern. Ein Erfolg in zehn Sekunden mit gelegentlicher Wiederherstellung von einer Minute kann den Durchsatz gegenüber einer langsameren Strategie mit weniger Eingriffen verschlechtern. Messen Sie Erfolg und Wiederherstellungszeit über genügend Zyklen, um relevante Unterbrechungen zu erfassen.
Auch die Sichtprüfung hilft. Bewahren Sie Videos einer Stichprobe aus vollständigen Erfolgen, Teilversuchen und unterschiedlich verursachten Fehlern auf. Ein Clip, der unmittelbar nach dem Greifen endet, lässt das Ablegen aus. Wer den ganzen Versuch sieht, kann einen erledigten Auftrag von einer vielversprechenden Bewegung unterscheiden.
Ein Pilot vor Ort kann vom Forschungsdesign profitieren
Ein Pilot sollte mit einer Arbeit beginnen, die vor Ort tatsächlich anfällt. Ein Lager könnte gemischte Behälter mit reflektierenden Verpackungen und gelegentlich zerdrückten Kartons testen. Ein Labor könnte eine Reihe von Übergaben kleiner Werkzeuge prüfen. Die genaue Aufgabe, ihr Anfangszustand und das erwartete Ergebnis machen den Test wiederholbar und helfen Anbietern, Verbesserungen zu erkennen.
- Wählen Sie eine Aufgabe, deren Abschluss beobachtbar ist. Halten Sie Ausgangsanordnung und Endbedingung fest. Nehmen Sie repräsentative Objekte und einige schwierige, aber legitime Fälle auf.
- Dokumentieren Sie Roboter, Sensoren, Endeffektor, Standortbedingungen und Version der Steuerungsstrategie. Lassen Sie konkurrierende Strategien möglichst im selben lokalen Aufbau und mit denselben Anweisungen antreten.
- Trennen Sie einen Test ohne Anpassung von einem Test nach der Anpassung. Erfassen Sie Zahl der Demonstrationen, den Aufwand und die Beispiele, die dafür nicht verwendet wurden.
- Erfassen Sie vollständigen Erfolg, Teilfortschritt, Dauer und Eingriffe. Behalten Sie Versuche in der Auswertung, die beim Aufbau scheitern oder manuell zurückgesetzt werden müssen.
- Wiederholen Sie den Versuch in einer anderen Schicht oder an einem anderen Ort mit einer relevanten Änderung. Nutzen Sie etwa eine neue Mischung eingehender Objekte oder messen Sie das Verhalten bei leicht versetzter Ausgangsposition.
- Bewerten Sie Kontrollen und physische Sicherheit mit Fachpersonal und nach den lokalen Verfahren. Der Forschungsbenchmark misst das Verhalten der Strategie. Vor Ort müssen auch Menschen und Ausrüstung in der Nähe des Roboters berücksichtigt werden.
Wenn Teams qualitative Unterschiede beurteilen, können sie anonymisierte Clips paarweise ansehen. Geben Sie ihnen eine schriftliche Definition akzeptablen Verhaltens und eine Möglichkeit, unsichere oder unbrauchbare Versuche zu markieren. Bewahren Sie genügend Metadaten auf, um unterschiedliche Urteile später zu verstehen. Verblindung kann Markenpräferenzen verringern, und ein gemeinsamer Bewertungsmaßstab hilft, Ergebnisse an verschiedenen Standorten gleich zu beurteilen.
Vergleichen Sie zuerst die Testreihen und dann die Strategien
Open Track und Fine-tune Track stellen verwandte Fragen mit unterschiedlichen Versuchsaufbauten. Für den Open Track nennt der Preprint 5.699 paarweise Vergleiche an 124 Standorten. Ein paarweiser Versuch kann zeigen, wie zwei Strategien bei vergleichbarer Aufgabe und Umgebung abschneiden. Er bedeutet nicht, dass jeder Roboter an jedem Standort jede Aufgabe ausgeführt hat.
Für die berichtete Auswertung im Fine-tune Track wurden pro Aufgabe 100 Demonstrationen für insgesamt 20 Aufgaben verwendet. Für den Unitree G1 berichten die Autoren von keinem vollständigen Abschluss bei fünf getesteten Aufgaben und von mittleren Fortschrittswerten zwischen 13,3 % und 23,2 %. Die Teilwerte machen die Lücke genauer sichtbar als eine einzelne Null für den Abschluss. Eine Strategie kann nach dem Bewertungsmaßstab erkennbar vorankommen, ohne die Aufgabe zu Ende zu bringen.
Für die Fortschrittsrangfolgen über vier hardwarespezifische Aufgabengruppen geben die Autoren einen Kendall-Konkordanzkoeffizienten von 0,24 an. Er misst die Übereinstimmung zwischen Rangfolgen. Die Gruppen unterscheiden sich in der Roboterbauform und in den Aufgaben und Umgebungen. Die geringe Übereinstimmung ist ein Grund, die gewählte Kombination lokal zu testen. Aus ihr lässt sich die Bauform allein nicht als Ursache der Unterschiede ableiten.
Vergleichen Sie im Feldversuch beide Schichten
Nehmen wir ein Verteilzentrum, in dem ein Roboter denselben Verpackungseinsatz in zwei Schichten von einer Ablage in einen Karton befördern soll. Das Personal beobachtet, dass die Abendschicht eine andere Ablage und weniger Tageslicht hat. Testen Sie beide Strategien in beiden Situationen vor Ort. Wechseln Sie die Reihenfolge pro Schicht, damit eine nachlassende Batterie, eine verschobene Vorrichtung oder zunehmende Routine nicht stets derselben Strategie zugutekommt.
Notieren Sie Ausgangslage des Objekts, erlaubte Sensor- und Lichteinstellungen, das Eingriffsverfahren und das Kriterium für eine erfolgreiche Ablage. Speichern Sie Videos von Fehlschlägen und Hinweise zu Eingriffen. Wenn eine Strategie erst besser wird, nachdem die Ablage versetzt wurde, kann das für den Einsatz wichtiger sein als der Durchschnitt. Daraus kann eine neue Vorrichtung oder eine bessere Fallauswahl für den nächsten Test folgen.
Ein brauchbarer Bewertungsbogen vergibt Teilpunkte für beobachtbare Phasen. Ein Greifer, der den richtigen Einsatz findet, aber nicht anhebt, verlangt andere Verbesserungen als ein Greifer, der anhebt und den Karton verfehlt. Definieren Sie jede Phase so, dass zwei Personen denselben Versuch gleich verstehen. Ergänzen Sie eine eigene Kategorie für einen sicheren Stopp. Hält der Roboter an, weil jemand den Bereich betritt, kann er sich richtig verhalten haben, obwohl die Aufgabe offen bleibt.
Legen Sie fest, welche Nachweise den nächsten Schritt tragen
Eine gelungene Labordemo kann einen Vor-Ort-Test rechtfertigen, ein guter Vor-Ort-Test einen längeren Pilotbetrieb. Für jede Entscheidung gilt eine eigene Abnahmeschwelle. Der Einkauf kann Wiederholbarkeit über zwei übliche Schichten verlangen, bevor ein weniger vorhersehbarer Bereich hinzukommt. Die Forschung kann Fehlerkategorien und Wiederholungsbedingungen verlangen, bevor sie von Übertragbarkeit spricht.
Weichen Ergebnisse ab, erfassen Sie, was sich zwischen den Umgebungen verändert hat und welcher Schritt misslang. Eine Rangumkehr kann eine Aufgabe aufdecken, die der ursprüngliche Benchmark nicht abbildete. So lässt sich entscheiden, ob ein anderer Roboter, eine andere Strategie, eine angepasste Zelle oder ein repräsentativerer Test nötig ist.
Das Papier zeigt, wie sich Rangfolgen umkehren
Der Fine-tune Track enthält konkrete Beispiele aus den vier Aufgabengruppen. π0.5 belegt in den Fortschrittsranglisten für Franka und Bimanual-YAM Platz eins und beim G1 Platz vier. GR00T N1.7 liegt beim SO-101 vorn, auf Franka und Bimanual-YAM aber auf Platz vier. Die Ergebnisse beziehen sich auf die berichteten Aufgabengruppen und ihre Fortschrittsmetrik. Der Einkauf kann darin ein Beispiel sehen, wie sich eine Rangfolge mit Aufgaben, Umgebungen und Hardware verschiebt.
Das Papier untersucht auch eine aktive Auswahl der Vergleiche. In dieser Analyse erreichten etwa 400 bis 500 adaptiv ausgewählte Bewertungen rund 90 % Übereinstimmung mit der Rangfolge auf Basis aller Daten. Bei gleichmäßiger Auswahl waren dafür ungefähr 1.000 nötig. Das ist ein Ergebnis für diesen Versuchsaufbau. Für einen lokalen Pilotbetrieb ergibt sich eine Idee daraus. Wiederholen Sie Fälle häufiger, in denen sich die führenden Kandidaten schwer unterscheiden lassen, und behalten Sie ein festes Minimum repräsentativer Fälle bei.
Ein Betrieb kann eine erste Runde und eine adaptive Runde einplanen. Geben Sie beiden Kandidaten zunächst dieselben Aufgaben unter denselben Eingriffsregeln. Wiederholen Sie danach die Konfigurationen mit gemischter Beweislage. Behalten Sie die ursprüngliche Abnahmeregel bei. Musste ein Aufbau aus Sicherheits- oder Praxisgründen entfallen, halten Sie den Grund fest. Der Abschlussbericht sollte erklären können, wie die zusätzlichen Versuche die Entscheidung verändert haben.
Erheben Sie Daten zu den Aufgaben, auf die es ankommt
Verteilte Tests erfassen eine Vielfalt von Umgebungen, die ein einzelnes Labor kaum nachbilden kann. Ein lokaler Pilot zeigt im Detail, wie die eigenen Aufgaben laufen. Die Ansätze ergänzen sich. Finden Sie anhand breiterer Befunde vielversprechende Kandidaten und prüfen Sie vor Ort die Ausnahmen, die über den Nutzen des Systems entscheiden.
Der aussagekräftigste Vergleich lässt sich nach einer neuen Strategie oder einem Hardwarewechsel wiederholen. Bewahren Sie Aufgabe, Konfiguration und Fehlerbeispiele zusammen mit der Bewertung auf. Verschiebt sich die Rangfolge, können Sie dann nachvollziehen, ob die Änderung den eigenen Betrieb verbessert.
Quellen
Wenn Sie die Gespräche und Entscheidungen hinter Ihrer Arbeit durchsuchbar festhalten möchten, erstellen Sie ein Telli.sh-Konto.