Seu próximo agente de programação pode rodar no seu Mac: conheça o Flint
O novo modelo local da Recursive combina 40B parâmetros totais com uma pequena parcela ativa. Veja o que muda para repositórios privados, hardware e desenvolvimento real.
Marca oficial do Flint do repositório do modelo da Recursive, exibida sem alterações sobre uma margem neutra para identificação editorial. Não é uma captura do modelo em execução nem evidência de um resultado de benchmark.
Um assistente de programação que funciona no seu próprio computador muda uma pergunta conhecida. Em vez de perguntar se um repositório pode ser enviado a uma API, você pode perguntar se a máquina na sua mesa consegue concluir a alteração com confiabilidade. É uma mudança útil, sobretudo quando o trabalho envolve código privado, experimentos repetidos ou uma conexão instável.
O Flint, da Recursive, concretiza essa proposta. Um anúncio de suporte desde o lançamento do vLLM, datado de 21 de outubro de 2026, apresenta suporte ao novo modelo de programação. A Recursive descreve um modelo mixture-of-experts com cerca de 40 bilhões de parâmetros e aproximadamente 2,5 bilhões de parâmetros ativos por token. Seu runtime otimizado para Mac oferece um caminho entre baixar o modelo e usá-lo em uma aplicação de agente de programação.
Nossa leitura: o Flint é interessante porque modelo, software de inferência e conexão com o agente chegam juntos. A decisão importante de compra ainda envolve a estação inteira. “2,5B ativos” descreve parte do processamento; não significa que um notebook com pouca memória comporte o modelo completo. Este guia explica a distinção de hardware, três tarefas iniciais úteis e uma forma de avaliar programação local sem confundir texto rápido com uma correção concluída.
Um modelo local se torna útil quando trabalha com suas ferramentas
A Recursive é uma empresa de pesquisa em IA que desenvolve a Eureka Machine, um sistema de pesquisa automatizada. O Flint é um produto público desse esforço, com pesos para download e um mecanismo de inferência dedicado chamado rec. Para desenvolvedores que não conhecem a empresa, o ponto de partida prático é simples: trata-se de um modelo de texto destinado a examinar código, propor alterações e usar ferramentas por meio de uma aplicação de programação.
A distinção entre o modelo e a aplicação que o coordena importa. O modelo produz uma resposta ou solicita uma ação de ferramenta. O programa ao redor decide quais arquivos ele pode ler, executa comandos, devolve resultados e apresenta alterações. Instalar um modelo local não fornece automaticamente um fluxo de desenvolvimento útil; conectar essas partes integra a experiência do produto.
A documentação de configuração da Recursive lista opções de runtime local ao lado de aplicações como Pi, OpenCode, Cline e OpenHands. Isso torna o Flint mais acessível do que um lançamento composto apenas por pesos para download. Também oferece escolhas à equipe: manter um editor conhecido, usar o inicializador sugerido ou servir o modelo separadamente.
O limite da inferência local tem valor, mas é apenas um dos limites. A aplicação ainda pode chamar um gerenciador de pacotes, acessar um site de documentação ou executar um comando de implantação se suas permissões permitirem. Para um repositório privado, examine o endpoint do modelo e as ferramentas ao redor. Um servidor local mantém a inferência local; as outras conexões do agente seguem suas próprias configurações.
Quarenta bilhões de parâmetros ainda precisam ficar em algum lugar
Modelos mixture-of-experts selecionam um subconjunto de seus componentes aprendidos para cada token. Isso reduz o processamento necessário para gerar um token em comparação com ativar toda a rede. É semelhante a uma grande oficina na qual o trabalho atual usa apenas algumas ferramentas: o equipamento ocioso continua precisando de espaço.
O cartão do modelo Flint, consultado em 23 de outubro, especifica 39,8B parâmetros totais, aproximadamente 2,5B ativos por token, e entrada e saída de texto. Ele lista uma configuração de contexto documentada de 262.144 tokens, compartilhada entre o prompt e a saída gerada. Esses números respondem a perguntas diferentes; uma única indicação de “tamanho do modelo” não basta para planejar.
Um cálculo simples torna o problema de armazenamento visível. Com exatamente quatro bits por parâmetro, 39,8 bilhões de parâmetros contêm cerca de 19,9 GB de bits brutos de parâmetros em unidades decimais. Com 16 bits, a mesma conta resulta em 79,6 GB. São cálculos ilustrativos de baixo nível, não tamanhos medidos de download nem requisitos completos de RAM: metadados, escalas de quantização, alocações do runtime e cache da conversa aumentam o total.
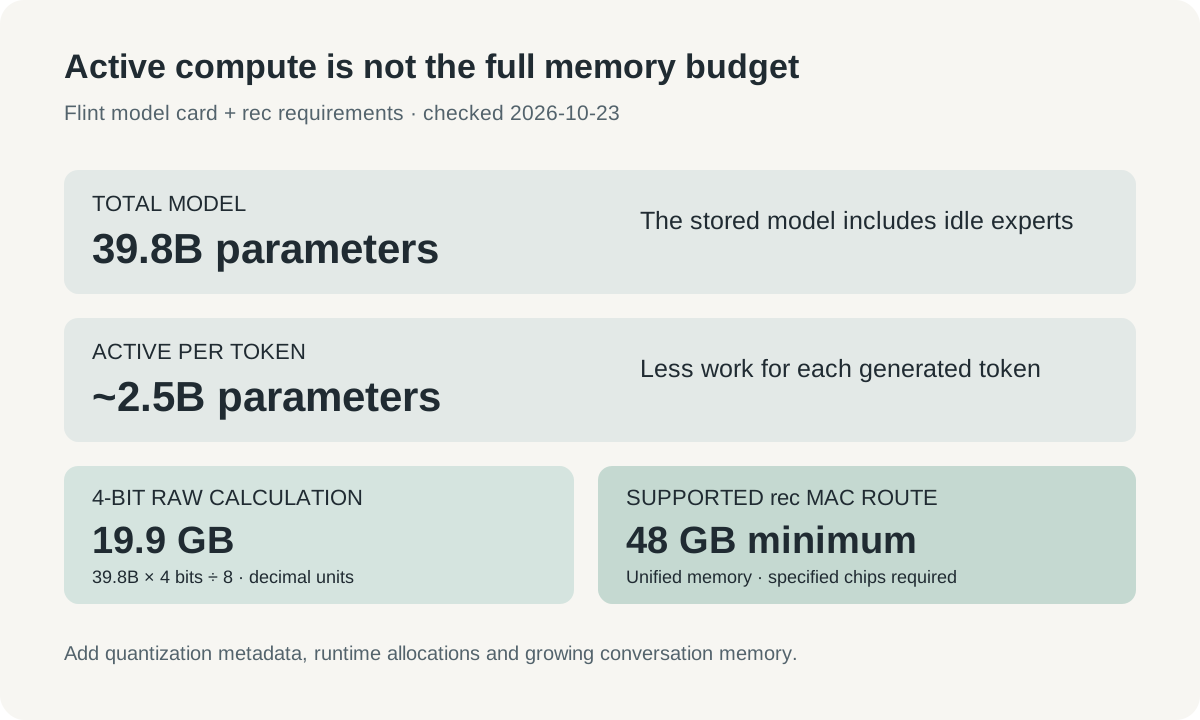
Infográfico original. A conta dos bits dos parâmetros é ilustrativa; parâmetros ativos não especificam a memória total do dispositivo. As alocações do runtime e do contexto são adicionais.
A distinção ganha importância conforme a conversa cresce. Arquivos de código, instruções, definições de ferramentas, saída de comandos e respostas do próprio modelo consomem contexto. Um máximo generoso permite carregar mais material na sessão, mas não garante qualidade igual em qualquer comprimento nem torna gratuito processar prompts longos. Manter a tarefa focada continua sendo uma escolha útil de engenharia.
Os requisitos atuais do rec especificam um Mac M4 Pro, M5 Pro ou M5 Max, pelo menos 48 GB de memória unificada e cerca de 30 GB de espaço livre. São requisitos daquele caminho otimizado de runtime, não uma promessa para toda máquina Apple Silicon. Quem tem um computador menor deve verificar os requisitos de outro runtime compatível, sem interpretar a quantidade de parâmetros ativos como orientação de compatibilidade.
Números de velocidade precisam de dispositivo e comprimento de contexto
A página de lançamento da Recursive informa mais de 125 tokens gerados por segundo em um MacBook Pro M4 Pro com contextos curtos, usando o mecanismo otimizado. Esse é o resultado de inferência divulgado pela empresa. A página também apresenta avaliações de programação, mas nem uma alegação de throughput nem uma posição em benchmark prevê a velocidade da suíte de testes da sua aplicação. Anúncio de lançamento da Recursive.
O artigo de lançamento do vLLM descreve outro ambiente: uma única GB200, decodificação com lote de uma solicitação e contexto de 100K tokens. Ele informa cerca de 485 tokens por segundo de ponta a ponta nessa configuração. Um resultado de GPU de servidor e outro de notebook não devem ocupar a mesma linha comparativa sem suas condições; hardware e infraestrutura de inferência fazem uma diferença importante.
Há ainda uma distinção entre gerar um token e concluir uma tarefa. Um modelo pode gerar mais raciocínio, chamar ferramentas com mais frequência ou escolher uma correção que exige outra tentativa. Uma saída mais rápida ajuda quando a geração é o gargalo. Ajuda menos quando a etapa mais longa é um teste de integração de dez minutos ou uma sequência de edições equivocadas.
Em uma avaliação cotidiana, meça o tempo até uma alteração revisada passar pelas verificações apropriadas. Registre quanto de correção humana ela exigiu e se afetou comportamentos alheios à tarefa. A velocidade em tokens continua sendo um diagnóstico útil, mas o resultado desejado era um patch correto. Um assistente rápido que escolhe repetidamente o caminho errado pode consumir mais da tarde.
| Decisão | Evidência útil | O que não resolve |
|---|---|---|
| O dispositivo consegue executar o modelo? | Chip, memória, runtime e checkpoint compatíveis | Se uma base de código específica cabe com folga |
| A geração parece responsiva? | Throughput com contexto e hardware declarados | Tempo total gasto em ferramentas e testes |
| Ele consegue corrigir essa classe de problema? | Resultados revisados com verificação reproduzível | Confiabilidade em categorias de tarefas desconhecidas |
| O fluxo atende às necessidades de privacidade? | Endpoints reais e permissões das ferramentas | Toda ação possível em uma aplicação com permissões amplas |
Comece com uma correção delimitada antes de uma migração inteira
O primeiro cenário útil é um bug comum em um repositório que você já conhece. Imagine um parser que trata incorretamente uma entrada vazia. Peça ao Flint para identificar a função responsável, explicar seu comportamento e adicionar um teste de regressão antes de alterar a implementação. É um teste ilustrativo, não um relato de execução nossa.
Essa tarefa dá ao assistente uma linha de chegada pequena e observável. O comportamento esperado é explícito, os arquivos relevantes são limitados e um revisor consegue dizer se o teste exercita a falha. Se o modelo partir para uma limpeza ampla, você poderá reconhecer o desvio antes que vire um patch grande. A geração local permite iterar sem uma cobrança de API por solicitação, mas a restrição continua melhorando o trabalho.
Um segundo cenário é conhecer um módulo privado. Peça um mapa do caminho da requisição com referências a arquivos e verifique algumas delas pessoalmente. Continue com um pedido restrito, como adicionar uma regra de validação ausente. O valor está em uma conversa fundamentada no repositório real, em vez de uma explicação genérica desconectada de seus contratos.
Um terceiro cenário é a manutenção rotineira dos testes. Uma equipe pode experimentar o Flint em falhas já compreendidas ou pequenas lacunas, mantendo os resultados esperados ocultos até a revisão. Inclua uma tarefa cuja resposta correta seja que o comportamento atual é intencional. A capacidade de evitar edições desnecessárias faz parte da qualidade do desenvolvimento, mesmo sendo menos impressionante do que uma grande funcionalidade gerada.
Esses casos diferem deliberadamente nos resultados: uma correção, uma explicação e uma decisão sobre testes. O sucesso em um deve orientar o próximo experimento, em vez de servir como evidência de que toda atividade de desenvolvimento pode migrar para o mesmo modelo local.
Um Mac compatível oferece um caminho curto até a primeira tarefa
A sequência abaixo usa o fluxo publicado do rec, consultado em 23 de outubro. Ela pressupõe um Mac compatível e um repositório que você tem autorização para examinar. Os comandos são instruções para os leitores, não evidência de que instalamos ou executamos o modelo.
- Confira chip, armazenamento livre e memória nos requisitos atuais. Comece em uma branch descartável ou cópia de um projeto conhecido para facilitar a revisão do primeiro experimento.
- Abra o repositório oficial do rec, examine as instruções e o instalador e siga o caminho documentado. O primeiro download exige conexão, mesmo que a inferência posterior seja local.
- Verifique a instalação e inicie a aplicação sugerida a partir do diretório do projeto:
rec doctor
rec launch pi
- Dê uma tarefa concreta, com comportamento esperado, escopo relevante e comando de verificação. Por exemplo: explicar por que um teste de entrada vazia falha, adicionar uma regressão focada e alterar somente a função responsável por esse comportamento.
- Revise o diff e a saída real dos testes. Ao terminar, confira o estado do servidor e interrompa o runtime se ele não deve continuar ocupando memória:
rec status
rec stop
Vale entender a conveniência do inicializador. A Recursive documenta que o servidor do modelo pode continuar rodando depois que a aplicação ou o terminal fecha. Encerrar a sessão interativa e liberar o modelo local são ações distintas. Isso importa em uma máquina também usada para compilações, navegador e outras aplicações diárias.
Guarde a configuração de geração junto com o resultado
O guia de configurações de geração recomenda começar com temperature 1.0, top-p 0.95 e top-k 20. Também explica que o raciocínio consome o orçamento de saída. Quando uma resposta para por atingir o limite, a resposta inacabada é um problema diferente de uma resposta completa e incorreta.
Use a configuração incluída no inicializador na primeira avaliação. Se depois trocar de runtime ou precisão, registre a mudança junto com o resultado. Caso contrário, uma aparente regressão do modelo pode vir de um template de chat incompatível, uma resposta truncada ou um parser de ferramentas que não entende o formato gerado.
O artigo do vLLM documenta parsers de ferramentas e raciocínio no estilo GLM-4.7 para esse caminho de execução. É um exemplo concreto de por que o modelo aparecer em um menu não representa toda a integração. A aplicação precisa preservar a estrutura relevante da conversa e executar corretamente as chamadas pretendidas. Uma resposta saudável no chat, sozinha, não demonstra que a edição de arquivos funciona.
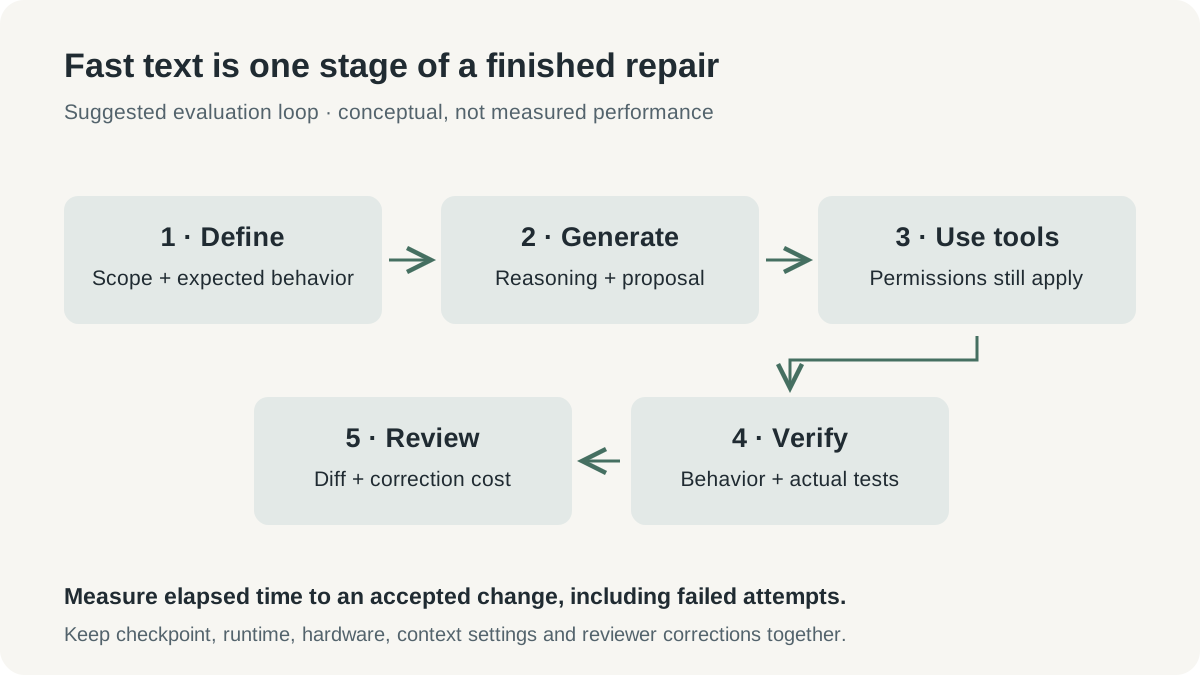
Fluxo conceitual original. A verificação final é um resultado de tarefa revisado; o diagrama não representa desempenho medido nem uma instalação concluída.
Uma nota de avaliação pode ser pequena: revisão do checkpoint, versão do runtime, hardware, configuração do contexto, tarefa, tempo decorrido, resultado dos testes e correções do revisor. Repetir as mesmas tarefas delimitadas após uma atualização informa mais do que comparar sessões cujas configurações e metas mudaram. Mantenha as tentativas que falharam, pois o custo de recuperação afeta a utilidade da ferramenta.
A inferência local muda a cobrança, não elimina o custo
Evitar uma tarifa de API pode atrair quem repete tarefas em hardware já disponível. Uma equipe que frequentemente pede explicações de código ou pequenos testes pode preferir capacidade local previsível. A comparação ainda inclui o tempo de instalação, manutenção e revisão, além do custo de oportunidade da memória da máquina.
Comprar um notebook novo com muita memória só por causa de um lançamento é uma conta diferente de testar o modelo em uma máquina compatível que você já possui. Estime a carga real antes de tratar hardware como economia. Inclua tarefas nas quais um modelo hospedado maior conclua o trabalho com menos correções; combinar local e hospedado pode fazer sentido quando trabalhos diferentes se beneficiam de ferramentas diferentes.
A concorrência também merece atenção. A documentação atual do rec diz que o mecanismo atende uma geração por vez, e solicitações sobrepostas podem receber HTTP 429. Uma boa experiência individual, portanto, não implica um servidor compartilhado de equipe com o mesmo comportamento. Atender vários agentes introduz outra carga e pode exigir outro runtime.
O desenvolvimento promissor é que a programação local está virando uma escolha completa de fluxo de trabalho. O pequeno processamento ativo do Flint, os pesos acessíveis e o runtime dedicado atacam partes diferentes desse problema. O próximo passo deveria ser evidência mais ampla de correções concluídas em projetos comuns, suporte estável de runtime e comportamento claro em sessões longas. São essas melhorias que transformam uma demonstração impressionante em uma ferramenta diária confiável.
A estação de trabalho está se tornando parte do assistente
O Flint pede que desenvolvedores avaliem mais do que uma pontuação de modelo. Sua memória, permissões das ferramentas, aplicação do agente e hábitos de revisão passam a integrar o assistente efetivamente utilizado. É uma proposta exigente, mas também dá controle: o ciclo de desenvolvimento pode ser inspecionado e moldado em uma máquina sua.
Comece com uma tarefa cujo resultado você saiba julgar. Se o ciclo local produzir repetidamente uma boa alteração com revisão administrável, você encontrou uma ferramenta útil. A afirmação mais forte, de que ele deveria assumir a próxima categoria mais difícil, pode esperar pela próxima evidência.
Fontes
- Recursive: Introducing Flint, anúncio de lançamento; consultado em 23 de outubro de 2026. A página independente não exibe uma data confiável de lançamento.
- vLLM e Recursive: Day-0 Support for Flint, 21 de outubro de 2026.
- Cartão e especificações oficiais do Flint, consultados em 23 de outubro de 2026.
- Recursive: documentação do Flint, configuração e requisitos do rec e configurações de geração, consultados em 23 de outubro de 2026.
- Repositório oficial do rec, consultado em 23 de outubro de 2026.
Guarde o raciocínio por trás de uma decisão técnica
Se você quer um espaço separado para links de fontes e notas técnicas revisadas, o Telli.sh é uma opção. Abra seu espaço de notas.