Der nächste Coding-Agent läuft auf deinem Mac: Das ist Flint
Recursives neues lokales Programmiermodell verbindet 40 Milliarden Gesamtparameter mit einem kleinen aktiven Anteil. Was sich für private Repositorys, Hardware und echte Entwicklungsarbeit verändert.
Offizielles Flint-Modellzeichen aus Recursives Modellrepository, unverändert mit neutralem Rand zur redaktionellen Kennzeichnung gezeigt. Es ist weder ein Screenshot eines laufenden Modells noch ein Beleg für ein Benchmarkergebnis.
Ein Programmierassistent auf dem eigenen Rechner verändert eine vertraute Frage. Statt zu fragen, ob ein Repository an eine API gesendet werden darf, lässt sich fragen, ob der Rechner auf dem Schreibtisch die Änderung zuverlässig fertigstellt. Das ist besonders bei privatem Code, wiederholten Experimenten oder unzuverlässiger Verbindung hilfreich.
Recursives Flint macht dieses Angebot konkret. Eine vLLM-Ankündigung zur Unterstützung ab Tag null vom 21. Oktober 2026 stellt das neue Programmiermodell vor. Recursive beschreibt ein Mixture-of-Experts-Modell mit rund 40 Milliarden Gesamtparametern und etwa 2,5 Milliarden aktiven Parametern pro Token. Eine optimierte Mac-Laufzeit bietet einen Weg vom Download zur tatsächlichen Programmierumgebung.
Unsere Einschätzung: Flint ist interessant, weil Modell, Servingsoftware und Agentenanbindung gemeinsam erscheinen. Die wichtige Kaufentscheidung betrifft dennoch die gesamte Workstation. „2,5B aktiv“ beschreibt einen Teil der Berechnung; es bedeutet nicht, dass ein speicherarmer Laptop das vollständige Modell aufnehmen kann. Dieser Artikel erklärt den Hardwareunterschied, drei sinnvolle Einstiegsaufgaben und eine Bewertung lokaler Programmierung, die schnellen Text nicht mit fertiger Reparatur verwechselt.
Ein lokales Modell wird mit seinen Werkzeugen nützlich
Recursive ist ein KI-Forschungsunternehmen und entwickelt mit der Eureka Machine ein automatisiertes Forschungssystem. Flint ist ein öffentliches Produkt dieser Arbeit, mit herunterladbaren Gewichten und einer eigenen Inferenzengine namens rec. Für Entwickler ohne Vorkenntnisse ist der Ausgangspunkt einfach: ein Textmodell, das über eine Programmieranwendung Code untersucht, Änderungen vorschlägt und Werkzeuge nutzt.
Die Trennung zwischen Modell und Ausführungsumgebung zählt. Das Modell erzeugt eine Antwort oder fordert eine Werkzeugaktion an. Das umgebende Programm bestimmt lesbare Dateien, führt Befehle aus, liefert Ergebnisse zurück und zeigt Änderungen. Ein installiertes lokales Modell bietet nicht automatisch einen brauchbaren Entwicklungsablauf; die Verbindung dieser Teile gehört zum Produkterlebnis.
Recursives Einrichtungsdokumentation führt lokale Laufzeiten und Anwendungen wie Pi, OpenCode, Cline und OpenHands auf. Das erleichtert den Einstieg gegenüber einem reinen Gewichtedownload. Teams haben Optionen: den vertrauten Editor behalten, den empfohlenen Launcher nutzen oder das Modell separat bereitstellen.
Lokale Inferenz schafft eine wertvolle, aber nur eine Grenze. Eine Ausführungsumgebung kann weiterhin Paketmanager aufrufen, Dokumentationsseiten kontaktieren oder Deploymentbefehle ausführen, sofern ihre Rechte das erlauben. Bei privaten Repositorys sollten Modellendpunkt und umgebende Werkzeuge geprüft werden. Ein lokaler Server hält die Inferenz lokal; andere Agentenverbindungen folgen ihrer eigenen Konfiguration.
Vierzig Milliarden Parameter müssen irgendwo liegen
Mixture-of-Experts-Modelle wählen pro Token einen Teil ihrer gelernten Komponenten aus. Das reduziert die Modellberechnung gegenüber der Aktivierung des gesamten Netzes. Ähnlich einer großen Werkstatt nutzt der aktuelle Auftrag nur einige Werkzeuge; die ungenutzte Ausrüstung benötigt trotzdem Lagerplatz.
Die am 23. Oktober geprüfte Flint-Modellkarte nennt 39,8 Milliarden Gesamtparameter, etwa 2,5 Milliarden aktive pro Token sowie Texteingabe und -ausgabe. Die dokumentierte Kontextkonfiguration umfasst 262.144 Tokens, gemeinsam für Prompt und generierte Ausgabe. Diese Zahlen beantworten verschiedene Fragen. Ein einzelnes Größenetikett reicht zur Planung nicht.
Eine einfache Rechnung macht die Speicherfrage sichtbar. Bei genau vier Bit pro Parameter enthalten 39,8 Milliarden Parameter etwa 19,9 GB reine Parameterbits in Dezimaleinheiten. Mit 16 Bit ergibt dieselbe Rechnung 79,6 GB. Das sind veranschaulichende Grundrechnungen, keine gemessenen Downloadgrößen oder vollständigen RAM-Anforderungen: Metadaten, Quantisierungsskalen, Laufzeitbelegungen und Gesprächscache kommen hinzu.
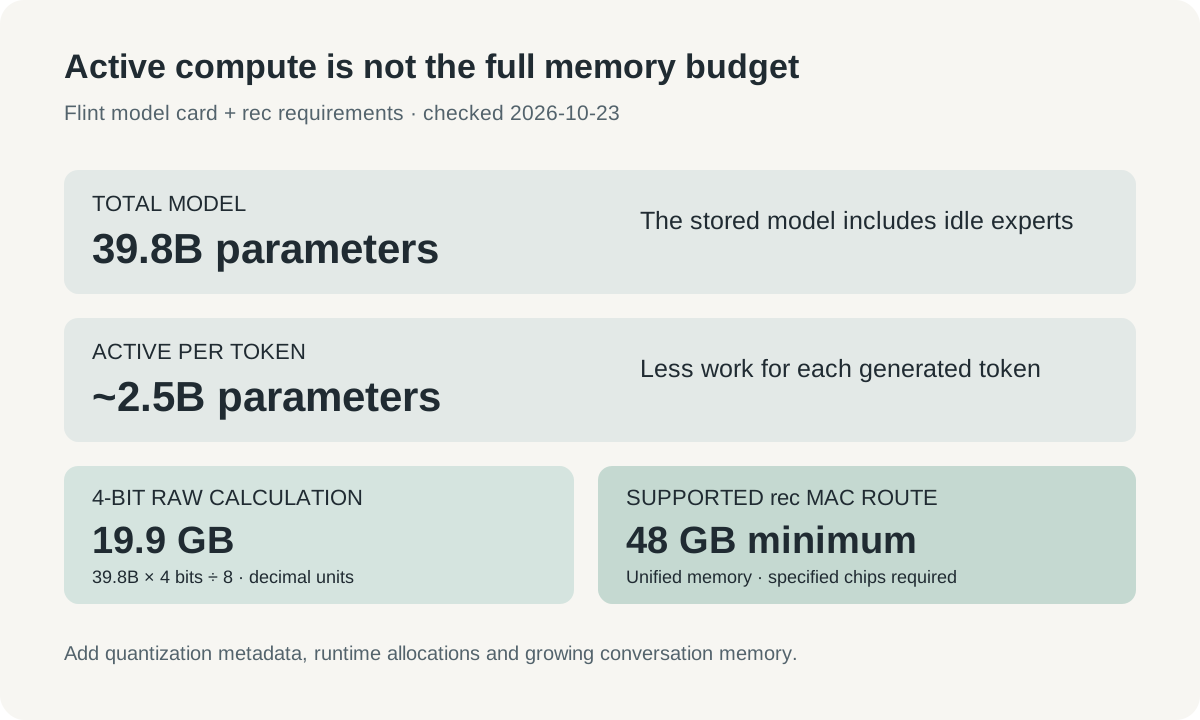
Eigene Infografik. Die Parameterbitrechnung ist beispielhaft; aktive Parameter legen den Gerätespeicher nicht fest. Laufzeit und Kontext benötigen zusätzlichen Speicher.
Mit wachsendem Gespräch wird der Unterschied wichtiger. Quelldateien, Anweisungen, Werkzeugdefinitionen, Befehlsausgaben und eigene Antworten verbrauchen Kontext. Ein großzügiges Maximum erlaubt mehr Material, garantiert aber weder gleiche Qualität bei jeder Länge noch kostenlose Verarbeitung langer Prompts. Die Aufgabe fokussiert zu halten bleibt eine sinnvolle technische Entscheidung.
Recursives aktuelle rec-Anforderungen nennen einen Mac mit M4 Pro, M5 Pro oder M5 Max, mindestens 48 GB gemeinsamem Speicher und etwa 30 GB freiem Laufwerksspeicher. Das gilt für diesen optimierten Laufzeitweg, nicht pauschal für alle Apple-Silicon-Rechner. Besitzer kleinerer Geräte sollten die Anforderungen einer anderen unterstützten Laufzeit prüfen, statt die aktive Parameterzahl als Kompatibilitätsrat zu lesen.
Geschwindigkeitsangaben brauchen Gerät und Kontextlänge
Recursive meldet auf der Einführungsseite mehr als 125 generierte Tokens pro Sekunde auf einem M4-Pro-MacBook-Pro bei kurzen Kontexten mit optimierter Engine. Das ist ein vom Unternehmen berichtetes Inferenzergebnis. Die Seite zeigt auch Programmierbewertungen, doch weder Durchsatz noch Benchmarkrang sagen voraus, wie schnell die eigene Testsuite läuft. Recursives Einführungsankündigung.
Der vLLM-Beitrag beschreibt eine andere Umgebung: einen einzelnen GB200, Dekodierung mit Batchgröße eins und 100.000 Tokens Kontext. Dort werden ungefähr 485 Tokens pro Sekunde von Anfang bis Ende berichtet. Server-GPU und Laptop gehören ohne Bedingungen nicht in dieselbe Vergleichszeile; Hardware und Inferenzstack leisten wesentliche Arbeit.
Zwischen Tokenproduktion und fertiger Aufgabe liegt ein weiterer Unterschied. Ein Modell kann mehr Überlegungen generieren, häufiger Werkzeuge aufrufen oder eine Reparatur wählen, die einen weiteren Versuch braucht. Schnellere Ausgabe hilft bei einem Generierungsengpass. Sie hilft weniger, wenn der längste Schritt ein zehnminütiger Integrationstest oder eine Folge falscher Änderungen ist.
Messen Sie im Alltag die Zeit bis zu einer geprüften Änderung, die die richtigen Tests besteht. Notieren Sie nötige menschliche Korrekturen und Eingriffe in unbeteiligtes Verhalten. Tokengeschwindigkeit bleibt eine nützliche Diagnose, gewünscht war aber ein korrekter Patch. Ein schneller Assistent auf wiederholt falschem Weg kann mehr vom Nachmittag verbrauchen.
| Entscheidung | Nützliche Belege | Was damit nicht geklärt ist |
|---|---|---|
| Kann das Gerät das Modell ausführen? | Unterstützter Chip, Speicher, Laufzeit und Checkpoint | Ob eine bestimmte Codebasis bequem hineinpasst |
| Reagiert die Generierung zügig? | Durchsatz bei benanntem Kontext und Hardwareaufbau | Gesamtzeit in Werkzeugen und Tests |
| Kann es diese Fehlerklasse reparieren? | Geprüfte Aufgabenergebnisse mit reproduzierbarem Test | Zuverlässigkeit in unbekannten Aufgabenkategorien |
| Erfüllt der Ablauf Datenschutzanforderungen? | Tatsächliche Endpunkte und Werkzeugrechte | Jede mögliche Aktion einer großzügig berechtigten Umgebung |
Mit einer begrenzten Reparatur statt einer ganzen Migration beginnen
Das erste sinnvolle Szenario ist ein gewöhnlicher Fehler in einem vertrauten Repository. Ein Parser verarbeitet beispielsweise eine leere Eingabe falsch. Flint soll die zuständige Funktion finden, ihr Verhalten erklären und vor der Implementierungsänderung einen Regressionstest ergänzen. Das ist ein beispielhafter Versuch, kein Bericht eigener Ausführung.
Diese Aufgabe gibt dem Assistenten ein kleines, sichtbares Ziel. Erwartetes Verhalten ist klar, betroffene Dateien sind begrenzt, Prüfer können erkennen, ob der Test den Fehler ausübt. Weicht das Modell zu umfassender Bereinigung ab, fällt das vor einem großen Patch auf. Lokale Generierung ermöglicht Iteration ohne API-Gebühr pro Anfrage, doch die Begrenzung verbessert weiterhin die Arbeit.
Ein zweites Szenario ist das Kennenlernen eines privaten Moduls. Fragen Sie nach einer Übersicht des Anfragewegs mit Dateiverweisen und prüfen Sie einige selbst. Anschließend folgt ein enger Auftrag wie eine fehlende Validierungsregel. Der Wert liegt im Gespräch über das tatsächliche Repository statt in einer allgemeinen Erklärung ohne dessen Verträge.
Ein drittes Szenario ist routinemäßige Testpflege. Ein Team kann Flint auf bekannte Fehler oder kleine Testlücken ansetzen und die erwarteten Ergebnisse bis zur Prüfung zurückhalten. Dazu gehört eine Aufgabe, bei der das aktuelle Verhalten absichtlich richtig ist. Unnötige Änderungen zu vermeiden ist Teil guter Entwicklung, auch wenn das weniger spektakulär als eine große generierte Funktion aussieht.
Diese Fälle unterscheiden sich bewusst im Ergebnis: Reparatur, Erklärung und Testentscheidung. Erfolg in einem Fall sollte das nächste Experiment bestimmen, statt als Beleg für die Verlagerung jeder Entwicklungsarbeit auf dasselbe lokale Modell zu dienen.
Ein unterstützter Mac hat einen kurzen Weg zur ersten Aufgabe
Die folgende Sequenz nutzt den veröffentlichten, am 23. Oktober geprüften rec-Ablauf. Voraussetzung sind ein unterstützter Mac und ein Repository, das Sie prüfen dürfen. Die Befehle sind Einrichtungsanweisungen für Leser, kein Beleg, dass wir das Modell installiert oder ausgeführt haben.
- Chip, freien Speicherplatz und Arbeitsspeicher mit den aktuellen Anforderungen abgleichen. In einem entbehrlichen Branch oder einer Kopie eines vertrauten Projekts beginnen, damit der Versuch gut prüfbar bleibt.
- Das offizielle rec-Repository öffnen, Installationshinweise und Installer prüfen und dem dokumentierten Weg folgen. Der erste Modelldownload benötigt Netzwerk, auch wenn spätere Inferenz lokal läuft.
- Installation prüfen, dann die empfohlene Umgebung aus dem Projektverzeichnis starten:
rec doctor
rec launch pi
- Eine konkrete Aufgabe mit erwartetem Verhalten, Umfang und Prüfbefehl geben. Beispiel: den fehlschlagenden Test für leere Eingabe erklären, gezielte Regression ergänzen und nur die zuständige Funktion ändern.
- Diff und tatsächliche Testausgabe prüfen. Danach Serverstatus kontrollieren und die Laufzeit stoppen, wenn sie keinen Speicher mehr belegen soll:
rec status
rec stop
Die Bequemlichkeit des Launchers sollte verstanden werden. Laut Recursive kann der Modellserver nach Schließen der Umgebung oder des Terminals weiterlaufen. Das Beenden der interaktiven Sitzung und das Freigeben des lokalen Modells sind getrennte Aktionen. Das zählt auf einem Rechner, der zugleich Builds, Browser und Alltagsanwendungen betreibt.
Generierungskonfiguration mit dem Ergebnis aufbewahren
Der Leitfaden zu Generierungseinstellungen empfiehlt zunächst temperature 1.0, top-p 0.95 und top-k 20. Er erklärt außerdem, dass Überlegungen das Ausgabebudget verbrauchen. Eine wegen des Limits abgebrochene Antwort ist ein anderes Problem als eine abgeschlossene falsche Antwort.
Nutzen Sie zur ersten Bewertung die mitgelieferte Launcher-Konfiguration. Bei einem späteren Wechsel von Laufzeit oder Präzision gehört die Änderung zum Ergebnisprotokoll. Sonst kann eine vermeintliche Modellverschlechterung tatsächlich aus einer falschen Chatvorlage, abgeschnittener Ausgabe oder einem unpassenden Werkzeugparser stammen.
Der vLLM-Beitrag dokumentiert Werkzeug- und Überlegungsparser im GLM-4.7-Stil für diesen Servingweg. Das zeigt konkret, weshalb ein Modell im Auswahlmenü nicht die ganze Integration ist. Die Anwendung muss Gesprächsstruktur erhalten und beabsichtigte Werkzeugaufrufe richtig ausführen. Eine gesunde Chatantwort belegt noch keine funktionierenden Dateiänderungen.
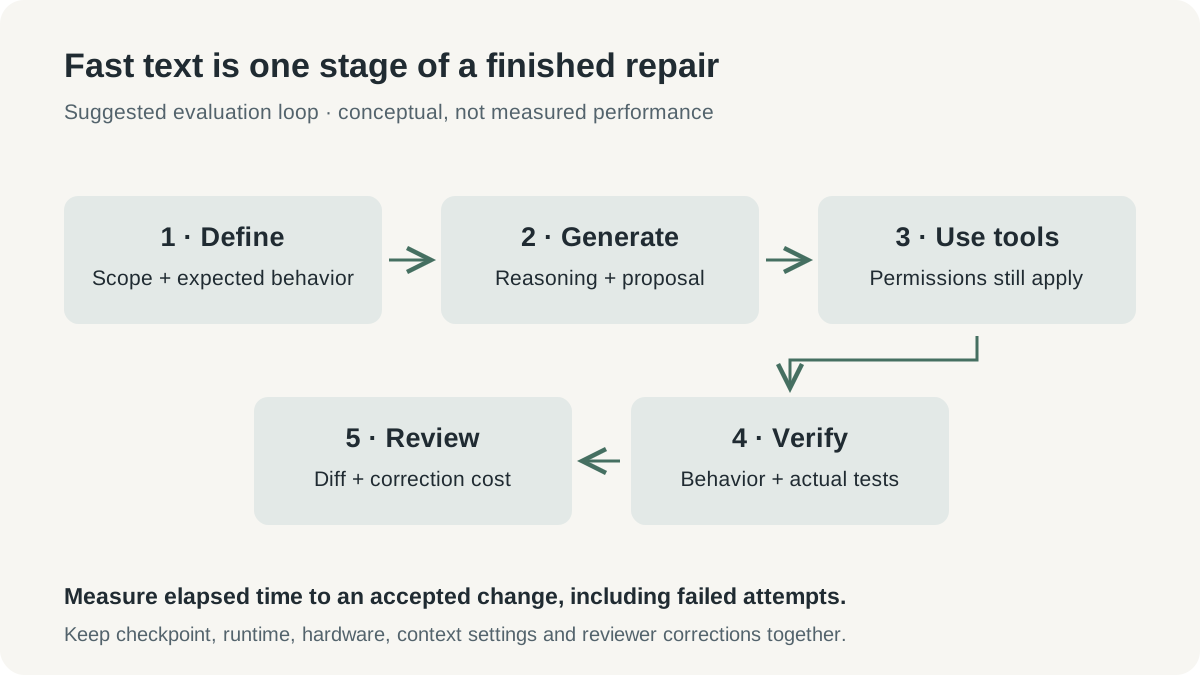
Eigener konzeptioneller Ablauf. Die letzte Prüfung betrifft ein geprüftes Aufgabenergebnis; die Grafik zeigt weder gemessene Leistung noch eine abgeschlossene Installation.
Eine Bewertungsnotiz kann kurz bleiben: Checkpointrevision, Laufzeitversion, Hardware, Kontext, Aufgabe, Dauer, Testergebnis und Korrekturen der Prüfer. Dieselben begrenzten Aufgaben nach einem Update zu wiederholen ist aufschlussreicher als Sitzungen mit verschiedenen Einstellungen und Zielen zu vergleichen. Fehlversuche gehören dazu, denn ihre Wiederherstellungskosten bestimmen den Nutzen.
Lokale Inferenz verändert die Rechnung, nicht das Vorhandensein von Kosten
Keine Inferenz-API-Gebühr zu zahlen ist bei wiederholter Arbeit auf vorhandener Hardware attraktiv. Teams, die häufig Code erklären oder kleine Tests erzeugen lassen, mögen planbare lokale Kapazität bevorzugen. Zur Rechnung gehören dennoch Installation, Pflege und Prüfung sowie die Opportunitätskosten des belegten Speichers.
Ein neuer speicherstarker Laptop allein für eine Veröffentlichung ist anders zu bewerten als ein Versuch auf einem vorhandenen unterstützten Rechner. Schätzen Sie die tatsächliche Arbeitslast, bevor Hardware als Ersparnis gilt. Beziehen Sie Aufgaben ein, die ein größeres gehostetes Modell mit weniger Korrekturen erledigt. Eine Aufteilung zwischen lokal und gehostet kann sinnvoll sein, wenn unterschiedliche Werkzeuge zu unterschiedlichen Aufgaben passen.
Auch Parallelität zählt. Die aktuelle rec-Dokumentation sagt, die Engine bearbeite eine Generierung zur selben Zeit; überlappende Anfragen können HTTP 429 erhalten. Ein gutes Einzelentwicklererlebnis verspricht deshalb keinen gemeinsamen Teamserver mit gleichem Verhalten. Mehrere Agenten sind eine andere Arbeitslast und benötigen möglicherweise eine andere Laufzeit.
Vielversprechend ist, dass lokales Programmieren zu einer vollständigen Ablaufoption wird. Flints geringe aktive Berechnung, verfügbare Gewichte und spezialisierte Laufzeit adressieren verschiedene Teile des Problems. Als Nächstes braucht es breitere Belege über abgeschlossene Reparaturen in normalen Projekten, stabile Laufzeitunterstützung und klares Verhalten in langen Sitzungen. Das macht aus einer beeindruckenden Demo ein verlässliches Alltagswerkzeug.
Die Workstation wird Teil des Programmierassistenten
Flint verlangt mehr als die Bewertung eines Modellscores. Speicherkapazität, Werkzeugrechte, Umgebung und Prüfgewohnheiten werden Teil des erlebten Assistenten. Das ist anspruchsvoll und bietet zugleich Kontrolle: Die Entwicklungsschleife lässt sich auf dem eigenen Rechner untersuchen und gestalten.
Beginnen Sie mit einer Aufgabe, deren Ergebnis Sie beurteilen können. Liefert die lokale Schleife wiederholt gute Änderungen bei tragbarem Prüfaufwand, ist ein nützliches Werkzeug gefunden. Die weitergehende Behauptung, es solle die nächste schwierigere Arbeitskategorie übernehmen, darf auf den nächsten Beleg warten.
Quellen
- Recursive: Introducing Flint, Einführungsankündigung; geprüft am 23. Oktober 2026. Die eigenständige Seite zeigt kein verlässliches Veröffentlichungsdatum.
- vLLM und Recursive: Day-0 Support for Flint, 21. Oktober 2026.
- Offizielle Flint-Modellkarte und Spezifikationen, geprüft am 23. Oktober 2026.
- Recursive: Flint-Dokumentation, rec-Einrichtung und Anforderungen sowie Generierungseinstellungen, geprüft am 23. Oktober 2026.
- Offizielles rec-Repository, geprüft am 23. Oktober 2026.
Die Gründe einer technischen Entscheidung aufbewahren
Wer Quellenlinks und geprüfte technische Notizen separat sammeln möchte, findet in Telli.sh eine Möglichkeit. Öffnen Sie Ihren Notizbereich.