O Qwen4-Max Preview lê vídeos. Ele consegue encontrar a cena certa?
Um vídeo longo de treinamento é um bom teste para o Qwen4-Max Preview. Confira se a resposta indica a cena correta e o que muda quando você usa um trecho mais curto.
Um vídeo de treinamento diz para arquivar um registro só depois de conferir o status de retenção. Quarenta minutos depois, outra demonstração abre a mesma tela e passa direto por ela. Uma pessoa em treinamento pergunta qual cena mostra a sequência completa. Uma resposta bem escrita é fácil de ler. O ponto exato do vídeo vale muito mais.
Em 11 de novembro de 2026, a QwenCloud iniciou uma prévia limitada do Qwen4-Max-Preview, modelo principal que aceita texto, imagem e vídeo. A documentação especifica um contexto de um milhão de tokens. A prévia está disponível só pelo Token Plan e tem fim previsto para 24h de 25 de novembro, UTC+8. Depois disso, a QwenCloud diz que vai retirar esse identificador de modelo. Documentação do modelo na QwenCloud
Um modelo assim permite fazer perguntas sobre uma gravação longa. O que vale testar é se ele leva alguém à passagem exata que sustenta a resposta. Um vídeo de treinamento permite separar três tarefas: encontrar a cena, entendê-la e relatar o que viu com clareza.
Uma janela longa dá mais cenas para o modelo investigar
A especificação de um milhão de tokens é um limite de contexto. Ela diz pouco sobre quanto detalhe útil um vídeo específico vai transmitir. O processamento de vídeo, a amostragem de quadros, os limites do arquivo, a rota da API e o restante da instrução influenciam o que entra no pedido. Duas gravações de mesma duração também podem exigir níveis de atenção muito diferentes. É mais difícil recuperar um estado de tela que pisca rapidamente do que uma seção visível por vários minutos. Consulte as regras de entrada de vídeo para o endpoint e o método que você usa.
A QwenCloud documenta saídas estruturadas e controles separados para a intensidade do raciocínio. Assim é possível pedir um objeto de resposta consistente e comparar configurações. Esses recursos dão um formato à afirmação e à marcação de tempo. A evidência vem da conferência do que o vídeo mostra naquele instante. Recursos do modelo na QwenCloud
Imagine um vídeo de treinamento de software de 50 minutos. A mesma caixa de arquivamento aparece duas vezes. Na demonstração relevante, a instrutora lê primeiro o campo de retenção e confere uma data antes de continuar. Na recapitulação, ela mostra onde abrir a caixa, mas não confere o campo. Uma resposta pertinente precisa identificar a demonstração completa e indicar a pista visível. Encontrar apenas o título da caixa pode levar a pessoa à cena errada.
Estruture a avaliação em torno dessa diferença. Para cada pergunta, peça a alguém que marque o intervalo válido, identifique a evidência visual e diga se só a transcrição bastaria para responder. Se dois intervalos contêm evidência suficiente, marque ambos como válidos. Isso evita punir uma passagem alternativa útil. Se a resposta depende da ordem de duas ações, anote o intervalo inteiro necessário para ver ambas.
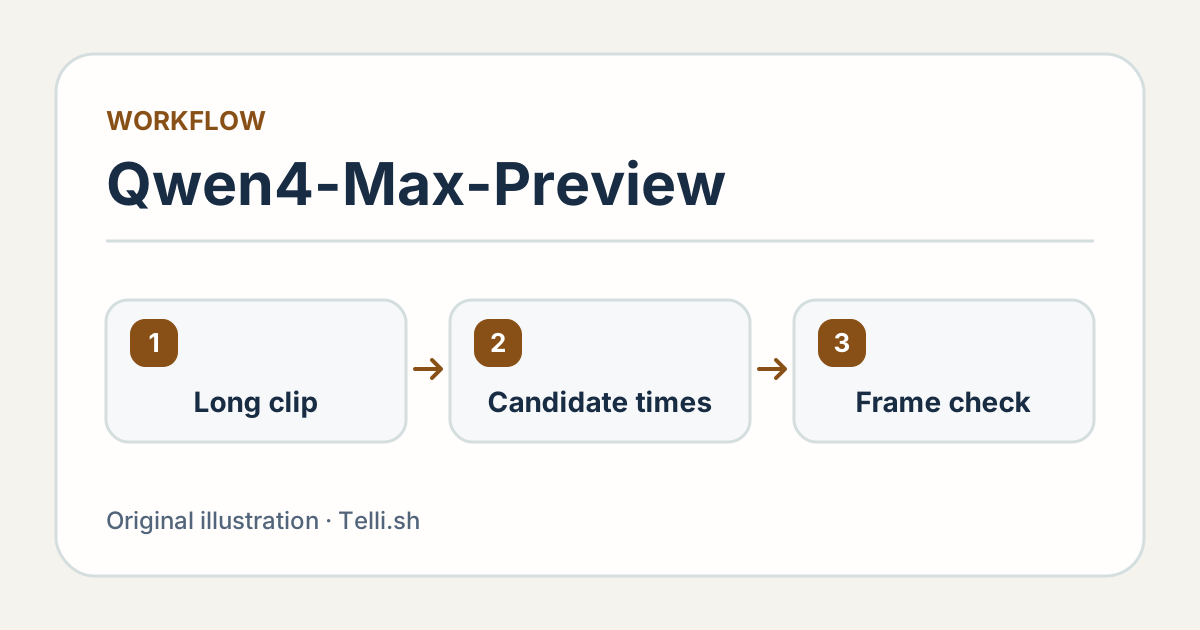
Uma marcação de tempo se torna útil quando você consegue abri-la e ver a evidência. Ilustração original da Telli.sh.
Peça uma resposta que alguém possa conferir
O objeto de resposta pode ser pequeno. Inclua a resposta, os tempos inicial e final no vídeo de origem, uma descrição breve da pista e um estado explícito para evidência insuficiente. A interface pode abrir o vídeo no começo do intervalo proposto. Peça à pessoa que confira a cena antes de ler a explicação gerada. Assim uma justificativa plausível tem menos chance de influenciar o julgamento.
O pedido pode ser direto: “Encontre a sequência completa de arquivamento. Devolva o início e o fim da cena, identifique o campo de status de retenção e diga se a data aparece antes da confirmação. Se a gravação não mostrar a sequência completa, informe que a evidência é insuficiente”. Os campos devem corresponder ao que alguém consegue ver. Evite pedir um número de “confiança” se não houver um jeito de confirmar se os valores acompanham resultados reais.
Faça perguntas sobre texto, ordem e ausência. Para texto, escolha um rótulo visível cujo sentido muda entre duas cenas. Para ordem, pergunte o que aparece antes ou depois de uma pista clara. Para ausência, pergunte por uma etapa plausível que o vídeo nunca mostra. Um modelo pode acertar perguntas comuns seguindo convenções conhecidas. Um exemplo negativo revela o que acontece quando essas convenções divergem da gravação.
A marcação de tempo também precisa de definição. Se o player começa em zero, mas a transcrição usa os códigos de tempo da gravação original, alinhe-os antes de pontuar a resposta. Ao cortar cinco minutos de um vídeo maior, guarde o deslocamento entre o tempo do trecho e o da fonte. Exportar 04:15 de um trecho e abrir 04:15 no original pode gerar um erro convincente mesmo quando o modelo encontrou o quadro certo.
Compare uma busca ampla e uma conferência curta com as mesmas perguntas
Há pelo menos dois caminhos. Envie o vídeo completo ao modelo e peça intervalos candidatos. Ou divida a gravação em capítulos conhecidos, use os títulos ou a transcrição para selecionar alguns e peça ao modelo que inspecione trechos menores. Comece com as mesmas perguntas e os mesmos intervalos anotados por pessoas. Compare os métodos antes de decidir se uma solicitação maior compensa em tempo e custo.
| Método | Para que ajuda | O que conferir |
|---|---|---|
| Vídeo inteiro numa solicitação | Uma ação que se repete em cenas distantes | Ocorrência correta, latência total e respostas incompletas |
| Busca por capítulo seguida de trecho curto | Um assunto conhecido com detalhes visuais pequenos | Erros de seleção de capítulo e deslocamento de tempo |
| Transcrição antes da conferência visual | Um processo narrado com confirmação na tela | Se o que se diz corresponde ao que se faz |
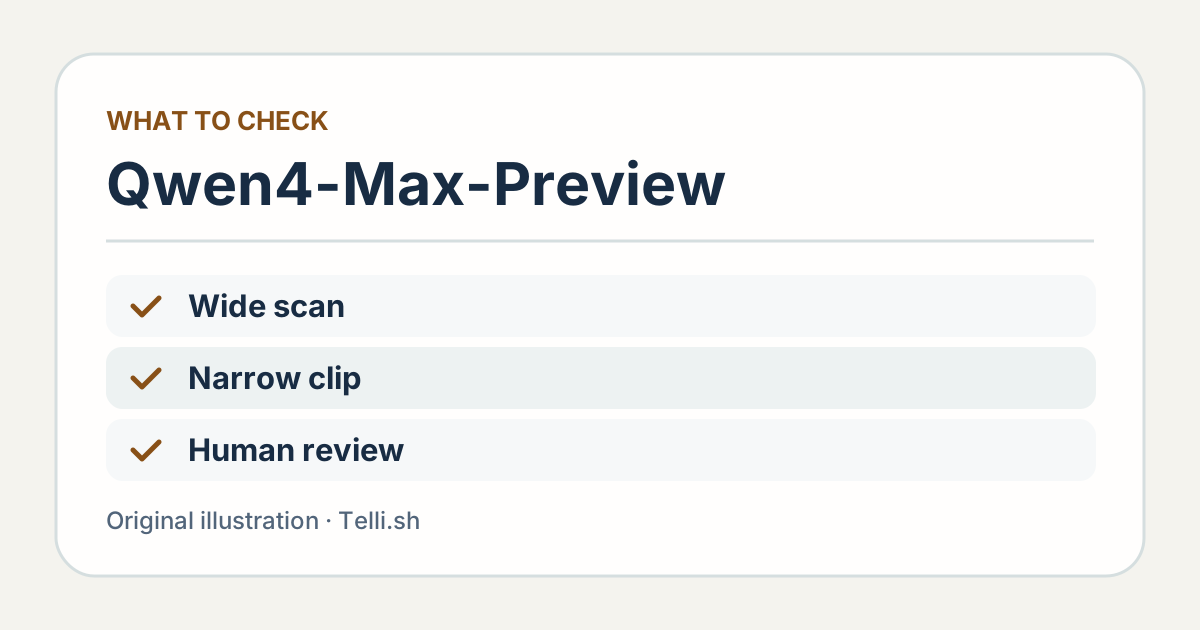
Use um único conjunto de cenas de referência para comparar os caminhos de busca. Ilustração original da Telli.sh.
O caminho curto pode custar menos, mas pode falhar na seleção antes de o modelo sequer ver a evidência. O vídeo inteiro pode recuperar uma cena num capítulo inesperado. Também pode acertar a seção e perder a pista exata. Registre o tipo de cada falha. Se a busca falhou, melhore a seleção de capítulos. Se faltou evidência, melhore a entrada visual ou a revisão. Se o tempo da fonte está errado, corrija o player ou a conversão.
A avaliação fica mais clara se você separar localizar a cena de responder por completo. Marque se o intervalo indicado coincide em parte com uma cena de referência válida. Depois confira se a resposta identifica o campo visível e a ordem das ações. Defina antes a margem de tempo aceitável, como dez segundos para uma demonstração lenta. Uma transição rápida pode exigir uma margem bem menor. Guarde essas regras para medir outros modelos da mesma forma.
Meça o tempo desde a pergunta até o momento em que a pessoa consegue reproduzir a evidência. Uma explicação rápida sem intervalo utilizável obriga a fazer outra busca. Separe o primeiro resultado utilizável do tempo total. Para uma resposta importante, pode valer abrir os dois primeiros candidatos. Para uma dúvida de rotina, a resposta certa com um link para a evidência pode bastar.
Três vídeos parecidos podem revelar três erros diferentes
Monte um conjunto pequeno com uma dificuldade clara por gravação. Na primeira demonstração narrada, faça as instruções faladas coincidirem com as ações visíveis. Na segunda, mostre uma sequência de botões diferente da que a pessoa descreve. Na terceira, coloque uma cena parecida no começo e a correta perto do fim. O modelo pode acertar um tutorial comum e ainda falhar justamente no caso em que alguém precisa de ajuda.
Use uma tarefa cuja resposta depende de uma pista visual precisa. No segundo vídeo, a narração manda clicar em Enviar, mas o botão na tela diz Salvar como rascunho e o documento nunca entra na fila de revisão. Para quem precisa enviar um documento, a diferença importa. Separe o que a pessoa recomendou do que aconteceu. Marque o campo que revela o estado final como a evidência a buscar. A marcação certa deve abrir cedo o bastante para mostrar por que a tela mudou.
Dê uma tabela de decisão à pessoa que revisa. Intervalo certo com interpretação errada conta como erro de leitura. Interpretação certa ligada a outra cena é erro de busca. Informar falta de evidência está certo num trecho incompleto de propósito e errado quando há uma sequência claramente marcada. Conte esses casos para o modelo não melhorar a nota recusando todas as perguntas difíceis. Use a mesma pontuação em cada variante.
Confira a legibilidade antes de tirar conclusões quando o texto na tela não for encontrado. Abra o arquivo exato enviado no tamanho esperado e compare com os quadros que a pessoa consegue ver. A compressão pode tornar um status ilegível antes que o modelo o receba. Experimente um trecho recortado quando a solicitação ampla sempre encontra o capítulo e perde um detalhe pequeno. Assim você vê se mais detalhe visual local ajuda mais do que enviar tudo de novo.
Para equipes de treinamento, também há um limite editorial para o quão curto deve ser o intervalo. Cinco segundos podem mostrar o estado final e omitir a decisão que o precedeu. Anote se a pessoa precisa ver a escolha no menu, o aviso ou a confirmação. Isso permite que a interface abra uma passagem que explique a tarefa e comprove a resposta.
Use a prévia como período de avaliação
A QwenCloud identifica o modelo como qwen4-max-preview. A página indica acesso pelo Token Plan e diz que a prévia não está disponível na modalidade de pagamento por uso. O provedor documenta compatibilidade com Chat Completions e Responses no estilo da OpenAI e Messages no estilo da Anthropic. Confira as regras de entrada visual do protocolo escolhido antes de reaproveitar um cliente que só trabalha com texto. Acesso à prévia da QwenCloud
A QwenCloud também documenta uma saída máxima de 393.216 tokens, compartilhada entre raciocínio e resposta final. Na interface compatível com Chat Completions, o orçamento máximo de conclusão inclui os dois. Nesta avaliação, peça uma resposta concisa e monitore resultados incompletos. Uma saída longa pouco ajuda quem procura uma cena de vinte segundos. Ao comparar configurações de raciocínio, mantenha vídeo, perguntas e regras de validação constantes para separar o tamanho da entrada da qualidade do raciocínio.
Escolha um vídeo que você tenha autorização para enviar. Um tutorial sintético ou um vídeo de treinamento público basta para testar a busca de evidências. Ele pode incluir duas demonstrações parecidas com uma diferença planejada, sem dados de clientes nem procedimentos internos. Antes de incluir gravações de trabalho, confira os termos atuais do provedor e a permissão da equipe para enviar o material.
Documente a avaliação de modo que ela sobreviva à prévia. Guarde referências dos arquivos, limites dos capítulos, intervalos de referência, perguntas e decisões de pontuação com a data e o identificador do modelo. Mantenha os vídeos no armazenamento autorizado da equipe. Se precisar comparar o substituto, já terá o que mais custa reconstruir: um conjunto de exemplos conferidos.
O link para a evidência faz parte da interface
Uma janela longa torna razoável testar outra forma de localizar uma cena. Um intervalo preciso e reproduzível torna o resultado útil para a próxima pessoa. Para uma equipe de treinamento, o teste mais útil verifica se alguém chega à cena certa e entende a ação sem rever a aula inteira. O mesmo teste continua válido quando a prévia terminar.
Fontes
- Especificações, protocolos e período de prévia da QwenCloud
- Guia de desenvolvimento e documentação de entrada visual da QwenCloud
Para encontrar suas notas de treinamento e as decisões que elas embasam, crie uma conta na Telli.sh.