[AI创意笔记 04] 从Jev式决策走向图像:认识基于Qwen的小模型QEV
为什么Qwen周围开始出现视觉决策模型,Jev实验性图像支持带来什么变化,以及本地2B级QEV项目的位置。
AI创意笔记探索新兴AI模型与工具背后的思路,以及它们在实际应用中的可能性。
一张照片进入分拣流程。应用需要在塑料、玻璃和金属之间选择,检查物品是否属于给定类别,并返回软件能使用的值。一段流畅的瓶子描述或许有趣,却让模型与决策之间仍隔着一步。
Jev让另一种接口受到关注:提供情境、问题和允许的答案,得到带概率的结构化决策。接下来的问题很自然:它能否不仅处理模型读到的内容,也处理看到的内容?
现在已有几种实现。TypeSafe于2026年10月14日为Jev推出实验性图像支持;独立项目也在把Qwen视觉语言骨干适配为Jev式决策。其中就有QEV:基于Qwen3.5-2B的本地模型,提供选择、有序评分、布尔判断和弃答。Jev公告、QEV仓库
作者披露:QEV是本文作者独立维护的项目。本文区分已发布版本与仅源码具备的功能,采用公开文档及已有记录示例,并非新的独立模型评估。
 QEV的公开仓库,摄于2026年10月20日。这是文档画面,不是本地推理演示。
决策模型为何不同于聊天机器人
聊天机器人通常逐token写出答案。应用已知道答案形状时,决策模型更有用,例如选择目的地、按有序尺度评价条件,或判断陈述是否成立。
答案选项可以随请求变化。客服系统今天提供账单与技术支持,明天可能加入账号恢复。视觉分拣的一题可提供六种材质描述,另一题则提供不同处理规则。模型必须将当前证据与这些描述关联,而不是从永久训练好的标签表中选一个。
Jev常见的基础类型是choice、score和noul。QEV的choice返回给定候选的概率分布;score使用有序层级,返回其概率及期望层级;noul使用真与假的判定条件。即使共享底层模型,这些也是不同的输出约定。QEV API参考
概率让边界可见:两个候选只差一点,就可以转人工复核,而非自动执行。但概率不保证决策正确。应用仍须制定处理不确定性、不适合输入和误判成本的策略。
Jev已经有实验性图像路径
历史动机需要更新。如果介绍QEV时说Jev目前不能接收图像,会造成误导。TypeSafe的10月公告通过TypeSafe-Danger-Zone-Images请求头,为Jev 1.13和1.14启用实验性图像输入;1.14还加入空间型Box。公告明确这些图像功能仍属实验。Jev 1.14公告
这改变了比较方式。真正有用的问题,是哪种部署、输入约定和决策行为适合具体流程。托管Jev实验、研究模型和本地Qwen适配版,可以共享受约束决策的思路,但封装及支持操作差别很大。
QEV没有文档说明的Jev Box等价物。它是独立实现,不是TypeSafe权重,也不是官方Jev版本。类型名或SystemOne式端点相似,是集成起点,不证明所有请求都能原样迁移。
为什么这些项目会选择Qwen
视觉语言骨干已将文本与图像信息带进同一个模型,为决策项目提供实际起点:保留视觉理解,再调整模型如何把证据与应用提供的答案关联起来。
两个公开例子说明,这不只是单个仓库的方向:
| 项目 | 公开描述的方法 | 如何理解其状态 |
|---|---|---|
| PixelJev | 用小型Qwen3.5骨干研究Jev式视觉选择,包括2B和4B | 关于视觉选择的论文,不证明具备完整托管Jev替代能力 |
| AutoTrust JEV-27B-VL | 使用Qwen3.8-27B、决策头与适配器 | 独立的大模型;模型卡区分文本训练的决策行为与零样本图像使用 |
| QEV | 把Qwen3.5-2B适配为choice、score和noul判断 | 本地2B级项目,有已发布SDK及单独说明的源码扩展 |
PixelJev论文有助于理解架构思路:把图像与运行时给定候选接入决策读出。AutoTrust模型卡展示另一种规模,同时指出尚未建立系统性的视觉校准。这些是新兴设计模式的例子,不是基准排名,也不是兼容性相同的产品清单。PixelJev论文、AutoTrust模型卡
QEV在这幅图景中的位置,是紧凑的本地部署。“小”指相对于更大视觉语言模型的骨干级别,不意味着整个安装只有几MB,或能在任何设备上瞬间运行。
QEV怎样把图像变成决策
QEV使用一个Qwen3.5-2B文本视觉骨干。公开架构增加语言侧适配,以及把情境、问题与候选描述绑定的读出。它直接为候选评分,不先生成回答句,再交给另一个解析器抽取标签。公开模型卡
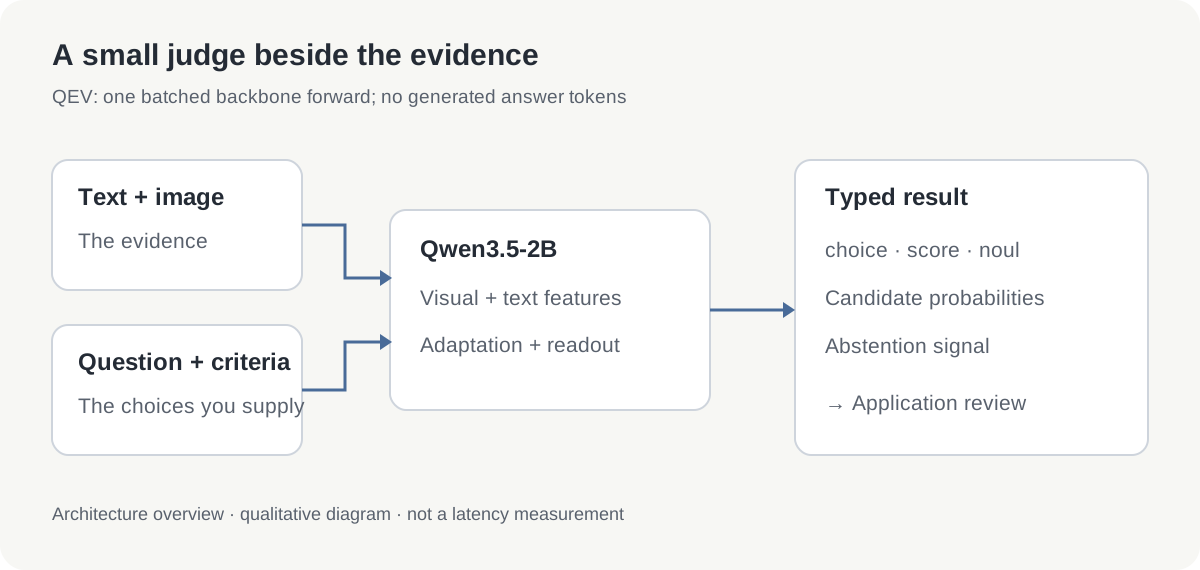 原创示意图。箭头说明文档中的决策路径,不是速度实测比较。
已发布SDK的一个请求可以包含文本、一张图像或两者。它支持一至四个问题,choice有二至十六个候选,score有二至十六个有序层级。因此一小组相关判断可以共用请求,不必每题另开聊天。API参考
例如给照片附一句“按以下描述选择材质”。第二题可以问适用哪个策略档,第三题问是否满足布尔条件。照片是共同证据,条件则定义每项判断的含义。
文档中的推理路径不生成答案token。这能减少格式变化,却没有消除视觉编码器、骨干计算、图像预处理或应用开销。“不生成答案”和“没有计算成本”,是完全不同的说法。
瓶子示例,就当作示例来看
QEV仓库含有一张具有许可的塑料瓶照片和记录输出。安装前,它能直观展示响应结构。
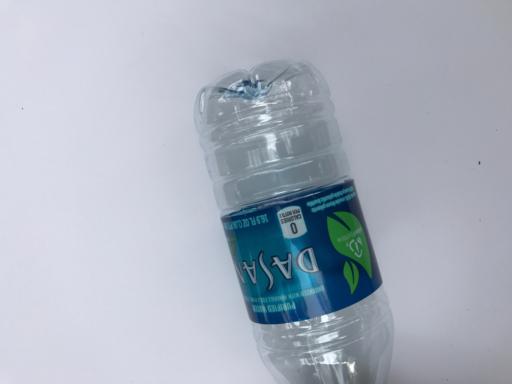 来自QEV照片样例的公开输入,原始来源为TrashNet。Copyright 2017 Gary Thung,MIT许可;已保留许可声明。
| 公开样例的问题 | 记录结果 | 含义 |
|---|---|---|
| 从六种材质中选择 | 塑料,概率约0.9361 | 塑料在给定候选中占最大概率 |
| 选择有序策略档 | 0–2尺度的期望层级约0.4254 | 三个给定档位索引的加权平均 |
| 是否属于玻璃、纸或塑料? | 真,概率约0.7903 | 布尔条件比其假选项更受支持 |
score需要特别注意。这个样例里,档0包含玻璃与塑料,档1包含金属与垃圾,档2包含纸板与纸。这是示例策略的排序。0.4254不是安全评级、回收标准,也不是材质选择的置信度。
同样,塑料概率只描述当前请求及其候选,不能证明所有瓶子照片中有93.61%能正确分类。这是以前检查过的发布样例,不是新的留出测试;上述输出来自项目已有记录,并非本文复现。
这里的“兼容Jev”应该怎样理解
分层理解兼容性最清楚:请求定义决策的共同思路、精确JSON结构、支持的输入,以及每种输出的行为。一层匹配,不代表其他层自动匹配。
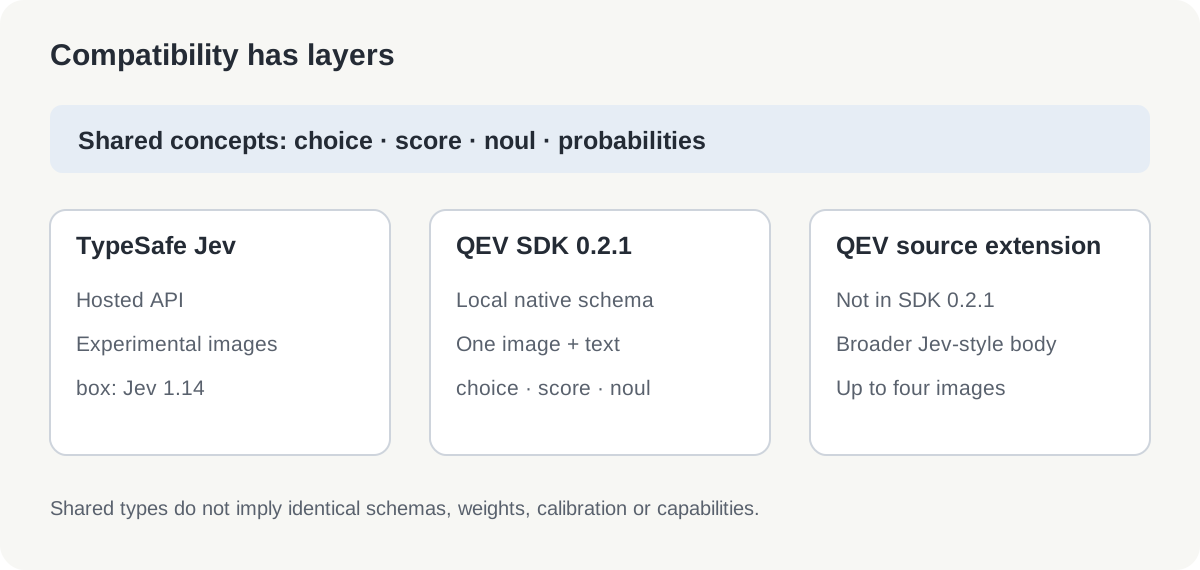 原创兼容性图,核对于2026年10月20日。源码扩展与打包SDK约定分开。
打包的QEV 0.2.1使用QEV原生请求结构,以及一张可选图像。公开源码还说明更广的Jev/SystemOne式请求处理和最多四张有序图像,不能假定这些扩展也存在于已发布0.2.1包中。API与版本说明、0.2.1版本
集成时,从一个已知请求开始,比较验证、答案字段、候选顺序和不确定性行为。仅有熟悉的/v1/systemone路由,不代表能通用地直接替换TypeSafe服务或SDK。
实际上手,可以先看本地界面
初次探索,本地playground比应用集成更容易检查。
- 准备并激活Python 3.12环境。
- 用下列命令安装固定版本,启动playground。
- 打开
http://127.0.0.1:7860,选择示例,检查候选概率与弃答。
python -m pip install qev==0.2.1
qev playground
文档中的playground在http://127.0.0.1:7860本地运行,包含示例照片,展示概率、弃答和结构化输出。界面与文档为英语。这些是发布版本的安装说明,不代表本文安装或计时过模型。Playground指南
一个小型文本请求可以展示原生SDK的形状:
from qev import DecisionRequest, load

model = load()
request = DecisionRequest.model_validate({
    "state": {
        "text": "I was charged twice. Please refund the duplicate payment."
    },
    "questions": {
        "department": {
            "type": "choice",
            "instructions": "Which team should handle this request?",
            "criteria": {
                "billing": "Payments and refunds",
                "technical": "Software faults"
            }
        }
    }
})
print(model.predict(request)["answers"])
先用两三个明显不同的候选,再试歧义案例和不属于任何候选的案例。检查弃答与应用策略是否产生有用结果。图像测试应使用你有权处理的照片,并根据可见证据写条件,不要询问图像无法证明的事实。
要为骨干预算,不只看适配器
上面的旧SDK 0.2.1路径中,QEV适配检查点约32.01 MB,还需单独下载约4.55 GB的Qwen骨干。公开明细列出约22.13亿骨干参数和799.2万适配、读出参数。下文10月QEV-0.8B与QEV-2B检查点使用另一条版本加载路径。SDK模型大小明细
因此首次准备涉及数GB。之后可使用缓存,但运行内存还包含激活、图像处理与缓冲区;公开GPU和CPU路径采用不同数值精度。检查点字节数适合规划存储,不承诺特定机器的内存、吞吐量或电池消耗。
如果2B让电脑吃力,可以尝试QEV-0.8B
10月发布包括基于Qwen3.5-0.8B的QEV-0.8B,与新版QEV-2B使用同一教师蒸馏。GPU内存或响应时间让2B不合适时,它是实际的起点。小模型保留请求定义决策,但以部分视觉决策质量换取更低资源使用。0.8B模型卡、2B模型卡
| 公开测量项 | QEV-0.8B | 10月QEV-2B | 差距 |
|---|---|---|---|
| 公开视觉Decision Index,accurate模式 | 53.02 | 61.99 | 2B领先8.97个指数点 |
| GPU峰值分配,accurate模式 | 1.86 GiB | 4.44 GiB | 0.8B约少58% |
| 各请求配置p50延迟的中位数 | 66.0 ms | 135.3 ms | 0.8B约低51% |
| 最高的请求配置p95延迟 | 377.3 ms | 738.6 ms | 0.8B约低49% |
| GPU峰值分配,fast模式 | 1.60 GiB | 4.13 GiB | 0.8B少2.53 GiB |
| RealWorldQA分数 | 39.2 | 56.2 | 2B领先17.0点 |
| Winoground分数 | 47.5 | 65.5 | 2B领先18.0点 |
| InfographicVQA分数 | 75.4 | 83.1 | 2B领先7.7点 |
以上为开发者测量,于2026年10月20日核对。指数使用公开vision kit 0.3.2自评分,尚待官方运行,并非总体准确率百分比。8.97点差距的配对自助法区间为7.39–10.48点。各基准也显示差距随任务而变。
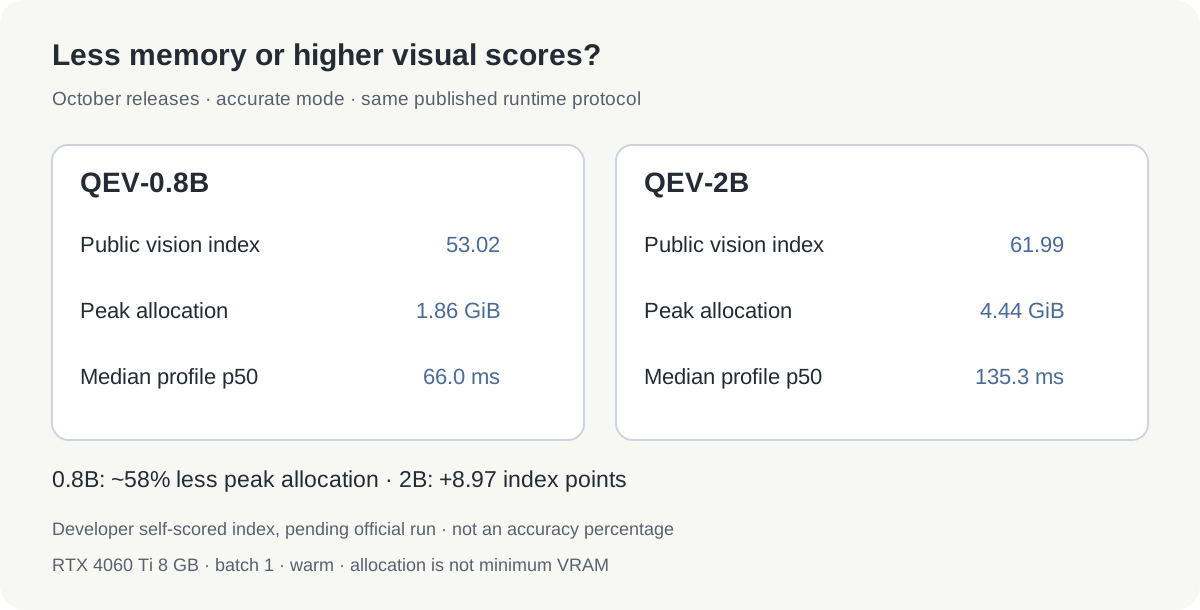 根据两个固定版本模型卡制作的原创比较图。指数为自评分,内存与耗时是实测GPU上accurate模式的结果。
运行测量使用RTX 4060 Ti 8 GB、批量1、预热模型和47种请求配置,每种先预热3次,再计时30次。accurate模式允许每张图最多1.6 MP。内存是PyTorch峰值分配,不是显卡最低容量:驱动、其他应用和不同输入仍需余量。计时不含下载和加载,也不能预测CPU性能。
fast模式将图像限制为0.26 MP,并在24层中的第16层退出。0.8B的p50中位数降至44.6 ms,最慢配置p95降至123.2 ms。内部DEV准确率从accurate的86.0%降到82.0%,尤其影响文档、图表和屏幕输入。fast没有公开Decision Index,53.02属于accurate模式。
这些检查点应使用独立Python 3.12环境。旧qev==0.2.1包不能加载0.8B版本:
python -m pip install "qev @ git+https://github.com/ken-jo/qev@986a2d6d7b7e1583458b4006c9b88d6269dfa84a" huggingface_hub
from huggingface_hub import snapshot_download
import qev

path = snapshot_download(
    "ken-jo/QEV-0.8B",
    revision="def58ea5c773bb2e5bf53c428c6a1c76c6e55ceb",
)
model = qev.QEV.load(path, device="cuda")
# To reduce image resolution and depth further:
# model = qev.QEV.load(path, device="cuda", mode="fast")
像前例一样,通过model.predict(request)提交DecisionRequest。先试0.8B accurate,资源仍紧张再试fast。当代表性输入的错误值得用额外内存和时间解决时,再换2B;比较时保持输入和候选描述一致。
在哪里试用,以及证据到哪里为止
好的首试任务有可见证据,后果也有边界:把文档图像分到复核队列、分类物品照片,或从给定处理说明中选最合适的一项。测量模型是否有帮助时,保留人工复核路径。
调整提示前选一组小而有代表性的输入,记录被接受回答的准确率、弃答率和仍通过的错误。改变光线、图像质量和语言重复评估。QEV继承骨干的多语言输入能力,但公开准确率与校准证据以英语为主;韩语或其他语言是否相当,应测试而非假定。公开模型卡
旧SDK模型评估也限定了期待:2,000道类型化决策题中,QEV为77.00%,文本专家LAYA为76.95%,仅差一题,配对置信区间跨越零。这不能证明普遍准确率优势,也不是与托管Jev直接比较。它们与上面的10月检查点比较是不同结果。纯文本专门化在自身设置下也可能更快。比较方法与结果
视觉推理仍不均衡。项目探索性的2048评估报告,72次尝试没有成功游戏。能识别照片材质的紧凑模型,不自动等于可靠的空间规划器。评估笔记
当本地运行、小骨干与明确决策输出同时重要时,QEV值得探索。Jev实验性图像路径及其他Qwen项目,让更广的方向变得清楚:更多应用可以要求模型对图像作受约束判断,再用普通软件决定如何处理该判断。
来源
来源核对于2026年10月20日。上文架构、示例与版本边界参考QEV固定版本公开源码和SDK 0.2.1。更广背景来自TypeSafe的Jev公告、PixelJev论文与AutoTrust模型卡。头图是QEV公开README的编辑性截图;媒体来源与权利另有记录。
把原始证据与决策一起保存,才能重新检查错误分类或变化的政策。创建Telli.sh账号,把来源资料、笔记与后续研究汇集到一个可搜索的工作区。