[Caderno de ideias de IA 04] Das decisões ao estilo Jev às imagens: conheça o QEV, um pequeno modelo baseado em Qwen
Por que estão surgindo modelos de decisão visual baseados em Qwen, o que muda com o suporte experimental de imagens do Jev e onde se encaixa o projeto local QEV da classe 2B.
Caderno de ideias de IA explora as ideias e as possibilidades práticas de modelos e ferramentas de IA que estão surgindo.
Uma fotografia chega a um fluxo de separação de materiais. A aplicação precisa escolher entre plástico, vidro e metal, verificar se o item pertence a uma categoria fornecida e devolver um valor que o software consiga usar. Um parágrafo fluente descrevendo a garrafa pode ser interessante, mas ainda deixa uma etapa entre o modelo e a decisão.
O Jev chamou atenção para outra interface: fornecer ao modelo uma situação, uma pergunta e as respostas permitidas e receber uma decisão estruturada com probabilidades. A próxima pergunta é natural: essa interface pode trabalhar com o que o modelo vê, além do que lê?
Agora pode, de várias formas. A TypeSafe apresentou suporte experimental de imagens para o Jev em 14 de outubro de 2026. Projetos independentes também estão adaptando bases de visão e linguagem Qwen a decisões ao estilo Jev. Entre eles está o QEV, um modelo local baseado em Qwen3.5-2B que oferece escolhas, pontuações ordenadas, decisões booleanas e abstenção. Anúncio do Jev, repositório do QEV
Declaração do autor: o QEV é um projeto independente mantido pelo autor deste artigo. Esta introdução separa a versão publicada das funções disponíveis apenas no código-fonte e usa documentação pública e exemplos registrados; não apresenta uma nova avaliação independente do modelo.
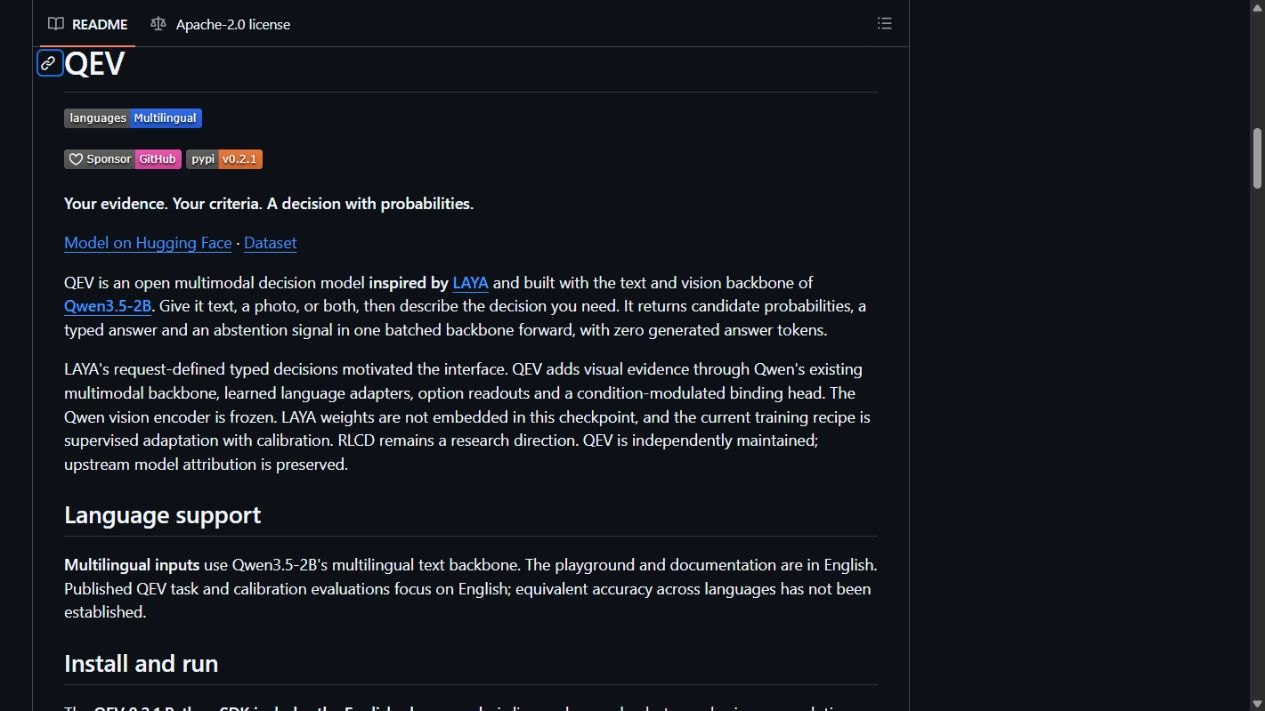 Repositório público do QEV, capturado em 20 de outubro de 2026. É uma tela de documentação, não uma demonstração de inferência local.
Por que um modelo de decisão é diferente de um chatbot
Um chatbot geralmente escreve uma resposta token a token. Um modelo de decisão é útil quando a aplicação já conhece o formato da resposta: selecionar um destino, classificar uma condição em uma escala ordenada ou decidir se uma afirmação é verdadeira.
As opções podem mudar a cada solicitação. Um sistema de atendimento pode oferecer financeiro e suporte técnico hoje e acrescentar recuperação de conta amanhã. Um fluxo visual pode fornecer seis descrições de materiais para uma pergunta e outras regras de manuseio para a seguinte. O modelo precisa relacionar as evidências atuais a essas descrições, em vez de escolher de uma lista fixa de rótulos treinados.
As primitivas conhecidas do Jev são choice, score e noul. No QEV, uma escolha retorna uma distribuição entre os candidatos fornecidos. Uma pontuação usa níveis ordenados fornecidos e retorna suas probabilidades e o nível esperado. Uma pergunta noul usa critérios de verdadeiro e falso. São contratos de saída diferentes, mesmo compartilhando o mesmo modelo. Referência da API do QEV
As probabilidades tornam o limite visível: uma pequena vantagem entre candidatos pode encaminhar a revisão em vez de uma ação automática. Elas não tornam a decisão correta. A aplicação ainda precisa de uma política para incerteza, entradas inadequadas e custo de erro.
O Jev já tem uma rota experimental para imagens
A motivação histórica precisa ser atualizada. Seria enganoso apresentar o QEV dizendo que o Jev atualmente não aceita imagens. O anúncio de outubro da TypeSafe habilita entrada experimental de imagens no Jev 1.13 e 1.14, pelo cabeçalho TypeSafe-Danger-Zone-Images. O Jev 1.14 também acrescenta a primitiva espacial Box. O anúncio descreve esses recursos visuais como experimentais. Anúncio do Jev 1.14
Isso muda a comparação. A pergunta útil é qual implantação, contrato de entrada e comportamento de decisão atendem a determinado fluxo. Um experimento hospedado no Jev, um modelo de pesquisa e uma adaptação local do Qwen podem compartilhar decisões delimitadas e diferir bastante em empacotamento e operações suportadas.
O QEV não tem equivalente documentado da primitiva Box. É uma implementação independente, não os pesos da TypeSafe nem uma versão oficial do Jev. Compartilhar nomes de primitivas ou um endpoint ao estilo SystemOne é um ponto de partida para integração, não uma prova de que toda solicitação funciona sem alterações entre produtos.
Por que o Qwen aparece nesses projetos
Uma base de visão e linguagem já combina informações de texto e imagem no mesmo modelo. Isso oferece um começo prático a um projeto de decisão: conservar a compreensão visual e adaptar a maneira como o modelo relaciona evidências às respostas fornecidas pela aplicação.
Dois exemplos públicos mostram que a direção vai além de um repositório:
| Projeto | Abordagem descrita publicamente | Como interpretar seu estágio |
|---|---|---|
| PixelJev | Estuda escolhas visuais ao estilo Jev com bases Qwen3.5 pequenas, incluindo variantes 2B e 4B | Artigo de pesquisa sobre escolha visual; não comprova uma substituição hospedada e completa do Jev |
| AutoTrust JEV-27B-VL | Usa Qwen3.8-27B com uma cabeça de decisão e adaptadores | Modelo independente maior; sua documentação distingue decisões treinadas em texto do uso de imagens zero-shot |
| QEV | Adapta Qwen3.5-2B para decisões choice, score e noul | Projeto local da classe 2B com SDK lançado e extensões de código-fonte documentadas separadamente |
O artigo do PixelJev ajuda a entender a arquitetura: conectar imagens e candidatos fornecidos em tempo de execução a uma leitura de decisão. A documentação do AutoTrust ilustra outra escala e observa que não há calibração visual sistemática estabelecida. São exemplos de um padrão emergente de projeto, não uma classificação de benchmarks nem uma lista de produtos igualmente compatíveis. Artigo do PixelJev, documentação do AutoTrust
O lugar do QEV nesse cenário é a implantação local compacta. “Pequeno” descreve a classe da base em relação a modelos visuais muito maiores; não significa uma instalação inteira de poucos megabytes nem execução instantânea em qualquer dispositivo.
Como o QEV transforma uma imagem em decisão
O QEV usa uma única base Qwen3.5-2B de texto e visão. Sua arquitetura publicada acrescenta adaptação na parte de linguagem e uma leitura que relaciona situação e pergunta às descrições dos candidatos. O modelo pontua diretamente os candidatos, em vez de gerar uma frase e pedir a outro analisador que extraia o rótulo. Documentação pública do modelo
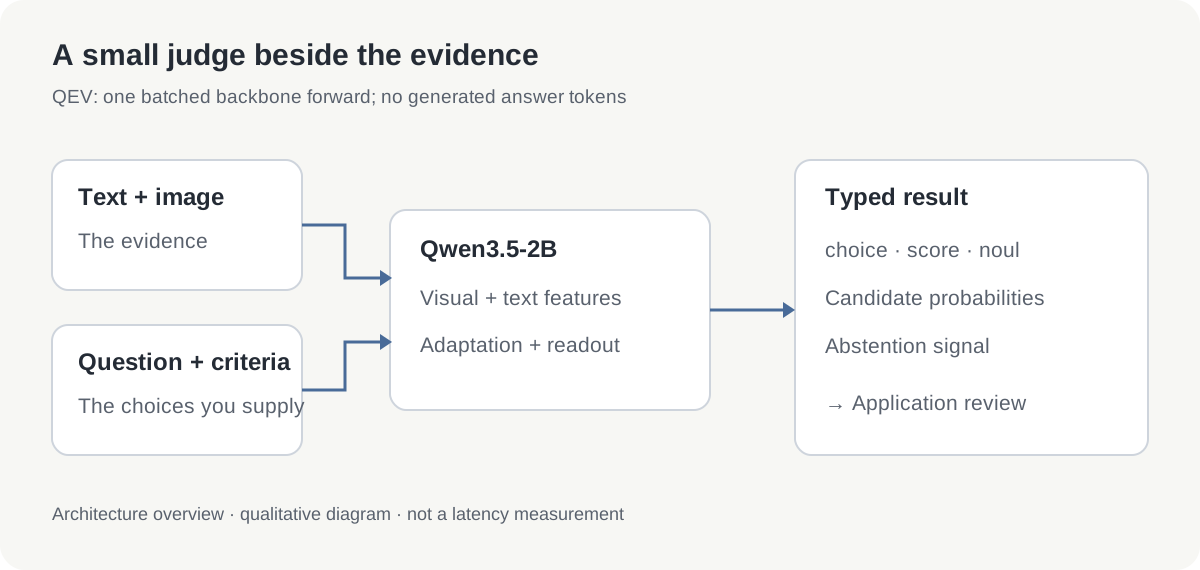 Diagrama explicativo original. As setas descrevem o caminho documentado de decisão, não uma comparação medida de velocidade.
No SDK lançado, uma solicitação pode conter texto, uma imagem ou ambos. Aceita de uma a quatro perguntas, com dois a dezesseis candidatos em choice e dois a dezesseis níveis ordenados em score. Isso permite reunir decisões relacionadas sem transformar cada pergunta em uma conversa separada. Referência da API
Considere uma fotografia com a instrução curta “Escolha o material conforme estas descrições”. Uma segunda pergunta pode pedir a faixa de política aplicável, e uma terceira verificar uma condição booleana fornecida. A fotografia é a evidência compartilhada; os critérios definem o significado de cada decisão.
O caminho documentado de inferência gera zero tokens de resposta. Isso elimina uma fonte de variação de formato, mas não elimina o codificador visual, o cálculo da base, o pré-processamento da imagem nem o custo da aplicação. “Sem resposta gerada” e “sem custo computacional” são afirmações muito diferentes.
Leia o exemplo da garrafa como um exemplo
O repositório do QEV inclui uma fotografia licenciada e uma saída registrada para uma garrafa plástica. É uma forma útil de conhecer a estrutura da resposta antes de instalar qualquer coisa.
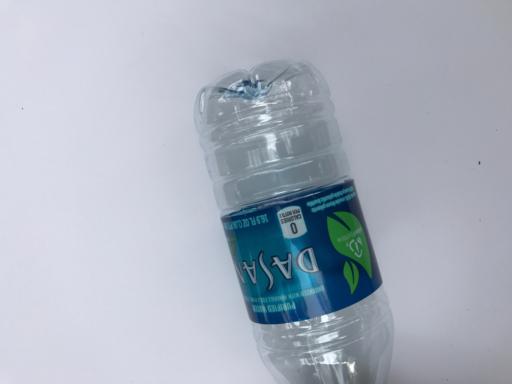 Entrada de exemplo publicada no caso fotográfico do QEV, originalmente do TrashNet. Copyright 2017 Gary Thung, licença MIT; o aviso de licença foi preservado.
| Pergunta do exemplo publicado | Resultado registrado | Significado |
|---|---|---|
| Escolher entre seis materiais | Plástico, probabilidade de aproximadamente 0.9361 | Plástico recebe a maior parcela entre os candidatos fornecidos |
| Escolher uma faixa ordenada de política | Nível esperado de aproximadamente 0.4254 na escala 0–2 | Média ponderada dos três índices de faixa fornecidos |
| Pertence a vidro, papel ou plástico? | Verdadeiro, probabilidade de aproximadamente 0.7903 | O critério verdadeiro é favorecido em relação à alternativa falsa |
A pontuação exige cuidado. Nesse exemplo, a faixa 0 agrupa vidro e plástico, a 1 agrupa metal e lixo, e a 2, papelão e papel. A ordem é uma política ilustrativa. O número 0.4254 não é uma classificação de segurança, norma de reciclagem nem a confiança na escolha do material.
Da mesma forma, a probabilidade de plástico descreve esta solicitação e seus candidatos. Não demonstra que 93.61% de todas as fotografias de garrafas serão classificadas corretamente. É um exemplo de lançamento já examinado, não um teste novo reservado, e a saída foi registrada pelo projeto, não reproduzida para este artigo.
O que “compatível com Jev” deve significar aqui
É mais fácil entender compatibilidade por camadas. Há a ideia comum de decisões definidas por solicitação, o esquema JSON exato, as entradas aceitas e o comportamento de cada saída. Corresponder em uma camada não garante correspondência nas outras.
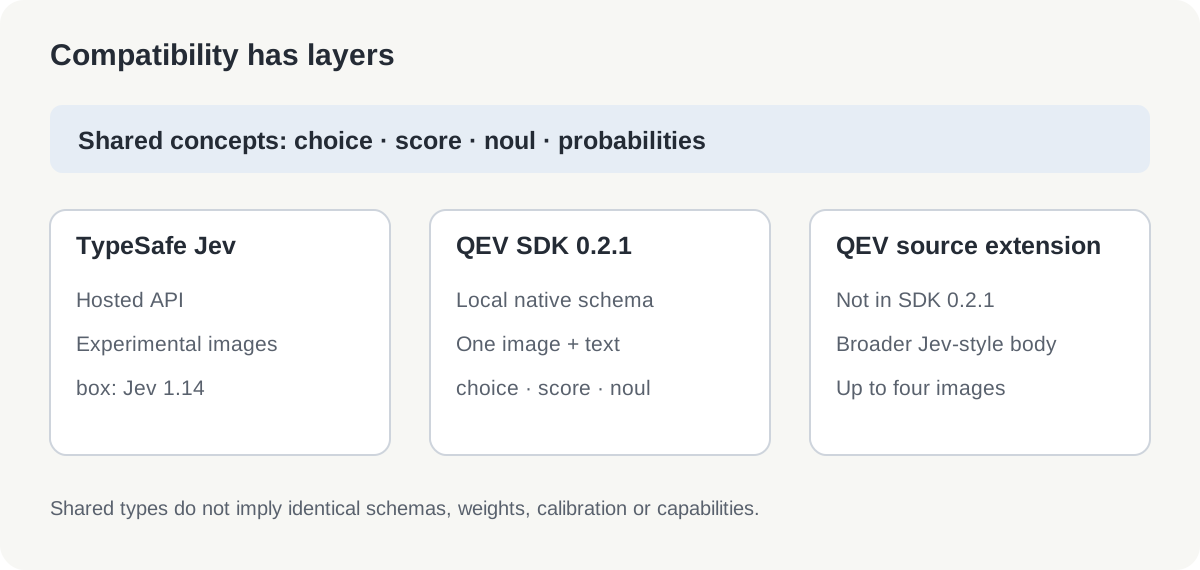 Mapa de compatibilidade original, conferido em 20 de outubro de 2026. Extensões de código-fonte são separadas do contrato do SDK empacotado.
O SDK empacotado QEV 0.2.1 usa o esquema nativo do QEV e uma imagem opcional. O código-fonte público também documenta solicitações mais amplas ao estilo Jev/SystemOne e até quatro imagens ordenadas. Não presuma que essas extensões estão no pacote 0.2.1 publicado. API e notas da versão, versão 0.2.1
Na integração, comece com uma solicitação conhecida e compare validação, campos de resposta, ordem dos candidatos e incerteza. Uma rota familiar /v1/systemone, sozinha, não comprova substituição universal e direta do serviço ou SDK da TypeSafe.
Uma primeira exploração prática
Para conhecer o projeto, o playground local é mais fácil de examinar do que uma integração em aplicação.
- Prepare e ative um ambiente Python 3.12.
- Instale a versão fixada e inicie o playground com os comandos abaixo.
- Abra
http://127.0.0.1:7860, escolha um exemplo e examine probabilidades e abstenção.
python -m pip install qev==0.2.1
qev playground
O playground documentado executa localmente em http://127.0.0.1:7860. Inclui fotografias de exemplo e mostra probabilidades, abstenção e saída estruturada. Interface e documentação estão em inglês. Estas são instruções da versão, não uma alegação de instalação ou medição para o artigo. Guia do playground
Uma solicitação pequena de texto mostra o formato do SDK nativo:
from qev import DecisionRequest, load

model = load()
request = DecisionRequest.model_validate({
    "state": {
        "text": "I was charged twice. Please refund the duplicate payment."
    },
    "questions": {
        "department": {
            "type": "choice",
            "instructions": "Which team should handle this request?",
            "criteria": {
                "billing": "Payments and refunds",
                "technical": "Software faults"
            }
        }
    }
})
print(model.predict(request)["answers"])
Comece com dois ou três candidatos claramente diferentes. Depois teste um caso ambíguo e outro que não pertença a nenhum deles. Verifique se a abstenção e a política da aplicação geram uma resposta útil. Nos testes visuais, use fotos que você tenha direito de processar e critérios baseados em evidências visíveis, não em fatos que a imagem não comprova.
Reserve recursos para a base, não só para o adaptador
Na rota mais antiga do SDK 0.2.1 acima, o checkpoint de adaptação do QEV tem aproximadamente 32.01 MB, com download separado da base Qwen de cerca de 4.55 GB. A divisão publicada lista cerca de 2.213 bilhões de parâmetros da base e 7.992 milhões de adaptação e leitura. Os checkpoints QEV-0.8B e QEV-2B de outubro, abaixo, usam outra rota de carregamento. Detalhamento de tamanho do SDK
A configuração inicial, portanto, envolve gigabytes. O uso posterior pode aproveitar arquivos em cache, mas a memória de execução também inclui ativações, processamento de imagens e buffers. As rotas documentadas de GPU e CPU usam precisões numéricas diferentes. O tamanho em bytes ajuda a planejar armazenamento, não promete memória, vazão ou consumo de bateria numa máquina específica.
Se o 2B pesar no computador, experimente o QEV-0.8B
O lançamento de outubro inclui o QEV-0.8B, baseado em Qwen3.5-0.8B e destilado do mesmo professor do novo QEV-2B. É um começo prático quando memória de GPU ou tempo de resposta tornam o 2B desconfortável. O modelo menor mantém decisões definidas por solicitação, trocando parte da qualidade visual por menor consumo. Documentação do 0.8B, documentação do 2B
| Medida publicada | QEV-0.8B | QEV-2B de outubro | Diferença |
|---|---|---|---|
| Decision Index visual público, modo accurate | 53.02 | 61.99 | 2B supera por 8.97 pontos do índice |
| Pico de alocação de GPU, modo accurate | 1.86 GiB | 4.44 GiB | 0.8B usa cerca de 58% menos |
| Mediana das latências p50 dos perfis de solicitação | 66.0 ms | 135.3 ms | Cerca de 51% menor no 0.8B |
| Maior latência p95 entre os perfis | 377.3 ms | 738.6 ms | Cerca de 49% menor no 0.8B |
| Pico de alocação de GPU, modo fast | 1.60 GiB | 4.13 GiB | 0.8B economiza 2.53 GiB |
| Pontuação RealWorldQA | 39.2 | 56.2 | 2B supera por 17.0 pontos |
| Pontuação Winoground | 47.5 | 65.5 | 2B supera por 18.0 pontos |
| Pontuação InfographicVQA | 75.4 | 83.1 | 2B supera por 7.7 pontos |
São medições do desenvolvedor conferidas em 20 de outubro de 2026. O índice foi calculado pelo próprio projeto com o kit visual público, edição 0.3.2, e aguarda execução oficial; não é um percentual geral de precisão. O intervalo de bootstrap pareado da diferença de 8.97 pontos é 7.39–10.48 pontos. Os benchmarks individuais mostram como a diferença varia conforme a tarefa.
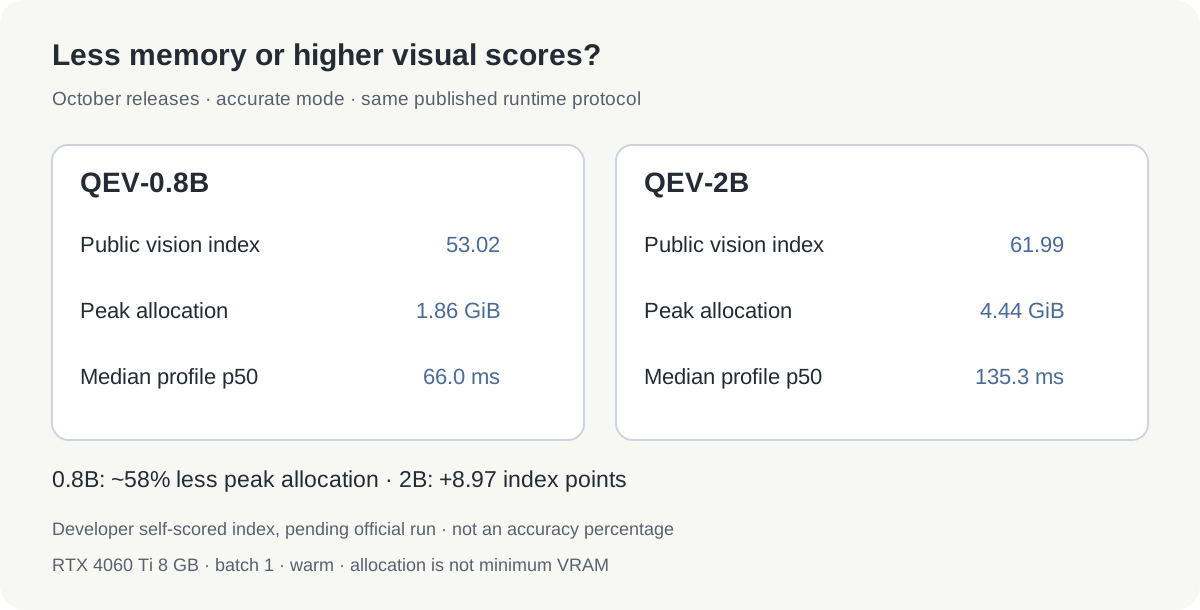 Infográfico original baseado nas duas documentações fixadas. Os índices foram calculados pelo projeto; memória e tempo referem-se ao modo accurate na GPU medida.
As medições usam RTX 4060 Ti 8 GB, lote 1, modelo aquecido e 47 perfis, com três aquecimentos e 30 execuções cronometradas por perfil. O modo accurate aceita até 1.6 MP por imagem. A memória é a alocação máxima do PyTorch, não a capacidade mínima de uma placa: drivers, outros aplicativos e entradas diferentes também precisam de espaço. Os tempos excluem download e carregamento e não preveem desempenho em CPU.
O modo fast limita as imagens a 0.26 MP e termina na camada 16 de 24. No 0.8B, a mediana p50 cai a 44.6 ms e o pior p95 a 123.2 ms. A precisão interna DEV cai de 86.0% no modo accurate para 82.0%, afetando sobretudo documentos, gráficos e telas. Não há Decision Index público para fast; a pontuação 53.02 pertence ao modo accurate.
Use um ambiente Python 3.12 separado para esses checkpoints. O pacote antigo qev==0.2.1 não carrega o lançamento 0.8B:
python -m pip install "qev @ git+https://github.com/ken-jo/qev@986a2d6d7b7e1583458b4006c9b88d6269dfa84a" huggingface_hub
from huggingface_hub import snapshot_download
import qev

path = snapshot_download(
    "ken-jo/QEV-0.8B",
    revision="def58ea5c773bb2e5bf53c428c6a1c76c6e55ceb",
)
model = qev.QEV.load(path, device="cuda")
# To reduce image resolution and depth further:
# model = qev.QEV.load(path, device="cuda", mode="fast")
Envie um DecisionRequest com model.predict(request), como no exemplo anterior. Comece com 0.8B no modo accurate e teste fast se os recursos continuarem apertados. Migre para 2B quando os erros em entradas representativas justificarem mais memória e tempo, mantendo as mesmas entradas e descrições de candidatos.
Onde testar e onde terminam as evidências
Bons primeiros experimentos usam evidências visíveis e consequências delimitadas: encaminhar a imagem de um documento a uma fila de revisão, categorizar uma foto de item ou escolher a descrição de manuseio que melhor corresponde à entrada. Preserve revisão humana enquanto mede se o modelo ajuda.
Escolha um conjunto representativo pequeno antes de ajustar prompts. Registre precisão das decisões aceitas, taxa de abstenção e erros que ainda passam. Repita com iluminação, qualidade de imagem e idiomas diferentes. O QEV herda entradas multilíngues da base, mas as evidências publicadas de precisão e calibração focam o inglês; equivalência em coreano ou outros idiomas deve ser testada, não presumida. Documentação pública
As avaliações do modelo antigo do SDK também delimitam a promessa. Em uma comparação de 2,000 perguntas de decisão tipada, QEV marcou 77.00% e o especialista textual LAYA, 76.95%: diferença de uma pergunta, com intervalo de confiança pareado cruzando zero. Isso não demonstra vantagem geral de precisão nem é comparação direta com o Jev hospedado. Esses resultados antigos são separados da comparação dos checkpoints de outubro acima. A especialização textual também pode ser mais rápida em seu contexto. Método e resultados da comparação
O raciocínio visual continua irregular. A avaliação exploratória de 2048 informa nenhum jogo bem-sucedido em 72 tentativas. Um modelo compacto que identifica materiais em fotos não vira automaticamente um planejador espacial confiável. Notas de avaliação
Vale explorar o QEV quando operação local, uma base pequena e decisões explícitas importam juntas. A rota experimental de imagens do Jev e outros projetos baseados em Qwen mostram a direção: mais aplicações podem pedir um julgamento delimitado sobre uma imagem e decidir o que fazer com ele em software convencional.
Fontes
Fontes conferidas em 20 de outubro de 2026. A arquitetura, os exemplos e os limites de versão acima se referem ao código-fonte público fixado do QEV e ao SDK 0.2.1. O contexto vem do anúncio do Jev pela TypeSafe, do artigo PixelJev e da documentação AutoTrust. A imagem principal é uma captura editorial do README público do QEV; fontes e direitos de mídia estão registrados separadamente.
Mantenha a evidência original ao lado da decisão para poder rever uma classificação errada ou uma política alterada. Crie uma conta no Telli.sh para reunir fontes, notas e pesquisas posteriores em um espaço pesquisável.