[KI-Ideen-Notizbuch 04] Von Entscheidungen nach Jev-Art zu Bildern: QEV, ein kleines Modell auf Qwen-Basis
Warum rund um Qwen visuelle Entscheidungsmodelle entstehen, was Jevs experimentelle Bildunterstützung verändert und wo das lokale QEV-Projekt der 2B-Klasse seinen Platz hat.
Das KI-Ideen-Notizbuch erkundet die Ideen und praktischen Möglichkeiten hinter neu entstehenden KI-Modellen und Werkzeugen.
Ein Foto trifft in einem Sortierablauf ein. Die Anwendung muss zwischen Kunststoff, Glas und Metall wählen, prüfen, ob der Gegenstand zu einer vorgegebenen Kategorie gehört, und einen für Software nutzbaren Wert zurückgeben. Ein flüssiger Absatz über die Flasche mag interessant sein, lässt aber einen weiteren Schritt zwischen Modell und Entscheidung offen.
Jev rückte eine andere Schnittstelle ins Blickfeld: Man gibt dem Modell eine Situation, eine Frage und die erlaubten Antworten und erhält eine strukturierte Entscheidung mit Wahrscheinlichkeiten. Die nächste Frage liegt nahe: Funktioniert diese Schnittstelle auch mit dem, was ein Modell sieht, statt nur mit dem, was es liest?
Inzwischen geht das in mehreren Formen. TypeSafe führte am 14. Oktober 2026 experimentelle Bildunterstützung für Jev ein. Unabhängige Projekte passen ebenfalls Qwens Vision-Language-Backbones an Entscheidungen nach Jev-Art an. Eines davon ist QEV, ein lokales Modell auf Basis von Qwen3.5-2B mit Auswahlentscheidungen, geordneten Bewertungen, booleschen Entscheidungen und Enthaltung. Jev-Ankündigung, QEV-Repository
Offenlegung des Autors: QEV ist das vom Autor dieses Beitrags unabhängig betreute Projekt. Diese Einführung trennt die veröffentlichte Version von ausschließlich im Quellcode verfügbaren Funktionen und stützt sich auf öffentliche Dokumentation und protokollierte Beispiele. Sie stellt keine neue unabhängige Modellbewertung vor.
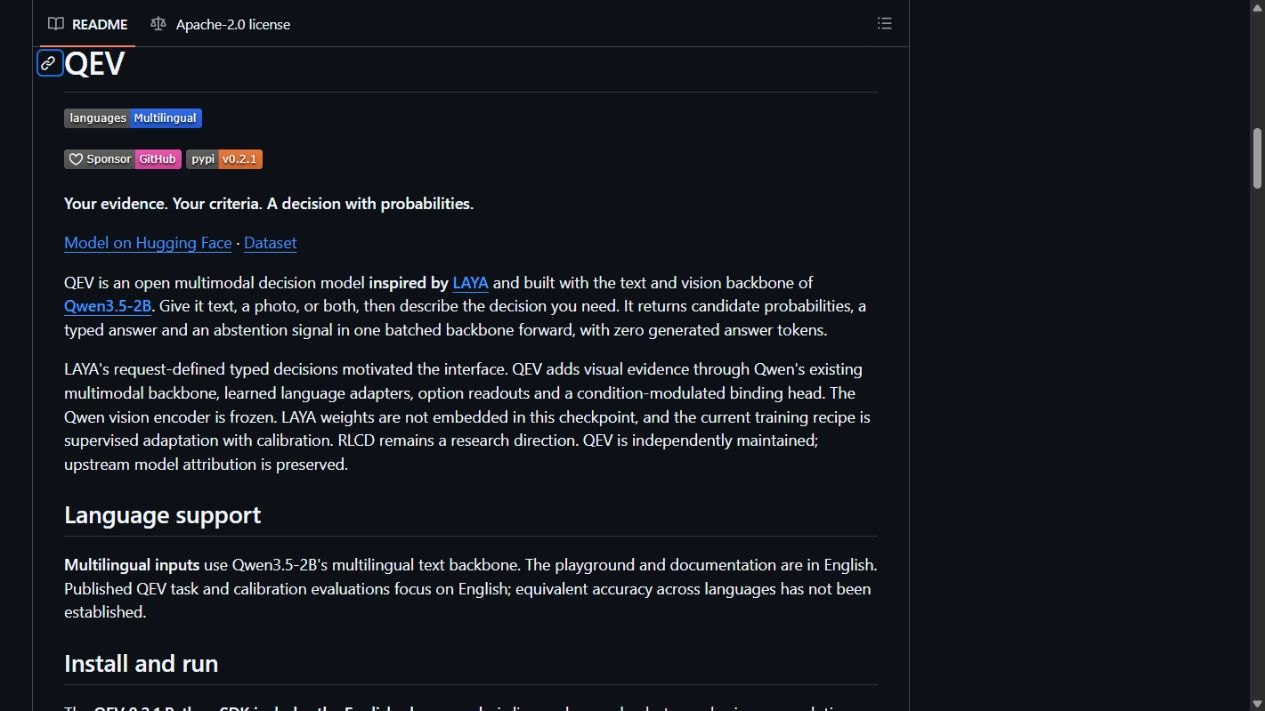 Das öffentliche QEV-Repository, aufgenommen am 20. Oktober 2026. Zu sehen ist Dokumentation, keine Vorführung lokaler Inferenz.
Warum sich ein Entscheidungsmodell anders als ein Chatbot anfühlt
Ein Chatbot schreibt normalerweise Token für Token eine Antwort. Ein Entscheidungsmodell ist nützlich, wenn die Anwendung die Form der Antwort bereits kennt: ein Ziel auswählen, einen Zustand auf einer geordneten Skala einordnen oder entscheiden, ob eine Aussage zutrifft.
Die Antwortmöglichkeiten können sich mit jeder Anfrage ändern. Ein Supportsystem bietet heute vielleicht Abrechnung und technischen Support an und morgen zusätzlich Kontowiederherstellung. Ein visueller Sortierablauf gibt für eine Frage sechs Materialbeschreibungen vor und für eine andere andere Behandlungsvorschriften. Das Modell muss die aktuellen Belege auf diese Beschreibungen beziehen, statt aus einer dauerhaft trainierten Etikettenliste auszuwählen.
Jevs bekannte Primitive heißen choice, score und noul. In QEV liefert eine Auswahl eine Verteilung über die vorgegebenen Kandidaten. Ein Score verwendet vorgegebene geordnete Stufen und liefert deren Wahrscheinlichkeiten sowie einen erwarteten Stufenwert. Eine noul-Frage verwendet Kriterien für wahr und falsch. Das sind unterschiedliche Ausgabeverträge, selbst wenn dasselbe Modell darunterliegt. QEV-API-Referenz
Wahrscheinlichkeiten machen die Grenze sichtbar: Ein knapper Vorsprung zwischen zwei Kandidaten kann eine Prüfung statt einer automatischen Aktion auslösen. Sie machen die Entscheidung aber nicht richtig. Die Anwendung benötigt weiterhin Regeln für Unsicherheit, ungeeignete Eingaben und die Kosten eines Fehlers.
Jev bietet bereits einen experimentellen Bildpfad
Die historische Motivation braucht eine Aktualisierung. Es wäre irreführend, QEV damit einzuführen, dass Jev derzeit keine Bilder akzeptieren könne. TypeSafes Oktoberankündigung ermöglicht experimentelle Bildeingaben für Jev 1.13 und 1.14 hinter dem Header TypeSafe-Danger-Zone-Images. Jev 1.14 ergänzt außerdem das räumliche Primitiv Box. Die Ankündigung bezeichnet diese Bildfunktionen als experimentell. Ankündigung von Jev 1.14
Das verändert den Vergleich. Die nützliche Frage ist, welche Bereitstellung, welcher Eingabevertrag und welches Entscheidungsverhalten zu einem konkreten Ablauf passen. Ein gehosteter Jev-Versuch, ein Forschungsmodell und eine lokale Qwen-Anpassung können die Idee begrenzter Entscheidungen teilen und sich bei Verpackung und unterstützten Operationen dennoch deutlich unterscheiden.
QEV hat kein dokumentiertes Gegenstück zu Jevs Box-Primitiv. Es ist eine unabhängige Implementierung, weder TypeSafes Gewichte noch eine offizielle Jev-Veröffentlichung. Gemeinsame Primitivnamen oder ein Endpunkt nach SystemOne-Art sind ein Ausgangspunkt für die Integration, kein Beleg dafür, dass sich jede Anfrage unverändert zwischen Produkten verschieben lässt.
Warum Qwen in diesen Projekten auftaucht
Ein Vision-Language-Backbone führt Text- und Bildinformationen bereits in einem gemeinsamen Modell zusammen. Damit erhält ein Entscheidungsprojekt einen praktischen Ausgangspunkt: visuelles Verständnis bewahren und anschließend anpassen, wie das Modell Belege mit den von der Anwendung vorgegebenen Antworten verknüpft.
Zwei öffentliche Beispiele zeigen, dass dieser Ansatz über ein einzelnes Repository hinausgeht:
| Projekt | Öffentlich beschriebener Ansatz | Wie sein Status einzuordnen ist |
|---|---|---|
| PixelJev | Untersucht visuelle Auswahlentscheidungen nach Jev-Art mit kleinen Qwen3.5-Backbones, darunter Varianten mit 2B und 4B | Ein Forschungsartikel über visuelle Auswahl, kein Beleg für einen vollständigen Ersatz eines gehosteten Jev-Dienstes |
| AutoTrust JEV-27B-VL | Verwendet Qwen3.8-27B mit Entscheidungskopf und Adaptern | Ein unabhängiges größeres Modell; die Model Card trennt texttrainiertes Entscheidungsverhalten von Zero-Shot-Bildnutzung |
| QEV | Passt Qwen3.5-2B an choice-, score- und noul-Entscheidungen an | Ein lokales Projekt der 2B-Klasse mit veröffentlichtem SDK und separat dokumentierten Quellcodeerweiterungen |
PixelJevs Artikel hilft, die Architekturidee zu verstehen: Bilder und zur Laufzeit vorgegebene Kandidaten mit einer Entscheidungsauslese verbinden. AutoTrusts Model Card zeigt eine andere Größenordnung der Implementierung und weist zugleich darauf hin, dass systematische visuelle Kalibrierung nicht belegt ist. Das sind Beispiele eines entstehenden Entwurfsmusters, keine Benchmark-Rangliste und keine Liste gleich kompatibler Produkte. PixelJev-Artikel, AutoTrust Model Card
QEVs Platz in diesem Bild ist kompakter lokaler Betrieb. „Klein“ beschreibt die Backbone-Klasse im Vergleich zu wesentlich größeren Vision-Language-Modellen. Es bedeutet nicht, dass die gesamte Installation nur wenige Megabytes umfasst oder auf jedem Gerät sofort läuft.
Wie QEV aus einem Bild eine Entscheidung macht
QEV verwendet einen einzigen Qwen3.5-2B-Backbone für Text und Bild. Die veröffentlichte Architektur ergänzt eine sprachseitige Anpassung und eine Ausleseschicht, die Situation und Frage mit den vorgegebenen Kandidatenbeschreibungen verbindet. Das Modell bewertet diese Kandidaten direkt, statt einen Antwortsatz zu erzeugen und einen weiteren Parser daraus ein Etikett extrahieren zu lassen. Öffentliche Model Card
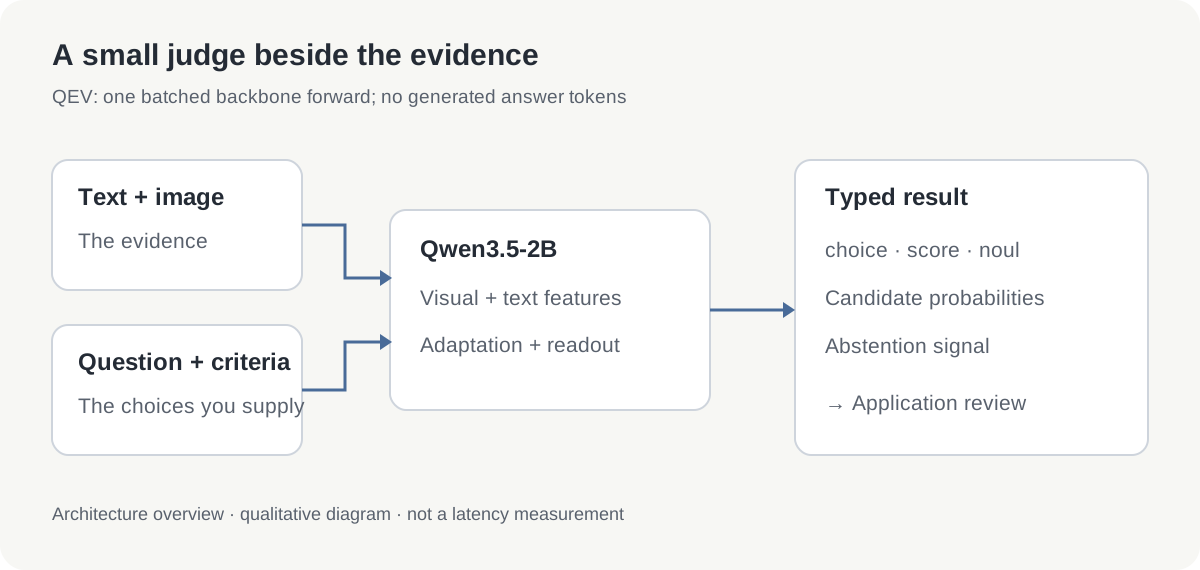 Eigene Erklärungsgrafik. Die Pfeile zeigen den dokumentierten Entscheidungspfad, keinen gemessenen Geschwindigkeitsvergleich.
Im veröffentlichten SDK kann eine Anfrage Text, ein Bild oder beides enthalten. Unterstützt werden eine bis vier Fragen, mit zwei bis sechzehn Kandidaten für choice und zwei bis sechzehn geordneten Stufen für score. Damit ist ein kleines Bündel zusammenhängender Entscheidungen möglich, ohne aus jeder Frage einen eigenen Chat zu machen. API-Referenz
Denken Sie an ein Foto mit der kurzen Anweisung: „Wähle das Material anhand dieser Beschreibungen.“ Eine zweite Frage kann nach der geltenden Regelstufe fragen und eine dritte danach, ob der Gegenstand eine vorgegebene boolesche Bedingung erfüllt. Das Foto liefert die gemeinsamen Belege; die Kriterien definieren die Bedeutung jeder Entscheidung.
Der dokumentierte Inferenzpfad erzeugt null Antwort-Tokens. Das beseitigt eine Quelle unterschiedlicher Formatierung, aber nicht den Vision-Encoder, Backbone-Berechnungen, Bildvorverarbeitung oder Anwendungsaufwand. „Keine generierte Antwort“ und „kein Rechenaufwand“ sind sehr unterschiedliche Aussagen.
Lesen Sie das Flaschenbeispiel als Beispiel
QEVs Repository enthält ein lizenziertes Foto und eine protokollierte Ausgabe für eine Kunststoffflasche. Damit lässt sich die Antwortstruktur ansehen, bevor etwas installiert wird.
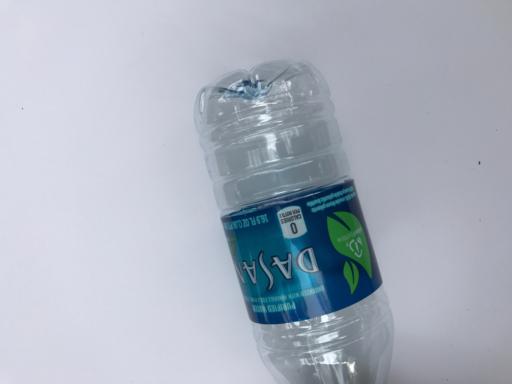 Veröffentlichte Beispieleingabe aus QEVs Foto-Fixture, ursprünglich aus TrashNet. Copyright 2017 Gary Thung, MIT-Lizenz; der Lizenzhinweis bleibt erhalten.
| Frage im veröffentlichten Fixture | Protokolliertes Ergebnis | Bedeutung |
|---|---|---|
| Unter sechs Materialien wählen | Kunststoff, Wahrscheinlichkeit etwa 0.9361 | Kunststoff erhält den größten Anteil unter den vorgegebenen Kandidaten |
| Eine geordnete Regelstufe wählen | Erwarteter Wert etwa 0.4254 auf einer Skala von 0–2 | Ein gewichteter Mittelwert der drei vorgegebenen Stufenindizes |
| Gehört es zu Glas, Papier oder Kunststoff? | Wahr, Wahrscheinlichkeit etwa 0.7903 | Das boolesche Kriterium wird gegenüber seiner falschen Alternative bevorzugt |
Der Score braucht besondere Sorgfalt. In diesem Fixture fasst Stufe 0 Glas und Kunststoff zusammen, Stufe 1 Metall und Restmüll sowie Stufe 2 Karton und Papier. Die Reihenfolge ist eine beispielhafte Regel. Die Zahl 0.4254 ist weder eine Sicherheitsbewertung noch ein Recyclingstandard oder die Konfidenz der Materialauswahl.
Ebenso beschreibt die Kunststoffwahrscheinlichkeit diese konkrete Anfrage und ihre Kandidaten. Sie belegt nicht, dass 93.61% aller Flaschenfotos korrekt klassifiziert werden. Dies ist ein zuvor geprüftes Veröffentlichungs-Fixture, kein neuer zurückgehaltener Test. Die obige Ausgabe wurde vom Projekt aufgezeichnet und nicht für diesen Artikel reproduziert.
Was „Jev-kompatibel“ hier bedeuten sollte
Kompatibilität lässt sich am besten in Schichten verstehen: die gemeinsame Idee anfragedefinierter Entscheidungen, das exakte JSON-Schema, die unterstützten Eingaben und das Verhalten jedes Ausgabetyps. Die Übereinstimmung einer Schicht bedeutet nicht automatisch die Übereinstimmung aller anderen.
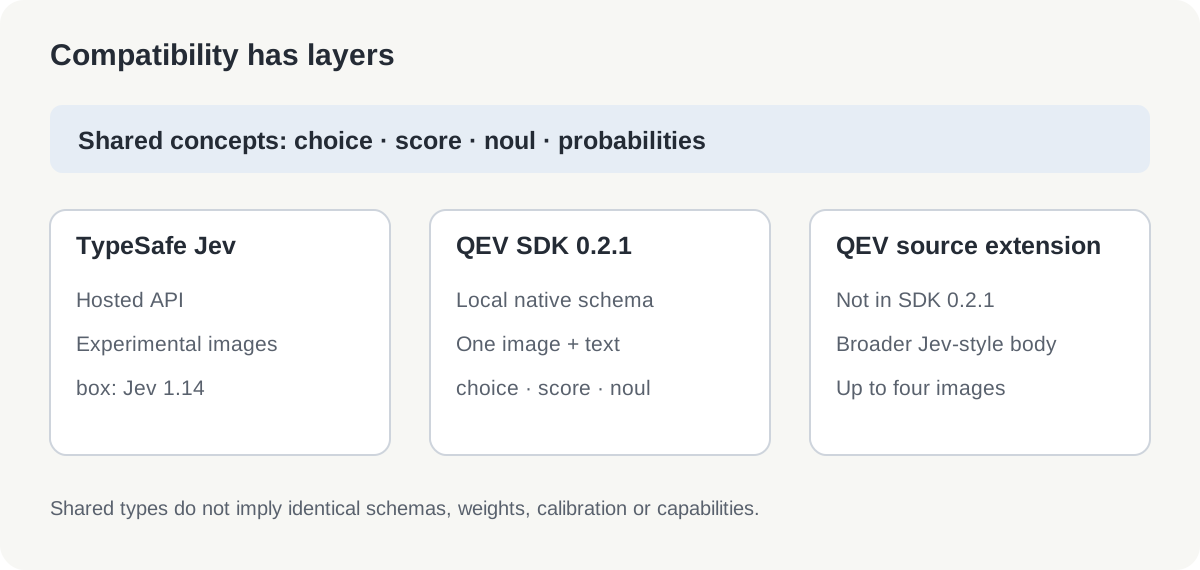 Eigene Kompatibilitätsübersicht, geprüft am 20. Oktober 2026. Quellcodeerweiterungen sind vom Vertrag des ausgelieferten SDK getrennt.
Das als Paket veröffentlichte QEV-0.2.1-SDK verwendet QEVs natives Anfrageschema und ein einzelnes optionales Bild. Der öffentliche Quellcodestand dokumentiert außerdem breitere Verarbeitung von Anfragen nach Jev/SystemOne-Art und bis zu vier geordnete Bilder. Diese Erweiterungen dürfen nicht als Funktionen des veröffentlichten 0.2.1-Pakets vorausgesetzt werden. API und Veröffentlichungshinweise, Veröffentlichung 0.2.1
Beginnen Sie eine Integration mit einer bekannten Anfrage und vergleichen Sie Validierung, Antwortfelder, Kandidatenreihenfolge und Verhalten bei Unsicherheit. Eine vertraute Route /v1/systemone allein belegt keinen universellen direkten Ersatz für TypeSafes Dienst oder SDK.
Ein praktischer erster Einblick
Für eine erste Erkundung lässt sich der lokale Playground leichter prüfen als eine Anwendungsintegration.
- Bereiten Sie eine Python-3.12-Umgebung vor und aktivieren Sie sie.
- Installieren Sie die fixierte Veröffentlichung und starten Sie den Playground mit den folgenden Befehlen.
- Öffnen Sie
http://127.0.0.1:7860, wählen Sie ein Beispiel und prüfen Sie Kandidatenwahrscheinlichkeiten und Enthaltung.
python -m pip install qev==0.2.1
qev playground
Der dokumentierte Playground läuft lokal unter http://127.0.0.1:7860. Er enthält Beispielfotos und zeigt Wahrscheinlichkeiten, Enthaltung und strukturierte Ausgaben. Oberfläche und Dokumentation sind englischsprachig. Das sind Installationsanweisungen der Veröffentlichung, keine Behauptung, das Modell sei für diesen Beitrag installiert oder zeitlich vermessen worden. Playground-Anleitung
Eine kleine Textanfrage zeigt die Struktur des nativen SDK:
from qev import DecisionRequest, load

model = load()
request = DecisionRequest.model_validate({
    "state": {
        "text": "I was charged twice. Please refund the duplicate payment."
    },
    "questions": {
        "department": {
            "type": "choice",
            "instructions": "Which team should handle this request?",
            "criteria": {
                "billing": "Payments and refunds",
                "technical": "Software faults"
            }
        }
    }
})
print(model.predict(request)["answers"])
Beginnen Sie mit zwei oder drei klar unterschiedlichen Kandidaten. Versuchen Sie danach einen mehrdeutigen Fall und einen, der zu keinem passt. Prüfen Sie, ob Enthaltung und Anwendungsregeln zu einem brauchbaren Ergebnis führen. Verwenden Sie für Bildtests Fotos, zu deren Verarbeitung Sie berechtigt sind, und formulieren Sie Kriterien anhand sichtbarer Belege statt anhand von Tatsachen, die ein Bild nicht belegen kann.
Planen Sie den Backbone ein, nicht nur den Adapter
Beim oben beschriebenen älteren Weg über SDK 0.2.1 umfasst QEVs Anpassungs-Checkpoint ungefähr 32.01 MB, hinzu kommt ein separater Qwen-Backbone-Download von ungefähr 4.55 GB. Die veröffentlichte Aufschlüsselung nennt rund 2.213 Milliarden Backbone-Parameter und 7.992 Millionen Anpassungs-/Ausleseparameter. Die folgenden Oktober-Checkpoints QEV-0.8B und QEV-2B verwenden einen separaten Ladeweg. Größenaufschlüsselung des SDK-Modells
Die Ersteinrichtung umfasst also Gigabytes. Später können zwischengespeicherte Modelldateien verwendet werden, doch Laufzeitspeicher enthält auch Aktivierungen, Bildverarbeitung und Puffer. Die dokumentierten GPU- und CPU-Pfade nutzen unterschiedliche numerische Präzision. Die Bytezahl eines Checkpoints hilft bei der Speicherplanung, verspricht aber weder Speicherbedarf noch Durchsatz oder Akkulaufzeit auf einem bestimmten Rechner.
Wenn 2B Ihren Rechner überfordert, probieren Sie QEV-0.8B
Die Oktoberveröffentlichung enthält QEV-0.8B, aufgebaut auf Qwen3.5-0.8B und aus demselben Lehrermodell wie das neuere QEV-2B destilliert. Es ist ein praktischer Einstieg, wenn GPU-Speicher oder Antwortzeit 2B unkomfortabel machen. Das kleinere Modell bewahrt anfragedefinierte Entscheidungen und tauscht einen Teil der visuellen Entscheidungsqualität gegen geringeren Ressourcenbedarf. 0.8B Model Card, 2B Model Card
| Veröffentlichte Messgröße | QEV-0.8B | QEV-2B vom Oktober | Unterschied |
|---|---|---|---|
| Öffentlicher visueller Decision Index, accurate-Modus | 53.02 | 61.99 | 2B liegt 8.97 Indexpunkte vorn |
| Maximale GPU-Speicherallokation, accurate-Modus | 1.86 GiB | 4.44 GiB | 0.8B benötigt etwa 58% weniger |
| Median der p50-Latenzen der Anfrageprofile | 66.0 ms | 135.3 ms | Für 0.8B etwa 51% niedriger |
| Höchste p95-Latenz der Anfrageprofile | 377.3 ms | 738.6 ms | Für 0.8B etwa 49% niedriger |
| Maximale GPU-Speicherallokation, fast-Modus | 1.60 GiB | 4.13 GiB | 0.8B spart 2.53 GiB |
| RealWorldQA-Score | 39.2 | 56.2 | 2B liegt 17.0 Punkte vorn |
| Winoground-Score | 47.5 | 65.5 | 2B liegt 18.0 Punkte vorn |
| InfographicVQA-Score | 75.4 | 83.1 | 2B liegt 7.7 Punkte vorn |
Das sind Messungen des Entwicklers, geprüft am 20. Oktober 2026. Der Index wurde mit dem öffentlichen Vision-Kit, Ausgabe 0.3.2, selbst bewertet; ein offizieller Durchlauf steht aus. Er ist kein allgemeiner Genauigkeitsprozentsatz. Das gepaarte Bootstrap-Intervall für den Abstand von 8.97 Punkten beträgt 7.39–10.48 Punkte. Die einzelnen Benchmarks zeigen, wie stark sich der Abstand nach Aufgabe unterscheidet.
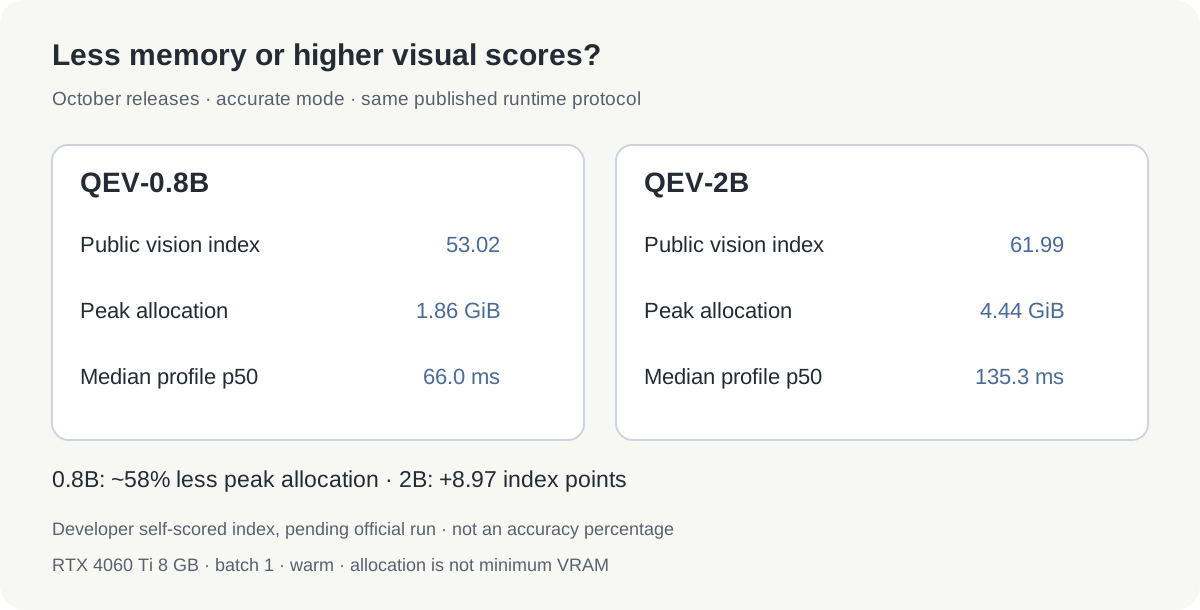 Eigene Vergleichsinfografik auf Basis der beiden fixierten Model Cards. Die Indexwerte sind selbst bewertet; Speicher- und Zeitwerte beziehen sich auf den accurate-Modus auf der vermessenen GPU.
Die Laufzeitmessungen verwenden eine RTX 4060 Ti 8 GB, Batchgröße 1, ein aufgewärmtes Modell und 47 Anfrageprofile mit drei Aufwärmdurchläufen und 30 Zeitmessungen pro Profil. Der accurate-Modus erlaubt bis zu 1.6 MP pro Bild. Der Speicherwert ist die maximale PyTorch-Allokation, keine Mindestkapazität der Grafikkarte: Treiber, andere Anwendungen und andere Eingaben benötigen ebenfalls Platz. Die Zeiten schließen Download und Laden des Modells aus und sagen keine CPU-Leistung voraus.
Der fast-Modus begrenzt Bilder auf 0.26 MP und steigt bei Schicht 16 von 24 aus. Für 0.8B sinkt der mediane p50-Wert auf 44.6 ms und der p95-Wert des langsamsten Profils auf 123.2 ms. Die interne DEV-Genauigkeit fällt von 86.0% im accurate-Modus auf 82.0%, besonders bei Dokumenten, Diagrammen und Bildschirmbildern. Für den fast-Modus ist kein öffentlicher Decision Index angegeben; der Wert 53.02 gehört zum accurate-Modus.
Verwenden Sie für diese Checkpoints eine separate Python-3.12-Umgebung. Das alte Paket qev==0.2.1 lädt die 0.8B-Veröffentlichung nicht:
python -m pip install "qev @ git+https://github.com/ken-jo/qev@986a2d6d7b7e1583458b4006c9b88d6269dfa84a" huggingface_hub
from huggingface_hub import snapshot_download
import qev

path = snapshot_download(
    "ken-jo/QEV-0.8B",
    revision="def58ea5c773bb2e5bf53c428c6a1c76c6e55ceb",
)
model = qev.QEV.load(path, device="cuda")
# To reduce image resolution and depth further:
# model = qev.QEV.load(path, device="cuda", mode="fast")
Übergeben Sie wie im früheren Beispiel eine DecisionRequest über model.predict(request). Beginnen Sie mit 0.8B im accurate-Modus und probieren Sie bei weiterhin knappen Ressourcen den fast-Modus. Wechseln Sie zu 2B, wenn Fehler bei repräsentativen Eingaben den zusätzlichen Speicher- und Zeitbedarf rechtfertigen. Behalten Sie zum Vergleich dieselben Eingaben und Kandidatenbeschreibungen bei.
Wo sich ein Versuch lohnt und wo die Belege enden
Gute erste Versuche haben sichtbare Belege und begrenzte Folgen: ein Dokumentbild einer Prüfwarteschlange zuweisen, ein Gegenstandsfoto kategorisieren oder aus mehreren vorgegebenen Handlungsbeschreibungen die passendste auswählen. Bewahren Sie einen menschlichen Prüfweg, während Sie messen, ob das Modell hilft.
Wählen Sie vor Promptanpassungen eine kleine repräsentative Menge. Erfassen Sie die Genauigkeit angenommener Entscheidungen, Enthaltungsquote und weiterhin durchgelassene Fehler. Wiederholen Sie dies bei unterschiedlicher Beleuchtung, Bildqualität und Sprache. QEV erbt mehrsprachige Eingabefähigkeiten vom Backbone, doch die veröffentlichten Belege zu Genauigkeit und Kalibrierung konzentrieren sich auf Englisch. Gleichwertigkeit für Koreanisch oder andere Sprachen sollte geprüft und nicht vorausgesetzt werden. Öffentliche Model Card
Auch die Bewertungen des älteren SDK-Modells begrenzen die Erwartungen. In einem Vergleich typisierter Entscheidungen mit 2,000 Fragen erreichte QEV 77.00% und der Textspezialist LAYA 76.95%: eine einzige Frage Unterschied, mit einem gepaarten Konfidenzintervall, das null einschließt. Das ist kein Beleg für einen allgemeinen Genauigkeitsvorteil und kein direkter Vergleich mit gehostetem Jev. Diese älteren Ergebnisse sind vom obigen Vergleich der Oktober-Checkpoints getrennt. Textspezialisierung kann in ihrem eigenen Umfeld außerdem schneller sein. Vergleichsmethodik und Ergebnisse
Visuelles Schlussfolgern bleibt uneinheitlich. Die explorative 2048-Auswertung des Projekts meldet keinen erfolgreichen Spielverlauf in 72 Versuchen. Ein kompaktes Modell, das Materialien auf einem Foto erkennt, ist nicht automatisch ein verlässlicher räumlicher Planer. Bewertungsnotizen
QEV lohnt die Erkundung, wenn lokaler Betrieb, eine kleine Backbone-Klasse und explizite Entscheidungsausgaben gemeinsam wichtig sind. Jevs experimenteller Bildpfad und die anderen Qwen-Projekte zeigen die breitere Richtung: Mehr Anwendungen können ein Modell nach einer begrenzten Beurteilung eines Bildes fragen und anschließend mit gewöhnlicher Software entscheiden, was daraus folgt.
Quellen
Die Quellen wurden am 20. Oktober 2026 geprüft. Architektur, Beispiele und Versionsgrenzen oben beziehen sich auf QEVs fixierten öffentlichen Quellcodestand und SDK 0.2.1. Der weitere Kontext stammt aus TypeSafes Jev-Ankündigung, dem PixelJev-Artikel und AutoTrusts Model Card. Das Titelbild ist eine redaktionelle Aufnahme des öffentlichen QEV-README; Medienquellen und Rechte sind separat dokumentiert.
Bewahren Sie die ursprünglichen Belege neben der Entscheidung auf, damit sich eine falsche Klassifizierung oder eine geänderte Regel später erneut prüfen lässt. Erstellen Sie ein Telli.sh-Konto, um Quellenmaterial, Notizen und weitere Recherche in einem durchsuchbaren Arbeitsbereich zu sammeln.