Por que a PFN quer empilhar memória em seu próximo chip de IA
A colaboração entre PFN e SEMIFIVE no MN-Core L2000 mira um gargalo de memória na inferência. O que o roteiro de desenvolvimento significa para agentes, IA privada e futuras compras de hardware.
Um assistente de IA pode ter memória suficiente para carregar um modelo e ainda parecer lento em cada resposta. As unidades aritméticas estão prontas, mas o cálculo útil depende de levar os dados certos a elas na hora certa. Para uma empresa que atende vários assistentes privados, essa diferença pode transformar uma especificação impressionante em uma espera incômoda entre palavras.
Preferred Networks e SEMIFIVE estão apostando no desenvolvimento para enfrentar esse problema. O anúncio de 16 de novembro de 2026 descreve a série MN-Core L2000, um processador voltado à inferência que empilha lógica e DRAM verticalmente. A meta declarada é oferecer mais que o dobro da largura de banda de memória da série L1000 anterior. A PFN publicou o anúncio em seu site em 17 de novembro. Anúncio da PFN
A pergunta interessante é o que esse projeto pode mudar para quem vier a operar serviços de IA. Movimentar dados mais rápido pode importar tanto quanto acrescentar capacidade aritmética, enquanto o encapsulamento, o suporte de software e o servidor final determinam se o benefício chega à tela do usuário. O anúncio do L2000 oferece uma forma útil de pensar nessas decisões antes da hora de comprar.
A empresa por trás do PLaMo também projeta as máquinas que o sustentam
A Preferred Networks é uma empresa de IA sediada em Tóquio que atua em processadores, infraestrutura computacional e na família de modelos PLaMo. Nesta colaboração, a PFN responde pela arquitetura do processador e pelo projeto lógico; a SEMIFIVE fornece implementação e serviços de cadeia de suprimentos usando a plataforma da Samsung Foundry e sua infraestrutura de projeto 3D-IC. PFN e as responsabilidades de desenvolvimento
Essa divisão importa porque um acelerador útil é mais do que um conjunto de instruções ou um desenho de chip. O projeto lógico precisa virar silício fabricável, a memória precisa se conectar a ele e os dispositivos encapsulados precisam funcionar de maneira consistente. O cliente precisa, no fim, de uma configuração de servidor reproduzível e de um caminho de software que transforme o modelo em aplicação. Cada passagem de responsabilidade pode afetar o custo e o prazo de entrega do produto final.
A ligação com o PLaMo oferece uma referência conhecida, mas não comprova que todos os seus ambientes passarão a usar esse hardware. Um desenvolvedor de modelos e um comprador de infraestrutura também têm perguntas diferentes. O desenvolvedor pergunta se a carga pode ser expressa com eficiência; o comprador quer saber se a implementação com suporte atenderá à meta do serviço durante a vida da instalação.
Para os leitores coreanos, a participação da SEMIFIVE é um exemplo concreto de conhecimento local em projeto de semicondutores aplicado à infraestrutura de inferência. A próxima pergunta útil é como esse conhecimento se traduz em dispositivos de produção e sistemas com suporte. O anúncio identifica os participantes e a direção; os produtos posteriores determinarão as opções disponíveis para os clientes.
Capacidade e largura de banda de memória respondem a perguntas diferentes
A capacidade informa quanto um sistema de memória consegue armazenar. A largura de banda informa quantos dados ele consegue movimentar em determinado intervalo. Um modelo pode caber no primeiro limite enquanto o segundo restringe a velocidade do processador. Aumentar apenas a capacidade não garante uma aplicação mais responsiva.
Uma conta simples de planejamento torna a primeira diferença visível. Um modelo denso hipotético com 30 bilhões de parâmetros, armazenados em dois bytes cada, precisa de aproximadamente 60 bilhões de bytes só para os parâmetros. A conta exclui espaços de trabalho de execução, dados de atenção em cache e outros custos adicionais. É uma ilustração de orçamento de armazenamento, não uma descrição da capacidade do L2000 ou dos modelos que ele suportará.
A pergunta seguinte é como a carga usa o que armazena. Processar um prompt e gerar os tokens de saída em sequência exigem coisas diferentes do sistema. A explicação da NVIDIA sobre otimização de inferência diferencia o processamento paralelo do prompt da decodificação autorregressiva, em que a movimentação de memória pode se tornar uma restrição. Também explica por que o processamento em lotes e a gestão do cache de atenção mudam o equilíbrio. Guia de otimização de inferência da NVIDIA, 17 de novembro de 2023
Pense na memória como uma despensa ligada a uma cozinha. Uma despensa maior ajuda a manter ingredientes no local; uma passagem mais larga ajuda a entregá-los à cozinha. Nenhuma delas diz quanto tempo levará uma refeição específica, porque o preparo e o restante do fluxo também importam. Comparar hardware se torna mais útil quando essas funções continuam separadas.
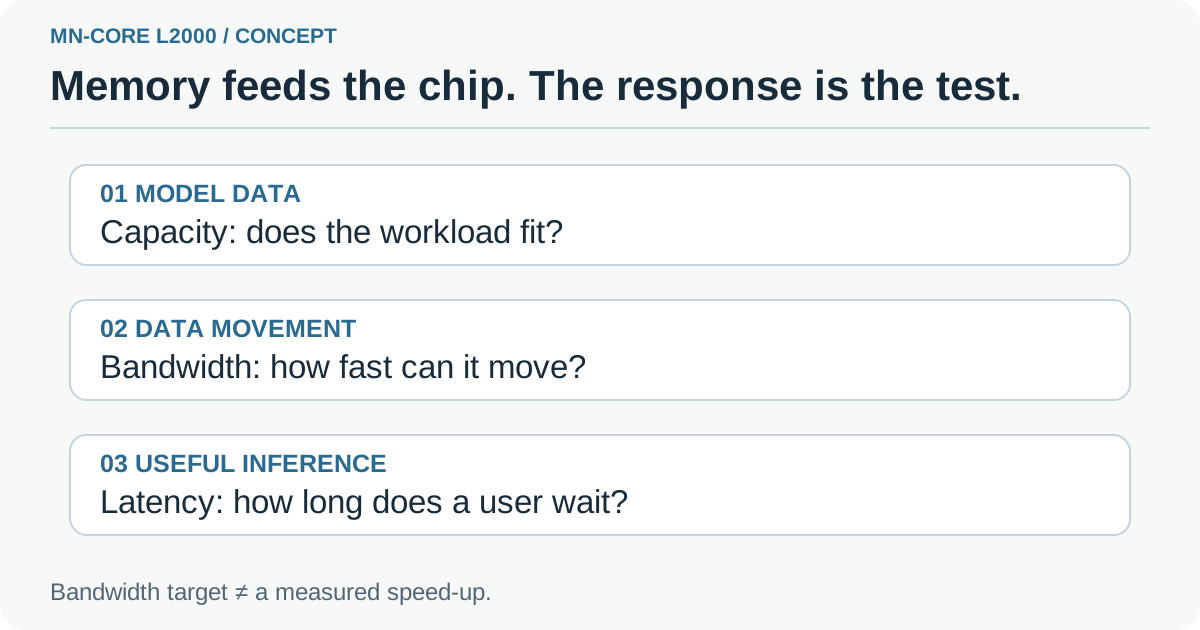
Diagrama explicativo original que separa armazenamento, movimentação de dados e resposta da aplicação. Ilustra a decisão, sem representar o layout de um encapsulamento L2000 ainda não publicado.
Empilhar muda tanto o desafio de engenharia quanto o caminho dos dados
O anúncio oficial da PFN inclui um diagrama da lógica e da DRAM empilhadas verticalmente na série MN-Core L. É uma forma útil de visualizar a direção proposta. Ele não mostra o servidor completo que um cliente instalaria nem comprova o desempenho de uma aplicação pronta.
Reunir componentes em uma pilha exige que o projeto funcione como sistema físico. Fornecimento de energia, dissipação de calor e consistência de fabricação precisam ser discutidos junto com a movimentação dos dados. Não são detalhes para resolver depois que a arquitetura fica atraente em um slide. Eles influenciam a possibilidade de produzir, encapsular, resfriar e dar suporte aos dispositivos a um custo adequado.
Para um operador, o projeto do encapsulamento é, portanto, o início da investigação, não o fim. Um rack tem limites de energia, uma instalação tem seu projeto de refrigeração e o serviço tem uma expectativa de disponibilidade. O acelerador proposto precisará se encaixar nos três. O benefício econômico depende da instalação completa, incluindo os equipamentos e o trabalho necessários para mantê-la funcionando.
É também por isso que uma explicação de eficiência deve acompanhar suas condições de medição. Um resultado favorável para um modelo, uma precisão e um nível de concorrência não descreve todas as cargas. O cliente precisa saber onde o sistema funciona bem, onde perde margem e quanta energia o serviço completo usa para entregar respostas úteis.
Três cargas fariam três perguntas diferentes
Considere um assistente documental privado para uma equipe jurídica ou de engenharia. Nesse serviço ilustrativo, as solicitações chegam irregularmente e os usuários percebem o atraso antes de a resposta começar. A avaliação deve incluir documentos representativos, tempo de busca e a primeira resposta do modelo. Um acelerador pode melhorar parte do caminho enquanto uma busca documental ou verificação de acesso continua causando a maior demora.
Um segundo exemplo é um agente interno que chama um modelo várias vezes para concluir uma tarefa. Uma geração lenta pode afetar várias etapas dependentes. O resultado útil é o tempo necessário para terminar uma tarefa corretamente autorizada, incluindo os resultados das ferramentas e eventuais aprovações humanas. Aumentar a taxa de tokens só ajuda a parte que realmente espera pela geração.
Um terceiro exemplo é uma fila noturna que classifica ou resume uma grande coleção de registros. Ela pode aceitar lotes maiores e priorizar o total concluído antes do prazo. Essa carga pode preferir uma configuração diferente da de um assistente interativo, mesmo com o mesmo modelo. A análise de compra deve preservar essa distinção, em vez de escolher a demonstração com o maior número na manchete.
Esses cenários são planos de avaliação, não testes do L2000. Eles mostram por que vale acompanhar uma arquitetura centrada na memória sem presumir um único resultado de desempenho. O melhor piloto começa com uma carga que a equipe já entende e um resultado que pode comparar ao sistema atual.
| Decisão | O que a equipe deve trazer | O que o resultado precisa mostrar |
|---|---|---|
| Assistente documental privado | Perguntas, documentos e regras de acesso representativos | Respostas úteis chegam dentro da meta de resposta acordada |
| Agente interno de várias etapas | Tarefas completas, chamadas de ferramentas e pontos de aprovação | A conclusão de ponta a ponta melhora sem perder correção |
| Fila de processamento noturna | Conjunto fixo de registros e prazo de conclusão | O trabalho necessário termina com confiabilidade dentro do orçamento operacional |
Uma meta de largura de banda é um dos dados para estimar o serviço
Nossa visão é que a comparação mais útil começa pelo trabalho comprado. Uma equipe não compra largura de banda isoladamente: compra a capacidade de concluir tarefas sob restrições. Isso exige uma cadeia de evidências do modelo e do ambiente de execução até o servidor e a aplicação.
Comece pelo suporte a modelos. A arquitetura exata, a precisão e os operadores necessários precisam funcionar na pilha de software com suporte. Um compilador ou ambiente capaz de rodar uma demonstração ainda pode deixar trabalho de integração para a produção. Pergunte quais versões são suportadas, quais operações precisam de conversão e quem mantém esse caminho quando o modelo muda.
Depois, separe as métricas de resposta. Tempo até a primeira resposta útil, velocidade durante a geração e total de solicitações concluídas descrevem experiências diferentes. Registre-as com os mesmos tamanhos de entrada e concorrência, incluindo falhas e respostas incompletas. Uma execução mais rápida que muda a qualidade ou descarta solicitações silenciosamente é um resultado diferente de uma melhoria do serviço.
Por fim, recoloque a aplicação ao redor do modelo. Busca, moderação, acesso a ferramentas, filas e tráfego de rede também consomem tempo. Um piloto de hardware deve mostrar quanto da tarefa completa fica esperando pela inferência. Assim, a equipe consegue estimar de forma razoável o benefício real de um caminho de inferência mais rápido.
O próximo marco visível é entregar o projeto à fabricação
A meta anunciada para o tape-out é o primeiro trimestre de 2027: quando os dados finais do projeto são entregues à fabricação. É um marco de desenvolvimento, não a data de entrega de um servidor pronto. Roteiro de desenvolvimento da PFN
Fabricação, encapsulamento, ativação inicial e validação ainda precisam ligar o projeto a um produto utilizável. A qualificação de software e a integração do sistema determinam depois o que os clientes podem implantar. Avançar nessas etapas pode gerar notícias importantes antes do início das vendas gerais, mas cada etapa responde a uma pergunta diferente.
O mesmo cuidado vale para a base da comparação. O próprio L1000 está previsto para 2027, portanto o anúncio compara gerações em desenvolvimento, não dois sistemas disponíveis hoje. Não há preço de varejo publicado do L2000, calendário de entrega na Coreia ou benchmark do sistema final no anúncio. Um cronograma de compra deve se basear na configuração com suporte e nas condições de entrega que o fornecedor vier a oferecer.
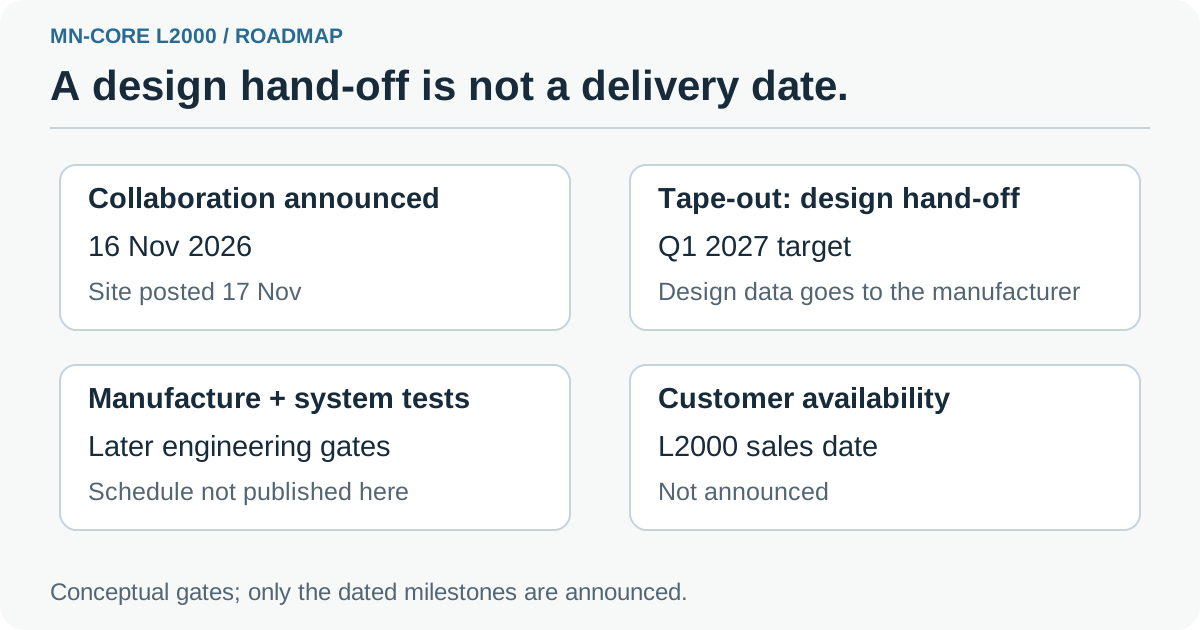
Guia original das etapas de desenvolvimento. A meta de tape-out anunciada aparece separada das etapas posteriores de fabricação, qualificação e entrega ao cliente; essas datas continuam em aberto.
O que um arquivo de avaliação prática deve conter
Uma equipe pode fazer trabalho útil enquanto acompanha o roteiro. Ela deve produzir uma base compacta que continue valendo, quer a compra futura seja um sistema MN-Core, um servidor GPU ou um serviço hospedado. O objetivo é tornar as comparações futuras mais baratas e relevantes.
- Escolha o trabalho completo. Defina uma tarefa interativa e, se for o caso, uma tarefa em lote. Registre o que conta como conclusão correta e o prazo de resposta ou término.
- Fixe os materiais de teste e as versões de software. Mantenha juntos prompts, documentos, revisão do modelo, precisão e configurações de execução. Use material que a equipe tenha autorização para processar.
- Meça o caminho atual. Registre o tempo de resposta do modelo, o tempo total, falhas e uso de recursos sob a carga esperada. Observe quando o serviço espera por busca ou ferramentas, em vez de geração.
- Peça uma configuração equivalente com suporte. Um teste futuro do fornecedor deve identificar acelerador, memória, host, ambiente de execução e modelos suportados. Mantenha visíveis as alterações de qualidade ou precisão.
- Compare a decisão operacional. Inclua aquisição, integração de software, eletricidade, refrigeração, suporte e recuperação. Julgue se a melhoria resolve a tarefa original a um custo aceitável.
Esse arquivo é mais útil do que uma coleção de capturas de vazão sem relação entre si. Ele impede a equipe de mudar a carga sempre que surge um novo sistema. Também facilita identificar um ganho real: o mesmo trabalho, concluído corretamente, com menos atraso ou menor esforço operacional.
Para uma equipe pequena, a decisão imediata pode ser continuar com o hardware atual e melhorar a aplicação. Se a busca domina o tempo de resposta, acelerar só a inferência terá efeito limitado. Se o serviço espera constantemente pela geração sob a carga necessária, um novo acelerador se torna um candidato de teste mais relevante. As duas descobertas ajudam a direcionar o gasto ao gargalo que afeta os usuários.
A história do hardware está se aproximando da memória
Vale acompanhar a colaboração L2000 porque ela conecta um problema de inferência ao projeto físico e à produção necessários para enfrentá-lo. As próximas evidências úteis serão avanços de fabricação e qualificação de software, seguidos de medições em sistemas com suporte. Esses resultados mostrarão quais cargas se beneficiam e o que um operador precisa investir para obter esse benefício.
Por enquanto, a lição prática já está disponível. Separe capacidade do modelo, movimentação de dados e resultados da aplicação ao comparar hardware de IA. Um modelo caber na memória é o início da conversa; um serviço confiável é o resultado de que o comprador precisa.
Fontes
- Preferred Networks, PFN e SEMIFIVE colaboram no desenvolvimento da série MN-Core L2000, comunicado datado de 16 de novembro de 2026 e publicado no site em 17 de novembro de 2026. Inclui o diagrama oficial e o cronograma de desenvolvimento.
- Preferred Networks, anúncio em japonês, o comunicado correspondente da empresa.
- Shashank Verma e Neal Vaidya, NVIDIA Technical Blog, Mastering LLM Techniques: Inference Optimization, 17 de novembro de 2023. Contexto sobre fases de inferência, lotes e memória, não um benchmark do hardware MN-Core.
Guarde juntos a carga, as configurações do modelo e as respostas dos fornecedores para começar a próxima avaliação em uma base comparável. Crie sua primeira nota com o Telli.sh.