Warum PFN den Speicher auf seinem nächsten KI-Chip stapeln will
Die Zusammenarbeit von PFN und SEMIFIVE beim MN-Core L2000 zielt auf einen Speicherengpass der KI-Inferenz. Was der Entwicklungsplan für Agenten, private KI und künftige Hardwarekäufe bedeutet.
Ein KI-Assistent kann genügend Speicher zum Laden eines Modells haben und trotzdem bei jeder Antwort langsam wirken. Die Recheneinheiten sind bereit, doch sinnvolle Berechnungen hängen davon ab, dass die richtigen Daten im richtigen Moment ankommen. Für ein Unternehmen mit mehreren privaten Assistenten kann dieser Unterschied aus beeindruckenden Chipdaten unangenehme Wartezeiten zwischen den Wörtern machen.
Preferred Networks und SEMIFIVE setzen bei ihrer Entwicklung auf dieses Problem. Ihre Ankündigung vom 16. November 2026 beschreibt die MN-Core-L2000-Serie, einen auf Inferenz ausgerichteten Prozessor mit vertikal gestapelter Logik und DRAM. Das erklärte Ziel ist mehr als die doppelte Speicherbandbreite der vorhergehenden L1000-Serie. PFN veröffentlichte die Mitteilung am 17. November auf seiner Website. Ankündigung von PFN
Interessant ist, was dieser Entwurf für die späteren Betreiber von KI-Diensten ändern könnte. Schnellere Datenbewegung kann ebenso wichtig sein wie zusätzliche Rechenleistung; Gehäusetechnik, Softwareunterstützung und der fertige Server bestimmen jedoch, ob der Nutzen auf dem Bildschirm ankommt. Die L2000-Ankündigung hilft, diese Entscheidungen vor einem späteren Kauf zu durchdenken.
Das Unternehmen hinter PLaMo entwickelt auch die darunterliegende Technik
Preferred Networks ist ein KI-Unternehmen aus Tokio, das Prozessoren, Recheninfrastruktur und die Modellfamilie PLaMo entwickelt. Bei dieser Zusammenarbeit verantwortet PFN Prozessorarchitektur und Logikdesign; SEMIFIVE übernimmt Implementierung und Lieferkettendienste auf Grundlage der Plattform und 3D-IC-Entwurfsinfrastruktur von Samsung Foundry. Unternehmen und Entwicklungsaufgaben bei PFN
Diese Arbeitsteilung zählt, weil ein brauchbarer Beschleuniger mehr als ein Befehlssatz oder eine Chipzeichnung ist. Aus dem Logikdesign muss herstellbares Silizium werden, der Speicher muss angebunden sein, und die verpackten Bauteile müssen zuverlässig funktionieren. Kunden benötigen am Ende eine reproduzierbare Serverkonfiguration und einen Softwareweg vom Modell zur Anwendung. Jede Übergabe kann Kosten und Liefertermin des fertigen Produkts beeinflussen.
Der Bezug zu PLaMo bietet einen vertrauten Einstieg, belegt aber nicht, dass jede PLaMo-Installation auf diese Hardware umzieht. Modellentwickler und Infrastrukturkäufer stellen außerdem unterschiedliche Fragen. Entwickler prüfen, ob sich eine Aufgabe effizient ausdrücken lässt; Käufer fragen, ob die unterstützte Umsetzung über die Lebensdauer der Installation ein Dienstziel erfüllen kann.
Für koreanische Leser zeigt SEMIFIVEs Beteiligung konkret, wie lokale Kompetenz im Halbleiterdesign zur Inferenzinfrastruktur beiträgt. Die nächste sinnvolle Frage lautet, wie daraus Serienbauteile und unterstützte Systeme entstehen. Eine Kooperationsmeldung benennt Beteiligte und Richtung; erst die nachfolgenden Produkte bestimmen die verfügbaren Kundenoptionen.
Speicherkapazität und Speicherbandbreite beantworten unterschiedliche Fragen
Kapazität beschreibt, wie viele Daten ein Speichersystem aufnehmen kann. Bandbreite beschreibt die Datenmenge, die es in einem bestimmten Zeitraum bewegen kann. Ein Modell kann die erste Grenze einhalten, während die zweite begrenzt, wie schnell der Prozessor arbeitet. Mehr Kapazität allein garantiert keine reaktionsschnellere Anwendung.
Eine einfache Planungsrechnung verdeutlicht den ersten Unterschied. Ein hypothetisches dichtes Modell mit 30 Milliarden Parametern und zwei Bytes pro Parameter benötigt allein dafür etwa 60 Milliarden Bytes. Laufzeit-Arbeitsbereiche, zwischengespeicherte Aufmerksamkeitsdaten und weiterer Aufwand sind nicht enthalten. Das veranschaulicht eine Speicherplanung und ist keine Aussage über L2000-Kapazität oder unterstützte Modelle.
Danach stellt sich die Frage, wie die Aufgabe die gespeicherten Daten nutzt. Die Verarbeitung einer Eingabe und die schrittweise Erzeugung von Ausgabetokens beanspruchen das System unterschiedlich. NVIDIAs Leitfaden zur Inferenzoptimierung trennt die parallele Eingabeverarbeitung vom autoregressiven Decoding, bei dem Datenbewegung zum Engpass werden kann. Er erläutert auch den Einfluss von Batching und Aufmerksamkeitscache-Verwaltung. NVIDIAs Leitfaden zur Inferenzoptimierung vom 17. November 2023
Stellen Sie sich den Speicher als Vorratskammer mit einem Durchgang zur Küche vor. Eine größere Kammer hält mehr Zutaten bereit; ein breiterer Durchgang bringt sie schneller zur Verarbeitung. Beides sagt noch nicht, wie lange ein bestimmtes Gericht dauert, denn Zubereitung und übriger Ablauf zählen ebenfalls. Hardwarevergleiche werden nützlicher, wenn diese Aufgaben getrennt sichtbar bleiben.
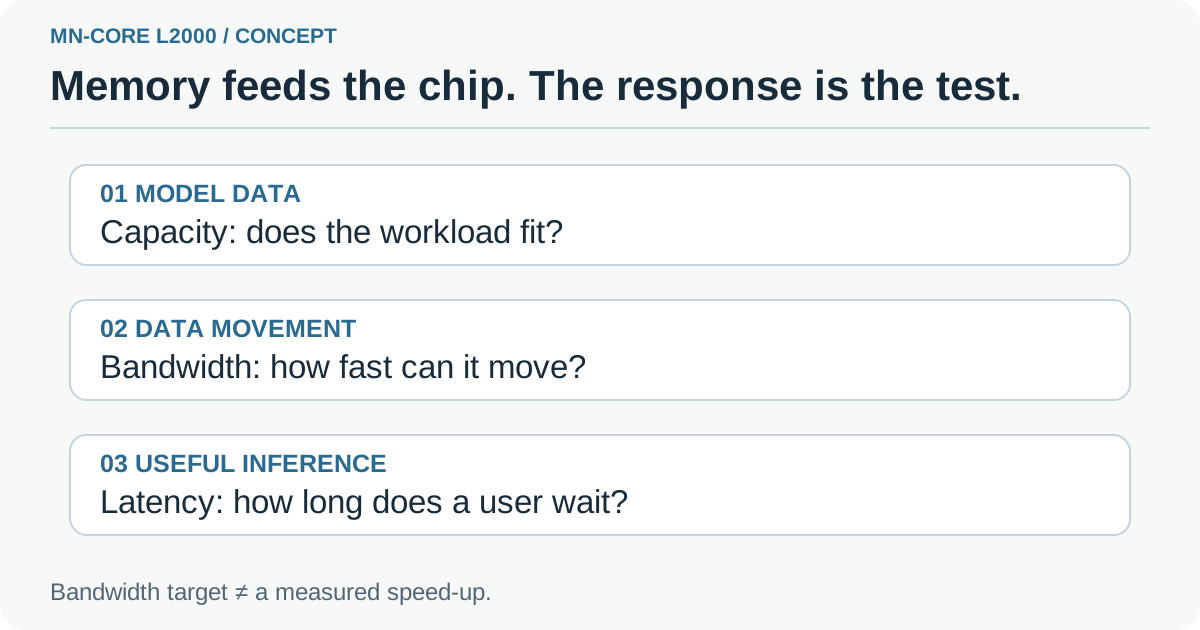
Eigenes Erklärungsschaubild zur Trennung von Speicherung, Datenbewegung und Anwendungsreaktion. Es veranschaulicht die Entscheidung, ohne einen unveröffentlichten L2000-Gehäuseaufbau darzustellen.
Das Stapeln verändert die Entwicklungsaufgabe ebenso wie den Datenpfad
PFNs offizielle Ankündigung enthält eine Darstellung der vertikal gestapelten Logik und des DRAM der MN-Core-L-Serie. Sie zeigt die vorgeschlagene Richtung anschaulich. Den vollständigen, beim Kunden installierten Server oder die Leistung einer fertigen Anwendung belegt sie nicht.
Ein Stapel von Komponenten muss als physisches System funktionieren. Stromversorgung, Wärmeabfuhr und gleichbleibende Fertigungsqualität gehören ebenso zur Diskussion wie Datenbewegung. Das sind keine nachträglichen Aufgaben, die erst nach einer attraktiven Architekturfolie entstehen. Sie bestimmen mit, ob sich Bauteile zu sinnvollen Kosten herstellen, verpacken, kühlen und betreuen lassen.
Für Betreiber ist das Gehäusedesign daher der Beginn einer Prüfung. Ein Rack besitzt einen Leistungsrahmen, ein Standort ein Kühlkonzept und der Dienst eine Verfügbarkeitserwartung. Ein vorgeschlagener Beschleuniger muss später zu allen drei passen. Der wirtschaftliche Nutzen hängt von der gesamten Installation einschließlich der für den Betrieb benötigten Geräte und Arbeit ab.
Deshalb müssen Effizienzaussagen ihre Messbedingungen mitbringen. Ein günstiges Ergebnis für ein Modell, eine Genauigkeit und eine Parallelitätsstufe beschreibt nicht jede Aufgabe. Kunden müssen sehen, wo das System gut arbeitet, wo Reserven ausgehen und wie viel Energie der gesamte Dienst für brauchbare Antworten benötigt.
Drei Aufgaben stellen drei unterschiedliche Fragen
Denken Sie an einen privaten Dokumentenassistenten für eine Rechts- oder Ingenieurabteilung. Dieser beispielhafte Dienst erhält unregelmäßige Anfragen; Nutzer bemerken die Wartezeit bis zum Antwortbeginn. Seine Prüfung sollte typische Dokumente, Suchdauer und erste Modellantwort einschließen. Ein Beschleuniger kann einen Teil verbessern, während Dokumentensuche oder Zugriffsprüfung weiterhin mehr Zeit beanspruchen.
Ein zweites Beispiel ist ein interner Agent, der während einer Aufgabe wiederholt ein Modell aufruft. Eine langsame Generierung kann mehrere abhängige Schritte verzögern. Relevant ist die Zeit bis zum Abschluss einer korrekt autorisierten Aufgabe einschließlich Werkzeugergebnissen und gegebenenfalls menschlicher Freigabe. Eine höhere Tokenrate hilft nur dem tatsächlich auf Generierung wartenden Teil.
Ein drittes Beispiel ist eine nächtliche Warteschlange zur Klassifizierung oder Zusammenfassung großer Datensammlungen. Sie verträgt größere Batches und legt mehr Wert auf abgeschlossene Arbeit vor einem Termin. Diese Aufgabe kann eine andere Konfiguration bevorzugen als ein interaktiver Assistent, selbst bei identischem Modell. Ein Einkaufsvergleich sollte den Unterschied bewahren und nicht einfach die größte Vorführzahl wählen.
Diese Szenarien sind Prüfpläne, keine L2000-Tests. Sie zeigen, warum eine speicherorientierte Architektur Beachtung verdient, ohne ein bestimmtes Leistungsergebnis vorauszusetzen. Der beste Pilot beginnt mit einer bekannten Aufgabe und einem Ergebnis, das sich mit dem bisherigen System vergleichen lässt.
| Entscheidung | Was das Team mitbringen sollte | Was das Ergebnis zeigen muss |
|---|---|---|
| Privater Dokumentenassistent | Typische Fragen, Dokumente und Zugriffsregeln | Brauchbare Antworten innerhalb des vereinbarten Reaktionsziels |
| Mehrstufiger interner Agent | Vollständige Aufgaben, Werkzeugaufrufe und Freigabepunkte | Besserer Gesamtablauf ohne Verlust an Korrektheit |
| Nächtliche Verarbeitung | Fester Datenbestand und Abschlusstermin | Zuverlässiger Abschluss innerhalb des Betriebsbudgets |
Ein Bandbreitenziel ist ein Baustein der Dienstabschätzung
Aus unserer Sicht beginnt der nützlichste Vergleich mit der eingekauften Arbeit. Ein Team kauft Bandbreite nicht isoliert, sondern die Möglichkeit, Aufgaben unter bestimmten Bedingungen abzuschließen. Dafür ist eine Beweiskette vom Modell und der Laufzeitumgebung bis zu Server und Anwendung erforderlich.
Beginnen Sie mit der Modellunterstützung. Exakte Architektur, Genauigkeit und benötigte Operatoren müssen im unterstützten Softwarepaket funktionieren. Ein Compiler oder eine Laufzeitumgebung für eine Vorführung kann dennoch Integrationsarbeit im Produktivdienst hinterlassen. Fragen Sie nach unterstützten Versionen, Konvertierungsbedarf und der Verantwortung bei Modelländerungen.
Trennen Sie anschließend die Reaktionsmaße. Zeit bis zur ersten brauchbaren Antwort, Generierungsgeschwindigkeit und insgesamt erledigte Anfragen beschreiben unterschiedliche Erfahrungen. Erfassen Sie sie mit denselben Eingabegrößen und derselben Parallelität, einschließlich fehlgeschlagener oder unvollständiger Antworten. Ein schnellerer Lauf mit geänderter Qualität oder still verworfenen Anfragen ist ein anderes Ergebnis als ein besserer Dienst.
Setzen Sie schließlich die Anwendung wieder um das Modell herum. Suche, Moderation, Werkzeugzugriffe, Warteschlangen und Netzwerkverkehr benötigen ebenfalls Zeit. Ein Hardwarepilot sollte zeigen, welcher Anteil der Gesamtaufgabe auf Inferenz wartet. Daraus lässt sich der tatsächlich erwartbare Vorteil eines schnelleren Inferenzpfads sinnvoller abschätzen.
Der nächste sichtbare Meilenstein ist die Übergabe des Designs
Das angekündigte Tape-out-Ziel ist das erste Quartal 2027: die Übergabe der endgültigen Entwurfsdaten an die Fertigung. Das ist ein Entwicklungsmeilenstein und kein Lieferdatum eines fertigen Servers. PFNs Entwicklungsplan
Fertigung, Packaging, Inbetriebnahme und Validierung müssen das Design noch in ein brauchbares Produkt überführen. Softwarequalifizierung und Systemintegration bestimmen anschließend die Einsatzmöglichkeiten für Kunden. Fortschritte können lange vor einem allgemeinen Verkaufsstart wichtige Neuigkeiten liefern, doch jede Stufe beantwortet eine eigene Frage.
Dieselbe Sorgfalt gilt für die Vergleichsbasis. Auch L1000 ist für eine Veröffentlichung 2027 vorgesehen; die Meldung vergleicht somit Entwicklungsgenerationen statt zweier heute kaufbarer Systeme. Einen öffentlichen L2000-Verkaufspreis, koreanischen Lieferplan oder Benchmark eines fertigen Systems enthält sie nicht. Ein Kaufzeitplan sollte sich später auf die unterstützte Konfiguration und Lieferbedingungen eines Anbieters stützen.
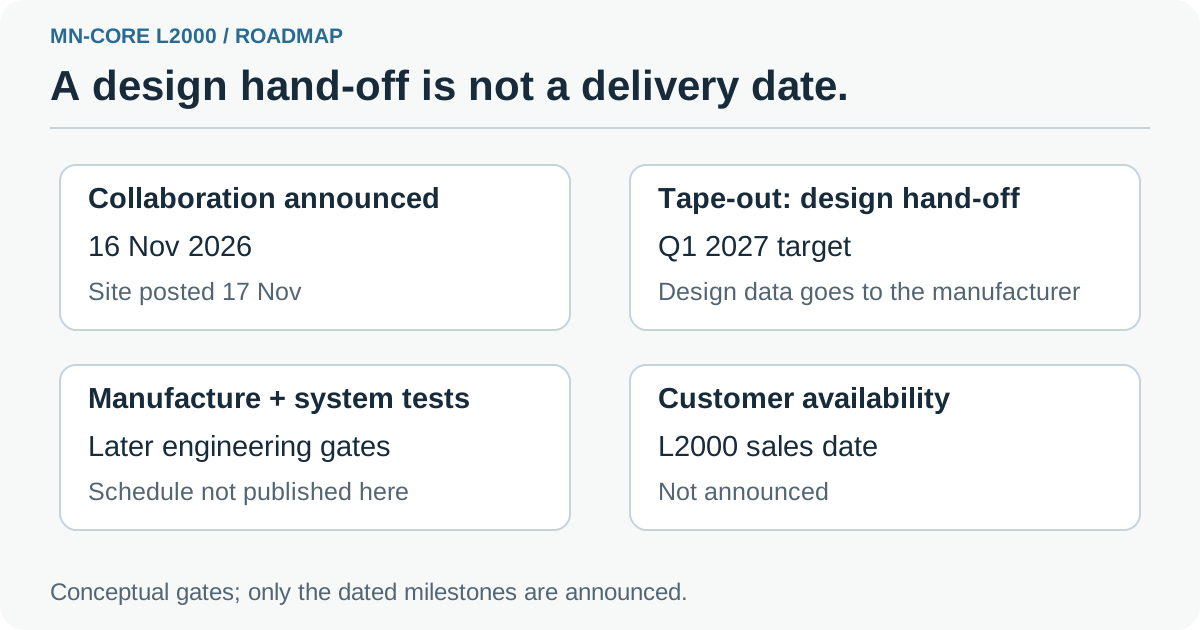
Eigener Leitfaden zu Entwicklungsstufen. Das angekündigte Tape-out-Ziel ist von späterer Fertigung, Qualifizierung und Kundenauslieferung getrennt; deren Termine bleiben offen.
Was eine praktische Prüfakte enthalten sollte
Ein Team kann während der Beobachtung des Entwicklungsplans bereits sinnvoll arbeiten. Es sollte eine kompakte Vergleichsbasis erstellen, die auch beim späteren Kauf eines MN-Core-Systems, GPU-Servers oder gehosteten Dienstes nützlich bleibt. Ziel sind günstigere und aussagekräftigere künftige Hardwarevergleiche.
- Die vollständige Aufgabe wählen. Definieren Sie eine interaktive Aufgabe und bei Bedarf einen Batchauftrag. Halten Sie fest, was als korrekter Abschluss gilt und welche Antwort- oder Abschlussfrist besteht.
- Testmaterial und Softwareversionen festhalten. Bewahren Sie Prompts, Eingabedokumente, Modellstand, Genauigkeit und Laufzeiteinstellungen gemeinsam auf. Verwenden Sie Material, dessen Verarbeitung erlaubt ist.
- Den bisherigen Ablauf messen. Erfassen Sie Modellantwortzeit, Gesamtzeit, Fehler und Ressourcenbedarf unter erwarteter Last. Notieren Sie, wann der Dienst auf Suche oder Werkzeuge statt auf Generierung wartet.
- Eine passende unterstützte Konfiguration anfordern. Ein späterer Anbietertest sollte Beschleuniger, Speicheraufbau, Host, Laufzeitumgebung und Modellunterstützung benennen. Änderungen an Qualität oder Genauigkeit müssen sichtbar bleiben.
- Die Betriebsentscheidung vergleichen. Beziehen Sie Anschaffung, Softwareintegration, Strom, Kühlung, Support und Wiederherstellung ein. Prüfen Sie, ob die Verbesserung die ursprüngliche Aufgabe zu akzeptablen Kosten löst.
Diese Akte ist nützlicher als eine Sammlung unzusammenhängender Durchsatzbilder. Sie verhindert, dass das Team bei jedem neuen System die Aufgabe verändert. Echte Verbesserungen werden so leichter erkennbar: dieselbe Arbeit, gut erledigt, mit weniger Wartezeit oder geringerem Betriebsaufwand.
Für ein kleines Team kann die unmittelbare Entscheidung lauten, die bisherige Hardware weiterzuverwenden und die Anwendung zu verbessern. Dominiert die Suche die Antwortzeit, hilft schnellere Inferenz allein wenig. Wartet der Dienst unter erforderlicher Last regelmäßig auf Generierung, wird ein neuer Beschleuniger ein relevanterer Testkandidat. Beide Erkenntnisse lenken Ausgaben zum nutzerrelevanten Engpass.
Die Hardwaregeschichte rückt näher an den Speicher
Die L2000-Zusammenarbeit lohnt die Beobachtung, weil sie ein Inferenzproblem mit dem physischen Design und der notwendigen Produktionsarbeit verbindet. Als Nächstes zählen Fortschritte bei Fertigung und Softwarequalifizierung sowie Messungen auf unterstützten Systemen. Sie werden zeigen, welche Aufgaben profitieren und was Betreiber dafür investieren müssen.
Die praktische Lehre ist schon jetzt verfügbar. Halten Sie Modellkapazität, Datenbewegung und Anwendungsergebnisse beim Hardwarevergleich auseinander. Dass ein Modell in den Speicher passt, eröffnet das Gespräch; ein verlässlicher Dienst ist das benötigte Ergebnis.
Quellen
- Preferred Networks, PFN und SEMIFIVE entwickeln gemeinsam die MN-Core-L2000-Serie, Datierung der Mitteilung 16. November 2026; Websiteveröffentlichung 17. November 2026. Enthält offizielle Strukturzeichnung und Entwicklungsplan.
- Preferred Networks, japanischsprachige Ankündigung, die entsprechende Unternehmensmitteilung.
- Shashank Verma und Neal Vaidya, NVIDIA Technical Blog, Mastering LLM Techniques: Inference Optimization, 17. November 2023. Hintergrund zu Inferenzphasen, Batching und Speicherbedarf, kein Benchmark von MN-Core-Hardware.
Bewahren Sie Aufgabe, Modelleinstellungen und Anbieterantworten gemeinsam auf, damit die nächste Prüfung auf einer vergleichbaren Basis beginnt. Erstellen Sie Ihre erste Notiz mit Telli.sh.