Un modello anonimo ha bruciato 26.000 miliardi di token in quattro giorni. Il listino è arrivato dopo: 24 centesimi.
Il 20 agosto 2026 su OpenRouter è comparso un modello senza laboratorio, senza scheda tecnica e senza prezzo, con il nome stealth/ox-alpha. Quattro giorni dopo gli utenti di OpenCode ci avevano fatto passare 26.000 miliardi di token. Sei giorni dopo Z.AI lo ha rivendicato: GLM-5.3-Flash, 320 miliardi di parametri, licenza MIT, 0,15 dollari per milione di token in ingresso. Perché i laboratori pubblicano ormai modelli senza il proprio nome, cosa misurano davvero quei numeri di traffico e cosa comporta un prezzo misto di 24 centesimi per l'economia delle pipeline vocali.
Il 20 agosto 2026 su OpenRouter è comparso un modello con lo slug stealth/ox-alpha. Nessun laboratorio associato. Nessuna scheda tecnica, nessuna tabella di benchmark, nessun thread di annuncio. Il campo prezzo indicava 0 dollari in ingresso, 0 dollari in uscita. Aveva però una finestra di contesto da 1.048.576 token, input di testo, immagini e video, e una descrizione di una riga sull'ingegneria del software di lungo periodo.
Quattro giorni dopo, OpenCode ha comunicato che i suoi utenti ci avevano fatto passare 26.000 miliardi di token.
Sei giorni dopo, Z.AI ha confermato a Bloomberg che il modello era suo, ha pubblicato i pesi sotto licenza MIT e vi ha allegato un listino: quindici centesimi per milione di token in ingresso, cinquanta centesimi per milione in uscita. Il nome è GLM-5.3-Flash. La parola «Flash» in quella frase svolge un lavoro enorme, ed è il motivo per cui scriviamo questo articolo.
Questo è un commento, non una cronaca di lancio. Quello che segue è la cronologia dei sei giorni con i numeri di traffico e i loro asterischi, un argomento sul perché i laboratori pubblicano sempre più spesso modelli senza il nome di nessuno, le specifiche e i punteggi indipendenti ora che l'identità è nota, un elenco esplicito delle affermazioni che non siamo riusciti a verificare e un calcolo dettagliato di cosa faccia un prezzo misto di 24 centesimi al costo di elaborare il parlato. È il seguito diretto del nostro prima e dopo sulla rimonta dei modelli locali, e va nella stessa direzione: il prezzo di un'intelligenza artificiale competente continua a scendere, più in fretta di quanto assumano la maggior parte delle roadmap di prodotto.
In sintesi:
- Il traffico è stato reale e da record. 26.000 miliardi di token su OpenCode in quattro giorni con 327.000 utenti unici, e 11.600 miliardi su OpenRouter in tre giorni: il più grande lancio di modello nella storia di OpenRouter, contro un precedente record di 4.400 miliardi.
- L'identità è confermata da fonte primaria. Il 26 agosto 2026 Z.AI ha dichiarato a Bloomberg che Ox Alpha era un modello della serie GLM; la pagina di OpenRouter riporta ora che il modello stealth «è stato sviluppato e gestito da ZAI, rivelato come ZAI GLM-5.3-Flash».
- La notizia è il prezzo. 320 miliardi di parametri totali con 18 miliardi attivi, licenza MIT, 0,15 dollari in ingresso e 0,50 in uscita per milione di token: 0,24 dollari misti, contro i 10,00 dollari dell'ammiraglia chiusa di sei mesi fa, che supera di 12,1 punti sull'Intelligence Index di Artificial Analysis.
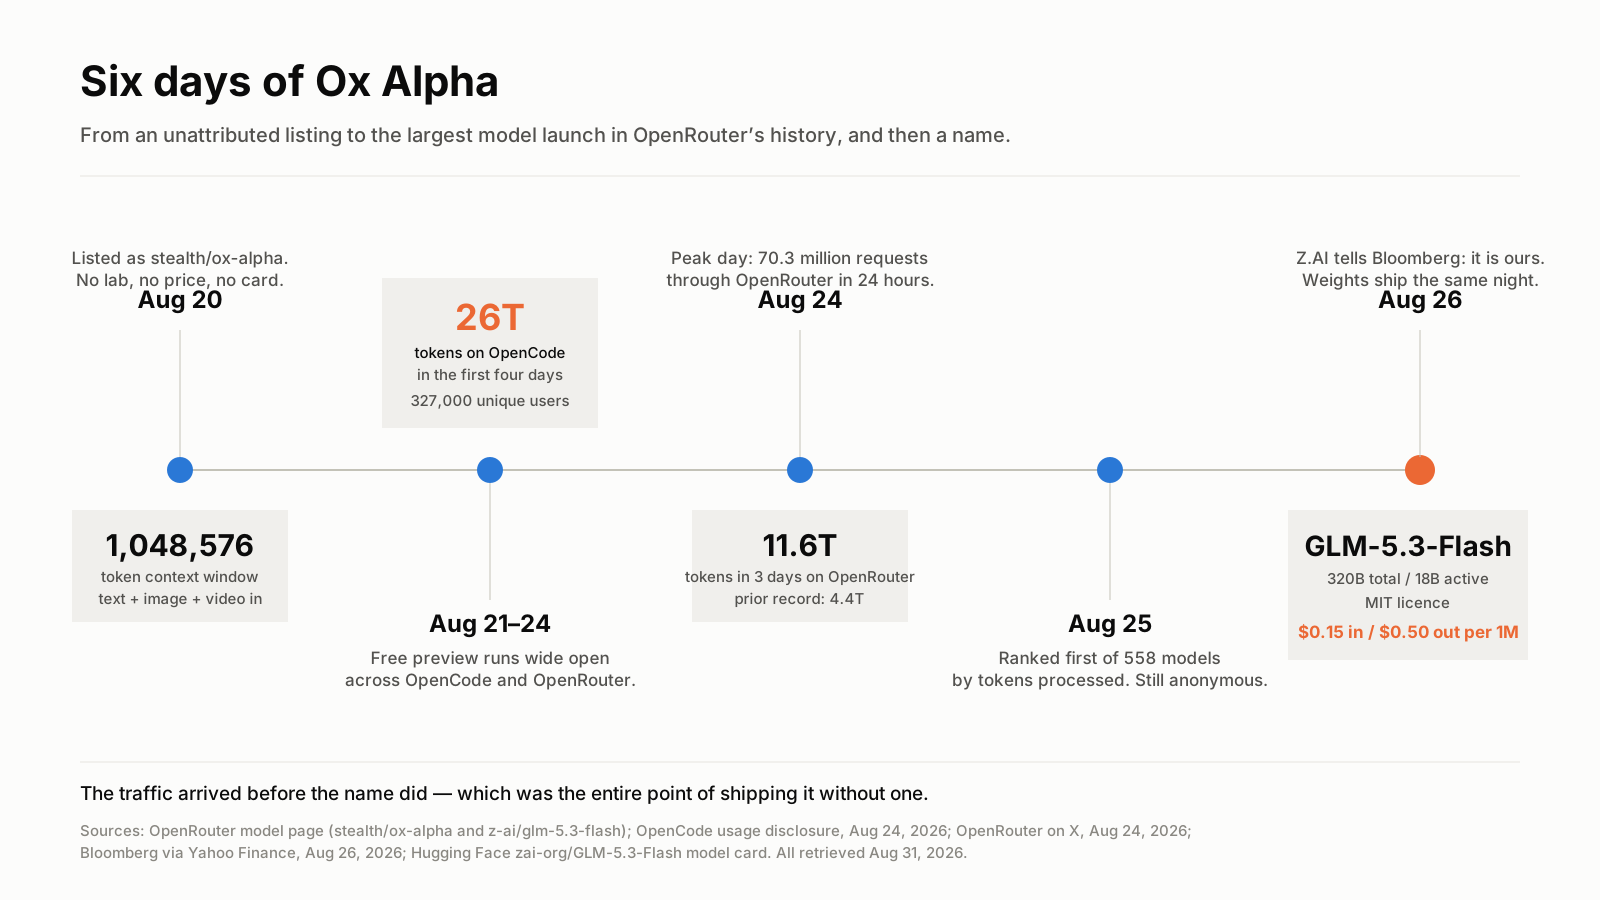
L'intera vicenda, dall'inizio alla fine, è durata meno di una settimana. Fonti in fondo all'articolo.
Sei giorni, nell'ordine in cui sono accaduti
20 agosto: la scheda va online su OpenRouter e contemporaneamente dentro OpenCode, l'agente di programmazione da terminale open source creato da Dax Raad. OpenCode lo presenta come gratuito, di fatto illimitato, senza conservazione dei dati attraverso il proprio percorso, e dichiara di aver garantito capacità fino a 100.000 miliardi di token al giorno.
Dal 21 al 24 agosto: l'utilizzo cresce ogni singolo giorno. L'endpoint di attività dei modelli di OpenRouter ha registrato 27,0 milioni di richieste il 21 agosto, 54,4 milioni il 22 (più 101,2 per cento), 63,9 milioni il 23 e 70,3 milioni il 24.
24 agosto: OpenCode pubblica i numeri. 26.000 miliardi di token nei primi quattro giorni, con 327.000 utenti unici e 8.328.244 sessioni completate, in media 3,2 milioni di token per sessione e circa 25 sessioni per utente. Ox Alpha si è così piazzato secondo tra i modelli tracciati da OpenCode, dietro DeepSeek V4 Flash a 33.000 miliardi e davanti a MiMo-V2.5 di Xiaomi a 12.000 miliardi. OpenRouter ha riportato separatamente 11.600 miliardi di token nei primi tre giorni pieni, definendolo il più grande lancio di modello nella storia della piattaforma; il precedente primatista aveva generato 4.400 miliardi nella stessa finestra iniziale.
25 agosto: l'API dei modelli di OpenRouter, ordinata per token elaborati nell'ultima settimana, colloca Ox Alpha al primo posto tra i 558 modelli restituiti. Fuori dal laboratorio nessuno sa chi lo abbia costruito.
26 agosto: Z.AI conferma a Bloomberg che Ox Alpha è un nuovo modello della sua serie GLM. I pesi escono la stessa notte. Il post di lancio dell'azienda afferma di aver testato GLM-5.3-Flash in forma anonima come ox-alpha su OpenCode e OpenRouter «per raccogliere feedback dagli utenti», e la pagina stealth di OpenRouter viene modificata indicando che il modello «è stato sviluppato e gestito da ZAI, rivelato come ZAI GLM-5.3-Flash».
Il numero sul traffico è reale. Ma non è un verdetto sulla qualità.
È qui che gran parte della copertura ha sbagliato, quindi mettiamo a fuoco: cosa misura esattamente quella cifra di 26.000 miliardi di token?
Misura il throughput di un endpoint gratuito con una finestra da un milione di token, consumato soprattutto da agenti di programmazione. La dashboard di OpenCode indica che il 93 per cento dei token in ingresso è stato servito dalla cache: lo stesso contesto di repository, riletto più e più volte nel corso di una sessione lunga. Una classifica ordinata per token elaborati regala un vantaggio meccanico enorme a qualunque modello gratuito con una finestra gigantesca, perché gli harness degli agenti reimmettono il contesto, ritentano le chiamate agli strumenti fallite e rimandano l'output degli strumenti nel prompt. Le sessioni lunghe gonfiano il numero per costruzione.
La cifra dei 100.000 miliardi di token al giorno merita lo stesso trattamento. Era OpenCode che descriveva la capacità di servizio aggregata, non l'utilizzo erogato né una quota per utente. L'utilizzo effettivo si è attestato in media sui 6.500 miliardi di token al giorno nei primi quattro giorni: il 6,5 per cento del tetto pubblicizzato. L'analista Teortaxes ha osservato che generare 100.000 miliardi di token in uscita al giorno a 80 token al secondo richiederebbe circa 580.000 equivalenti GPU, che è esattamente il tipo di numero che dovrebbe spingerti a chiedere cosa si stia contando prima di rilanciarlo.
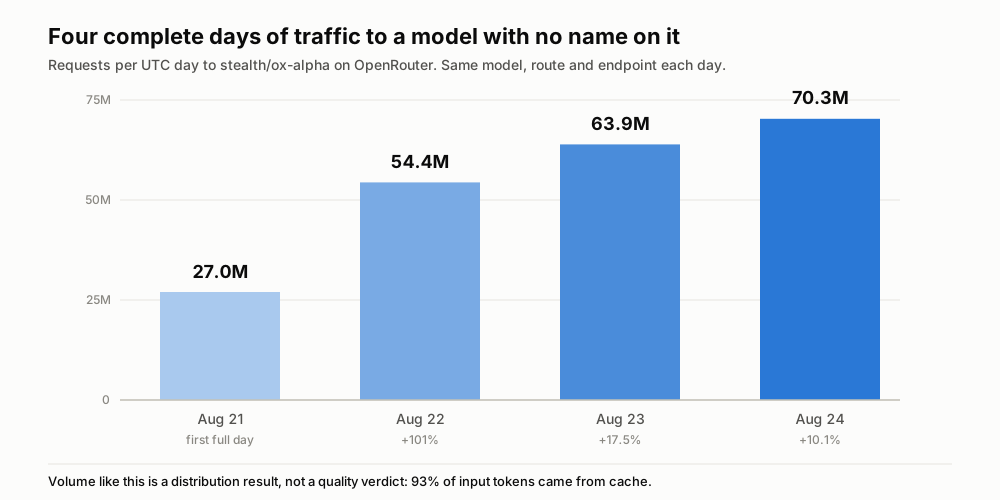
Richieste giornaliere dall'endpoint di attività dei modelli di OpenRouter, snapshot in cache al 25 agosto 2026. La piattaforma può rivedere questi valori.
Che cosa dimostra allora davvero il traffico? Che un modello gratuito di forma frontiera con una finestra da un milione di token, calato nei due posti dove gli agenti di programmazione già vivono, satura la domanda in 24 ore. È un risultato di distribuzione, e i risultati di distribuzione meritano di essere studiati per quello che sono. Non dice nulla su quanto il modello sia bravo sul tuo repository.
Perché oggi un laboratorio pubblica un modello senza il proprio nome
Ecco il passaggio, e lo segnaliamo con chiarezza: tutto quanto precede è misurazione, quello che segue è la nostra lettura.
Pubblicare in forma anonima compra a un laboratorio tre cose che non può ottenere in altro modo. Chiamiamo questa combinazione il dividendo dell'anonimato.
La prima è una valutazione pulita. Ogni rilascio firmato atterra dentro un pregiudizio. Un modello di un laboratorio cinese viene giudicato in base a «sorprendentemente buono per un modello aperto»; uno di un laboratorio di frontiera statunitense in base a «vale l'aumento di prezzo?». Togli il nome e a chi sviluppa resta solo l'output a cui reagire. Le valutazioni tornate durante la settimana stealth sono state fatte da persone che non avevano idea di quale modello stessero elogiando: la cosa più costosa da fabbricare nel marketing dell'IA e la più economica da ottenere semplicemente non dicendo nulla.
La seconda è il volano. Il mistero è la campagna. Nessuno scrive un post forense su un aggiornamento di versione di routine, ma una settimana di impronte del tokenizer, analisi dello strato di serving e speculazioni produce un volume enorme di copertura che il laboratorio non ha dovuto pagare. La rivelazione atterra poi su un pubblico già investito nella risposta. Z.AI ha ottenuto una settimana di attenzione gratuita e poi un giorno di lancio con la battuta finale già incorporata.
La terza è telemetria su una scala che il denaro non compra facilmente. 8,3 milioni di sessioni di agente completate, fatte di lavoro reale, disordinato, con la forma della produzione, sono un dataset. La pagina OpenRouter di Ox Alpha diceva che prompt e completamenti venivano conservati dal fornitore e esplicitamente non usati per l'addestramento — ci torniamo tra poco — ma la sola conservazione già restituisce modalità di guasto, distribuzioni di latenza, tassi di errore nelle chiamate agli strumenti e curve di degrado su contesti lunghi, su centinaia di migliaia di repository reali. Da una suite di valutazione interna non si ottiene.
Quella riga sulle condizioni relative ai dati merita una nota a parte, perché è l'unica cosa davvero insolita di questa storia. Delle quattordici schede stealth che OpenRouter ha gestito da aprile 2025, tredici riportavano una qualche versione di «prompt e completamenti sono registrati dal fornitore e potrebbero essere usati per migliorare il modello». Solo quella di Ox Alpha diceva invece: conservati, non usati per l'addestramento. Se questo ti rassicuri o meno dipende da quanto peso attribuisci a una riga di testo sulla pagina modello di una piattaforma di routing. È perlomeno una scelta deliberata, ed è la prima volta che una scheda stealth la compie.
Il nome in codice è ormai un genere
Non è una mossa inedita. È uno schema con cinque conferme di prima mano alle spalle, e conoscere quel curriculum è ciò che permette di calibrare il caso successivo.
| Nome in codice | Si è rivelato essere | Confermato da | Data | Prova |
|---|---|---|---|---|
| Quasar Alpha | GPT-4.1, snapshot OpenAI pre-rilascio | Il blog di OpenRouter | 14/04/2025 | Fonte primaria |
| Optimus Alpha | GPT-4.1, snapshot più vicino alla versione finale | Il blog di OpenRouter | 14/04/2025 | Fonte primaria |
| Horizon Alpha / Horizon Beta | Checkpoint iniziali di GPT-5 | OpenRouter, «GPT-5 is now live» | 07/08/2025 | Fonte primaria |
| Sonoma Dusk Alpha / Sonoma Sky Alpha | xAI Grok 4 Fast, versioni senza e con ragionamento | Solo deduzione della community | — | Riportato, non confermato |
| Hunter Alpha / Healer Alpha | Xiaomi MiMo | Il team MiMo di Xiaomi | 18/03/2026 | Fonte primaria |
| Owl Alpha | Meituan LongCat-2.0-Preview | Blog di Meituan e @Meituan_LongCat | 30/06/2026 | Fonte primaria |
| Cypher Alpha / Aurora Alpha | Mai chiarito | — | — | Nessuna |
| Ox Alpha | Z.AI GLM-5.3-Flash | Z.AI a Bloomberg; pagina OpenRouter modificata | 26/08/2026 | Fonte primaria |
Da questa tabella emergono due cose. Sette delle tredici schede storiche sono state alla fine confermate da una dichiarazione di prima mano, un tasso di risoluzione molto migliore di quanto suggerisca il folklore, e tre di quelle conferme sono arrivate dal laboratorio, non da OpenRouter: ecco perché le raccolte che guardano solo il blog di OpenRouter continuano a sottostimare. E il genere ha cambiato palcoscenico. Le righe del 2025 sono OpenAI e xAI. Quelle del 2026 sono Xiaomi, Meituan e Z.AI. I laboratori cinesi non hanno inventato il lancio stealth; lo hanno industrializzato.
La rivelazione: 320 miliardi totali, 18 miliardi attivi, MIT
Passiamo alle specifiche, prese dalla scheda di Z.AI stessa e non dal riassunto di qualcun altro.
GLM-5.3-Flash è descritto dai suoi autori come «il primo modello nativamente multimodale della serie GLM-5», con 320 miliardi di parametri totali e 18 miliardi attivi in una configurazione mixture-of-experts, addestrato su un corpus multimodale da 30.000 miliardi di token. L'architettura combina per la prima volta nella serie attenzione sparsa e lineare, più una tecnica che il paper chiama Manifold-Constrained Hyper-Connections. La finestra di contesto è di 1.048.576 token, con una risposta singola massima di 131.072 token. La profondità di ragionamento è esposta tramite il parametro reasoning_effort con i livelli low, high e max, con max come predefinito. La licenza è MIT: non una licenza community su misura con una soglia di utenti, ma MIT.
L'affermazione di Z.AI sulle capacità merita una citazione esatta, perché è più misurata della copertura che la circonda: il modello «supera GLM-5.2 su benchmark e carichi di lavoro reali a un decimo del prezzo, avvicinandosi a Claude Opus 4.8 sui benchmark di programmazione e di agenti». Avvicinandosi. Non superando.
Per una lettura indipendente, Artificial Analysis lo ha ormai valutato. GLM-5.3-Flash ottiene 57 sull'Artificial Analysis Intelligence Index, contro una mediana di 29 tra i modelli a pesi aperti comparabili. Eseguire l'intera suite di valutazione è costato 138,02 dollari di spesa API, cifra che citiamo perché è il singolo dato più onesto di tutto questo articolo su quanto costi oggi usare intelligenza vicina alla frontiera. La stessa valutazione segnala due debolezze reali: a 45 token in uscita al secondo il modello è lento, e ha generato 150 milioni di token per completare l'indice contro una mediana di 110 milioni, il che lo rende prolisso. La prolissità è una fattura anche quando il prezzo per token è basso.
Che un modello di fascia Flash arrivi a 57 è la vera notizia
Mettiamo i numeri uno accanto all'altro, con la stessa convenzione mista 3:1 ingresso-uscita che Epoch AI usa per i confronti di prezzo.
| Claude Opus 4.6 Max | Qwen3.8-27B | GLM-5.3-Flash | |
|---|---|---|---|
| Pubblicazione | 05/02/2026 | 14/08/2026 | 26/08/2026 |
| Pesi | Chiusi | Apache 2.0 | MIT |
| Intelligence Index | 44,9 | 52,0 | 57 |
| Prezzo per milione in ingresso | 5,00 $ | 0,45 $ | 0,15 $ |
| Prezzo per milione in uscita | 25,00 $ | 3,20 $ | 0,50 $ |
| Misto (3:1) | 10,00 $ | 1,09 $ | 0,24 $ |
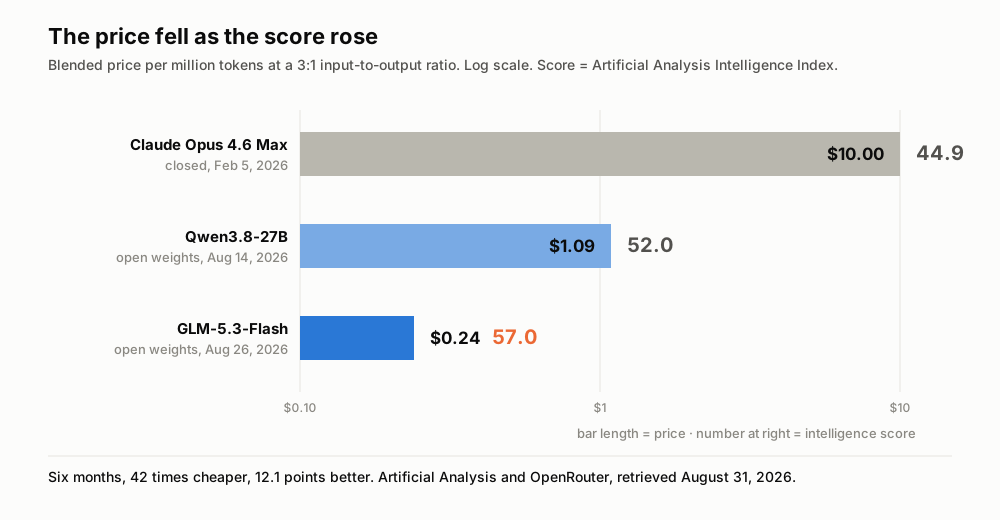
La lunghezza della barra è il prezzo; il numero a destra di ogni barra è il punteggio di intelligenza. Artificial Analysis e OpenRouter, consultati il 31 agosto 2026.
GLM-5.3-Flash costa 42 volte meno dell'ammiraglia chiusa di febbraio e la supera di 12,1 punti sullo stesso indice indipendente. Rispetto al 27B aperto di cui abbiamo scritto dieci giorni fa, è 4,6 volte più economico e 5 punti migliore. Entrambi i divari si sono aperti nel giro di sei mesi.
È la stessa curva che il nostro articolo su Qwen3.8 misurava dall'altro capo: la serie a soglia fissa di Epoch AI, che tiene costante un punteggio di benchmark e segue il modello più economico che lo raggiunge, ha rilevato che le prestazioni di livello GPT-4 sono scese da 37,50 dollari per milione di token nel marzo 2023 a 0,18 dollari nel febbraio 2025: 208 volte più economiche in 23 mesi. GLM-5.3-Flash è l'aspetto che assume quella curva quando raggiunge la frontiera attuale invece di una di tre anni fa.
E notate la fascia. Questa non è l'ammiraglia. «Flash», nella nomenclatura di qualunque laboratorio, indica il fratello economico, veloce e ad alto volume del modello con cui vogliono davvero impressionarti. Il fatto interessante non è che un laboratorio cinese abbia pubblicato un modello forte. È che la referenza economica è ormai abbastanza vicina alla frontiera da non aver svelato subito il gioco dopo una settimana di test anonimi testa a testa.
Quattro cose che non abbiamo potuto verificare, segnalate come tali
L'entusiasmo intorno a questo rilascio corre davanti alle prove in punti precisi. Eccoli.
L'affermazione che Ox Alpha «superi GPT-5.6» nei test su contesti da un milione di token proviene da articoli di terzi, non da una metodologia pubblicata che abbiamo potuto ispezionare, e il termine di paragone di Z.AI stessa è Claude Opus 4.8, non GPT-5.6. Trattate il confronto con GPT-5.6 come un'affermazione della community non verificata.
Il molto citato punteggio dell'80 per cento in pass@1 su DeepSWE non è comparabile con i valori oltre il 96 per cento su SWE-bench Verified che compaiono accanto nelle stesse tabelle. Harness diverso, insieme di compiti diverso, difficoltà diversa. Qualunque tabella li metta in righe adiacenti produce una classifica che non esiste.
L'affermazione di Z.AI secondo cui l'intera settimana stealth sarebbe stata servita su acceleratori cinesi domestici, con un miglioramento di 3x nel serving end-to-end e un costo per token paragonabile all'hardware NVIDIA, viene dal fornitore e non è stata verificata in modo indipendente. Se regge, è il dettaglio più gravido di conseguenze dell'intera storia; per ora è un'affermazione da comunicato.
E l'anteprima gratuita era un sussidio, non una fascia di listino. È finita. I prezzi attuali sono 0,15 e 0,50 dollari, con uno sconto promozionale del 50 per cento valido fino al 9 settembre 2026 alle 16:00 UTC: il numero onesto a regime è quindi quello non scontato, e il budget va fatto su 0,15 / 0,50 dollari e non su quanto costa questa settimana.
Cosa fanno 24 centesimi a una pipeline che ascolta, traduce e riassume
I prodotti vocali sono insolitamente esposti al prezzo dei token, perché generano trascrizioni e poi le rileggono ripetutamente. Ogni passaggio a valle — rifinitura, traduzione, riassunto, risposta alle domande — reingerisce lo stesso testo. Ecco l'aritmetica, con tutte le assunzioni sul tavolo.
- Partite da un'unità di lavoro reale. Una riunione di 60 minuti tra due persone, a circa 130 parole al minuto, produce circa 7.800 parole. Con etichette di parlante e marcatori temporali, contate 12.000 token di trascrizione.
- Aggiungete il passaggio di riassunto. Trascrizione completa in ingresso, note strutturate in uscita: 12.000 token in ingresso, circa 800 in uscita.
- Aggiungete la traduzione in tempo reale in tre lingue. Ogni passaggio legge la trascrizione e scrive un volume comparabile: 12.000 in ingresso e 12.000 in uscita, per tre volte.
- Sommate la riunione. 48.000 token in ingresso e 36.800 in uscita.
- Prezzatela due volte. Ai 0,15 / 0,50 dollari di GLM-5.3-Flash, quella riunione costa 2,6 centesimi. Ai 5,00 / 25,00 dollari di Claude Opus 4.6, la stessa riunione costa 1,16 dollari.
Una differenza di 45 volte su una sola ora di audio non è l'ottimizzazione di una voce di spesa. È la differenza tra una funzione di cui misuri l'uso con attenzione e una funzione che lasci accesa per impostazione predefinita. A 1,16 dollari a riunione, tradurre in tre lingue per ogni utente è una decisione che qualcuno in amministrazione deve approvare. A 2,6 centesimi, è una casella da spuntare.
È questa la parte della storia che sopravvive al nome in codice. Il lancio stealth è stato una manovra di marketing, e pure buona. Il fatto duraturo è che la fascia economica del listino di un laboratorio di media grandezza consegna oggi 57 punti di indice a 24 centesimi misti, con licenza MIT allegata così da poterlo eseguire in proprio se il prezzo dovesse mai muoversi nella direzione sbagliata.
In conclusione: la frontiera non è più il posto dove stanno i prezzi interessanti
Per tre anni la domanda sulla scelta del modello è stata «quanto vicino alla frontiera puoi permetterti di stare». I sei giorni di Ox Alpha ne hanno posta un'altra: quanta capacità si trova ormai sotto la fascia ammiraglia, prezzata come una commodity, e pubblicata da laboratori abbastanza sicuri da testarla con il proprio nome rimosso.
Il dividendo dell'anonimato si incassa solo se il modello è abbastanza buono da sopravvivere a una settimana senza marchio. Z.AI ha incassato. Il prossimo nome in codice che comparirà su una piattaforma di routing merita lo stesso trattamento riservato a Ox Alpha: eseguitelo sui vostri compiti prima che qualcuno vi dica di chi è, perché per quella settimana è l'unica valutazione onesta che chiunque possa ottenere.
Dove si colloca Telli.sh: questa curva è il motivo per cui costruiamo la nostra pipeline vocale su uno strato di provider di motori anziché attorno all'API di un singolo fornitore. Telli.sh instrada trascrizione, traduzione e riassunto attraverso motori intercambiabili, così un gradino sceso lungo questa curva di prezzo arriva come note migliori allo stesso prezzo, non come un annuncio di listino. La parte che nessun rilascio di modello vi dà è il resto del lavoro: catturare un'ora di audio senza perderla, tenere distinti i parlanti, tradurre dal vivo in 15 lingue e lasciarvi note che il trimestre prossimo potrete ancora cercare.
Fonti
- Pagina del modello
stealth/ox-alphasu OpenRouter — data di pubblicazione 20 agosto 2026, contesto da un milione di token e la riga aggiunta che conferma ZAI GLM-5.3-Flash; consultata il 31 agosto 2026 - Pagina del modello
z-ai/glm-5.3-flashsu OpenRouter — prezzi attuali e la finestra di sconto promozionale fino al 9 settembre 2026; consultata il 31 agosto 2026 - Scheda del modello su Hugging Face, zai-org/GLM-5.3-Flash — 320 miliardi di parametri totali / 18 miliardi attivi, corpus multimodale da 30.000 miliardi di token, licenza MIT, livelli di
reasoning_efforte la formulazione sull'avvicinarsi a Claude Opus 4.8 - L'anonimo Ox Alpha elabora 26.000 miliardi di token su OpenCode e batte il record di lancio di OpenRouter — RuntimeWire, 26 agosto 2026 — 26.000 miliardi di token, 327.000 utenti, 8.328.244 sessioni, il dato del 93 per cento di cache e il record di 11.600 miliardi di token di OpenRouter
- Utilizzo, specifiche e indizi sull'identità di Ox Alpha — LLM Rumors, 25 agosto 2026 — richieste giornaliere e il primo posto su 558 modelli
- Il modello stealth di livello frontiera Ox Alpha compare gratuitamente su OpenRouter e OpenCode — WinBuzzer, 24 agosto 2026 — l'affermazione sulla capacità di 100.000 miliardi di token al giorno e la stima GPU di Teortaxes
- La cinese Z.AI ha creato il modello stealth Ox Alpha, rivale di DeepSeek — Bloomberg via Yahoo Finance, 26 agosto 2026 — la conferma di identità di prima mano
- Il modello stealth che ha battuto DeepSeek appartiene a Zhipu — The Next Web — copertura della rivelazione e impegno sui pesi aperti
- Modelli stealth di OpenRouter: chi si sono rivelati essere — Digital Applied, 22 agosto 2026 — il censimento delle quattordici schede, date di rivelazione, livelli di prova e il confronto delle condizioni sui dati
- Artificial Analysis: analisi di intelligenza, prestazioni e prezzo di GLM-5.3-Flash — Intelligence Index 57, costo di valutazione di 138,02 dollari, 45 token al secondo, 150 milioni di token generati; consultata il 31 agosto 2026
- Epoch AI, «LLM inference prices have fallen rapidly but unequally across tasks», 12 marzo 2025 — la scala di prezzo a soglia fissa dietro il dato delle 208 volte
- Il nostro prima e dopo sulla rimonta dei modelli locali — i numeri di Qwen3.8-27B, la curva dei prezzi e il ritardo di recupero