O OpenRE-Bench consegue dizer se a IA transformou uma issue do GitHub em um requisito útil?
Um benchmark de dez casos compara como estruturas de agentes traduzem pedidos de funcionalidades em requisitos. Um exemplo mostra o que avaliar antes da primeira linha de código.
Uma issue no GitHub diz: “Mantenha meus filtros quando eu voltar”. Um agente de programação já pode começar a implementar alguma coisa. Também pode escolher a interpretação errada. “Voltar” significa reabrir a lista depois de ver um item, recarregar o navegador, entrar de novo amanhã ou mudar de espaço de trabalho? Cada resposta leva a uma funcionalidade diferente e a outros testes de aceitação.
O OpenRE-Bench examina o intervalo entre a issue e a implementação. Um preprint submetido ao arXiv em 10 de novembro de 2026 apresenta uma infraestrutura de testes comum para sistemas de agentes que geram requisitos. A primeira bateria reúne dez casos: cinco derivados de pedidos públicos de funcionalidades no GitHub e cinco escritos pelos pesquisadores. Os autores oferecem três adaptadores de exemplo para aplicar as mesmas entradas e regras de avaliação a diferentes sistemas. Preprint do OpenRE-Bench
O benchmark ajuda a fazer uma pergunta mais precisa sobre o que o agente produz. Duas pessoas que leem os requisitos propostos implementariam e testariam o mesmo comportamento? O exemplo dos filtros mostra por que o histórico das decisões importa tanto quanto o texto final e como uma equipe pode avaliar o próprio processo de transformar uma issue em requisitos.
Deixe as decisões visíveis antes de escrever o código
Engenharia de requisitos é o trabalho de esclarecer objetivos, restrições e comportamentos observáveis até que as pessoas possam chegar a um acordo. Uma issue pode explicar bem o problema do usuário e ainda deixar várias decisões de implementação em aberto. Duas pessoas podem concordar que a navegação precisa preservar o trabalho e discordar sobre sincronizar preferências entre dispositivos. Um primeiro rascunho útil registra essa diferença para que os responsáveis possam decidir.
Uma interpretação possível do pedido é a seguinte. Quando uma pessoa autenticada abre um item e retorna à lista no mesmo espaço de trabalho, a lista restaura os filtros anteriores. Preferências em outros espaços ficam fora desse escopo até que a equipe tome uma decisão específica. O teste de aceitação tem um estado inicial, uma ação e um resultado observável. Ele pode ser executado em um protótipo ou no recurso pronto.
Outra interpretação seria guardar os filtros depois que a pessoa encerra a sessão e também em outro dispositivo. Essa versão exige decidir onde armazenar a preferência no nível da conta e o que fazer quando dois dispositivos têm filtros salvos diferentes. A issue de uma linha deixou esses comportamentos em aberto. Um agente que os inclui por conveniência pode transformar um pequeno ajuste de navegação em uma mudança de produto com outros custos e implicações de privacidade.
| Parte do pedido | Primeiro rascunho para revisão | Decisão que ainda cabe à equipe |
|---|---|---|
| Voltar de um item para a lista | Restaurar os filtros visíveis no mesmo espaço de trabalho | Se a posição na lista também deve voltar |
| Recarregar a página ou entrar novamente | Registrar a questão como uma decisão em aberto | Por quanto tempo guardar as preferências e onde armazená-las |
| Trocar de espaço de trabalho | Evitar que os filtros de um espaço apareçam em outro | Se cada espaço mantém seu próprio histórico |
| Compartilhar um link com filtros | Tratar o compartilhamento como um caso de uso separado | Quais valores podem aparecer na URL compartilhada |
Exemplo de como revisar requisitos gerados antes da implementação. Ilustração original da Telli.sh.
Quem lê a primeira linha consegue testá-la sem uma descrição técnica da camada de armazenamento. Quem revisa também consegue identificar as linhas que exigem novas decisões. Um requisito útil especifica o comportamento que promete e deixa claras as questões que ainda cabem à equipe.
O benchmark mantém estáveis a entrada e o formato das evidências
O preprint descreve um CaseInput compartilhado com nome, descrição e texto de requisitos do caso. Um adaptador faz a ponte entre esse contrato e cada sistema participante. Ele preserva os dados necessários para comparar resultados e deixa cada sistema escolher como seus agentes colaboram. Os exemplos incluídos são MARE, iReDev e QUARE. Os autores descrevem MARE e iReDev como reimplementações baseadas nos artigos originais. Artigo do OpenRE-Bench, seção II
A infraestrutura guarda a saída de quatro fases. Ela registra modelos iniciais, um histórico de negociação, um modelo integrado e o resultado da verificação. Cada fase responde a uma pergunta diferente. O que os agentes viram no início? Em que discordaram? Quais escolhas foram incorporadas ao modelo? Que evidência permite conferir o resultado? Essa estrutura facilita acompanhar uma decisão mesmo quando os sistemas dão nomes diferentes aos papéis internos.
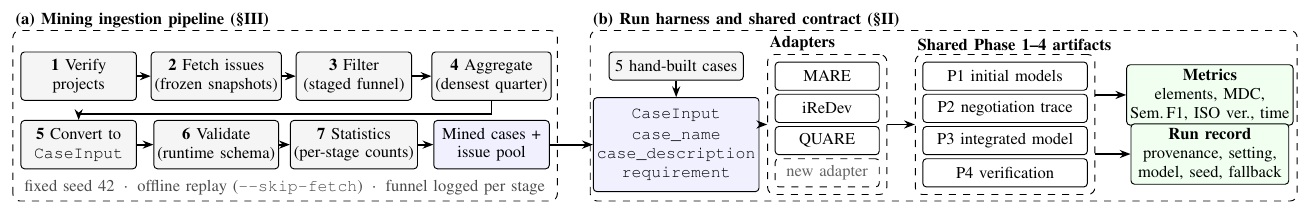
Figura 1 de Cheng et al., OpenRE-Bench, 10 de novembro de 2026. Imagem recortada do PDF dos autores e redimensionada para exibição. Figura original · CC BY 4.0.
No exemplo dos filtros, a saída da fase 1 poderia propor tanto “preservar a lista ao voltar” quanto “lembrar as preferências entre dispositivos”. A fase 2 poderia registrar os dois escopos. O artefato integrado poderia manter o primeiro e deixar o segundo pendente. A verificação final examinaria o comportamento mantido. Rever as quatro fases permite distinguir uma decisão deliberada sobre o escopo de uma omissão acidental.
Para quem compara sistemas de agentes, os adaptadores também deixam mais visíveis os limites da comparação. Um sistema com uma representação interna sofisticada pode perder detalhes ao exportá-la para um esquema comum. Guarde os artefatos nativos quando eles ajudarem a explicar um resultado. As saídas padronizadas dão uma base de comparação estável, e os artefatos nativos podem explicar por que um sistema teve desempenho diferente.
Os dez casos ajudam a avaliar o processo
Cheng e coautores relatam que coletaram 3.000 issues de cinco projetos em Python, TypeScript e Java. Os filtros deixaram 1.396 issues. Desse conjunto, 18 deram origem a cinco casos extraídos dos repositórios, que se juntaram a cinco casos escritos pelos pesquisadores na versão 1.0. O conjunto de coleta e os casos avaliados têm tamanhos diferentes. Uma execução da bateria incluída avalia dez casos, embora o processo comece com milhares de registros de issues. Artigo do OpenRE-Bench, tabela I
O processo também é uma contribuição do benchmark. Um registro de coleta e filtragem permite acompanhar como uma issue real de projeto chegou ao teste. Isso ajuda a comparar uma execução mais recente com o resultado publicado. Também mostra que tipos de pedidos o corpus tende a selecionar, inclusive os efeitos de rótulos, comentários, períodos de agregação e outros filtros.
Essas escolhas determinam os problemas que o benchmark representa. Em repositórios públicos, o escopo de um recurso costuma ser discutido em um local visível para qualquer pessoa. Já uma equipe que planeja mudar permissões internas pode negociar grande parte do escopo em uma conversa com o cliente ou numa revisão privada de projeto. Um modelo que se sai bem com os casos públicos pode precisar de testes específicos para esse contexto. Inclua casos com contexto incompleto, requisitos espalhados por vários documentos ou comentários contraditórios, se essas situações forem comuns no seu backlog.
Os cinco casos escritos à mão partem de outra situação. Um caso preparado pode isolar uma ambiguidade, enquanto um caso extraído pode preservar a forma como o pedido chegou. Divulgue os resultados de cada grupo. Um sistema que melhora no caso bem delimitado, mas perde decisões no meio de uma conversa extraída, talvez precise de outras instruções ou mais evidências antes de ser usado na triagem de issues.
Uma avaliação comum dá à equipe uma comparação estável e espaço para acrescentar verificações próprias. Ilustração original da Telli.sh.
A nota de verificabilidade pede uma revisão da fonte
O artigo descreve uma nota estrutural reproduzível de 1 a 5 para a verificabilidade, com base em critérios de conformidade ligados à norma ISO/IEC/IEEE 29148. Os autores também informam a quantidade de elementos, a preservação semântica entre a saída inicial e a integrada de uma mesma execução e o tempo decorrido. Juntas, as métricas podem mostrar se o sistema produz artefatos estruturados de forma consistente e preserva ideias durante o processo. Se todas as fases herdaram uma premissa de negócio, essas métricas não determinam se a premissa estava correta. Artigo do OpenRE-Bench, métricas
Imagine que o primeiro modelo interprete “voltar” como “entrar novamente na semana seguinte”. Se a saída integrada repete a interpretação, a métrica de preservação semântica pode refletir consistência entre as fases. Ainda assim, uma pessoa que leia a issue pode apontar que o texto não sustenta essa leitura. A métrica e a revisão respondem a perguntas diferentes. Cada uma ajuda quando seu escopo é claro.
Mantenha um pequeno conjunto de referência para avaliar a fidelidade à fonte. Em cada issue, identifique as frases que sustentam diretamente um requisito e as escolhas que o texto deixa em aberto. Peça a quem revisa que sinalize restrições descartadas, hipóteses plausíveis apresentadas como fatos e contradições entre o teste proposto e a issue. Cinco perguntas específicas podem revelar mais sobre o seu uso real do que uma média de muitos casos com escopos diferentes.
Considere um recurso hipotético de exportação. Uma issue pede que relatórios continuem legíveis numa planilha depois de mudar o formato regional de datas. Um rascunho define um ator, um recurso de dados, uma sequência e um registro de verificação. A instrução de verificação é “Confirme se a data foi exportada corretamente”. Outro rascunho diz “Depois de escolher uma localidade com o dia em primeiro lugar e exportar uma linha datada de 4 de março de 2026, verifique se a planilha exportada mantém a data de 4 de março de 2026 ao ser reaberta numa localidade com o mês em primeiro lugar”. A segunda frase é fácil de converter em um teste. O primeiro rascunho tem mais elementos formais, mas sua instrução deixa dois leitores livres para discordar do resultado esperado.
Também vale testar a própria revisão. Peça a duas pessoas que escrevam os dados mínimos de teste para a mesma proposta. Se uma escolher uma data ambígua e a outra escolher o dia 28 do mês, os conjuntos de dados podem revelar problemas diferentes. Um bom teste de aceitação indica os dados que expõem o erro. O agente pode ajudar a escrever esse teste se souber por que a issue original era importante.
Custo e tempo merecem a mesma atenção. Alguns sistemas fazem mais chamadas ao conciliar perspectivas conflitantes. Um fluxo mais lento pode valer o tempo se revelar conflitos que sua equipe costuma deixar passar. Se toma as mesmas decisões de uma referência mais simples e acrescenta artefatos intermediários extensos, a diferença entra na comparação de custo. Execute a referência e o sistema no mesmo caso antes de decidir se as etapas extras compensam.
Compare poucos requisitos que sua equipe consegue avaliar
- Comece pelo artefato versionado do artigo e faça um teste básico offline. Os autores documentam o modo
single_agent, que dispensa chave e serve para conferir a execução e os caminhos dos artefatos antes de pagar por uma comparação com modelos. Instruções do artefato OpenRE-Bench - Escolha algumas issues públicas ou para as quais você tem autorização. Inclua um pedido simples, um com comentários conflitantes e um que deixe em aberto uma decisão de política. Escreva o comportamento esperado e as dúvidas antes de examinar a saída do agente.
- Execute cada candidato com a mesma entrada e registre a versão do sistema, a configuração do modelo e o modo de execução. Guarde os artefatos intermediários. Use os mesmos critérios para identificar requisitos ausentes ou pressupostos sem apoio na fonte.
- Compare a saída no nível das decisões. Pergunte o que pode ser verificado pela observação do produto e qual trecho da issue justifica a decisão. Registre se alguém precisa esclarecer o escopo antes do início da implementação.
- Use os resultados para decidir onde o agente ajuda. Alguns pedidos já permitem elaborar um teste de aceitação. Outros se beneficiam de uma lista de perguntas ao autor. Deixe as duas saídas visíveis no processo.
Um próximo passo é levar um requisito a uma reunião de revisão real. Compare o rascunho do agente com o comportamento que a equipe finalmente aprova. Se os revisores reescrevem sempre a mesma categoria de afirmação, acrescente um teste para ela. Um requisito com resultado esperado preciso e origem rastreável continua útil enquanto o restante do documento ainda passa por edição.
O OpenRE-Bench viabiliza a comparação antes da primeira mudança no código. O que vale avaliar é se a próxima pessoa consegue ver que comportamento a equipe aprovou, de onde vieram as evidências e quais decisões ainda precisam de um responsável.
Fontes
- Cheng et al., preprint do OpenRE-Bench, 10 de novembro de 2026
- Artigo completo com métodos, dados e a Figura 1 original
- Artefato versionado fornecido pelos autores
- Creative Commons Atribuição 4.0 Internacional
Para encontrar por busca as decisões por trás dos pedidos de funcionalidades e das revisões, crie uma conta na Telli.sh.