Zeigt OpenRE-Bench, ob KI aus einem GitHub-Issue eine brauchbare Anforderung macht?
Zehn Testfälle helfen beim Vergleich von Agenten-Frameworks, die Feature-Wünsche in Anforderungen übersetzen. Ein Beispiel zeigt, was sich vor der ersten Codeänderung bewerten lässt.
In einem GitHub-Issue steht: „Behalte meine Filter, wenn ich zurückkomme.“ Ein Programmieragent kann sofort etwas umsetzen. Er kann aber auch die falsche Bedeutung wählen. Bedeutet „zurückkommen“, nach einem Detail wieder die Liste aufzurufen, den Browser neu zu laden, sich morgen anzumelden oder den Arbeitsbereich zu wechseln? Jede Antwort führt zu einer anderen Funktion und anderen Akzeptanztests.
OpenRE-Bench untersucht den Weg vom Issue zur Implementierung. Eine am 10. November 2026 bei arXiv eingereichte Vorabveröffentlichung stellt eine gemeinsame Testumgebung für Agenten-Frameworks vor, die Anforderungen erstellen. Die erste Testsuite umfasst zehn Fälle. Fünf stammen aus öffentlichen GitHub-Feature-Wünschen und fünf haben die Forschenden selbst verfasst. Die Autoren stellen drei Beispieladapter bereit, damit verschiedene Frameworks dieselben Eingaben und Bewertungskriterien verwenden können. OpenRE-Bench-Preprint
Mit dem Benchmark lässt sich eine genauere Frage an die Ausgabe des Agenten stellen. Würden zwei Personen mit den vorgeschlagenen Anforderungen dasselbe Verhalten entwickeln und prüfen? Das Filterbeispiel zeigt, warum die dokumentierten Entscheidungen ebenso wichtig sind wie der fertige Text und wie ein Team seinen eigenen Ablauf vom Issue zur Anforderung prüfen kann.
Entscheidungen sollten vor dem Schreiben von Code sichtbar sein
In der Anforderungsanalyse geht es darum, Ziele, Einschränkungen und beobachtbares Verhalten so genau zu beschreiben, dass sich Beteiligte darüber einigen können. Ein gutes Issue kann ein Problem verständlich darstellen und trotzdem mehrere Umsetzungsentscheidungen offenlassen. Zwei Beteiligte können sich einig sein, dass beim Navigieren keine Arbeit verloren gehen soll, und unterschiedlicher Meinung dazu sein, ob Einstellungen geräteübergreifend gelten sollen. Ein brauchbarer erster Entwurf hält den Unterschied fest, damit die zuständigen Personen entscheiden können.
Eine mögliche Lesart der Filteranfrage wäre folgende. Wenn ein angemeldeter Nutzer einen Eintrag öffnet und im selben Arbeitsbereich zur Liste zurückkehrt, zeigt die Liste wieder die vorherigen Filterwerte an. Änderungen an Einstellungen anderer Arbeitsbereiche bleiben ausgeschlossen, bis das Team darüber eigens entscheidet. Der Akzeptanztest hat einen eindeutigen Ausgangszustand, eine Aktion und ein beobachtbares Ergebnis. Er kann am Prototyp oder an der fertigen Funktion laufen.
Eine zweite mögliche Auslegung speichert Filter über die Abmeldung hinaus und auf einem anderen Gerät. Diese Variante braucht eine Entscheidung über die Speicherung auf Kontoebene und eine Regel für den Fall, dass auf zwei Geräten unterschiedliche Filter gespeichert sind. Das einzeilige Issue hat diese Verhaltensweisen nicht festgelegt. Wenn der Agent sie hinzufügt, weil sie bequem klingen, kann aus einer kleinen Navigationskorrektur eine Produktänderung mit anderen Kosten und Datenschutzfolgen werden.
| Teil der Anfrage | Überprüfbarer erster Entwurf | Was noch entschieden werden muss |
|---|---|---|
| Vom Eintrag zur Liste zurückkehren | Sichtbare Filter im selben Arbeitsbereich wiederherstellen | Ob auch die Position in der Liste wiederhergestellt wird |
| Neu laden oder wieder anmelden | Als offene Entscheidung festhalten | Wie lange Einstellungen bestehen bleiben und wo sie gespeichert werden |
| Arbeitsbereich wechseln | Filter eines Arbeitsbereichs in keinem anderen anzeigen | Ob jeder Arbeitsbereich seinen eigenen Verlauf behält |
| Gefilterten Link teilen | Teilen als eigenen Anwendungsfall behandeln | Welche Werte in der geteilten URL stehen dürfen |
Ein Beispiel dafür, wie sich generierte Anforderungen vor der Umsetzung prüfen lassen. Eigene Illustration von Telli.sh.
Die erste Zeile lässt sich ohne technische Erläuterung der Speicherschicht testen. Zugleich ist ersichtlich, dass weitere Zeilen Entscheidungen verlangen. Eine brauchbare Anforderung beschreibt genau, welches Verhalten sie zusagt und welche Fragen das Team noch beantworten muss.
Der Benchmark hält Eingaben und Ausgaben für den Vergleich konstant
Der OpenRE-Bench-Preprint beschreibt ein gemeinsames Format namens CaseInput mit Name, Beschreibung und Anforderungstext des Falls. Ein Adapter vermittelt zwischen diesem Format und jedem teilnehmenden Framework. Er erhält die Informationen, die die Testumgebung für den Vergleich braucht, und lässt dem Framework Spielraum bei der Zusammenarbeit seiner Agenten. Die mitgelieferten Beispiele sind MARE, iReDev und QUARE. Die Autoren beschreiben MARE und iReDev als Neuimplementierungen nach den Originalpublikationen. OpenRE-Bench-Studie, Abschnitt II
Die Testumgebung zeichnet Ausgaben aus vier Phasen auf. Sie speichert die Ausgangsmodelle, ein Aushandlungsprotokoll, ein zusammengeführtes Modell und ein Prüfergebnis. Jede Phase beantwortet eine andere Frage. Was sahen die Agenten zu Beginn? Wo waren sie sich uneinig? Welche Entscheidungen blieben in der Zusammenführung bestehen? Welche Belege lassen sich zur Kontrolle heranziehen? Mit dieser Struktur bleibt eine Entscheidung auch dann nachvollziehbar, wenn Frameworks ihre internen Rollen anders benennen.
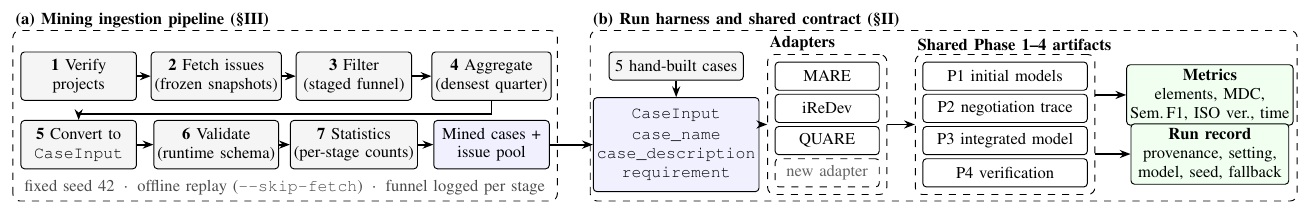
Abbildung 1 aus Cheng et al., OpenRE-Bench, 10. November 2026. Aus dem PDF der Autoren ausgeschnitten und für die Anzeige skaliert. Originalabbildung · CC BY 4.0.
Im Filterbeispiel könnte Phase 1 sowohl „beim Zurückkehren die aktuelle Liste erhalten“ als auch „Einstellungen geräteübergreifend speichern“ vorschlagen. In Phase 2 ließen sich beide als verschiedene mögliche Umfänge festhalten. Das zusammengeführte Ergebnis könnte den ersten behalten und den zweiten offenlassen. Die abschließende Prüfung würde dann das beibehaltene Verhalten kontrollieren. Wer alle vier Phasen liest, kann eine legitime Abgrenzung von einer versehentlichen Auslassung unterscheiden.
Adapter erleichtern es auch, die Grenzen des Framework-Vergleichs zu benennen. Ein System mit einer differenzierten internen Darstellung kann beim Export in ein gemeinsames Schema Einzelheiten verlieren. Behalten Sie die nativen Ergebnisse, wenn sie eine Entscheidung erklären. Die standardisierten Ausgaben sind der gemeinsame Vergleichsmaßstab. Die nativen Ergebnisse können zeigen, warum ein Framework anders abgeschnitten hat.
Zehn Fälle prüfen vor allem den Ablauf
Cheng und seine Mitautoren berichten von 3.000 abgerufenen Issues aus fünf Projekten in Python, TypeScript und Java. Nach dem Filtern blieben 1.396 Issues übrig. Aus diesem Bestand gingen 18 Issues in fünf daraus abgeleitete Testfälle ein. Zusammen mit fünf von Hand erstellten Fällen bilden sie die Testsuite v1.0. Ausgangsbestand und ausgewertete Fälle sind unterschiedliche Größen. Ein Lauf mit der mitgelieferten Suite nutzt zehn Fälle, auch wenn die Datenaufbereitung mit Tausenden Issues beginnt. OpenRE-Bench-Studie, Tabelle I
Der dokumentierte Ablauf gehört zum Beitrag des Benchmarks. Die Schritte zum Abruf und Filtern zeigen, wie aus einem echten Projekt-Issue ein Testfall wurde. Das hilft beim Vergleich neuer Läufe mit veröffentlichten Ergebnissen. Prüfer können auch sehen, welche Anfragen der Datensatz bevorzugt und welchen Einfluss Labels, Kommentare, Zeiträume für das Zusammenfassen und andere Filter haben.
Diese Entscheidungen prägen die abgedeckten Probleme. In öffentlichen Repositorys werden Anforderungen oft für alle einsehbar diskutiert. Bei der Planung einer internen Berechtigungsänderung kann ein Team große Teile des Umfangs in einem Kundengespräch oder einem internen Designreview klären. Ein Modell, das bei öffentlichen Fällen gut abschneidet, kann für diesen Einsatz eigene Tests brauchen. Nehmen Sie Fälle mit lückenhaftem Kontext, über mehrere Dokumente verteilten Anforderungen oder widersprüchlichen Kommentaren auf, wenn das im eigenen Backlog häufig vorkommt.
Die fünf von Hand erstellten Fälle setzen einen anderen Ausgangspunkt. Ein gezielt entworfener Fall kann eine bestimmte Mehrdeutigkeit isolieren, während ein abgeleiteter Fall zeigt, wie Wünsche in der Praxis formuliert werden. Weisen Sie die Ergebnisse für beide Gruppen aus. Wenn ein Framework bei klar aufgebauten Fällen besser wird, in aus Issues abgeleiteten Diskussionen aber Entscheidungen verliert, braucht es womöglich andere Anweisungen oder zusätzliche Belege für die Erstbewertung.
Eine gemeinsame Bewertung schafft eine stabile Vergleichsgrundlage und lässt Raum für Prüfungen der eigenen Arbeit. Eigene Illustration von Telli.sh.
Zur Bewertung der Prüfbarkeit gehört ein Quellenabgleich
Die Studie beschreibt eine reproduzierbare Bewertung der strukturellen Prüfbarkeit von 1 bis 5 anhand von Merkmalen, die mit ISO/IEC/IEEE 29148 zusammenhängen. Erfasst werden außerdem die Anzahl der Elemente, die semantische Übereinstimmung zwischen den anfänglichen und den zusammengeführten Ausgaben eines Laufs sowie die Laufzeit. Zusammen zeigen diese Werte, ob ein System regelmäßig strukturierte Ergebnisse erzeugt und Ideen im Ablauf erhält. Ob eine fachliche Annahme stimmt, lässt sich so nicht klären, wenn alle Phasen sie übernehmen. OpenRE-Bench-Studie, Messgrößen
Angenommen, das erste Modell deutet „zurückkommen“ als „nächste Woche erneut anmelden“. Wenn die gleiche Auslegung im zusammengeführten Ergebnis steht, kann die semantische Kennzahl eine durchgängige Bedeutung anzeigen. Eine Person, die das Issue liest, könnte die Auslegung dennoch als unbegründet markieren. Die Kennzahl und der Quellenabgleich beantworten verschiedene Fragen. Beide sind nützlich, wenn ihr Umfang klar bleibt.
Halten Sie für Aussagen über die Quelle eine kleine Menge geprüfter Referenzfälle bereit. Markieren Sie je Issue, welche Sätze eine Anforderung direkt stützen und welche Entscheidungen offenbleiben. Lassen Sie eine Person ausgelassene Einschränkungen, als Tatsachen formulierte plausible Annahmen und Widersprüche zwischen vorgeschlagenem Test und Issue markieren. Fünf konkrete Fragen können über den eigenen Einsatz mehr verraten als ein Durchschnitt über viele Fälle mit verschiedenem Umfang.
Nehmen wir als zweites Beispiel eine hypothetische Exportfunktion. Ein Issue verlangt, dass Berichte nach dem Wechsel eines regionalen Datumsformats im Tabellenprogramm lesbar bleiben. Ein Entwurf definiert eine handelnde Person, eine Datenressource, eine Folge von Schritten und einen Prüfnachweis. Die Prüfung lautet „Bestätige, dass das Datum korrekt exportiert wird“. Ein anderer Entwurf sagt „Wähle ein Gebietsschema mit Tag vor Monat, exportiere eine Zeile mit dem Datum 4. März 2026 und prüfe, dass in der exportierten Datei nach dem erneuten Öffnen mit einem Gebietsschema mit Monat vor Tag weiterhin der 4. März 2026 gespeichert ist.“ Der zweite Satz lässt sich direkt in einen Test übersetzen. Der erste Entwurf enthält mehr formale Elemente, lässt bei seiner Prüfung aber zwei Lesarten des richtigen Ergebnisses zu.
Auch die Prüfung selbst lässt sich untersuchen. Bitten Sie zwei Personen, den kleinsten nötigen Testdatensatz für dieselbe vorgeschlagene Prüfung zu entwerfen. Wenn eine Person ein mehrdeutiges Datum und die andere den 28. eines Monats wählt, können ihre Daten verschiedene Fehlerarten aufdecken. Ein guter Akzeptanztest benennt die Daten, die den Fehler sichtbar machen. Der Agent kann bei der Formulierung helfen, wenn er erkennt, warum das ursprüngliche Issue wichtig war.
Kosten und Zeit verdienen dieselbe Sorgfalt. Manche Frameworks machen mehr Aufrufe, um unterschiedliche Sichtweisen zusammenzuführen. Ein langsamerer Ablauf kann sich lohnen, wenn er Konflikte findet, die Ihr Team regelmäßig übersieht. Trifft er dieselben Entscheidungen wie eine einfachere Vergleichsversion und fügt nur ausführliche Zwischenergebnisse hinzu, gehört das in die Kostenbewertung. Lassen Sie Ausgangsversion und Framework auf demselben Fall laufen, bevor Sie entscheiden, ob zusätzliche Schritte sinnvoll sind.
Vergleichen Sie zunächst Anforderungen, die Sie selbst bewerten können
- Beginnen Sie mit der festgelegten Artefaktversion aus der Studie und einem kurzen Offline-Probelauf. Die Autoren dokumentieren die Einstellung
single_agent, die ohne Schlüssel auskommt. So können Sie Laufzeit und Ausgabepfade prüfen, bevor Sie für einen Vergleich mit Modellaufrufen bezahlen. Anleitung zum OpenRE-Bench-Artefakt - Wählen Sie wenige öffentliche oder freigegebene Issues. Nehmen Sie eine einfache Anfrage, eine Anfrage mit widersprüchlichen Kommentaren und eine mit offener Produktentscheidung auf. Schreiben Sie das erwartete Verhalten und die offenen Fragen auf, bevor Sie Agentenausgaben lesen.
- Verwenden Sie für jeden Kandidaten dieselbe Eingabe und notieren Sie Framework-Version, Modellkonfiguration und Ausführungsmodus. Speichern Sie die Zwischenergebnisse. Nutzen Sie dieselben Kriterien für fehlende Anforderungen und unbelegte Annahmen.
- Vergleichen Sie die konkreten Entscheidungen. Fragen Sie, was sich am Produkt beobachten ließe und welche Textstelle im Issue das begründet. Halten Sie fest, ob jemand den Umfang klären muss, bevor Code geschrieben wird.
- Entscheiden Sie anhand der Ergebnisse, wo der Agent helfen kann. Für manche Anfragen ist der Entwurf eines Akzeptanztests sinnvoll, für andere eine Liste mit Rückfragen an die Verfasser. Halten Sie beides im Ablauf sichtbar.
In einem Folgeschritt kann eine Anforderung in eine echte Review-Sitzung gehen. Vergleichen Sie den Agentenentwurf mit dem Verhalten, auf dessen Auslieferung sich das Team schließlich einigt. Wenn die prüfenden Personen jedes Mal dieselbe Art von Aussage umschreiben, ergänzen Sie dafür einen Test. Eine Anforderung mit einem klaren Ergebnis und einer nachvollziehbaren Quelle kann nützlich sein, auch wenn der restliche Text noch bearbeitet werden muss.
OpenRE-Bench macht den Vergleich vor der ersten Codeänderung praktikabel. Entscheidend ist, ob die nächste Person erkennen kann, auf welches Verhalten sich das Team geeinigt hat, woher die Belege stammen und wer über offene Fragen noch entscheiden muss.
Quellen
- Cheng et al., OpenRE-Bench-Preprint vom 10. November 2026
- Vollständige Studie mit Methoden, Daten und Originalabbildung 1
- Versioniertes Artefakt der Autoren
- Creative Commons Namensnennung 4.0 International
Um Entscheidungen hinter Feature-Wünschen und Reviews durchsuchbar zu halten, erstellen Sie ein Telli.sh-Konto.