Pengecaman pertuturan diam-diam bertukar open weight — dan muat dalam 1.56 GB
Model Qwen3-ASR daripada Alibaba berlesen Apache 2.0, merangkumi 52 bahasa dan dialek, serta bersaiz muat turun kurang daripada dua gigabait. Panduan bahasa mudah tentang lapisan transkripsi open weight: apa yang sedia ada, apa yang benar-benar anda peroleh dengan menjalankan model pada komputer riba sendiri, dan di mana API tertutup masih menang.
Anda kini boleh menjalankan pengecaman pertuturan berat terbuka pada komputer riba: pasukan Qwen Alibaba menerbitkan Qwen3-ASR-0.6B, Qwen3-ASR-1.7B dan Qwen3-ForcedAligner-0.6B sebagai model iringan, di bawah Apache 2.0. Muat turun terkecil bersaiz 1.56 GB, menyokong 52 bahasa dan dialek, serta sejak 26 Jun boleh dijalankan dengan tiga baris Python standard. Menjalankannya sendiri mengelakkan bil transkripsi bagi setiap permintaan.
Peralihan ini akan terasa biasa kepada sesiapa yang mengikuti model bahasa terbuka: pengehosan sendiri memberi lebih kawalan terhadap kos, privasi dan penggunaan luar talian, manakala API terhos lebih mudah dioperasikan. Pengecaman pertuturan kini berkembang dengan pilihan yang sama, melalui model yang cukup kecil untuk dijalankan secara setempat.
Panduan ini menerangkan fungsi pengecaman pertuturan berat terbuka, perbezaan model dan lesennya, perkara yang boleh dijalankan pada komputer riba, serta kelebihan yang masih dimiliki API terhos.
TL;DR:
- Transkripsi open weight sudah boleh digunakan hari ini: Qwen3-ASR di bawah Apache 2.0 dengan 52 bahasa dan dialek, Whisper di bawah MIT, Parakeet dan Canary daripada NVIDIA di bawah CC BY 4.0, Voxtral daripada Mistral di bawah Apache 2.0.
- Menghos sendiri memberi privasi, operasi luar talian, dan kawalan kos. Pada papan bebas Artificial Analysis, menghos model terbuka berharga 1.50 dolar bagi setiap 1,000 minit, berbanding 6.00 dolar bagi MAI-Transcribe-1.5 daripada Microsoft dan 18.15 dolar bagi Gemini 3.1 Pro Preview.
- Tempat pertama bagi ketepatan masih dipegang titik akhir pratonton tertutup. Namun satu model terbuka berlesen Apache 2.0, Voxtral Small, kini berada di tempat kelima, kira-kira satu mata kadar ralat perkataan di belakangnya.
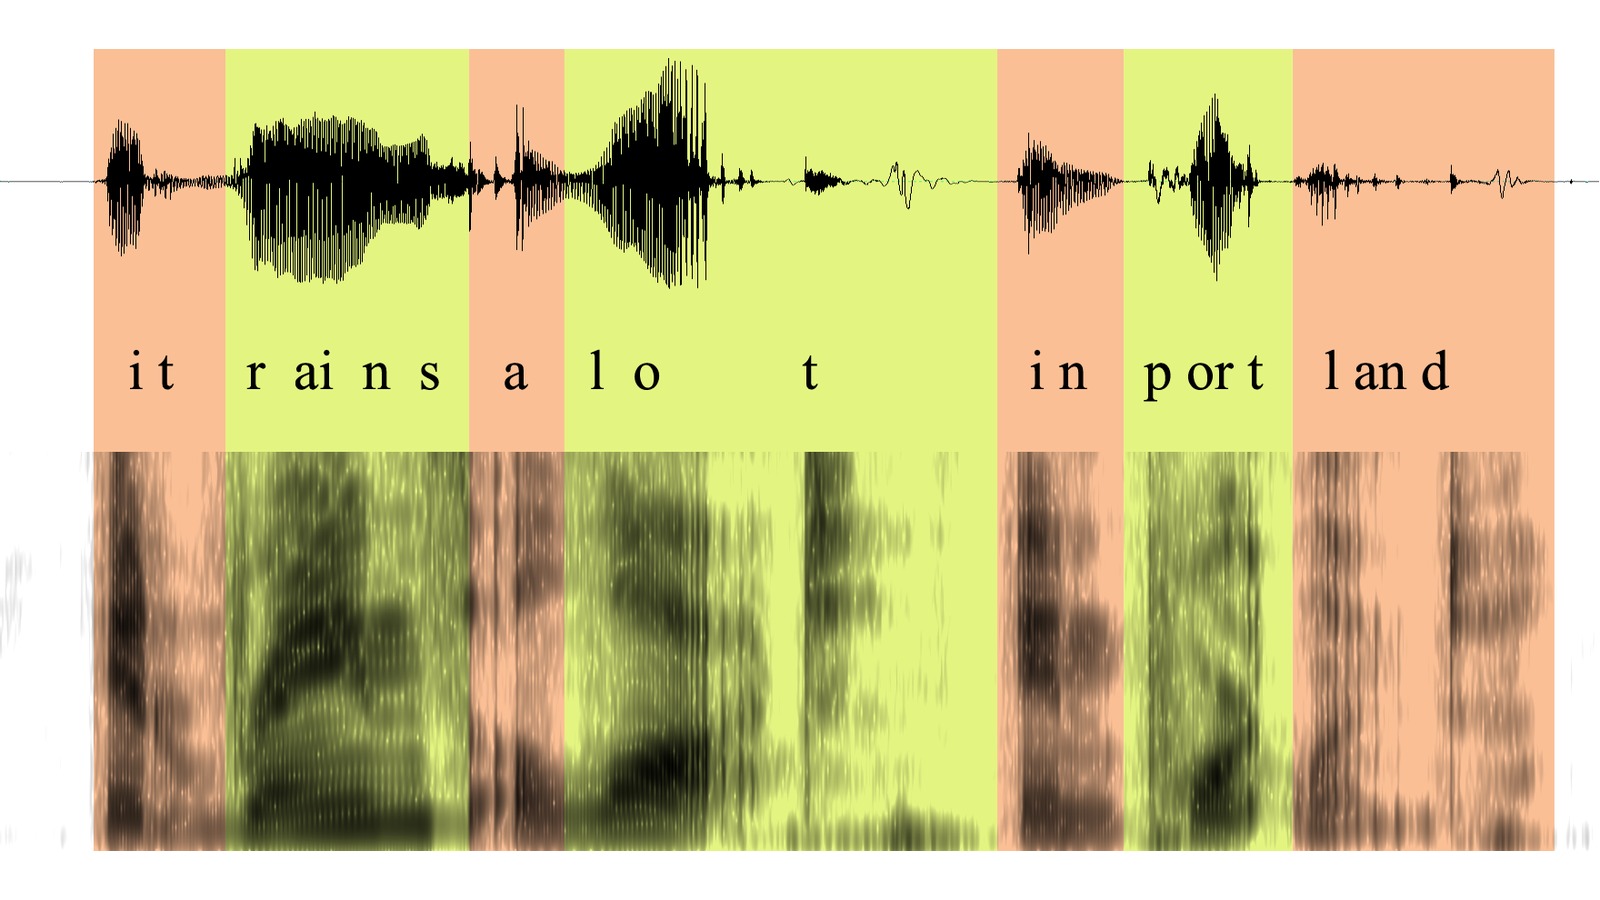
Gambar: Aaron Parecki, Wikimedia Commons, CC BY 2.0. Bentuk gelombang dan spektrogram bagi ayat "it rains a lot in Portland", dengan huruf diletakkan tepat di atas audio yang sepadan — inilah bahan mentah yang diproses oleh setiap model pengecaman pertuturan.
Apa yang sebenarnya anda muat turun apabila memuat turun model transkripsi
Model ASR — pengecaman pertuturan automatik, digunakan silih berganti dengan STT atau pertuturan ke teks — ialah program yang menerima audio dan menghasilkan teks. Itu sahaja tugasnya. Ia tidak memutuskan siapa yang bercakap, tidak meringkaskan, tidak tahu mesyuarat anda tentang apa. Ia mendengar perkataan lalu menulisnya.
"Open weights" bermaksud makmal itu menerbitkan fail model siap itu sendiri. Pemberat sesebuah model ialah grid nombor gergasi yang dipelajarinya semasa latihan, dan menerbitkannya bermakna anda memuat turun fail tersebut, menjalankannya pada perkakasan sendiri, dan membina di atasnya tanpa meminta kebenaran sesiapa atau membayar mengikut permintaan. Alternatifnya ialah model tertutup: pemberatnya kekal pada pelayan vendor dan anda menyewa akses melalui API — audio naik, teks kembali, dan pengebilan mengikut minit.
Nombor dalam nama itu ialah kiraan parameter, dan bagi model pertuturan ia terasa luar biasa konkrit. "0.6B" bermaksud kira-kira 600 juta parameter, yang dalam amalannya menjadikan Qwen3-ASR-0.6B sebuah fail 1.56 GB dan Qwen3-ASR-1.7B sebuah fail 4.08 GB — kedua-duanya cukup kecil untuk duduk pada SSD komputer riba tanpa disedari sesiapa. Bandingkan dengan model bahasa terbuka yang kami bincangkan dalam rangkuman gelombang model China, yang pelancaran utamanya bersaiz 1.56 terabait dalam 96 serpihan dan memerlukan kelompok pelayan semata-mata untuk dimuatkan. Model pertuturan kira-kira seribu kali lebih kecil daripada model teks barisan hadapan, dan fakta tunggal itulah sebabnya peralihan ini terasa lebih kuat di sini berbanding di sana.
Namakan julat saiz ini kelas komputer riba: model yang cukup kecil sehingga mencubanya hanya memerlukan muat turun, bukannya keputusan belanjawan perkakasan. Kebanyakan model teks frontier tidak termasuk; banyak model pertuturan muat.
Semak lesen sebelum menggunakan model. Apache 2.0 dan MIT membenarkan penggunaan, pengubahsuaian dan pengedaran komersial. CC BY 4.0 yang digunakan model NVIDIA juga membenarkan penggunaan komersial tetapi memerlukan atribusi.
Qwen melancarkan keluarga ini pada Januari; Jun ialah saat ia menjadi mudah
Kini kepada pelancaran yang mencetuskan tulisan ini, berserta satu pembetulan terhadap cara ia diperihalkan. Keluarga Qwen3-ASR tidak muncul pada bulan Jun. Repositori asalnya dinaikkan pada 28 Januari 2026, dan laporan teknikalnya mendarat di arXiv keesokan harinya. Apa yang berlaku pada 26 Jun ialah Qwen menerbitkan versi -hf bagi ketiga-tiga model itu — checkpoint yang berjalan secara asli dalam Hugging Face Transformers bermula versi 5.13.0.
Perubahan pembungkusan menjadikan persediaan lebih biasa: daripada memasang pakej qwen-asr Qwen atau backend vLLM, pembangun yang menggunakan Transformers boleh memuatkan checkpoint -hf dengan Python standard. Ini mengurangkan kos persediaan tanpa mengubah perkara yang dikenal pasti oleh model.
Spesifikasinya diambil terus daripada kad model. Kedua-dua saiz melakukan pengenalpastian bahasa dan pengecaman pertuturan bagi 30 bahasa — Inggeris, Cina, Korea, Jepun, Sepanyol, Arab, Hindi, Thai, Vietnam, Poland dan dua puluh lagi — ditambah 22 dialek Cina, dan begitulah angka "52 bahasa dan dialek" itu terhasil. Kedua-duanya menjalankan inferens penstriman dan luar talian daripada satu model yang sama, sesuatu yang lebih jarang daripada bunyinya: banyak model transkripsi hanya mampu salah satu. Kedua-duanya menerima audio panjang, dan kad itu turut menyenaraikan nyanyian serta lagu bermuzik latar sebagai jenis audio yang disokong.
Model ketiga wajar diberi perhatian. Qwen3-ForcedAligner-0.6B melakukan penjajaran paksa: berikan ia audio dan sebuah transkrip, ia akan menanda di mana setiap perkataan bermula dan berakhir, tepat sehingga milisaat, bagi 11 bahasa dan sehingga lima minit pertuturan pada satu masa. Itulah jentera di sebalik transkrip yang boleh diklik, pemasaan sari kata, dan lompatan terus ke saat seseorang menyebut sesuatu. Itulah tepat yang ditunjukkan oleh gambar di awal tulisan ini. Menerbitkan penjajar bersama pengecam ialah isyarat tentang untuk siapa pelancaran ini dibuat: bukan orang yang menjalankan demo, tetapi orang yang membina produk.
Mengenai kualiti, asingkan dahulu siapa mendakwa apa. Kad milik Qwen sendiri melaporkan angka daripada Hugging Face Open ASR Leaderboard bertarikh 26 Jun 2026: purata kadar ralat perkataan 5.59 % bagi model 1.7B dan 6.31 % bagi 0.6B, dengan subset audio mesyuarat AMI pada 9.26 % dan 10.57 %. Kadar ralat perkataan ialah bahagian perkataan yang disalah tangkap oleh model, jadi lebih rendah lebih baik, dan AMI ialah angka paling sukar di situ kerana mesyuarat sebenar memang bersepah. Qwen turut menyifatkan versi 1.7B sebagai "termaju dalam kalangan model ASR sumber terbuka" dan setanding API komersial — anggap itu dakwaan vendor sehingga ada pihak di luar Alibaba mengukurnya. Perhatikan juga bahawa ini penanda aras yang berbeza daripada papan bebas di bawah, dengan audio yang berbeza, jadi dua set angka ini tidak boleh dibandingkan antara satu sama lain.
Whisper yang memulakan semua ini, dan ia masih model yang semua orang jalankan
Semua ini tidak akan berbentuk sebegini tanpa Whisper daripada OpenAI. Repositorinya dibuka pada 16 September 2022 di bawah lesen MIT — kod dan pemberat sekali gus — pada waktu pengecaman pertuturan yang serius bermakna kontrak dengan penyedia awan. Sejak itu ia mengumpul 106,679 bintang di GitHub.
Yang menjadikan Whisper penting bukanlah modelnya sebanyak apa yang dibina komuniti di atasnya dalam beberapa bulan. whisper.cpp menulisnya semula dalam C dan C++ tulen, berlesen MIT, 52,591 bintang, dan membuatkannya berjalan pada komputer riba dan telefon tanpa Python dan tanpa GPU. faster-whisper membinanya semula di atas CTranslate2 dengan lonjakan besar pada kelajuan dan memori, MIT juga, 24,750 bintang. Model itu benihnya; ekosistem itu pokoknya.
Empat tahun kemudian, Whisper masih digunakan secara meluas. Dalam 30 hari sebelum 5 Ogos 2026, whisper-large-v3-turbo dimuat turun 8.72 juta kali daripada Hugging Face dan whisper-large-v3 5.50 juta kali; Qwen3-ASR-0.6B mencapai 4.29 juta muat turun. Pada papan Artificial Analysis, Whisper Large v3 mencatat AA-WER 4.07%, berbanding 1.73% bagi model peneraju dalam petikan itu.

Lapisan pertuturan terbuka tiba dalam dua gelombang berselang tiga tahun, dengan hampir kosong di antaranya. Tarikh pelancaran daripada GitHub dan Hugging Face, ditarik pada 5 Ogos 2026.
Pihak terbuka bukan sekadar satu makmal
Qwen tidak keseorangan, dan yang lain hebat dalam perkara yang jelas berbeza.
Barisan Parakeet daripada NVIDIA bertaruh pada kelajuan. parakeet-tdt-0.6b-v3, dikeluarkan pada Ogos 2025 di bawah CC BY 4.0, ialah model 600 juta parameter yang merangkumi 25 bahasa Eropah dengan pengesanan bahasa automatik, tanda baca, huruf besar, dan cap masa peringkat perkataan terbina dalam, serta menelan audio sehingga 24 minit dalam satu laluan. Keluarga Canary daripada NVIDIA — canary-1b-v2 dan canary-qwen-2.5b, juga CC BY 4.0 — merangkumi kawasan serupa dengan pertaruhan seni bina yang berbeza. Model Voxtral daripada Mistral tiba pada Julai 2025 di bawah Apache 2.0, dan pentingnya kerana satu sebab yang akan kita capai sebentar lagi.
Inilah pihak terbuka disusun bersebelahan, dengan API dihoskan pada baris terakhir sebagai perbandingan.
| Model | Muat turun | Lesen | Bahasa | Berjalan pada | Paling kuat pada |
|---|---|---|---|---|---|
| Whisper Large v3 | 3.09 GB | MIT | 99 | Komputer riba atau satu GPU | Menjadi pilihan lalai yang semua alat sudah sokong |
| Qwen3-ASR-0.6B | 1.56 GB | Apache 2.0 | 52 termasuk dialek | Komputer riba | Kerja pelbagai bahasa pada saiz terkecil |
| Qwen3-ASR-1.7B | 4.08 GB | Apache 2.0 | 52 termasuk dialek | Komputer riba atau satu GPU | Ketepatan terbaik dalam keluarga Qwen |
| Parakeet TDT 0.6B v3 | 2.51 GB | CC BY 4.0 | 25 bahasa Eropah | Komputer riba atau satu GPU | Kelajuan dan cap masa peringkat perkataan |
| Voxtral Small | — | Apache 2.0 | — | GPU pelayan, 24 bilion parameter | Skor terbuka tertinggi pada papan bebas |
| API dihoskan | Tidak boleh dimuat turun | Tertutup | Berbeza-beza | Awan vendor | Pengasingan penutur, penstriman, ketersediaan |
Saiz muat turun ialah checkpoint lalai dalam setiap repositori Hugging Face. "—" bermaksud bahan sumber untuk perbandingan ini tidak memberikan nilainya. Petikan diambil pada 5 Ogos 2026.
Kemudian ada kerja pembungkusan yang membawa model-model ini ke peranti sebenar, titik di mana kelas komputer riba berhenti menjadi teori. whisperkit-coreml — Whisper yang dikompil untuk perkakasan Apple — dimuat turun 8.31 juta kali dalam 30 hari lepas. Binaan MLX Parakeet untuk Apple Silicon meraih 1.87 juta, dan dua penukaran GGUF — format terkuantisasi yang menjalankan model pada CPU biasa — meraih 2.04 juta dan 1.87 juta. Berjuta orang sebulan memuat turun pengecaman pertuturan yang dibungkus khusus supaya berjalan pada mesin mereka sendiri. Itu bukan kehairanan penyelidikan. Itu saluran pengedaran.
Tempat pertama masih titik akhir pratonton yang anda tidak boleh muat turun
Perbandingan ini memisahkan ketepatan pengecaman daripada manfaat operasi menjalankan model sendiri.
Papan pertuturan-ke-teks Artificial Analysis, yang diperoleh pada 5 Ogos 2026, mengukur model terbuka dan tertutup menggunakan audio yang sama. Keputusan AA-WER v2 termasuk:
| Kedudukan | Model | AA-WER | Boleh dimuat turun? |
|---|---|---|---|
| 1 | Fun-Realtime-ASR-preview | 1.73 % | Tidak — titik akhir pratonton |
| 2 | Scribe v2, ElevenLabs | 2.18 % | Tidak — API dihoskan |
| 3 | MAI-Transcribe-1.5, Microsoft | 2.38 % | Tidak — API dihoskan |
| 4 | Smallest AI Pulse Pro | 2.43 % | Tidak — API dihoskan |
| 5 | Voxtral Small, Mistral | 2.77 % | Ya — Apache 2.0 |
| 6 | Gemini 3.1 Pro Preview, High | 2.82 % | Tidak — API dihoskan |
| 11 | Whisper Large v3 | 4.07 % | Ya — MIT |
Sumber: papan kedudukan pertuturan-ke-teks Artificial Analysis, AA-WER v2, ditarik pada 5 Ogos 2026. Status muat turun dinilai daripada lesen yang diterbitkan setiap model.
Empat baris teratas menunjukkan bahawa model dengan skor terbaik dalam petikan ini semuanya terhos, dan penerajunya ialah titik akhir pratonton, bukannya model yang boleh dimuat turun.
Kini baca baris kelima, kerana ia membetulkan pembetulan tadi. Voxtral Small berlesen Apache 2.0. Anda boleh memuat turunnya, menjalankannya pada perkakasan sendiri, dan menghantarnya secara komersial — dan ia berada di tempat kelima papan bebas dengan 2.77 %, kira-kira satu mata kadar ralat perkataan di belakang sebuah model pratonton tertutup. Diterjemah kepada mesyuarat sejam berisi 6,300 perkataan, jurang itu bernilai kira-kira 66 perkataan. Nyata, tetapi jauh daripada jurang menganga seperti yang lazim digambarkan.
Bagi banyak beban kerja, model pertuturan terbuka sudah boleh digunakan. Keputusan yang tinggal ialah sama ada jurang ketepatan yang sederhana berbaloi demi kawalan pengehosan sendiri, atau ciri tambahan perkhidmatan terhos membenarkan kosnya.
Apa yang anda peroleh dengan menjalankannya sendiri, dan apa kosnya
Ada tiga perkara yang menolak pasukan ke arah menghos sendiri, dan tiada satu pun berkenaan ketepatan.
Privasi yang pertama dan lazimnya menentukan. Jika anda mentranskripsi konsultasi perubatan, temu bual guaman, atau perbualan sumber manusia, "audio tidak meninggalkan perkakasan kami" bukan pilihan hati tetapi syarat perolehan, dan model yang anda hos sendiri ialah satu-satunya seni bina yang memenuhinya dengan kemas. Operasi luar talian yang kedua: model pada peranti berfungsi di dalam kapal terbang, di ruang bawah tanah, di lantai kilang, di tapak tanpa isyarat. Itulah sebabnya whisper.cpp dan binaan GGUF mempunyai angka muat turun seperti yang ada.
Kos yang ketiga, dan di sini angkanya terus terang. Daripada gambaran Artificial Analysis yang sama, harga bagi setiap 1,000 minit audio: Whisper Large v3 yang dihos di fal.ai berharga 0.50 dolar, Canary Qwen 2.5B daripada NVIDIA di Replicate 0.74, Parakeet TDT 0.6B V3 di Together AI 1.50. Di pihak tertutup, Nova-3 daripada Deepgram 4.30, MAI-Transcribe-1.5 6.00, dan Gemini 3.1 Pro Preview 18.15. Itu jurang 4 kali ganda berbanding Microsoft dan 12 kali ganda berbanding Google, semata-mata untuk menghos model terbuka pada pelayan orang lain — sebelum anda mempertimbangkan menjalankannya pada pelayan sendiri, yang di situ kos sut jam keseribu ialah elektrik.
Angka kelajuan dalam petikan yang sama memihak kepada Parakeet TDT 0.6B V3 yang disajikan di Together AI pada 885x masa nyata — kira-kira empat saat untuk memproses audio sejam. Deepgram Nova-3 mencapai 512x, Whisper Large v3 di Together 478x dan MAI-Transcribe-1.5 189x. Pilihan terpantas yang disenaraikan ialah model berat terbuka, tetapi keputusan ini mengukur pengehosan Together AI, bukannya perkakasan setempat.

Pertukaran ini tidak pernah ketepatan lawan ketepatan. Ia kawalan dan kos lawan ciri-ciri yang membaluti pengecaman.
Jadi apa lagi yang dijual oleh API dihoskan? Segala yang bukan pengecaman. Dokumentasi Deepgram ialah inventori yang adil: pengasingan penutur, penstriman masa nyata, pemformatan, perbendaharaan kata tersuai, penyamaran entiti, pengesanan bahasa, dan jaminan operasi bahawa ia terus hidup ketika anda tidur. Muat turun Qwen3-ASR dan anda memperoleh perkataan serta cap masa. Tiada label penutur, tiada SLA, dan bil GPU, penskalaan, serta panggilan pukul tiga pagi menjadi milik anda.
Model paling banyak dimuat turun dalam kategori ini bukan model transkripsi
Corak muat turun turut menunjukkan permintaan terhadap pengenalpastian penutur bersama transkripsi.
Apabila anda menyusun keseluruhan kategori pengecaman pertuturan automatik di Hugging Face mengikut muat turun, model di puncak bukan Whisper, bukan Qwen, bukan juga Parakeet. Ia pyannote/speaker-diarization-3.1, dengan 8.91 juta muat turun dalam 30 hari lepas, dan sebuah lagi model pengasingan penutur pyannote mengambil tempat kelima dengan 5.26 juta. Pengasingan penutur ialah jentera yang menentukan siapa bercakap bila — lapisan tepat di atas transkripsi.

Pemberat terbuka kini menutup dua lapisan pertama. Lapisan yang menentukan sama ada nota itu berguna terletak di atasnya.
Model yang paling banyak dimuat turun dalam kategori pengecaman pertuturan tidak mengecam pertuturan; model itu mengenal pasti siapa yang bercakap dan bila. Permintaan itu menunjukkan lapisan di atas transkripsi, tempat label penutur membantu menukar perkataan yang dikenal pasti menjadi rekod mesyuarat yang berguna. Hal ini seiring dengan jurang produk yang dihuraikan dalam analisis kami tentang pasaran tertutup.
Kesimpulan
Soalan menarik tentang pengecaman pertuturan open weight tidak pernah "adakah ia sebaik model tertutup". Ia berjarak kira-kira satu mata kadar ralat perkataan, ia lebih pantas, ia empat hingga dua belas kali lebih murah, dan ia muat pada komputer riba. Soalan menariknya ialah apa yang anda bina dalam ruang yang terbuka apabila transkripsi berhenti menjadi kos sewaan — kerana fail 1.56 GB yang mendengar 52 bahasa bukanlah produk. Ia sebuah komponen yang baru sahaja menjadi percuma.
Bagi pasukan yang memilih alat nota mesyuarat dan bukan memilih model, bacaannya ringkas. Sama ada sesebuah produk menjalankan model terbuka atau API tertutup kini sebahagian besarnya hanyalah butiran pelaksanaan, dan makin lama ia akan menjadi kedua-duanya: pemberat terbuka untuk kerja bervolum besar, API dihoskan di tempat pengasingan penutur, penstriman, dan skala berbaloi dengan harganya. Telli.sh sudah menjalankan model terbuka dalam lapisan ringkasannya, jadi kemajuan di pihak terbuka mengalir terus ke transkripsi, terjemahan, dan nota mesyuarat tanpa perubahan harga. Nilai alat itu daripada apa yang keluar di penghujung: sama ada nota itu memberitahu anda siapa berjanji melakukan apa.
Mulakan nota AI secara langsung
Sumber
- Kad model Qwen3-ASR-0.6B-hf (Hugging Face) — lesen, senarai bahasa, angka papan kedudukan bertarikh 26 Jun 2026
- Kad model Qwen3-ASR-1.7B-hf (Hugging Face)
- Qwen3-ForcedAligner-0.6B (Hugging Face)
- Qwen3-ASR Technical Report, arXiv:2601.21337 (dihantar 29 Januari 2026)
- Repositori OpenAI Whisper (MIT, diterbitkan 16 September 2022)
- whisper.cpp dan faster-whisper
- Kad model NVIDIA parakeet-tdt-0.6b-v3 (CC BY 4.0)
- Mistral Voxtral-Small-24B-2507 (Apache 2.0)
- Papan kedudukan pertuturan-ke-teks Artificial Analysis — AA-WER v2, angka kelajuan dan harga ditarik pada 5 Ogos 2026
- Hugging Face Open ASR Leaderboard
- Dokumentasi Deepgram tentang pengasingan penutur
- Halaman gambar di Wikimedia Commons
