Il riconoscimento vocale è diventato open weight in silenzio — e sta in 1,56 GB
I modelli Qwen3-ASR di Alibaba sono sotto licenza Apache 2.0, coprono 52 lingue e dialetti e pesano meno di due gigabyte. Una guida in parole semplici allo strato di trascrizione open weight: cosa esiste, cosa ti dà davvero eseguire un modello sul tuo portatile e dove le API chiuse continuano a vincere.
Ora puoi eseguire il riconoscimento vocale open weight su un portatile: il team Qwen di Alibaba pubblica Qwen3-ASR-0.6B, Qwen3-ASR-1.7B e il modello complementare Qwen3-ForcedAligner-0.6B sotto licenza Apache 2.0. Il download più piccolo è di 1,56 GB, supporta 52 lingue e dialetti e, dal 26 giugno, può essere eseguito con tre righe di Python standard. Usarlo sulla tua macchina evita una tariffa di trascrizione per ogni richiesta.
Il cambiamento sarà familiare a chi ha seguito i modelli linguistici aperti: ospitarli in proprio offre più controllo su costi, riservatezza e uso offline, mentre le API ospitate sono più semplici da gestire. Anche il riconoscimento vocale sta sviluppando questa stessa scelta, con modelli abbastanza piccoli da funzionare in locale.
Questa guida spiega cosa fa il riconoscimento vocale open weight, in cosa differiscono i modelli disponibili e le relative licenze, cosa può eseguire un modello piccolo e dove le API ospitate hanno ancora un vantaggio.
TL;DR:
- La trascrizione open weight è già utilizzabile: Qwen3-ASR con Apache 2.0 e 52 lingue e dialetti, Whisper con MIT, Parakeet e Canary di NVIDIA con CC BY 4.0, Voxtral di Mistral con Apache 2.0.
- L'auto-hosting porta riservatezza, funzionamento offline e controllo dei costi. Sulla classifica indipendente di Artificial Analysis, ospitare un modello aperto costa 1,50 dollari ogni 1.000 minuti, contro i 6,00 di MAI-Transcribe-1.5 di Microsoft e i 18,15 di Gemini 3.1 Pro Preview.
- Il primo posto per accuratezza resta un endpoint chiuso in anteprima. Ma un modello aperto sotto Apache 2.0, Voxtral Small, è ormai quinto, a circa un punto di tasso di errore sulle parole.
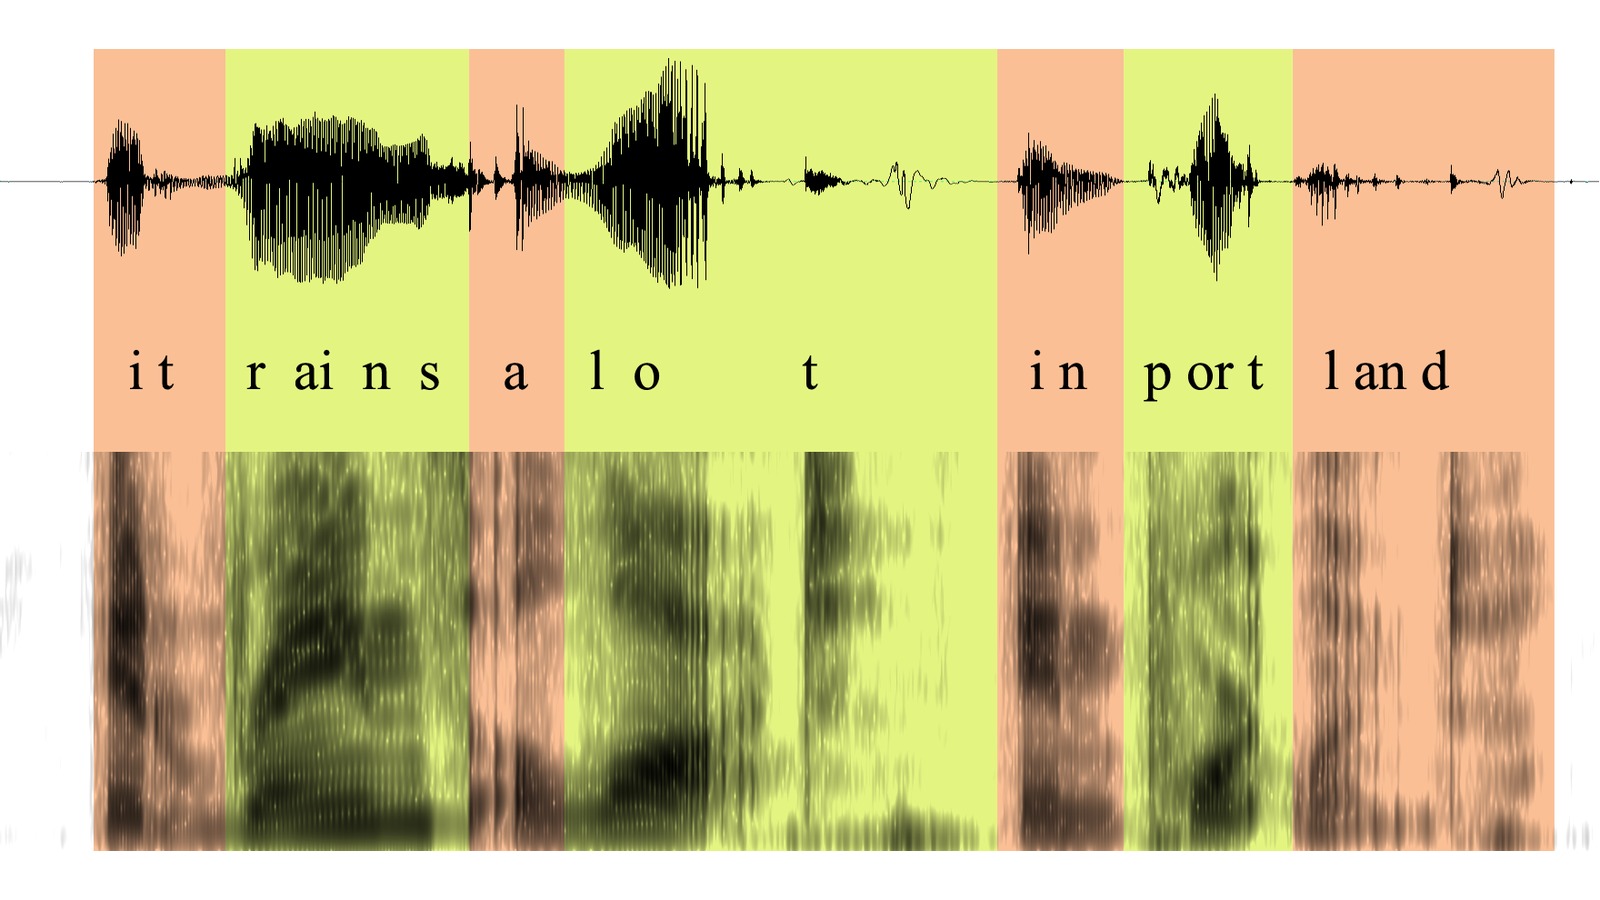
Immagine: Aaron Parecki, Wikimedia Commons, CC BY 2.0. Forma d'onda e spettrogramma della frase «it rains a lot in Portland», con le lettere posizionate sopra l'audio a cui corrispondono: è esattamente la materia prima su cui lavora ogni modello di riconoscimento vocale.
Cosa scarichi davvero quando scarichi un trascrittore
Un modello ASR — riconoscimento automatico del parlato, usato come sinonimo di STT, da voce a testo — è un programma che riceve audio e produce testo. Il lavoro è tutto qui. Non decide chi ha parlato, non riassume, non sa di cosa trattasse la tua riunione. Sente parole e le scrive.
«Open weights» significa che il laboratorio ha pubblicato il file del modello finito. I pesi di un modello sono l'enorme griglia di numeri che ha imparato durante l'addestramento, e pubblicarli significa che puoi scaricare quel file, eseguirlo sul tuo hardware e costruirci sopra senza chiedere il permesso a nessuno né pagare a richiesta. L'alternativa è un modello chiuso: i pesi restano sui server del fornitore e tu noleggi l'accesso tramite API — l'audio sale, il testo torna indietro e la fatturazione va a minuti.
Il numero nel nome è il conteggio dei parametri e, per i modelli vocali, è insolitamente concreto. «0.6B» vuol dire circa 600 milioni di parametri, il che in pratica rende Qwen3-ASR-0.6B un file da 1,56 GB e Qwen3-ASR-1.7B uno da 4,08 GB: entrambi abbastanza piccoli da stare sull'SSD di un portatile senza che nessuno se ne accorga. Confrontalo con i modelli linguistici aperti di cui abbiamo parlato nella nostra panoramica sulla Cina, dove il rilascio di punta era 1,56 terabyte su 96 frammenti e serviva un cluster solo per caricarlo. I modelli vocali sono circa mille volte più piccoli dei modelli testuali di frontiera, e questo singolo fatto spiega perché qui il cambiamento colpisce più forte che là.
Chiamiamo questa fascia di dimensioni la fascia da portatile: modelli così piccoli che provarli richiede un download, non una decisione sul budget hardware. La maggior parte dei modelli testuali di frontiera ne resta fuori; molti modelli vocali ci rientrano.
Controlla la licenza prima di adottare un modello. Apache 2.0 e MIT consentono uso, modifica e distribuzione commerciale; CC BY 4.0, usata dai modelli NVIDIA, consente anch'essa l'uso commerciale ma richiede l'attribuzione.
Qwen ha rilasciato la famiglia a gennaio; a giugno è diventata facile
Qwen3-ASR è apparso per la prima volta il 28 gennaio 2026 e il rapporto tecnico è arrivato su arXiv il giorno seguente. Il 26 giugno Qwen ha pubblicato le versioni -hf di tutti e tre i modelli, compatibili con Hugging Face Transformers dalla versione 5.13.0.
Il cambiamento di confezionamento rende la configurazione più familiare: invece di installare il pacchetto qwen-asr di Qwen o un backend vLLM, chi usa Transformers può caricare i checkpoint -hf con Python standard. Riduce il costo di configurazione senza cambiare ciò che il modello riconosce.
Le schede dei modelli indicano identificazione della lingua e riconoscimento in 30 lingue — tra cui inglese, cinese, coreano, giapponese, spagnolo, arabo, hindi, thai, vietnamita e polacco — più 22 dialetti cinesi, per un totale di 52 lingue e dialetti. Entrambe le versioni supportano inferenza in streaming e offline con un unico modello, accettano audio lunghi e indicano canto e brani con musica di sottofondo tra i tipi di audio supportati.
Qwen3-ForcedAligner-0.6B aggiunge l'allineamento forzato: ricevuti audio e trascrizione, indica l'inizio e la fine di ogni parola al millisecondo in 11 lingue, per clip fino a cinque minuti. Questo permette trascrizioni interattive, sincronizzazione dei sottotitoli e salti al momento in cui è stata pronunciata una parola. Pubblicare un allineatore insieme al riconoscitore rende la famiglia utile per creare prodotti di trascrizione, non solo per eseguire una demo.
Le schede di Qwen riportano risultati dell'Hugging Face Open ASR Leaderboard datati 26 giugno 2026: un tasso medio di errore sulle parole del 5,59 % per il modello 1.7B e del 6,31 % per lo 0.6B; nel sottoinsieme di audio di riunioni AMI, i valori sono 9,26 % e 10,57 %. Un tasso di errore più basso significa meno parole sbagliate. Qwen descrive il modello 1.7B come all'avanguardia tra i modelli ASR aperti e competitivo con le API commerciali; sono risultati comunicati dal fornitore. La classifica indipendente qui sotto usa audio diverso, quindi i punteggi non sono direttamente confrontabili.
È stato Whisper a cominciare, ed è ancora il modello che tutti eseguono
Niente di tutto questo esisterebbe in questa forma senza Whisper di OpenAI. Il repository è diventato pubblico il 16 settembre 2022 sotto licenza MIT — codice e pesi insieme — in un momento in cui riconoscimento vocale serio significava un contratto con un fornitore cloud. Da allora ha raccolto 106.679 stelle su GitHub.
Ciò che ha reso importante Whisper è stato meno il modello di quanto la comunità ci ha costruito sopra nel giro di mesi. whisper.cpp lo ha reimplementato in puro C e C++, licenza MIT, 52.591 stelle, facendolo girare su portatili e telefoni senza Python e senza GPU. faster-whisper lo ha ricostruito su CTranslate2 con un grande guadagno in velocità e memoria, sempre MIT, 24.750 stelle. Il modello era il seme; l'ecosistema era l'albero.
Quattro anni dopo, Whisper resta ampiamente utilizzato. Nei 30 giorni precedenti al 5 agosto 2026, whisper-large-v3-turbo è stato scaricato 8,72 milioni di volte da Hugging Face e whisper-large-v3 5,50 milioni; Qwen3-ASR-0.6B ha raggiunto 4,29 milioni. Nella classifica di Artificial Analysis, Whisper Large v3 ottiene un AA-WER del 4,07 %, contro l'1,73 % del leader in quella rilevazione.

Lo strato vocale aperto è arrivato in due ondate a tre anni di distanza, con quasi nulla in mezzo. Date di rilascio da GitHub e Hugging Face, consultate il 5 agosto 2026.
Il fronte aperto non è un laboratorio solo
Qwen non è sola, e le altre sono brave in cose nettamente diverse.
La linea Parakeet di NVIDIA punta sulla velocità. parakeet-tdt-0.6b-v3, rilasciato ad agosto 2025 sotto CC BY 4.0, ha 600 milioni di parametri, copre 25 lingue europee e supporta rilevamento automatico della lingua, punteggiatura, maiuscole e marcature temporali per parola per audio fino a 24 minuti per passaggio. La famiglia Canary di NVIDIA — canary-1b-v2 e canary-qwen-2.5b, anch'esse sotto CC BY 4.0 — offre capacità simili. I modelli Voxtral di Mistral, rilasciati a luglio 2025 sotto Apache 2.0, sono ai primi posti del confronto indipendente qui sotto.
Ecco il fronte aperto affiancato, con un'API ospitata nell'ultima riga come termine di paragone.
| Modello | Download | Licenza | Lingue | Gira su | Più forte in |
|---|---|---|---|---|---|
| Whisper Large v3 | 3,09 GB | MIT | 99 | Portatile o una GPU | Essere il default che tutto già supporta |
| Qwen3-ASR-0.6B | 1,56 GB | Apache 2.0 | 52 con dialetti | Portatile | Multilingua nella taglia più piccola |
| Qwen3-ASR-1.7B | 4,08 GB | Apache 2.0 | 52 con dialetti | Portatile o una GPU | La migliore accuratezza della famiglia Qwen |
| Parakeet TDT 0.6B v3 | 2,51 GB | CC BY 4.0 | 25 europee | Portatile o una GPU | Velocità e marcature temporali per parola |
| Voxtral Small | — | Apache 2.0 | — | GPU da server, 24 miliardi di parametri | Il punteggio aperto più alto sulla classifica indipendente |
| API ospitata | Non scaricabile | Proprietaria | Variabile | Il cloud del fornitore | Diarizzazione, streaming, continuità |
La dimensione del download è quella del checkpoint predefinito in ciascun repository Hugging Face. «—» indica che il materiale usato per questo confronto non riportava il valore. Rilevazione consultata il 5 agosto 2026.
Poi c'è il lavoro di confezionamento che porta questi modelli su dispositivi reali, il punto in cui la fascia da portatile smette di essere teorica. whisperkit-coreml — Whisper compilato per l'hardware Apple — è stato scaricato 8,31 milioni di volte negli ultimi 30 giorni. Una build MLX di Parakeet per Apple Silicon ha totalizzato 1,87 milioni e due conversioni GGUF — il formato quantizzato che fa girare i modelli su CPU ordinarie — 2,04 e 1,87 milioni. Milioni di persone al mese scaricano riconoscimento vocale confezionato apposta per girare sulla propria macchina. Non è una curiosità di ricerca. È un canale di distribuzione.
Il primo posto è ancora un endpoint in anteprima che non puoi scaricare
Il confronto separa la precisione del riconoscimento dai vantaggi operativi di eseguire un modello in proprio.
La classifica speech-to-text di Artificial Analysis, consultata il 5 agosto 2026, misura modelli aperti e chiusi sullo stesso audio. I risultati AA-WER v2 includono:
| Pos. | Modello | AA-WER | Scaricabile? |
|---|---|---|---|
| 1 | Fun-Realtime-ASR-preview | 1,73 % | No — endpoint in anteprima |
| 2 | Scribe v2, ElevenLabs | 2,18 % | No — API ospitata |
| 3 | MAI-Transcribe-1.5, Microsoft | 2,38 % | No — API ospitata |
| 4 | Smallest AI Pulse Pro | 2,43 % | No — API ospitata |
| 5 | Voxtral Small, Mistral | 2,77 % | Sì — Apache 2.0 |
| 6 | Gemini 3.1 Pro Preview, High | 2,82 % | No — API ospitata |
| 11 | Whisper Large v3 | 4,07 % | Sì — MIT |
Fonte: classifica speech-to-text di Artificial Analysis, AA-WER v2, consultata il 5 agosto 2026. La scaricabilità è dedotta dalla licenza pubblicata di ciascun modello.
Le prime quattro righe mostrano che i modelli con il punteggio migliore in questa rilevazione sono ospitati e che il leader è un endpoint in anteprima, non un modello scaricabile.
Voxtral Small è sotto Apache 2.0 e si classifica quinto con il 2,77 %, a circa un punto percentuale dal modello chiuso in anteprima al primo posto. In una riunione di un'ora con 6.300 parole, la differenza equivale a circa 66 parole. È un divario reale, ma non insormontabile per i team che danno valore all'esecuzione locale.
Per molti carichi di lavoro, i modelli vocali aperti sono già utilizzabili; la decisione rimanente è se un modesto divario di precisione valga il controllo dell'auto-hosting o se le funzioni aggiuntive di un servizio ospitato ne giustifichino il costo.
Cosa ti dà eseguirlo in casa e cosa ti costa
Tre cose spingono i team verso l'auto-hosting, e nessuna è l'accuratezza.
La riservatezza è la prima e di solito quella decisiva. Se trascrivi visite mediche, interviste legali o colloqui HR, «l'audio non esce dal nostro hardware» non è una preferenza ma un requisito d'acquisto, e un modello che ospiti tu è l'unica architettura che lo soddisfa in modo pulito. Il funzionamento offline è la seconda: un modello sul dispositivo funziona in aereo, in un seminterrato, in un capannone, in un sito senza copertura. È esattamente per questo che whisper.cpp e le build GGUF hanno i numeri di download che hanno.
Il costo è la terza, e qui i numeri sono spietati. Dalla stessa istantanea di Artificial Analysis, prezzo per 1.000 minuti di audio: Whisper Large v3 ospitato su fal.ai costa 0,50 dollari, Canary Qwen 2.5B di NVIDIA su Replicate 0,74, Parakeet TDT 0.6B V3 su Together AI 1,50. Sul fronte chiuso, Nova-3 di Deepgram è a 4,30, MAI-Transcribe-1.5 a 6,00 e Gemini 3.1 Pro Preview a 18,15. Un fattore 4 rispetto a Microsoft e 12 rispetto a Google solo per ospitare un modello aperto sui server di qualcun altro, prima ancora di considerare di farlo girare sui tuoi, dove il costo marginale della millesima ora è elettricità.
I dati sulla velocità della stessa rilevazione favoriscono Parakeet TDT 0.6B V3 servito su Together AI a 885 volte il tempo reale: elabora un'ora di audio in circa quattro secondi. Nova-3 di Deepgram raggiunge 512x, Whisper Large v3 su Together 478x e MAI-Transcribe-1.5 189x. L'opzione più veloce nell'elenco è un modello open weight, anche se questo risultato misura il servizio di Together AI, non l'esecuzione su hardware locale.

Il compromesso non è mai stato accuratezza contro accuratezza. È controllo e costo contro le funzioni avvolte attorno al riconoscimento.
Allora cosa vendono ancora le API ospitate? Tutto ciò che non è riconoscimento. La documentazione di Deepgram è un inventario onesto: diarizzazione dei parlanti, streaming in tempo reale, formattazione, vocabolario personalizzato, oscuramento delle entità, rilevamento della lingua e la garanzia operativa che resti in piedi mentre dormi. Scarica Qwen3-ASR e ottieni parole e marcature temporali. Nessuna etichetta di parlante, nessuno SLA, e tue sono la bolletta della GPU, la scalabilità e la chiamata alle tre di notte.
Il modello più scaricato della categoria non è un trascrittore
I dati sui download mostrano anche la domanda di identificazione dei parlanti oltre alla trascrizione.
Se ordini per download l'intera categoria riconoscimento automatico del parlato di Hugging Face, il modello in cima non è Whisper, né Qwen, né Parakeet. È pyannote/speaker-diarization-3.1, con 8,91 milioni di download negli ultimi 30 giorni, e un secondo modello di diarizzazione pyannote è quinto con 5,26 milioni. La diarizzazione è il meccanismo che stabilisce chi ha parlato e quando: lo strato immediatamente sopra la trascrizione.

I pesi aperti coprono ormai i primi due livelli dello stack. Quelli che decidono se una nota è utile stanno sopra.
Il modello più scaricato nella categoria del riconoscimento vocale non riconosce il parlato: identifica chi ha parlato e quando. Questa domanda indica il livello sopra la trascrizione, dove le etichette dei parlanti aiutano a trasformare le parole riconosciute in un verbale utile. È in linea con il divario di prodotto descritto nella nostra analisi del mercato chiuso.
In conclusione
La domanda interessante sul riconoscimento vocale open weight non è mai stata «è buono quanto i modelli chiusi». È a circa un punto di tasso di errore sulle parole, è più veloce, costa dalle quattro alle dodici volte meno e sta su un portatile. La domanda interessante è cosa costruisci nello spazio che si apre quando la trascrizione smette di essere una voce di spesa noleggiata, perché un file da 1,56 GB che sente 52 lingue non è un prodotto. È un componente che è appena diventato gratuito.
Per un team che sceglie uno strumento per le note di riunione e non un modello, la lettura pratica è breve. Che un prodotto esegua un modello aperto o un'API chiusa è ormai in gran parte un dettaglio implementativo, e sempre più sarà entrambe le cose: pesi aperti per il grosso del lavoro, API ospitate dove diarizzazione, streaming e scala si guadagnano il prezzo. Telli.sh esegue già un modello aperto nel suo strato di sintesi, così i progressi del fronte aperto arrivano diretti a trascrizione, traduzione e note di riunione senza variazioni di prezzo. Giudica lo strumento da ciò che esce alla fine: se la nota ti dice chi si è impegnato a fare cosa.
Fonti
- Scheda del modello Qwen3-ASR-0.6B-hf (Hugging Face) — licenza, elenco delle lingue, cifre di classifica datate 26 giugno 2026
- Scheda del modello Qwen3-ASR-1.7B-hf (Hugging Face)
- Qwen3-ForcedAligner-0.6B (Hugging Face)
- Qwen3-ASR Technical Report, arXiv:2601.21337 (inviato il 29 gennaio 2026)
- Repository OpenAI Whisper (MIT, pubblicato il 16 settembre 2022)
- whisper.cpp e faster-whisper
- Scheda del modello NVIDIA parakeet-tdt-0.6b-v3 (CC BY 4.0)
- Mistral Voxtral-Small-24B-2507 (Apache 2.0)
- Classifica speech-to-text di Artificial Analysis — AA-WER v2, dati di velocità e prezzo consultati il 5 agosto 2026
- Hugging Face Open ASR Leaderboard
- Documentazione Deepgram sulla diarizzazione
- Pagina dell'immagine su Wikimedia Commons
