图像生成器通常负责画椅子,它也能找出照片里的椅子吗?
Open Vision Banana 把分割和深度估计当作图像编辑任务。了解研究模型、评测条件,以及如何用自己的图片做对照实验。
一家家具零售商想给室内照片换背景。修图师得弄清椅子的边缘在哪里,植物挡住了椅子的哪一部分,地毯是否延伸到了椅腿后方。图像生成器能画出一个挺逼真的新房间。至于它能不能可靠地把原图中的椅子从周围分离出来,还得看它生成的掩膜。
Open Vision Banana 的作者在 2026 年 11 月 11 日发布的预印本中,把这类视觉感知问题当作图像编辑。他们适配了 40 亿和 90 亿参数的 FLUX.2 [klein] Base 图像生成模型,用 RGB 图像表达多种答案。掩膜用来标记区域,深度图则根据模型自己的表征编码各表面之间的距离关系。输出格式相同,各项任务及其误差衡量方式仍各不相同。
这个区别让研究有了实际意义。同一套基础模型可以承担多项视觉任务,但每项结果依然要达到各自的标准。对修图团队而言,要验证掩膜是否适合合成,也要核对近似深度图能否保持修图所需的前后顺序。本文用一张室内照片说明如何比较。
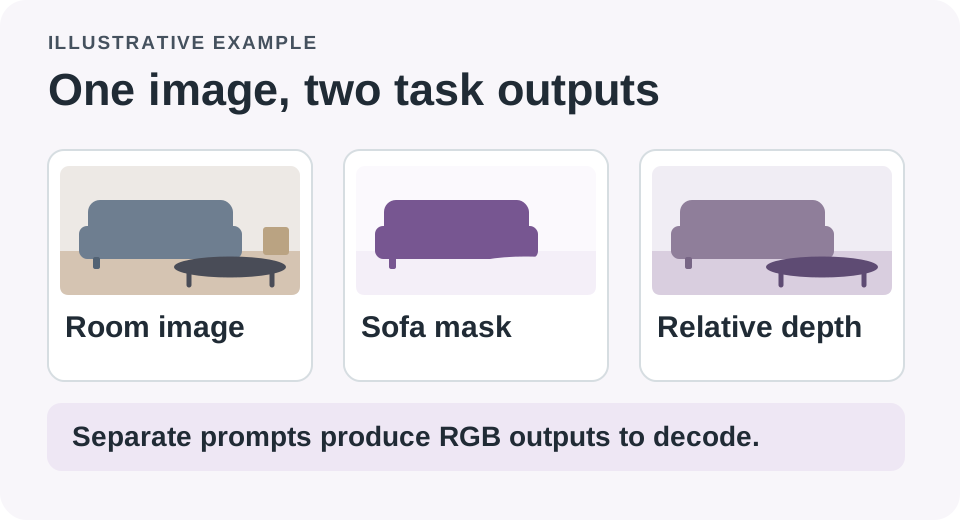
分割与深度可以采用相同的输出格式,同时回答关于同一张图像的不同问题。
一张图像可以回答不同的问题
语义分割把像素归入不同类别,比如椅子或地板。实例分割还要区分同类别的不同物体,比如左边的餐椅与右边几乎一样的椅子。指代分割从「窗边的椅子」之类的描述出发,寻找最符合描述的区域。深度图表达的是各处的表观距离。另一个受支持的任务是估计表面法线,也就是描述表面朝向。
Open Vision Banana 根据输入图像和任务提示词,生成一张承载答案的编辑后图像。分割提示词可以给出图例,把一个类别对应到某种颜色。后续通过图例解释生成的标签。深度输出则有自己的解码和评分约定。作者认为,提示词设计、颜色编码、参数适配和任务组合都会影响训练效果。单独表现不错的设置叠加起来,未必能得到最好的多任务模型。
就那张室内照片而言,有用的掩膜能帮助换掉背景,同时保留椅子的边缘。深度估计则能帮设计师核对构图,让新增元素出现在椅子后、墙壁前。两种用途的质量检查不一样。深度图即使平滑,如果把遮住椅子的植物排到了错误的一侧,还是无法使用。掩膜也可能看起来大致正确,却漏掉最终合成需要的细椅腿。
| 输出 | 在室内照片上检查什么 | 预览可能掩盖的问题 |
|---|---|---|
| 类别掩膜 | 椅子的像素与地板和墙分开 | 细椅腿或椅下空隙消失了 |
| 指代或实例掩膜 | 选中的椅子与其他椅子区分开 | 类别正确,找到的却是另一把椅子 |
| 深度估计 | 前景与背景保持工作所需的顺序 | 图面平滑,遮挡物却被放在错误的物体后面 |
结果图库可以查看作者提供的输出。上面的场景则是示例。与研究团队精选的漂亮效果图相比,用自己的照片做一次室内抠图,更能说明模型是不是适合你的流程。
高分是在一套特定流程下取得的
在 Cityscapes 语义分割任务上,作者报告 9B 零样本模型取得 73.9 mIoU,Vision Banana 早先公开的结果为 69.9。平均交并比衡量预测区域与参照区域的重叠程度,再按基准规则取平均。官方评估说明称,Cityscapes 的结果使用了 20 轮图例集成。各轮给同一类别分配不同的颜色,最后再汇总预测。一轮和二十轮的延迟及成本不同。
论文列举了通过投票提高分数而不更改模型权重的案例。这些结果适用于作者的评测配置,用到自己的照片上仍需单独验证。可以先跑简单设置,再看多跑几轮对你关心的错误有没有帮助。如果每轮都会漏掉同一道半透明细边,改用多数投票也弥补不了工具本身的不足。当问题出在提示词或颜色和类别的对应关系不稳定时,这项技术才可能发挥它的设计作用。
项目文档还区分了零样本和非零样本的训练数据组合。后者可能使用评测基准的训练集,项目称前者排除了这些训练集。如果只挑看上去最相近的数字做标题,可能把这层区别抹掉。一些实例分割评测还使用另一个模型判断目标是否存在,而 ReasonSeg 会重新表述查询。论文表示,模型的实例分割表现和 Vision Banana 仍有较大差距。读基准数据时,应留意每个分数用的流程,无法从一张总表判断哪个模型在所有任务上都更好。
深度分数也有自己的上下文。项目在 NYUv2 评测中对每张图进行视差对齐。因此,评测流程可以比较相对深度的部分特性。对齐后得分高,并不会让模型成为卷尺。设计团队可以核对哪个物体在前面。绝对尺寸、机器人的通行间隙和物理安全,则需要专门为这些决策构建并验证的系统提供依据。
视觉输出即使好看,边缘和重叠区域也要按照具体任务来检查。
共用一套模型能减少衔接代码,也会带来其他成本
即使专用模型在某项任务上依然领先,这种办法也值得试一试。在研究项目里,也许可以用类似的方式请求区域掩膜、深度图和编辑结果,并只维护一个模型家族。论文报告说,适配模型大体保留了原模型的图像编辑能力。这意味着可以试着用同一系统,针对相互关联的输入生成掩膜和编辑草稿。在撤掉目前擅长任一工作的工具前,要先检查两种结果。
用生成模型和专用掩膜模型分别处理同一个指定物体。记录输出能否准确转换为编辑器需要的 Alpha 掩膜。把头发、玻璃、空隙和阴影处的错误,同大块不透明表面上的错误分开数。一张书桌照片也许一轮就够用。如果整个产品目录里的家具都容易反光,检查和修边的时间可能超过共用一套模型所带来的便利。
4B 和 9B 两种规模都提供零样本和非零样本检查点。较小的检查点适合用来做有限试验,它的内存用量仍需根据配置测量。整个流程的资源用量取决于处理流程、分辨率、精度、运行环境和推理轮次。在笔记里记下这些因素,免得把配置改动的效果错算到模型头上。比较达到可接受结果的总时间,比只报最短推理用时有意义得多。
团队发布了代码和安装说明和结果图库。仓库把代码列为 Apache 2.0,公开权重则按 FLUX 非商业许可证提供。数据仍适用原有许可证。公开下载权重方便开展研究,商业产品目录是否能用这些文件则由使用权决定。用下面的试验理解方法,在实际采用之前确认计划用途所需的授权。
先挑那些出了错也看得出来的图片
初步研究对照可以从小规模做起。用自己拍摄或有权处理的照片,挑一些不用询问模型,也能确认目标和大致前后关系的例子。既选轮廓清楚的场景,也选遮挡关系容易混淆的场景。每一组可比较的试验都固定图像大小和提示词。这样能在扩大流程前了解哪项任务出错、怎样出错,免得只根据挑选过的示例判断可靠性。
- 手工标注一小组目标实例和遮挡区域,其中加入一个图中不存在的目标,让貌似合理的误检容易露馅。
- 选择并记录检查点、提示词、图像尺寸和推理轮次。用相同的图片比较专用模型和共用模型。
- 在掩膜或深度图真正要支持的操作中检查最终结果。例如,做抠图时把抠好的物体放到反差明显的背景上,别只看掩膜。
- 记录修复时间和常见错误类型。只要共用模型增加修图工作,或让重要错误更难发现,就保留现有的专用工具。
如果一个候选模型生成的掩膜很差,却给出了挺像样的编辑图,把两项观察都留下。它们分别回答不同的问题。多任务项目中的平均分可能遮住一项薄弱输出,而它恰恰会迫使人重新做后续工作。试行首先应找出新模型能够可靠支持的少数判断,没必要把功能数量填满一页幻灯片。
给修图师真正关心的问题计数。例如,数一数多少被选中的椅子要手动修整椅腿或边框,再看看有多少场景在对照中保住了遮挡顺序。自己挑的十张图片不足以证明普遍准确性。不过,它可能很快告诉你,真实来源的图片总会暴露哪类问题,而公开榜单上的平均值容易把这个问题掩盖过去。
还要检查流程最后交付了什么。保存为 RGB 可视化图的掩膜,往往要经过转换才能用作编辑器里的透明通道。核对转换是否保留指定的类别图例,以及保存过程有没有产生难以归类的像素。把原始生成图和衍生掩膜分别保存,这样就不会把转换错误误认为模型出了问题。换用新图例时把映射和结果一起记下来,以后才能按正确方式理解同一份文件中的颜色。
另一个用途示例是视觉参考图库。设计师在找「两层架子之间的灯」时,得到一个候选区域就可能有帮助,不一定需要可用于出版的像素精度。在这个场景下,展示几个可能匹配的区域让设计师选择,可能比直接给出一个貌似确定的抠图更实用。适不适合部署取决于任务。灵感板偶尔漏掉一个元素,和把轮廓有缺口的素材交给合成师,造成的返工成本并不一样。
图像做得好看,和准确看懂图像是两码事
创作场景之所以适合检验这个思路,是因为结果必须完成明确的工作。修图师要的是能在合成中用对的区域,而不只是看起来像一个区域的图。Open Vision Banana 值得跟进,因为它让一个模型家族承担多项任务,也公开了足够多的方法供人验证。比赛题目可以简单到:换掉背景以后,椅子的四条腿还在不在?
资料来源
评估视觉工作流时,把试验照片、提示词和对照记录整理到一起。用 Telli.sh 创建第一条笔记。