Um gerador de imagens consegue encontrar a cadeira que normalmente desenharia?
O Open Vision Banana trata a segmentação e a profundidade como tarefas de edição. Compare os checkpoints de pesquisa, as condições do benchmark e um jeito prático de testá-los.
Uma loja de móveis quer trocar o fundo da foto de uma sala. Quem edita precisa saber onde termina a cadeira, que parte da planta fica sobre ela e se o tapete passa atrás dos pés. Um gerador pode pintar uma sala nova e convincente. Para obter uma máscara confiável que separe a cadeira da foto de tudo ao redor, é preciso testar outra capacidade.
Em um preprint de 11 de novembro de 2026, os autores do Open Vision Banana tratam essas tarefas de percepção como edição de imagens. Eles adaptam geradores de imagens FLUX.2 [klein] Base com 4 e 9 bilhões de parâmetros para representar vários tipos de resposta em imagens RGB. No caso da máscara, a resposta identifica regiões. Na profundidade, codifica como as superfícies se relacionam em distância na representação do modelo. O formato de saída é compartilhado, enquanto a tarefa e a maneira de medir erros continuam diferentes.
Essa distinção é o centro da pesquisa. A mesma base pode assumir várias tarefas visuais, mas o resultado ainda precisa passar pelos testes de cada uma. Para uma equipe de edição, isso significa conferir se a máscara funciona na composição final e se um mapa de profundidade aproximado preserva a ordem em que os elementos devem aparecer. Vamos usar a foto de uma sala para mostrar como fazer essa comparação.
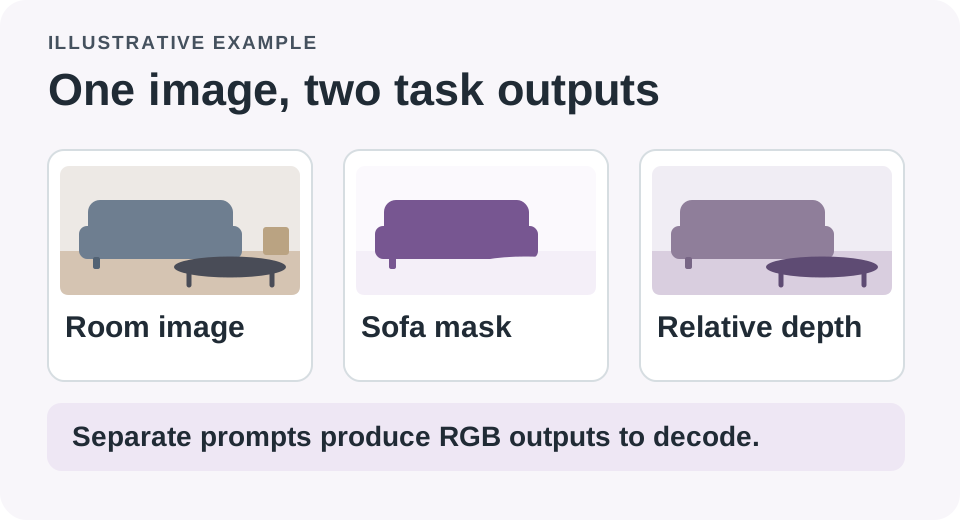
Segmentação e profundidade podem compartilhar o formato de saída e responder a perguntas diferentes sobre a mesma imagem.
Há mais de um jeito de transformar uma imagem em resposta
A segmentação semântica atribui pixels a categorias como cadeira ou piso. A segmentação por instância procura separar objetos individuais da mesma categoria: a cadeira de jantar à esquerda é distinta da quase idêntica à direita. A segmentação guiada por descrição parte de um pedido como a cadeira ao lado da janela e busca a região correspondente. Um mapa de profundidade representa a cena em termos de distâncias aparentes. O projeto também trabalha com normais à superfície, que descrevem a orientação dessas superfícies.
O Open Vision Banana recebe uma imagem e um prompt para a tarefa. Ele devolve uma imagem editada que contém a resposta. Um prompt de segmentação pode definir uma legenda que associa cada classe a uma cor. Os rótulos gerados são interpretados com essa legenda. A saída de profundidade segue convenções próprias de decodificação e avaliação. Os autores apontam a formulação do prompt, a codificação de cores, a adaptação de parâmetros e a escolha das tarefas combinadas como partes importantes do método de treinamento. Reunir as opções mais promissoras de forma isolada pode resultar em um modelo multitarefa inferior ao esperado.
Na foto da sala, uma boa máscara facilita a troca de fundo e preserva o contorno da cadeira. Uma estimativa de profundidade pode ajudar a conferir uma composição na qual um elemento novo deve passar atrás da cadeira e à frente da parede. Os dois exemplos exigem verificações diferentes. Um mapa suave pode ser inadequado se colocar uma planta que cobre parte da cadeira no lado errado. Um resultado bonito que delimita quase toda a cadeira ainda pode omitir os pés finos necessários para a composição final.
| Saída | O que conferir na foto da sala | Uma falha que a prévia pode esconder |
|---|---|---|
| Máscara de classe | Os pixels da cadeira estão separados do piso e da parede | Pés finos ou o espaço sob a cadeira desaparecem |
| Máscara guiada por descrição ou por instância | A cadeira pedida está separada das outras | A categoria correta esconde a instância errada |
| Estimativa de profundidade | Primeiro plano e fundo preservam a ordem necessária | Um mapa suave põe o elemento que encobre outro atrás do objeto errado |
A galeria traz resultados dos autores. O cenário acima é ilustrativo. Um recorte feito na sua própria foto ajuda a avaliar se o método serve para seu fluxo. Um belo exemplo escolhido pela equipe de pesquisa diz menos sobre o seu caso.
A pontuação alta vem com um protocolo
Na segmentação semântica do Cityscapes, os autores informam 73,9 mIoU para o modelo de 9 bilhões de parâmetros em modo zero-shot, ante os 69,9 relatados anteriormente para o Vision Banana. A interseção média sobre a união mede a sobreposição entre as regiões previstas e as de referência, com a média calculada segundo o benchmark. As notas oficiais de avaliação dizem que o resultado do Cityscapes combina 20 execuções com legendas diferentes. Cada execução atribui cores diferentes às mesmas categorias, e o processo combina as respostas. Uma execução e vinte execuções têm custos e tempos de resposta diferentes.
O artigo descreve casos em que a votação melhora os resultados sem alterar os pesos do modelo. A evidência vem da configuração do benchmark dos autores. Para as suas fotos, rode primeiro a configuração mais simples e veja se execuções adicionais ajudam na falha que importa. Se todas as tentativas perderem uma borda fina e transparente, vale testar uma ferramenta mais adequada. A combinação pode ajudar quando a instabilidade vem da interpretação do prompt ou da associação de classes às cores, o problema que a técnica procura resolver.
A documentação também distingue as combinações de treinamento zero-shot e não zero-shot. As não zero-shot podem incluir as partições de treinamento dos benchmarks de avaliação. Segundo o projeto, as zero-shot excluem essas partições. Uma manchete que compara números aparentemente equivalentes pode apagar essa diferença. Em algumas execuções de segmentação por instância, outro modelo verifica se o objeto está presente. O ReasonSeg usa reescritas de consultas. O artigo informa que, na segmentação por instância, os resultados ainda ficam mais distantes dos do Vision Banana. Leia cada resultado à luz do protocolo daquela prova.
Os números de profundidade também pedem contexto. Na avaliação com NYUv2, o projeto alinha a disparidade de cada imagem. Assim é possível comparar aspectos importantes da profundidade relativa de acordo com o protocolo. Uma pontuação alta depois do alinhamento não fornece medições físicas. Uma equipe de design pode conferir qual objeto está mais à frente. Medidas absolutas, espaço livre para robôs e segurança física exigem evidências de sistemas construídos e verificados para essas decisões.
Um bom resultado visual ainda exige verificações específicas nas bordas e nas áreas de sobreposição.
Um editor compartilhado pode reduzir a integração e trazer outro custo
Há motivos para experimentar a abordagem mesmo se um modelo especializado ainda vencer em uma tarefa. Talvez seja possível pedir uma máscara de região, uma imagem de profundidade e uma edição de maneiras parecidas, usando a mesma família de modelos em um projeto de pesquisa. Segundo o artigo, os modelos adaptados mantêm boa parte da capacidade de edição da base. Isso abre espaço para testar um único sistema que produza uma máscara e esboce uma edição a partir de entradas relacionadas. Confira os dois resultados antes de retirar uma ferramenta que já faz bem uma das tarefas.
Compare uma execução com o gerador e outra com um modelo especializado em máscaras, pedindo o mesmo objeto. Registre se é possível converter a saída para a máscara alfa que seu editor espera. Conte separadamente erros em cabelo, vidro, frestas e sombras e erros em grandes superfícies opacas. Em uma foto de uma mesa, uma execução pode dar conta. Em um catálogo cheio de móveis reflexivos, o tempo de inspeção e retoque pode superar a vantagem de usar um só modelo.
As famílias de checkpoints de 4 e 9 bilhões de parâmetros incluem versões zero-shot e não zero-shot. Um checkpoint menor é um candidato razoável para uma avaliação limitada. Confira o uso real de memória. O consumo total depende do fluxo, da resolução, da precisão, do ambiente de execução e da quantidade de passagens. Registre esses fatores para separar mudanças de modelo de mudanças de configuração. Compare o tempo total até chegar a uma saída aceitável, incluindo o trabalho que vem depois da previsão.
A equipe publica o código e as instruções de configuração e uma galeria de resultados. O repositório indica a licença Apache 2.0 para o código e a FLUX Non-Commercial License para os pesos distribuídos. Os dados conservam suas licenças originais. O download público dos pesos ajuda na pesquisa. Um catálogo comercial exige permissões adequadas. Faça o teste abaixo para conhecer o método e obtenha as permissões que se aplicam ao uso pretendido antes de adotá-lo.
Comece por imagens em que você consegue enxergar a falha
Uma comparação exploratória pode ser pequena. Use fotos que você tirou ou tem autorização para processar. Escolha imagens em que consiga identificar o objeto procurado e a ordem aproximada dos planos sem recorrer ao modelo. Inclua contornos fáceis de distinguir e sobreposições ambíguas. Mantenha fixos o tamanho da imagem e o prompt em cada execução comparável. Procure saber qual tarefa falha e de que jeito antes de ampliar um fluxo que talvez pareça confiável apenas em exemplos selecionados.
- Marque manualmente um conjunto pequeno de objetos e regiões encobertas. Inclua um objeto ausente para facilitar a identificação de um falso positivo plausível.
- Escolha e registre o checkpoint, o prompt, o tamanho da imagem e a quantidade de execuções. Compare o modelo especializado e o compartilhado com imagens idênticas.
- Confira a máscara ou a profundidade final na operação em que ela será usada. Teste um recorte em um fundo contrastante para avaliar a qualidade da composição.
- Registre o tempo de correção e os tipos de falha mais comuns. Mantenha a ferramenta especializada se o modelo compartilhado exigir mais edição ou esconder um erro importante.
Quando um candidato produz uma máscara ruim e uma edição convincente da imagem original, registre as duas observações. Elas respondem a perguntas diferentes. Em um projeto multitarefa, a média pode ocultar a única saída fraca que obriga a equipe a repetir a etapa seguinte. O primeiro objetivo de um piloto é descobrir quais poucas decisões um novo modelo consegue apoiar com confiança. O número de recursos em um slide vem depois.
Meça os casos que afetam a edição. Conte quantas cadeiras selecionadas precisaram de retoques manuais nos pés ou na estrutura e quantas cenas preservaram a ordem de sobreposição no comparativo. Dez fotos suas formam uma amostra pequena demais para estabelecer a precisão geral. Ainda podem poupar tempo se uma imagem realista expõe repetidamente uma falha que desapareceria na média de um ranking público.
A comparação também deve cobrir o que sai do fluxo. Uma máscara salva como visualização RGB pode exigir conversão antes de ser usada como transparência. Verifique se a conversão preserva a legenda de classes solicitada e se a imagem salva introduz pixels ambíguos. Guarde a imagem gerada e a máscara derivada separadamente para identificar eventuais erros na conversão. Ao experimentar uma legenda nova, registre-a junto do resultado. Assim será possível interpretar as cores do arquivo mais tarde.
Um segundo exemplo é uma biblioteca de referências visuais. Quem busca “a luminária entre as prateleiras” pode aproveitar uma sugestão de região sem exigir a precisão de pixels necessária para publicação. Nessas condições, mostrar algumas regiões possíveis e deixar o designer escolher pode ser mais útil do que retornar automaticamente um único recorte. A escolha de implantar depende da tarefa. Perder ocasionalmente um item em um painel de referências tem um custo diferente de entregar a quem faz a composição uma silhueta discretamente incompleta.
Uma imagem bonita pode esconder uma percepção errada
O exemplo criativo funciona porque dá um trabalho para a saída. Quem faz a edição precisa de uma região que se comporte corretamente na composição. A aparência da máscara por si só diz pouco. O Open Vision Banana reúne várias tarefas na mesma família de modelos e publica o suficiente do método para colocar a ideia à prova. O teste pode ser simples: quando o fundo muda, a cadeira fica com os quatro pés?
Fontes
- Preprint do Open Vision Banana, enviado pela primeira vez em 11 de novembro de 2026
- Projeto da equipe de pesquisa e galeria de resultados
- Código oficial, checkpoints, protocolo de avaliação e informações sobre licenças
Organize as fotos de teste, os prompts e as notas da comparação enquanto avalia um fluxo de visão computacional. Crie sua primeira nota com o Telli.sh.