Kann ein Bildgenerator den Stuhl finden, den er sonst zeichnen würde?
Open Vision Banana behandelt Segmentierung und Tiefenschätzung als Bildbearbeitung. So vergleichst du Checkpoints, Benchmarkbedingungen und die Ergebnisse mit eigenen Bildern.
Ein Möbelhändler möchte den Hintergrund eines Raumfotos austauschen. Für die Bearbeitung muss klar sein, wo der Stuhl endet, welche Teile die Pflanze verdeckt und ob der Teppich hinter den Stuhlbeinen verläuft. Ein Bildgenerator kann einen überzeugenden neuen Raum malen. Ob er auch eine zuverlässige Maske liefert, die den vorhandenen Stuhl von seiner Umgebung trennt, ist damit noch offen.
In einem Preprint vom 11. November 2026 behandeln die Autoren von Open Vision Banana solche Wahrnehmungsaufgaben als Bildbearbeitung. Sie passen Bildgeneratoren aus der Familie FLUX.2 [klein] Base mit vier und neun Milliarden Parametern an. Die Modelle können verschiedene Arten von Antworten als RGB-Bild ausgeben. Eine Maske markiert Bildregionen. Das Tiefenbild kodiert die Abstandsbeziehungen von Oberflächen in der Darstellung des Modells. Das Ausgabeformat ist gleich, Aufgaben und Fehlermaße unterscheiden sich.
Hier liegt der praktische Nutzen der Forschung. Dasselbe Basismodell kann mehrere Sehaufgaben übernehmen, aber jede Ausgabe muss ihre eigenen Anforderungen erfüllen. Ein Bildbearbeitungsteam muss prüfen, ob sich eine Maske in einer Montage bewährt und ob eine ungefähre Tiefenkarte die Reihenfolge der Objekte für die Bearbeitung korrekt wiedergibt. An einem Raumfoto lässt sich zeigen, wie dieser Vergleich ablaufen kann.
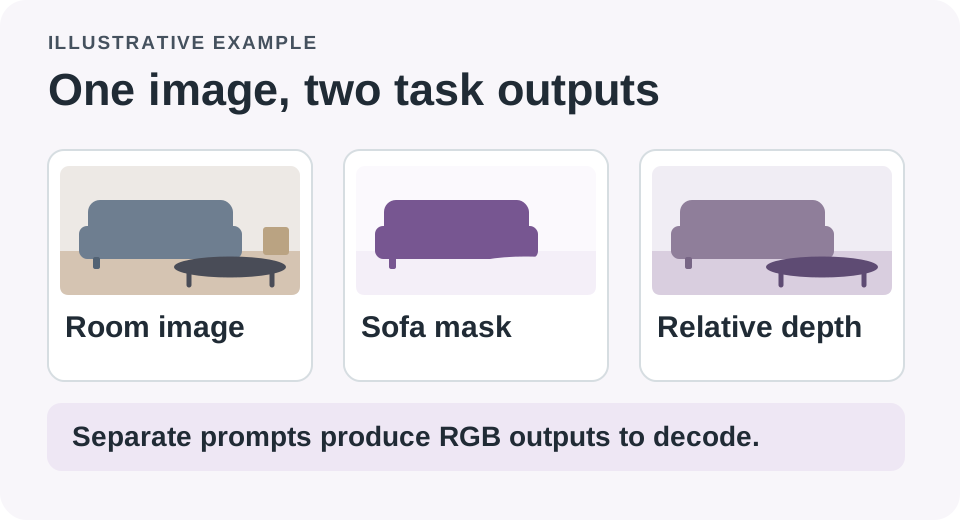
Segmentierung und Tiefenschätzung können dasselbe Format nutzen und dabei unterschiedliche Fragen zum selben Bild beantworten.
Ein Bild kann verschiedene Antworten liefern
Semantische Segmentierung ordnet Pixel Kategorien wie Stuhl oder Boden zu. Instanzsegmentierung versucht zusätzlich, einzelne Gegenstände derselben Kategorie zu trennen, etwa den Esszimmerstuhl links von dem fast identischen Stuhl rechts. Bei der referenzbasierten Segmentierung gibt man eine Beschreibung wie „der Stuhl neben dem Fenster“ vor und fragt nach dem passenden Bereich. Eine Tiefenkarte beschreibt die scheinbaren Abstände in der Szene. Auch die Ausrichtung von Oberflächen lässt sich mit Oberflächennormalen darstellen, einer weiteren unterstützten Aufgabe.
Open Vision Banana erzeugt aus einem Eingabebild und einem Aufgabenprompt ein bearbeitetes Bild, das die Antwort enthält. Ein Segmentierungsprompt kann eine Legende vorgeben, die jeder Klasse eine Farbe zuordnet. Anhand der Legende lassen sich die erzeugten Markierungen auswerten. Eine Tiefenausgabe wird nach eigenen Regeln dekodiert und bewertet. Laut den Autoren beeinflussen der Aufbau des Prompts, die Farbkodierung, die Parameteranpassung und die Mischung der Aufgaben den Trainingserfolg. Entscheidungen, die einzeln gut abschneiden, ergeben zusammen nicht automatisch das beste Modell für mehrere Aufgaben.
Für das Raumfoto könnte eine gute Maske beim Austausch des Hintergrunds helfen und dabei die Konturen des Stuhls erhalten. Eine Tiefenschätzung könnte bei einer Montage zeigen, ob ein neues Element hinter dem Stuhl und vor der Wand liegt. Die beiden Aufgaben brauchen unterschiedliche Qualitätsprüfungen. Eine glatte Tiefenkarte kann unbrauchbar sein, wenn sie die verdeckende Pflanze auf die falsche Seite des Stuhls setzt. Eine ansprechend dargestellte Stuhlmaske kann wiederum die dünnen Beine auslassen, die in der fertigen Montage zu sehen sein sollen.
| Ausgabe | Was am Raumfoto zu prüfen ist | Welchen Fehler die Vorschau verdecken kann |
|---|---|---|
| Klassenmaske | Stuhlpixel sind deutlich von Boden und Wand getrennt | Dünne Beine oder der Zwischenraum unter dem Stuhl verschwinden |
| Referenz- oder Instanzmaske | Der gesuchte Stuhl ist von den anderen Stühlen getrennt | Die Kategorie stimmt, aber die Maske zeigt den falschen Stuhl |
| Tiefenschätzung | Vorder- und Hintergrund behalten die benötigte Reihenfolge | Eine gleichmäßige Karte setzt das verdeckende Objekt hinter den falschen Gegenstand |
In der Galerie sind die Ausgaben der Autoren verlinkt. Das Szenario mit dem Raumfoto ist ein Beispiel. Ob sich die Methode für deine Arbeit eignet, zeigt ein Freistellversuch mit einem eigenen Bild besser als ein besonders gelungenes Beispiel aus einer Forschungsgalerie.
Der hohe Punktwert gehört zu einer bestimmten Auswertung
Für die semantische Segmentierung auf Cityscapes berichten die Autoren für ihr 9B-Modell im Zero-Shot-Setting 73,9 mIoU. Für Vision Banana wurden zuvor 69,9 angegeben. Mean Intersection over Union misst die Überlappung von vorhergesagten und tatsächlichen Regionen nach den Mittelungsregeln des Benchmarks. Laut den offiziellen Evaluationshinweisen beruht das Cityscapes-Ergebnis auf 20 Durchläufen eines Ensembles mit wechselnden Farblegenden. Die Durchläufe weisen denselben Klassen unterschiedliche Farben zu und führen die Resultate anschließend zusammen. Ein Durchlauf braucht andere Laufzeit und Ressourcen als zwanzig.
Die Studie nennt Fälle, in denen das Abstimmungsverfahren die Punktwerte verbessert, ohne die Modellgewichte zu ändern. Diese Ergebnisse stammen aus dem Testaufbau der Autoren. Ob sich der Effekt auf deine Fotos überträgt, ist separat zu prüfen. Beginne mit der einfachen Konfiguration und schau, ob zusätzliche Durchläufe bei dem konkreten Fehler helfen. Übersieht jeder Durchlauf dieselbe dünne, durchscheinende Kante, behebt eine Mehrheitsentscheidung das Problem nicht. Sie kann helfen, wenn die Zuordnung zwischen Prompt, Farbe und Klasse instabil ist. Dafür wurde das Verfahren entwickelt.
Die Projektdokumentation unterscheidet zudem Trainingsmischungen für Zero-Shot- und Nicht-Zero-Shot-Auswertungen. Letztere können die Trainingsdaten der Testbenchmarks enthalten. Für das Zero-Shot-Modell wurden diese Trainingsdaten laut Projekt ausgeschlossen. Wer nur die ähnlichsten Zahlen in einer Überschrift gegenüberstellt, kann den Unterschied übersehen. Bei manchen Instanzsegmentierungstests prüft ein zusätzliches Modell, ob das Objekt vorhanden ist. Für ReasonSeg werden Anfragen umformuliert. Der Studie zufolge liegt das Modell bei der Instanzsegmentierung noch deutlicher hinter Vision Banana. Für jede Kennzahl zählt der konkrete Testablauf. Eine einzige Rangliste reicht hier nicht aus.
Auch Tiefenwerte brauchen ihren eigenen Kontext. Bei der NYUv2-Auswertung gleicht das Projekt die Disparität für jedes Bild separat ab. Damit lassen sich für das jeweilige Benchmarkprotokoll wichtige Eigenschaften der relativen Tiefe vergleichen. Aus einem hohen Wert nach diesem Abgleich ergibt sich keine absolute Messung. Ein Designteam kann prüfen, welches Objekt vorne liegt. Für absolute Maße, den Abstand eines Roboters zu Hindernissen und physische Sicherheit sind Systeme nötig, die für genau diese Entscheidungen entwickelt und geprüft wurden.
Auch eine überzeugende Ausgabe braucht aufgabenspezifische Prüfungen an Kanten und in überlappenden Bereichen.
Ein gemeinsames Modell spart Schnittstellencode und kann anderswo mehr Aufwand verursachen
Der Ansatz ist einen Versuch wert, auch wenn ein Spezialmodell bei einer bestimmten Aufgabe besser bleibt. In einem Forschungsprojekt könntest du eine Regionsmaske, ein Tiefenbild und eine Bearbeitung auf ähnliche Weise anfordern und bei einer Modellfamilie bleiben. Laut Studie behalten die angepassten Modelle den Großteil der Bildbearbeitungsfähigkeiten ihrer Basismodelle. Damit lässt sich ausprobieren, aus zusammengehörigen Eingaben mit demselben System eine Maske und einen Bearbeitungsentwurf zu erstellen. Prüfe beide Ausgaben, bevor du eines der bewährten Werkzeuge ersetzt.
Vergleiche den Generator mit einem spezialisierten Maskenmodell am selben Gegenstand. Notiere, ob sich die Ausgabe sauber in die Alphamaske umwandeln lässt, die dein Editor erwartet. Zähle Fehler an Haaren, Glas, Zwischenräumen und Schatten getrennt von Fehlern auf großen undurchsichtigen Flächen. Bei einem Schreibtischfoto kann ein Durchlauf genügen. Bei einem Möbelkatalog mit vielen spiegelnden Oberflächen kann die Zeit für Prüfung und Nachbearbeitung den Vorteil des gemeinsamen Modells aufwiegen.
Für 4B und 9B gibt es jeweils Checkpoints für beide Trainingsmischungen. Ein kleinerer Checkpoint kommt für begrenzte Tests infrage. Wie viel Speicher er tatsächlich benötigt, muss gemessen werden. Der Ressourcenverbrauch über den ganzen Ablauf hängt unter anderem von Pipeline, Auflösung, Rechengenauigkeit, Laufzeitumgebung und Zahl der Durchläufe ab. Halte diese Faktoren fest, damit du Modelländerungen von geänderten Einstellungen unterscheiden kannst. Vergleiche die gesamte Zeit bis zu einer brauchbaren Ausgabe und erfasse nicht nur die schnellste Vorhersage.
Das Team veröffentlicht Code und Einrichtungshinweise und eine Galerie mit Ergebnissen. Laut Projekt steht der Code unter Apache 2.0, die bereitgestellten Gewichte unter der FLUX Non-Commercial License. Für die Daten gelten weiterhin deren ursprüngliche Lizenzen. Öffentlich herunterladbare Gewichte helfen der Forschung. Ob dieselben Dateien für einen kommerziellen Katalog zulässig sind, richtet sich nach den Nutzungsrechten. Probiere das Verfahren anhand des folgenden Versuchs aus und kläre vor der Übernahme die Rechte für die beabsichtigte Nutzung.
Fang mit Bildern an, bei denen du einen Fehler erkennen kannst
Ein erster Vergleich kann klein bleiben. Verwende eigene Fotos oder solche, die du bearbeiten darfst. Wähle Bilder, auf denen du das gesuchte Objekt und die ungefähre Reihenfolge von Vorder- und Hintergrund selbst bestimmen kannst. Nimm sowohl einfache Konturen als auch mehrdeutige Überlappungen auf. Halte bei vergleichbaren Durchläufen Bildgröße und Aufgabenprompt konstant. So erkennst du, welche Aufgabe wie scheitert, bevor du einen an ausgewählten Beispielen zuverlässig wirkenden Ablauf ausweitest.
- Markiere einige Zielobjekte und Verdeckungen von Hand. Wähle auch ein Objekt, das nicht im Bild vorkommt, damit sich ein plausibler Fehlalarm leicht erkennen lässt.
- Lege Checkpoint, Prompt, Bildgröße und Zahl der Durchläufe fest und dokumentiere sie. Nutze für Spezialmodell und gemeinsames Modell dieselben Bilder.
- Prüfe Maske oder Tiefenausgabe beim vorgesehenen Bearbeitungsschritt. Setze einen Freisteller zum Beispiel vor einen kontrastreichen Hintergrund und beurteile auch dieses Ergebnis.
- Erfasse Korrekturzeit und typische Fehler. Behalte das bisherige Spezialwerkzeug bei, wenn das gemeinsame Modell mehr Nacharbeit verursacht oder einen wichtigen Fehler verdeckt.
Erzeugt ein Modell eine schlechte Maske, aber eine überzeugende Bearbeitung des Ausgangsbilds, dokumentiere beides. Die beiden Beobachtungen beantworten unterschiedliche Fragen. Ein Mittelwert über viele Aufgaben kann eine schwache Ausgabe verdecken, die den nächsten Arbeitsschritt zur Handarbeit macht. Ein Pilot sollte zuerst herausfinden, welche wenigen Entscheidungen das Modell zuverlässig unterstützen kann. Eine möglichst lange Funktionsliste hilft dabei wenig.
Zähle, was für die Bildbearbeitung wichtig ist. Du könntest etwa erfassen, bei wie vielen ausgewählten Stühlen Beine oder Rahmen von Hand korrigiert werden mussten und in wie vielen Szenen die Reihenfolge überlappender Objekte stimmt. Zehn eigene Bilder reichen nicht für Aussagen zur allgemeinen Genauigkeit. Sie können aber schnell zeigen, ob realistische Eingaben wiederholt denselben Fehler sichtbar machen, der in einem öffentlichen Mittelwert untergehen würde.
Der Vergleich sollte auch das Ende der Verarbeitung einschließen. Eine als RGB-Illustration ausgegebene Maske muss womöglich umgewandelt werden, bevor der Editor sie für Transparenz verwenden kann. Prüfe, ob die Umwandlung die vorgegebene Klassenlegende beibehält und beim Speichern mehrdeutige Pixel entstehen. Bewahre das generierte Bild und die abgeleitete Maske getrennt auf, damit du einen Umwandlungsfehler nicht dem Modell zuschreibst. Protokolliere eine neue Farblegende zusammen mit der Ausgabe, um deren Farben später richtig auslegen zu können.
Ein weiterer möglicher Einsatz ist eine visuelle Referenzsammlung. Sucht eine Designerin nach der „Lampe zwischen den Regalen“, kann ihr ein vorgeschlagener Bildbereich helfen, ohne dass sie eine publikationsreife Maske braucht. Einige denkbare Treffer zur Auswahl sind in diesem Fall womöglich hilfreicher als ein automatisch und mit scheinbarer Gewissheit ausgewählter Freisteller. Es kommt auf den Auftrag an. Ein gelegentlich fehlendes Objekt auf einem Moodboard hat andere Folgen als eine leicht unvollständige Kontur in einer Bildmontage.
Ein ansprechendes Bild und ein richtig erkanntes Motiv sind zwei verschiedene Ergebnisse
Der Kreativeinsatz ist ein guter Test, weil die Ausgabe eine konkrete Aufgabe erfüllen muss. Wer ein Bild montiert, braucht eine Region, die sich im Ergebnis richtig verhält. Eine hübsche Darstellung einer Region reicht dafür nicht. Open Vision Banana macht mehrere Aufgaben mit einer Modellfamilie erreichbar und legt genügend Teile des Verfahrens offen, um das auszuprobieren. Der Test kann ganz einfach sein: Hat der Stuhl nach dem Hintergrundwechsel noch alle vier Beine?
Quellen
- Open Vision Banana: Preprint, zuerst eingereicht am 11. November 2026
- Projekt und Ergebnisgalerie des Forschungsteams
- Offizieller Code, Checkpoints, Evaluationsprotokoll und Lizenzhinweise
Halte Testfotos, Prompts und Vergleichsnotizen für deine Auswertung zusammen fest. Erstelle deine erste Notiz mit Telli.sh.