你的本地 AI 现在会说话了:Ollama 的 Phonon 更新究竟打开了什么
Ollama 借助 Gradium 的 Phonon 模型加入本地语音生成。看看哪些听读流程值得尝试、当前的 macOS 限制,以及为什么最小模型的许可证很重要。
本地语言模型的回答,通常仍然以终端或聊天窗口里的文字结束。你可以不断提问,却也必须不断看屏幕。要把答案读出来,往往还得增加一个应用、一个 API 或一个步骤。
Ollama 在 2026 年 10 月 24 日的公告,将语音生成带进了这个本地流程。首个受支持的语音模型系列,是 Gradium 开发的 Phonon。文字可以通过命令行或兼容 OpenAI 的语音端点变成音频,语言模型的答案也可以直接传给语音模型。官方公告。
对尚未使用过它的读者来说,Ollama 是一个在自己电脑上下载、运行模型,并通过本地 API 提供模型能力的工具。这次更新的重要之处,是让语音成为这个环境中的另一种模型能力。本地 AI 因而可以开口回答,但有一些重要限制:此次宣布的语音支持目前面向 macOS,Phonon 系列内部的模型许可证也有所不同。
 Ollama 官方标志,来自 Ollama 仓库,采用 MIT 许可证。已按比例在白色背景上栅格化。这是产品标识图片,并非截图或生成的语音。

有用的声音,从一个适度的承诺开始
眼前的能力是文本转语音。你提供文字,获得合成音频。它可以让生成的回答更方便收听,把文档变成供自己听读的草稿,或让开发者不必先使用托管语音服务,就能制作语音界面原型。
但它本身并不构成完整的语音助手。监听麦克风、判断对方何时说完、识别语音、打断播放,以及决定允许哪些操作,都是应用的其他部分。流利的声音,可能让尚未完成的系统显得比实际更完整。
决定首先构建什么时,区分这一点很有用。朗读一段已经批准的文字,是范围明确的任务。一个听取请求、搜索私人材料、选择工具并播报结果的系统,承担的责任要多得多。Phonon 可以提供其中的输出声音,却不能证明前面步骤的准确性或权限正当性。
因此,最适合起步的用途,都有一个可理解的文字边界。你可以先检查将要朗读的内容,判断措辞是否合适,再生成音频。这种简单安排,更容易看清声音是否改善了实际任务。
这次发布有平台和语言边界
发布说明要求使用搭载 Apple Silicon、安装 Ollama 0.40.11 或更高版本的 Mac,Windows 与 Linux 支持将稍后到来。在其他操作系统上使用 Ollama 的读者,不应假设现有安装已经支持此次宣布的语音流程。能够在网页上看到模型库,与运行时功能已在所有平台可用,是两回事。
Phonon 模型库条目也区分了模型选项。基础 Phonon 模型面向英语。40M 系列包括英语、法语、德语、西班牙语和葡萄牙语的单语言变体,以及覆盖这五种语言的多语言变体。
这份列表并不意味着通用的多语言语音能力。韩语不在列出的五种语言中,因此此次发布不能证明已经提供韩语语音选项。
英语听读流程与多语言产品,需要不同的评估。前者可能只需要一个能清晰朗读你自己英文笔记的声音;后者则必须检查具体模型所支持的语言、人名、发音,以及句子切换语言时的行为。单靠语言标签,并不能证明这些场景都表现良好。
模型更小,使用权限却不同
按模型大小浏览时,很容易忽略这个系列在许可上的区别。基础 Phonon 模型标注为 Apache 2.0;40M 变体则标注为 CC BY-NC 4.0,其中包含非商业用途限制。模型与许可信息。
这意味着,最小的下载体积,并不自动等于商业产品最简单的选择。紧凑模型可能适合在配置不高的机器上实验,但该模型附带的权限,未必适合付费服务或客户的生产应用。
| 需要考察的选择 | 有何变化 | 采用前需要检查什么 |
|---|---|---|
| 基础 Phonon | 标注 Apache 2.0 的英语语音选项 | 实际下载的具体模型、声明,以及额外语音资源 |
| 单语言 40M 变体 | 面向某种已列出语言的紧凑模型 | 非商业限制,以及对你的材料的发音表现 |
| 40M 多语言变体 | 覆盖上述五种语言的紧凑选项 | 相同的许可限制,以及语言切换和混合语言表现 |
这是实际的产品选择,并不是说某种许可证会让模型更擅长语音。应分别比较质量、运行成本与获准用途。记录测试的确切变体,而不是在部署笔记里只写“Phonon”。
命令行让新路径一目了然
在受支持的 macOS 安装中,官方公告展示了一条直接命令:
ollama run phonon "Hello from Ollama."
它还演示了把文本模型的输出传入语音模型:
ollama run gemma4 --hidethinking "Tell me a fun fact about owls in two sentences." | ollama run phonon
这些是公告流程中的示例,不是我们自己硬件测试的结果。有意思的是管道连接:一个模型生成文字,另一个生成声音。让答案简短,并把隐藏推理排除在朗读输入之外,可以让这次交接更容易理解。
公告也展示了如何把生成的语音保存为 WAV 文件:
ollama run phonon "Save this to a file." > speech.wav
先在受支持的环境中使用文档里的命令,检查输出文件,再围绕它构建批处理。音频文件的存在,并不能告诉你每句话是否都读出来了、开头有没有被截掉,或某个重要数字是否发音正确。
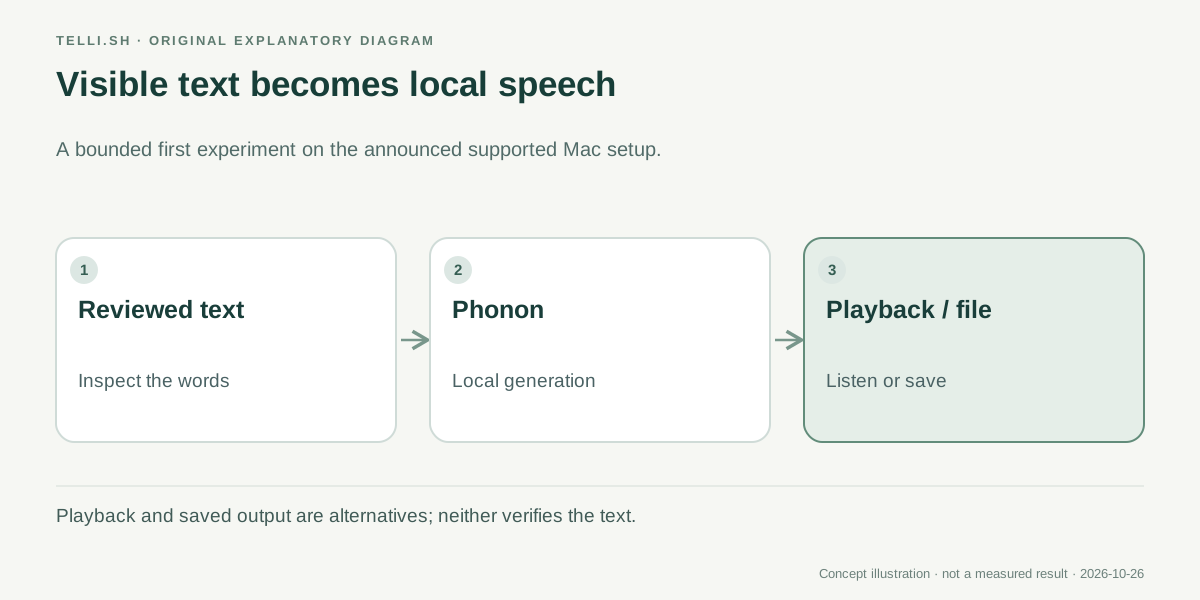 第一个有用的边界,是可见的文字。语音改变答案的交付方式,却不会独立验证答案。
示例一:发送文档之前,先听一遍
设想一名顾问正在审查英文项目更新。文档密集地解释了哪些内容有变化、哪些仍不确定,以及客户需要批准什么。它在屏幕上读起来还可以,但听读可能暴露一句过长的话,或一处难以跟上的衔接。
本地语音模型可以把这些已认可的文字变成听读草稿。顾问一边听真实措辞,一边修改原始文档。语音模型无需另行编造摘要,也不需要决定哪些陈述更重要。
好处很具体:多了一种审查文字的方法。它也可能帮助更喜欢听读的人,或希望在视觉与音频工作之间切换的人。但这并不能证明模型提供了完整的无障碍解决方案,生成的声音也不应替代针对特定受众需求所必需的检查。
这个例子也让隐私边界更容易理解。如果语音生成确实留在本地进程中,这一步就不必把文档发送给托管语音提供商。但完整流程仍然可能包含云编辑器、远程语言模型、遥测或共享存储文件夹。“本地语音”描述的是一个处理边界,而不是周围所有应用。
示例二:为带可见文字记录的语音回答制作原型
设想开发者在制作一个小型语言学习或信息查询终端原型。应用生成简短答案,显示文字,并提供一个点击后可以朗读的按钮。用户可以比较所见与所听,开发者也能检查失败,而不用猜测究竟什么文字进入了语音模型。
Ollama 通过本地运行时提供、兼容 OpenAI 的 /v1/audio/speech 端点,在这里很有价值。官方公告将它描述为把语音生成集成到应用中的方式。对于已经围绕语音 API 组织的软件,兼容性可以减少集成工作,但并不能证明远程提供商的每个选项,都有完全相同的本地实现。
先从文档说明的模型、声音和响应行为开始。如果应用依赖特定流式格式、取消行为或音频编码,就要测试那一项确切契约。一次单行请求成功,并不能证明长时间交互会表现正确。
对于语言学习示例,先从一种受支持语言和少量已审查句子开始。单独测试人名与陌生词。如果用户可以输入任意文字,还需要决定如何处理不受支持的文字系统、异常长的输入,以及绝不应在共享空间里朗读的内容。
如何让首次试用提供有效信息
能够回答可据以行动的问题,实验才最有用。“能发出声音吗?”适合检查安装,却不是有力的采用标准。写作工具需要清楚易懂的段落;交互原型还需要可接受的等待时间,以及可靠的停止行为。
- 确认平台与运行时。 查阅当前 Ollama 语音文档。发布说明要求 Apple Silicon Mac 和 Ollama 0.40.11 或更高版本。对宣布未来支持的平台,应按未来可用性看待。
- 选择具体模型并检查许可证。 在比较下载大小或速度之前,记录标签、语言和预期用途。
- 准备有代表性的文字。 包括短句、段落、数字、人名,以及实际流程中难以处理的案例。保留每项输入的副本。
- 完整收听输出。 检查遗漏、发音、不自然的停顿、重复词,以及结尾是否完整。保存文件与即时播放都要测试。
- 衡量自己电脑上的体验。 记录机器、模型、输入长度,以及产生可用音频所需的时间。用相同材料比较不同选项。
- 将审查与播放分开。 在应用朗读敏感或后果重大的措辞、或分发音频文件之前,让人先检查内容。
这一过程不需要大型基准测试。它为小团队提供了一种可重复的方法,判断本地语音是否足以完成范围明确的任务,以及下一步值得调查哪个限制。
速度主张需要附带测试条件
Ollama 的公告包含性能与语音质量比较。这些是厂商在所述模型、硬件和评估条件下报告的结果。它们是值得进一步调查的线索,却不是承诺另一台电脑、另一种声音和语言也有同样的延迟。
应把吞吐量与首次可听输出时间分开。模型可能总体上很快生成一大段内容,却仍让短交互在开始时显得缓慢。有声书批量草稿与对话回复,对这两项指标的关注点不同。
质量指标也需要上下文。对生成语音进行词语识别,可以帮助发现清晰度问题,但较低的错误率,并不等于对节奏、表现力,或某个名字是否符合受众习惯的完整判断。对于产品实际会朗读的材料,人来听仍然有用。
我们没有为本文进行独立的跨机器比较。因此,合理期待是多了一个值得评估的本地选项,而不是宣布它胜过所有托管或本地语音系统。
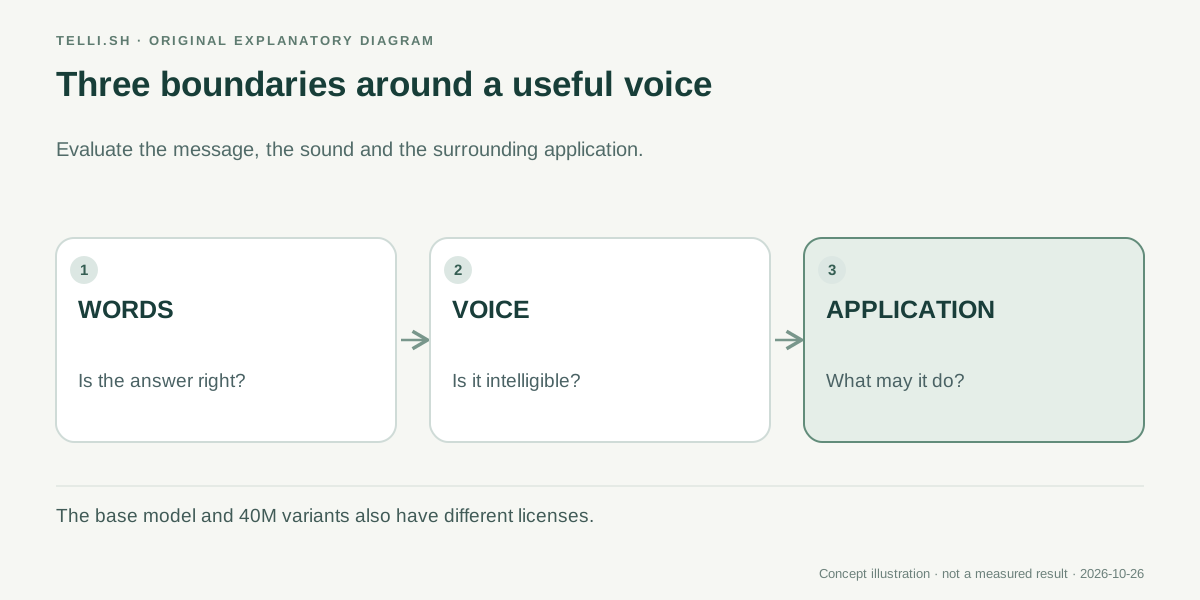 分别检查文字、声音和应用。清晰的声音,既能清楚地说出正确答案,也能同样清楚地说出错误答案。
本地语音接下来可能改变什么
这次更新最有希望的部分,是这种连接可以变得多么平常。本地模型写一段简短解释,另一个模型读出来,而应用保留可见的文字记录。语音开始像一种可组合的输出能力,而不是复制文字之后另行前往的目标。
这可能让本地写作审查、私人听读草稿和小型语音界面更容易探索,也可能鼓励应用协同使用多个专用模型:一个理解输入,一个作范围明确的决策,另一个朗读经过审查的结果。
接下来的测试很具体。更广泛的操作系统支持,会扩大能够尝试流程的人群;更多语言,会改变它能够服务的受众;更好的取消、声音处理和集成,会影响交互应用有多自然。它们是不同的改进,都应在真正可用时分别评判。
目前,Ollama 对 Phonon 的支持提供了有用的第一步:让本地 AI 朗读一小段可检查的文字,再判断听读是否让这项任务变得更好。模型许可证和平台限制,也应像声音一样清晰可见。
来源
- Ollama:语音模型,2026 年 10 月 24 日。
- Ollama:Phonon 模型库与许可证,于 2026 年 10 月 26 日查阅。
想为一次实验的文字、听读笔记和模型选择保留可搜索的记录吗?把材料带入 Telli.sh,整理成日后可以回看的笔记。