Sua IA local agora pode falar: o que a atualização Phonon do Ollama realmente abre
O Ollama adiciona geração local de voz com os modelos Phonon da Gradium. Fluxos úteis de escuta, a limitação atual ao macOS e por que a licença do menor modelo importa.
A resposta de um modelo de linguagem local ainda costuma terminar como texto em um terminal ou janela de chat. Você pode continuar perguntando, mas precisa continuar olhando para a tela. Ler a resposta em voz alta acrescenta outra aplicação, outra API ou outra etapa.
O anúncio do Ollama de 24 de outubro de 2026 traz a geração de voz para esse fluxo local. Sua primeira família de voz compatível é o Phonon, desenvolvido pela Gradium. Texto pode virar áudio pela linha de comando ou por um endpoint de voz compatível com OpenAI, e a resposta de um modelo de linguagem pode ser enviada diretamente ao modelo de voz. Anúncio oficial.
Para quem ainda não o usou, o Ollama é uma ferramenta para baixar e executar modelos no próprio computador e disponibilizá-los por uma API local. A atualização importa porque a voz se torna mais uma capacidade de modelo nesse ambiente. Ela dá à IA local uma forma de responder falando, com limites importantes: o suporte anunciado é atualmente para macOS, e as licenças variam dentro da família Phonon.
 Marca oficial do Ollama, do repositório Ollama, sob licença MIT. Rasterizada proporcionalmente sobre branco. É uma imagem de identificação do produto, não uma captura de tela ou fala gerada.

Uma voz útil começa com uma promessa modesta
A capacidade imediata é texto para fala. Você fornece palavras e recebe áudio sintetizado. Isso pode facilitar ouvir uma resposta gerada, transformar um documento em um rascunho privado para escuta ou permitir prototipar uma interface falada sem começar por um serviço de voz hospedado.
Isso não cria, por si só, um assistente de voz completo. Ouvir um microfone, decidir quando alguém terminou de falar, reconhecer a fala, interromper a reprodução e decidir quais ações são permitidas são partes separadas de uma aplicação. Uma voz fluente pode fazer um sistema inacabado parecer mais completo do que realmente é.
Essa distinção ajuda a escolher o que construir primeiro. Ler um parágrafo aprovado é uma tarefa delimitada. Um sistema que ouve uma solicitação, pesquisa material privado, escolhe uma ferramenta e fala o resultado tem responsabilidades muito maiores. O Phonon pode fornecer a voz de saída; ele não estabelece a precisão ou a autoridade das etapas anteriores.
Os primeiros casos mais fortes têm, portanto, uma fronteira de texto compreensível. É possível inspecionar o que será falado, decidir se a redação é adequada e só então gerar áudio. Esse arranjo simples facilita descobrir se a voz melhora uma tarefa real.
O lançamento tem limites de plataforma e idioma
As instruções de lançamento pedem um Mac com Apple Silicon e Ollama 0.40.11 ou posterior, com suporte a Windows e Linux previsto para depois. Quem usa o Ollama em outro sistema não deve supor que a instalação existente já executa o fluxo de voz anunciado. A biblioteca de modelos estar visível na web é diferente de o recurso funcionar em todas as plataformas.
A entrada do Phonon na biblioteca também distingue as escolhas de modelo. O Phonon básico é apresentado para inglês. A família 40M inclui variantes específicas para inglês, francês, alemão, espanhol e português, além de uma variante multilíngue que cobre esses cinco idiomas.
Essa lista não promete voz multilíngue universal. O coreano não está entre os cinco idiomas listados, portanto o lançamento não estabelece uma opção de fala em coreano.
Um fluxo de escuta em inglês e um produto multilíngue precisam de avaliações diferentes. O primeiro talvez exija apenas uma voz que leia suas notas em inglês com clareza. O segundo precisa verificar idiomas, nomes, pronúncia e comportamento do modelo exato quando uma frase troca de língua. Um rótulo de idioma, sozinho, não prova que todos esses casos funcionam bem.
Modelo pequeno, permissão diferente
A família tem uma distinção de licença fácil de ignorar ao escolher pelo tamanho. O modelo Phonon básico está listado sob Apache 2.0. As variantes 40M estão sob CC BY-NC 4.0, que inclui uma restrição a uso não comercial. Informações dos modelos e licenças.
Isso significa que o menor download não é automaticamente a escolha mais simples para um produto comercial. Um modelo compacto pode ser atraente para experimentos em uma máquina modesta, enquanto as permissões daquele modelo específico talvez não sirvam a um serviço pago ou à aplicação de produção de um cliente.
| Escolha a examinar | O que muda | O que verificar antes de adotar |
|---|---|---|
| Phonon básico | Opção de voz em inglês listada sob Apache 2.0 | Modelo exato baixado, avisos e recursos adicionais de voz |
| Variante 40M de um idioma | Modelo compacto para um dos idiomas listados | Restrições não comerciais e pronúncia do seu material |
| Variante 40M multilíngue | Uma opção compacta para os cinco idiomas listados | A mesma restrição de licença, além de alternância e mistura de idiomas |
Essa é uma decisão prática de produto, não um argumento de que uma licença melhora a voz de um modelo. Compare qualidade, custo de execução e uso permitido separadamente. Registre a variante exata testada em vez de escrever apenas “Phonon” em uma nota de implantação.
A linha de comando torna o novo caminho fácil de enxergar
Em uma instalação compatível de macOS, o anúncio oficial mostra uma instrução direta:
ollama run phonon "Hello from Ollama."
Ele também demonstra como passar a saída de um modelo de texto para a voz:
ollama run gemma4 --hidethinking "Tell me a fun fact about owls in two sentences." | ollama run phonon
São exemplos do fluxo anunciado, não resultados de um teste no nosso hardware. O pipe é a parte interessante: um modelo produz as palavras, outro produz a voz. Manter a resposta curta e excluir o raciocínio oculto da entrada falada facilita entender a passagem.
O anúncio também mostra como salvar a fala gerada como arquivo WAV:
ollama run phonon "Save this to a file." > speech.wav
Use a instrução documentada no ambiente compatível e confira o arquivo antes de construir um processamento em lote ao redor dela. A existência de um arquivo de áudio não diz se todas as frases foram faladas, se o início foi cortado ou se um número importante foi pronunciado corretamente.
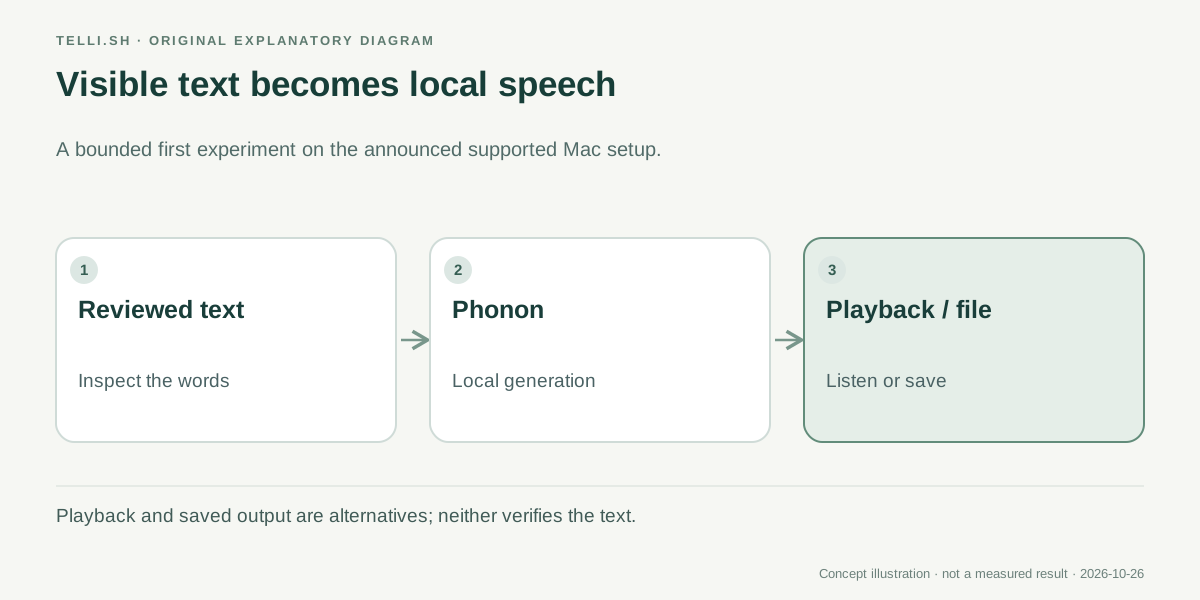 A primeira fronteira útil é o texto visível. A voz muda a forma de entregar a resposta; não verifica a resposta de maneira independente.
Primeiro exemplo: ouvir um documento antes de enviá-lo
Imagine um consultor revisando uma atualização de projeto em inglês. O documento traz uma explicação densa sobre o que mudou, o que permanece incerto e o que o cliente precisa aprovar. Ele parece aceitável na tela, mas ouvi-lo pode revelar uma frase longa demais ou uma transição difícil de acompanhar.
Um modelo local de voz pode transformar o texto aprovado em um rascunho para escuta. O consultor ouve a redação real enquanto edita o documento original. Não é necessário que o modelo de voz invente um resumo ou decida quais afirmações importam.
O benefício é específico: outra maneira de revisar um texto. Também pode ajudar quem prefere ouvir ou quer alternar entre trabalho visual e de áudio. Isso não comprova que o modelo seja uma solução completa de acessibilidade, e uma voz gerada não deve substituir as verificações exigidas pelas necessidades específicas do público.
O exemplo também facilita raciocinar sobre privacidade. Se a geração realmente fica no processo local, essa etapa não precisa enviar o documento a um provedor de voz hospedado. O fluxo completo ainda pode incluir um editor na nuvem, um modelo remoto, telemetria ou uma pasta compartilhada. “Voz local” descreve uma fronteira de processamento, não todas as aplicações ao redor.
Segundo exemplo: prototipar uma resposta falada com transcrição visível
Considere um desenvolvedor criando um pequeno protótipo de aprendizado de idiomas ou de um quiosque de informações. A aplicação gera uma resposta curta, exibe as palavras e oferece um botão para ouvi-las. Os usuários podem comparar o que veem com o que ouvem, e o desenvolvedor pode inspecionar falhas sem adivinhar qual texto chegou ao modelo de voz.
O endpoint /v1/audio/speech do Ollama, compatível com OpenAI e servido pelo ambiente local, é relevante aqui. O anúncio o descreve como uma forma de integrar a geração de voz às aplicações. A compatibilidade pode reduzir a integração de um software já organizado em torno de uma API de voz, mas não prova que toda opção de um provedor remoto tenha uma implementação local idêntica.
Comece pelo modelo, pela voz e pelo comportamento de resposta documentados. Se a aplicação espera um formato específico de streaming, cancelamento ou codificação de áudio, teste esse contrato exato. Uma requisição de uma linha bem-sucedida não estabelece que uma longa sessão interativa funcionará corretamente.
No exemplo de idiomas, comece por uma língua compatível e um conjunto pequeno de frases revisadas. Teste nomes e palavras desconhecidas separadamente. Se o usuário puder digitar qualquer texto, decida também como tratar sistemas de escrita não suportados, entradas longas demais e conteúdo que nunca deveria ser falado em um espaço compartilhado.
Como tornar o primeiro teste informativo
Um experimento é mais útil quando responde a uma pergunta que orienta uma ação. “Ele consegue produzir som?” é uma boa verificação de instalação, mas um critério fraco de adoção. Uma ferramenta de escrita precisa de parágrafos inteligíveis; um protótipo interativo também precisa de espera aceitável e interrupção confiável.
- Confirme a plataforma e o ambiente. Consulte a documentação atual de voz do Ollama. As instruções de lançamento especificam Mac com Apple Silicon e Ollama 0.40.11 ou posterior. Trate plataformas anunciadas para depois como disponibilidade futura.
- Escolha o modelo exato e inspecione a licença. Registre o tag, o idioma e o uso pretendido antes de comparar tamanho de download ou velocidade.
- Prepare texto representativo. Inclua uma frase curta, um parágrafo, números, nomes e um caso difícil do seu fluxo real. Guarde cada entrada.
- Ouça toda a saída. Verifique omissões, pronúncia, pausas artificiais, repetições e presença do final. Teste o arquivo salvo e a reprodução imediata.
- Meça a experiência no seu computador. Registre máquina, modelo, comprimento da entrada e tempo até o áudio útil. Compare o mesmo material entre opções.
- Separe revisão e reprodução. Deixe uma pessoa inspecionar textos sensíveis ou relevantes antes de a aplicação falá-los ou distribuir um arquivo de áudio.
O processo não exige um grande benchmark. Ele dá a uma equipe pequena uma forma repetível de decidir se a voz local atende a uma tarefa delimitada e qual limitação vale investigar depois.
Alegações de velocidade precisam das condições de teste
O anúncio do Ollama inclui comparações de desempenho e qualidade da fala. São resultados relatados pelo fornecedor nas condições declaradas de modelo, hardware e avaliação. São pistas úteis sobre o que investigar, não uma promessa de mesma latência em outro computador ou com outra voz e idioma.
Separe taxa de geração de tempo até o primeiro áudio audível. Um modelo pode gerar um trecho longo rapidamente no total e ainda fazer uma interação curta parecer lenta no início. Um rascunho de audiolivro em lote e uma resposta de conversa atribuem importâncias diferentes às duas medidas.
As medidas de qualidade também precisam de contexto. Reconhecer palavras na fala gerada ajuda a detectar problemas de inteligibilidade, mas uma baixa taxa de erro não avalia por completo ritmo, expressividade ou a adequação da pronúncia de um nome ao público. A escuta humana continua útil para o material que seu produto realmente falará.
Não executamos uma comparação independente entre máquinas para este artigo. A expectativa prática é, portanto, uma nova opção local para avaliar, e não um vencedor declarado sobre todos os sistemas de voz locais ou hospedados.
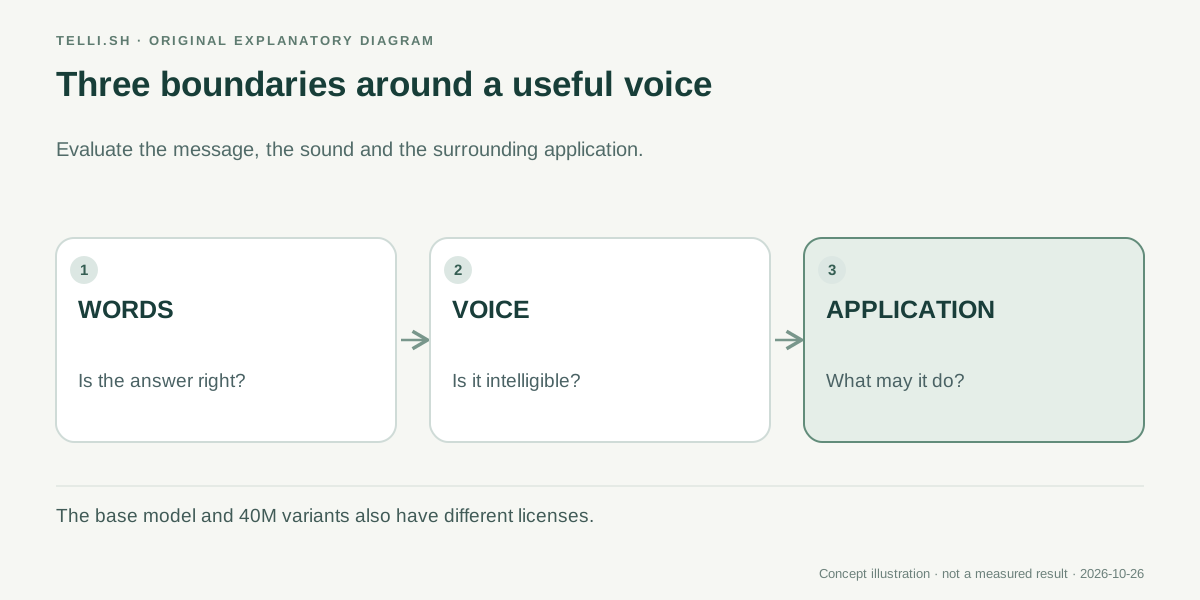 Verifique palavras, voz e aplicação separadamente. Uma voz clara pode entregar uma resposta errada com a mesma clareza de uma correta.
O que a voz local pode mudar depois
A parte promissora da atualização é como a conexão pode se tornar comum. Um modelo local escreve uma explicação curta, outro a lê e a aplicação mantém uma transcrição visível. A voz começa a parecer uma capacidade de saída que se combina com outras, e não um destino separado para copiar texto.
Isso pode facilitar explorar revisão local de escrita, rascunhos privados para escuta e pequenas interfaces faladas. Também pode incentivar aplicações que usem vários modelos especializados juntos: um para entender a entrada, outro para uma decisão delimitada e outro para falar o resultado revisado.
Os próximos testes são concretos. Mais sistemas operacionais ampliariam quem pode experimentar o fluxo. Maior cobertura de idiomas mudaria os públicos atendidos. Melhorias em cancelamento, gestão de vozes e integração tornariam a interação mais natural. Cada uma é um avanço diferente, que deve ser julgado quando estiver realmente disponível.
Por enquanto, o suporte do Ollama ao Phonon oferece um primeiro passo útil: deixar a IA local falar um texto curto e inspecionável e decidir se ouvir melhora aquela tarefa específica. Mantenha a licença e os limites de plataforma tão visíveis quanto a voz.
Fontes
- Ollama: Speech models, 24 de outubro de 2026.
- Ollama: biblioteca e licenças do modelo Phonon, consultada em 26 de outubro de 2026.
Quer manter um registro pesquisável dos textos, notas de escuta e escolhas de modelos de um experimento? Leve o material ao Telli.sh e crie uma nota à qual possa voltar.