Ihre lokale KI kann jetzt sprechen: Was Ollamas Phonon-Update tatsächlich ermöglicht
Ollama ergänzt lokale Spracherzeugung mit Gradiums Phonon-Modellen. Nützliche Abläufe zum Zuhören, die derzeitige macOS-Grenze und die wichtige Lizenzfrage beim kleinsten Modell.
Die Antwort eines lokalen Sprachmodells endet gewöhnlich noch als Text im Terminal oder Chatfenster. Sie können weitere Fragen stellen, müssen dafür aber weiterhin auf den Bildschirm sehen. Um die Antwort vorlesen zu lassen, braucht es eine weitere Anwendung, eine andere API oder einen zusätzlichen Arbeitsschritt.
Ollamas Ankündigung vom 24. Oktober 2026 bringt die Spracherzeugung in diesen lokalen Ablauf. Die erste unterstützte Sprachfamilie ist das von Gradium entwickelte Phonon. Text lässt sich über die Kommandozeile oder einen OpenAI-kompatiblen Sprachendpunkt in Audio umwandeln; die Antwort eines Sprachmodells kann direkt an das Sprachsynthesemodell weitergereicht werden. Offizielle Ankündigung.
Wer Ollama noch nicht verwendet hat: Das Werkzeug lädt Modelle auf den eigenen Rechner, führt sie dort aus und stellt sie über eine lokale API bereit. Das Update ist wichtig, weil die Sprachausgabe zu einer weiteren Modellfähigkeit dieser Umgebung wird. Lokale KI kann damit antworten, allerdings mit wichtigen Grenzen: Die angekündigte Sprachunterstützung gilt derzeit für macOS, und innerhalb der Phonon-Familie unterscheiden sich die Modelllizenzen.
 Offizielles Ollama-Zeichen aus dem Ollama-Repository, MIT-Lizenz. Proportional auf Weiß gerastert. Das Bild kennzeichnet das Produkt; es ist weder ein Screenshot noch erzeugte Sprache.

Eine hilfreiche Stimme beginnt mit einem überschaubaren Versprechen
Die unmittelbare Fähigkeit ist Text-to-Speech: Sie liefern Wörter und erhalten synthetisiertes Audio. So wird eine generierte Antwort leichter anhörbar, aus einem Dokument ein privater Hörentwurf oder aus einer Idee ein Prototyp für eine gesprochene Oberfläche, ohne zunächst einen gehosteten Sprachdienst einzusetzen.
Ein vollständiger Sprachassistent entsteht dadurch noch nicht. Ein Mikrofon abzuhören, das Ende einer Äußerung zu erkennen, Sprache zu transkribieren, die Wiedergabe zu unterbrechen und erlaubte Aktionen festzulegen sind getrennte Aufgaben der Anwendung. Eine flüssige Stimme kann ein unfertiges System vollständiger wirken lassen, als es ist.
Diese Unterscheidung hilft bei der Wahl des ersten Projekts. Einen freigegebenen Absatz vorzulesen ist eine begrenzte Aufgabe. Ein System, das eine Anfrage hört, private Unterlagen durchsucht, ein Werkzeug auswählt und das Ergebnis ausspricht, hat deutlich mehr Verantwortung. Phonon kann dort die Ausgabestimme liefern; es bestätigt nicht die Richtigkeit oder Befugnis der vorangehenden Schritte.
Die besten Einstiegsfälle haben deshalb eine nachvollziehbare Textgrenze. Sie können prüfen, was gesprochen werden soll, die Formulierung beurteilen und anschließend Audio erzeugen. Dieser einfache Aufbau macht erkennbar, ob die Stimme eine tatsächliche Aufgabe verbessert.
Zum Start gibt es Grenzen bei Plattform und Sprachen
Die Startanleitung verlangt einen Apple-Silicon-Mac mit Ollama 0.40.11 oder neuer; Unterstützung für Windows und Linux soll später folgen. Wer Ollama auf einem anderen Betriebssystem nutzt, sollte nicht annehmen, dass die bestehende Installation den angekündigten Sprachablauf bereits unterstützt. Eine im Web sichtbare Modellbibliothek ist etwas anderes als die Verfügbarkeit einer Laufzeitfunktion auf jeder Plattform.
Der Phonon-Bibliothekseintrag unterscheidet auch die Modellauswahl. Das Basismodell Phonon wird für Englisch angeboten. Zur 40M-Familie gehören sprachspezifische Varianten für Englisch, Französisch, Deutsch, Spanisch und Portugiesisch sowie eine mehrsprachige Variante für diese fünf Sprachen.
Diese Liste verspricht keine universelle Mehrsprachigkeit. Koreanisch gehört nicht zu den fünf genannten Sprachen; diese Einführung belegt deshalb keine koreanische Sprachausgabe.
Ein englischer Hörablauf und ein mehrsprachiges Produkt brauchen unterschiedliche Bewertungen. Für den ersten reicht vielleicht eine Stimme, die eigene englische Notizen verständlich liest. Beim zweiten müssen unterstützte Sprachen des konkreten Modells, Namen, Aussprache und das Verhalten bei Sprachwechseln im Satz geprüft werden. Eine Sprachbezeichnung allein beweist nicht, dass all das gut funktioniert.
Ein kleines Modell kann andere Nutzungsrechte haben
Innerhalb der Modellfamilie gibt es einen bei der Auswahl nach Größe leicht übersehbaren Lizenzunterschied. Das Basismodell Phonon ist unter Apache 2.0 aufgeführt. Die 40M-Varianten sind unter CC BY-NC 4.0 aufgeführt; diese Lizenz beschränkt die Nutzung auf nichtkommerzielle Zwecke. Modell- und Lizenzinformationen.
Der kleinste Download ist deshalb nicht automatisch die einfachste Wahl für ein kommerzielles Produkt. Ein kompaktes Modell kann für Versuche auf einem bescheiden ausgestatteten Rechner attraktiv sein, während seine Nutzungsrechte nicht zu einem kostenpflichtigen Dienst oder einer produktiven Kundenanwendung passen.
| Zu prüfende Wahl | Was sich ändert | Was vor der Einführung geprüft werden sollte |
|---|---|---|
| Phonon-Basismodell | Englische Sprachausgabe mit Apache-2.0-Angabe | Genaues heruntergeladenes Modell, Hinweise und zusätzliche Stimmdateien |
| Sprachspezifische 40M-Variante | Kompaktes Modell für eine aufgeführte Sprache | Nichtkommerzielle Einschränkungen und Aussprache des eigenen Materials |
| Mehrsprachige 40M-Variante | Eine kompakte Option für die fünf genannten Sprachen | Dieselbe Lizenzgrenze sowie Sprachwechsel und gemischte Texte |
Das ist eine praktische Produktentscheidung, kein Argument dafür, dass eine Lizenz ein Modell besser sprechen lässt. Vergleichen Sie Qualität, Laufzeitkosten und erlaubte Nutzung getrennt. Dokumentieren Sie die konkret getestete Variante, statt in einer Bereitstellungsnotiz nur „Phonon“ zu schreiben.
Die Kommandozeile zeigt den neuen Weg direkt
Für eine unterstützte macOS-Installation zeigt die offizielle Ankündigung einen direkten Befehl:
ollama run phonon "Hello from Ollama."
Sie demonstriert auch, wie die Ausgabe eines Textmodells an die Sprachsynthese weitergereicht wird:
ollama run gemma4 --hidethinking "Tell me a fun fact about owls in two sentences." | ollama run phonon
Das sind Beispiele des angekündigten Ablaufs, keine Ergebnisse unseres eigenen Hardwaretests. Interessant ist die Pipe: Ein Modell erzeugt die Wörter, ein anderes die Stimme. Eine kurze Antwort ohne verborgene Überlegungen in der gesprochenen Eingabe macht die Übergabe verständlicher.
Die Ankündigung zeigt außerdem, wie sich erzeugte Sprache als WAV-Datei speichern lässt:
ollama run phonon "Save this to a file." > speech.wav
Verwenden Sie den dokumentierten Befehl in der unterstützten Umgebung und prüfen Sie die Datei, bevor Sie einen Stapelprozess darauf aufbauen. Eine vorhandene Audiodatei beweist nicht, dass jeder Satz gesprochen wurde, der Anfang vollständig ist oder eine wichtige Zahl richtig ausgesprochen wird.
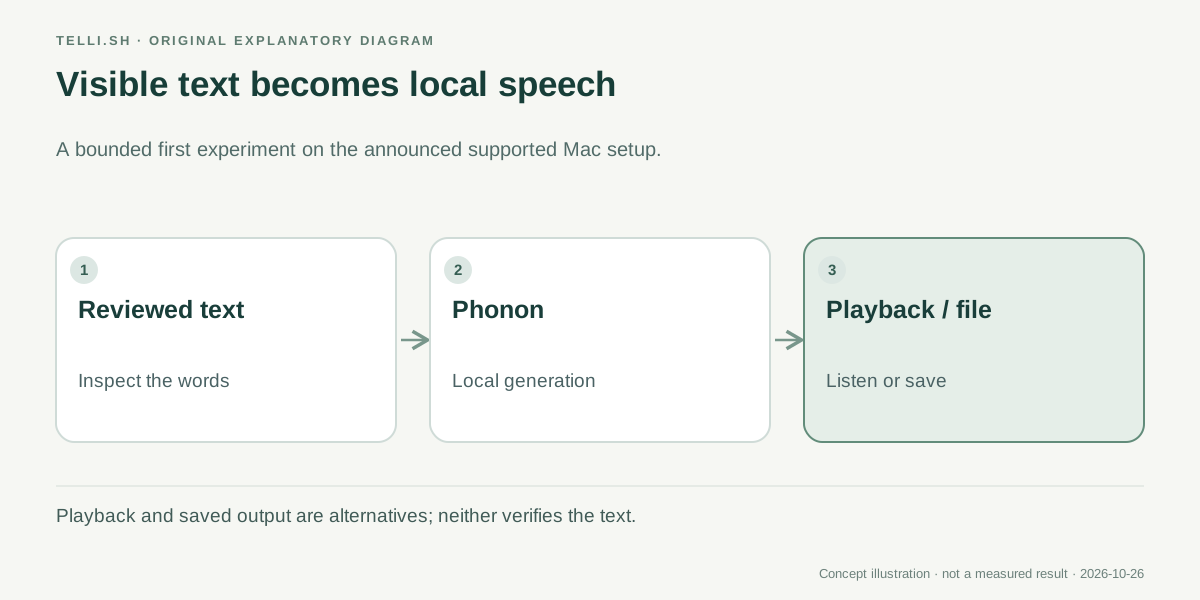 Die erste nützliche Grenze ist sichtbarer Text. Sprache verändert die Auslieferung der Antwort, bestätigt aber nicht unabhängig deren Richtigkeit.
Erstes Beispiel: Ein Dokument vor dem Versand anhören
Stellen wir uns einen Berater vor, der ein englisches Projektupdate prüft. Das Dokument erklärt dicht, was sich geändert hat, was unklar bleibt und was der Kunde freigeben muss. Auf dem Bildschirm liest es sich ordentlich, beim Anhören fällt aber vielleicht ein zu langer Satz oder ein schwer verständlicher Übergang auf.
Ein lokales Sprachsynthesemodell kann den freigegebenen Text in einen Hörentwurf verwandeln. Der Berater hört den tatsächlichen Wortlaut und bearbeitet dabei das Originaldokument. Das Sprachmodell muss weder eine Zusammenfassung erfinden noch entscheiden, welche Aussagen wichtig sind.
Der Nutzen ist konkret: eine zusätzliche Möglichkeit, einen Text zu prüfen. Das kann auch Menschen helfen, die lieber zuhören oder zwischen visueller und akustischer Arbeit wechseln möchten. Es belegt keine vollständige Lösung für Barrierefreiheit; eine generierte Stimme sollte Prüfungen für besondere Bedürfnisse der Zielgruppe nicht ersetzen.
Dieses Beispiel macht auch Datenschutzfragen überschaubarer. Bleibt die Spracherzeugung tatsächlich im lokalen Prozess, muss dieser Schritt das Dokument nicht an einen gehosteten Sprachdienst senden. Der gesamte Ablauf kann trotzdem einen Cloudeditor, ein entferntes Sprachmodell, Telemetrie oder einen geteilten Speicherordner enthalten. „Lokale Sprache“ beschreibt eine Verarbeitungsgrenze, nicht jede umgebende Anwendung.
Zweites Beispiel: Eine gesprochene Antwort mit sichtbarem Text erproben
Ein Entwickler baut etwa einen kleinen Prototyp zum Sprachenlernen oder für einen Informationskiosk. Die Anwendung erzeugt eine kurze Antwort, zeigt den Wortlaut und bietet eine Schaltfläche zum Anhören. Nutzer können Gesehenes und Gehörtes vergleichen; der Entwickler untersucht Fehler, ohne raten zu müssen, welcher Text in das Sprachmodell gelangte.
Relevant ist hier Ollamas OpenAI-kompatibler Endpunkt /v1/audio/speech, der über die lokale Laufzeit bereitgestellt wird. Die offizielle Ankündigung beschreibt ihn als Integrationsweg für Spracherzeugung in Anwendungen. Die Kompatibilität kann bei Software mit vorhandener Sprach-API den Integrationsaufwand senken. Sie beweist aber nicht, dass jede Option eines entfernten Anbieters lokal identisch umgesetzt ist.
Beginnen Sie mit dem dokumentierten Modell, der Stimme und dem Antwortverhalten. Erwartet Ihre Anwendung ein bestimmtes Streamingformat, Abbruchverhalten oder eine Audiocodierung, prüfen Sie genau diesen Vertrag. Eine erfolgreiche einzeilige Anfrage belegt kein korrektes Verhalten in einer langen interaktiven Sitzung.
Starten Sie beim Sprachenlernen mit einer unterstützten Sprache und wenigen geprüften Sätzen. Testen Sie Namen und unbekannte Wörter separat. Können Nutzer beliebigen Text eingeben, legen Sie auch den Umgang mit nicht unterstützten Schriften, ungewöhnlich langen Eingaben und Material fest, das in gemeinsam genutzten Räumen nicht ausgesprochen werden sollte.
So liefert der erste Versuch verwertbare Erkenntnisse
Ein Versuch ist am hilfreichsten, wenn er eine handlungsrelevante Frage beantwortet. „Kann es einen Ton erzeugen?“ ist ein guter Installationstest, aber ein schwaches Einführungskriterium. Ein Schreibwerkzeug braucht verständliche Absätze; ein interaktiver Prototyp zusätzlich akzeptable Wartezeiten und zuverlässiges Stoppen.
- Plattform und Laufzeit bestätigen. Prüfen Sie Ollamas aktuelle Sprachdokumentation. Die Startanleitung nennt einen Apple-Silicon-Mac und Ollama 0.40.11 oder neuer. Angekündigte spätere Plattformen sind noch keine aktuelle Verfügbarkeit.
- Konkretes Modell wählen und die Lizenz prüfen. Halten Sie Tag, Sprache und Verwendungszweck fest, bevor Sie Downloadgröße oder Tempo vergleichen.
- Repräsentativen Text vorbereiten. Nehmen Sie einen kurzen Satz, einen Absatz, Zahlen, Namen und einen für Ihren Ablauf schwierigen Fall auf. Bewahren Sie jede Eingabe auf.
- Die vollständige Ausgabe anhören. Prüfen Sie Auslassungen, Aussprache, unnatürliche Pausen, Wiederholungen und das Ende. Testen Sie sowohl die gespeicherte Datei als auch die direkte Wiedergabe.
- Auf dem eigenen Rechner messen. Dokumentieren Sie Rechner, Modell, Eingabelänge und die Zeit bis zu brauchbarem Audio. Vergleichen Sie dasselbe Material mit verschiedenen Optionen.
- Prüfung und Wiedergabe trennen. Lassen Sie sensible oder folgenreiche Formulierungen von einem Menschen prüfen, bevor eine Anwendung sie spricht oder als Audiodatei verteilt.
Dieser Prozess braucht keinen großen Benchmark. Er gibt einem kleinen Team eine wiederholbare Methode, um die Eignung lokaler Sprache für eine eng definierte Aufgabe zu beurteilen und die nächste untersuchenswerte Grenze zu finden.
Geschwindigkeitsangaben brauchen ihre Testbedingungen
Ollamas Ankündigung enthält Vergleiche zur Leistung und Sprachqualität. Es handelt sich um vom Anbieter gemeldete Ergebnisse unter den angegebenen Modell-, Hardware- und Bewertungsbedingungen. Sie geben Hinweise für eigene Untersuchungen, versprechen aber nicht dieselbe Latenz auf einem anderen Rechner oder mit einer anderen Stimme und Sprache.
Trennen Sie Durchsatz von der Zeit bis zur ersten hörbaren Ausgabe. Ein Modell kann einen langen Abschnitt insgesamt schnell erzeugen, während eine kurze Interaktion am Anfang trotzdem langsam wirkt. Ein stapelweise erzeugter Hörbuchentwurf und eine Gesprächsantwort gewichten diese beiden Messwerte unterschiedlich.
Auch Qualitätsmessungen brauchen Kontext. Worterkennung anhand generierter Sprache kann Verständlichkeitsprobleme sichtbar machen. Eine niedrige Fehlerrate bewertet aber weder Sprechtempo noch Ausdruck oder die für das Publikum passende Aussprache eines Namens vollständig. Menschliches Zuhören bleibt für das tatsächlich gesprochene Produktmaterial hilfreich.
Für diesen Artikel haben wir keinen unabhängigen Vergleich zwischen mehreren Rechnern durchgeführt. Die praktische Erwartung ist deshalb eine neue lokal zu prüfende Option und kein erklärter Sieger über sämtliche gehosteten oder lokalen Sprachsysteme.
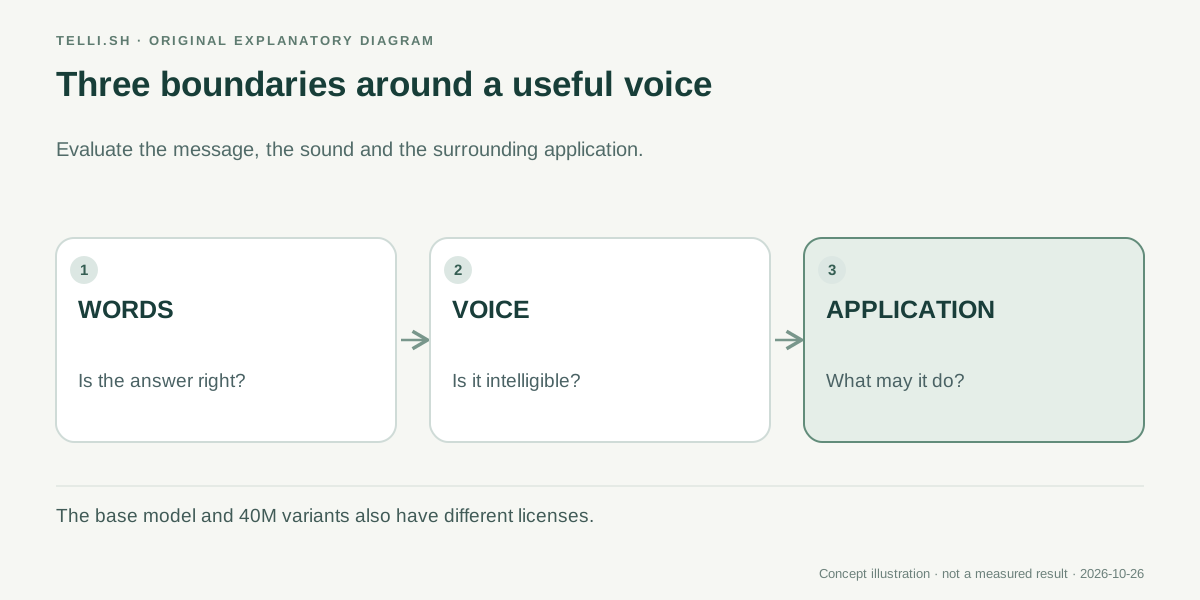 Prüfen Sie Wörter, Stimme und Anwendung getrennt. Eine klare Stimme kann eine falsche Antwort genauso verständlich ausgeben wie eine richtige.
Was lokale Sprachausgabe als Nächstes verändern könnte
Vielversprechend ist, wie selbstverständlich sich die Verbindung nutzen lassen könnte. Ein lokales Modell schreibt eine kurze Erklärung, ein anderes liest sie vor, und die Anwendung behält einen sichtbaren Text. Sprache wird zu einer kombinierbaren Ausgabefähigkeit statt zu einem separaten Ziel für kopierten Text.
Das könnte lokale Textprüfung, private Hörentwürfe und kleine gesprochene Oberflächen leichter erprobbar machen. Es könnte auch Anwendungen fördern, die mehrere spezialisierte Modelle verbinden: eines zum Verstehen der Eingabe, eines für eine begrenzte Entscheidung und eines zum Aussprechen des geprüften Ergebnisses.
Die nächsten Prüfsteine sind konkret. Mehr Betriebssysteme würden weiteren Menschen den Versuch ermöglichen. Mehr Sprachen würden neue Zielgruppen erschließen. Besseres Abbrechen, Stimmmanagement und bessere Integration würden das Gefühl interaktiver Anwendungen verändern. Das sind getrennte Verbesserungen, die bei tatsächlicher Verfügbarkeit zu beurteilen sind.
Ollamas Phonon-Unterstützung bietet vorerst einen hilfreichen ersten Schritt: Lassen Sie lokale KI einen kurzen, prüfbaren Text vorlesen und beurteilen Sie dann, ob Zuhören genau diese Aufgabe verbessert. Halten Sie Lizenz und Plattformgrenzen des Modells genauso sichtbar wie seine Stimme.
Quellen
- Ollama: Speech models, 24. Oktober 2026.
- Ollama: Phonon-Modellbibliothek und Lizenzen, geprüft am 26. Oktober 2026.
Möchten Sie Text, Hörnotizen und Modellentscheidungen eines Versuchs durchsuchbar festhalten? Sammeln Sie das Material in Telli.sh und erstellen Sie eine Notiz, zu der Sie zurückkehren können.