NVIDIA Speech Skills: ensine ao fluxo de ASR onde o jargão dá errado
Uma introdução às skills de adaptação de fala da NVIDIA: como um agente de programação pode investigar vocabulário especializado, preparar dados, treinar seletivamente e avaliar as melhorias.
A transcrição acerta a estrutura da frase e erra o nome importante. Um especialista reconhece imediatamente a expressão pretendida, mas o modelo de fala a substitui por uma palavra comum. Melhorar esse resultado começa com uma pergunta mais específica do que “qual modelo é o melhor?”.
O tutorial da NVIDIA de 13 de outubro de 2026 sobre Speech Agent Skills apresenta um fluxo para adaptar reconhecimento automático de fala, ou ASR, a um domínio. Uma skill de alto nível ajuda a definir o problema e coordenar o trabalho; uma especialista em NeMo cuida do treinamento e da avaliação compatíveis. O tutorial usa fala de controle de tráfego aéreo como exemplo completo. Tutorial da NVIDIA
Esta introdução explica o que as skills acrescentam, quando vale considerar treinamento e como planejar o primeiro experimento. Não é necessário começar com um treinamento grande. Um primeiro resultado útil pode ser uma descrição clara de quais palavras falham, por que importam e qual intervenção merece um teste.
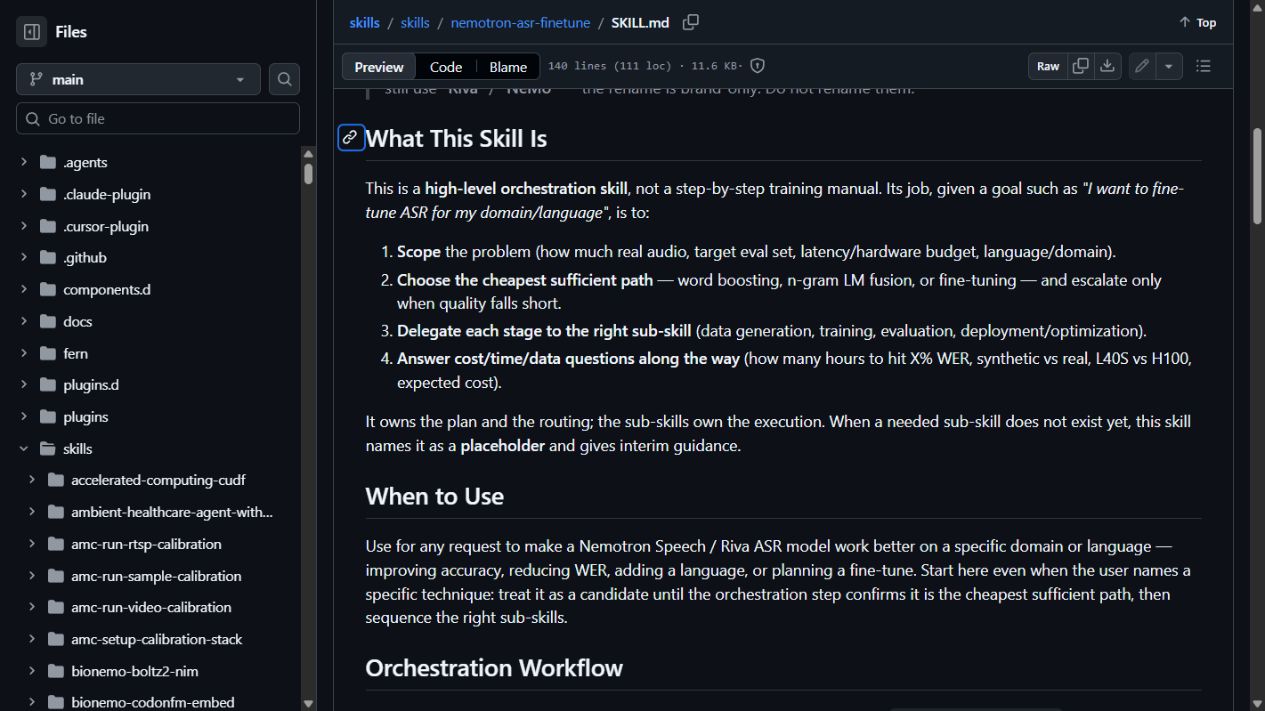 Documentação pública da skill, capturada em 20 de outubro de 2026. Documentação © NVIDIA, com atribuição sob CC BY 4.0. A tela mostra instruções, não uma execução de treinamento.
Uma skill organiza o trabalho em torno do modelo
Um modelo contém parâmetros aprendidos. Um framework de treinamento fornece os mecanismos para atualizá-los. Uma skill de agente fornece instruções que ajudam um assistente de programação a escolher e executar um fluxo. Instalar essas instruções não instala todos os frameworks, baixa todos os checkpoints nem comprova que uma GPU consegue executar o experimento.
No tutorial, a NVIDIA separa a skill de orquestração nemotron-asr-finetune da especialista nemo-speech-asr-finetune. A primeira enquadra o objetivo e encaminha o trabalho. A segunda executa as etapas específicas do NeMo quando treinamento ou avaliação offline são adequados. Descrição do fluxo
A divisão ajuda porque “melhorar o reconhecimento” inclui tarefas distintas. Um problema de vocabulário pode exigir apoio na decodificação. Diferenças de estilo de fala ou condições de áudio podem justificar adaptação. Uma configuração errada de pré-processamento pode precisar de correção antes de qualquer uma dessas rotas fazer sentido.
Pense na skill como coordenadora do experimento. Ela ajuda a manter objetivo, entradas e comparação alinhados, mas uma pessoa ainda precisa definir sucesso. O artefato final deve ser uma evidência examinável, não apenas a declaração de um assistente de que o treinamento terminou.
Comece pelo erro que muda o significado
Suponha que uma empresa ensine funcionários a dizer alguns códigos de produto em inspeções. O reconhecedor transcreve bem a conversa comum, mas confunde repetidamente dois códigos parecidos. O primeiro conjunto útil reúne essas confusões, o áudio original e uma transcrição de referência conferida.
Um segundo caso é um arquivo de entrevistas com nomes e terminologia especializada. A dificuldade pode variar conforme falante, microfone e tema. Separe convenções de escrita de erros acústicos: duas formas escritas de uma mesma abreviação não devem ser automaticamente consideradas falhas distintas de reconhecimento.
Um terceiro caso envolve suporte a equipamentos gravado em um canal ruidoso. Acrescentar uma lista de vocabulário pode ajudar alguns termos sem resolver sílabas ausentes. A adaptação de domínio ganha utilidade quando distingue expectativas linguísticas do som efetivamente disponível ao modelo.
Essas são aplicações propostas do fluxo, não implantações relatadas. Mostram por que a entrada deve incluir exemplos, não apenas uma frase de objetivo. Uma dúzia de erros bem compreendidos pode revelar se o próximo passo é limpar dados, apoiar o vocabulário ou estudar uma adaptação mais ampla.
Use a intervenção menos exigente que resolva a falha
A skill pública de orquestração descreve uma progressão por reforço de palavras, apoio de modelo de linguagem e ajuste fino, escolhendo uma rota suficiente antes de escalar. É um princípio de planejamento, não uma garantia de que todo modelo ou runtime oferece controles idênticos. Documentação da skill
| Problema observado | Intervenção candidata | O que comparar |
|---|---|---|
| Um termo conhecido perde para uma palavra comum | Mecanismo compatível de vocabulário ou reforço de palavras | Precisão dos termos-alvo e inserções indesejadas |
| Padrões de frases do domínio parecem sempre improváveis | Apoio compatível de modelo de linguagem ou decodificação | Precisão no domínio junto à fala comum |
| O modelo tem dificuldade com a fala ou o canal do domínio | Adaptação do modelo acústico | Áudio reservado do domínio e um conjunto de fala geral |
| A precisão cai de repente após mudar uma configuração | Restaurar e validar a compatibilidade do pré-processamento | Mesmo checkpoint e áudio nas duas configurações |
A tabela ajuda a decidir, mas não é um diagnóstico. Acrescentar vocabulário pode criar erros quando palavras comuns semelhantes são frequentes. O ajuste fino pode melhorar uma tarefa especializada e prejudicar outro tipo de fala. Meça o efeito desejado e os efeitos colaterais a evitar.
Também convém separar transcrição e limpeza posterior. Um modelo de linguagem pode reescrever uma expressão improvável em algo plausível, mas isso não prova que recuperou as palavras faladas. Preserve a saída original do reconhecimento para avaliar a tarefa acústica separadamente.
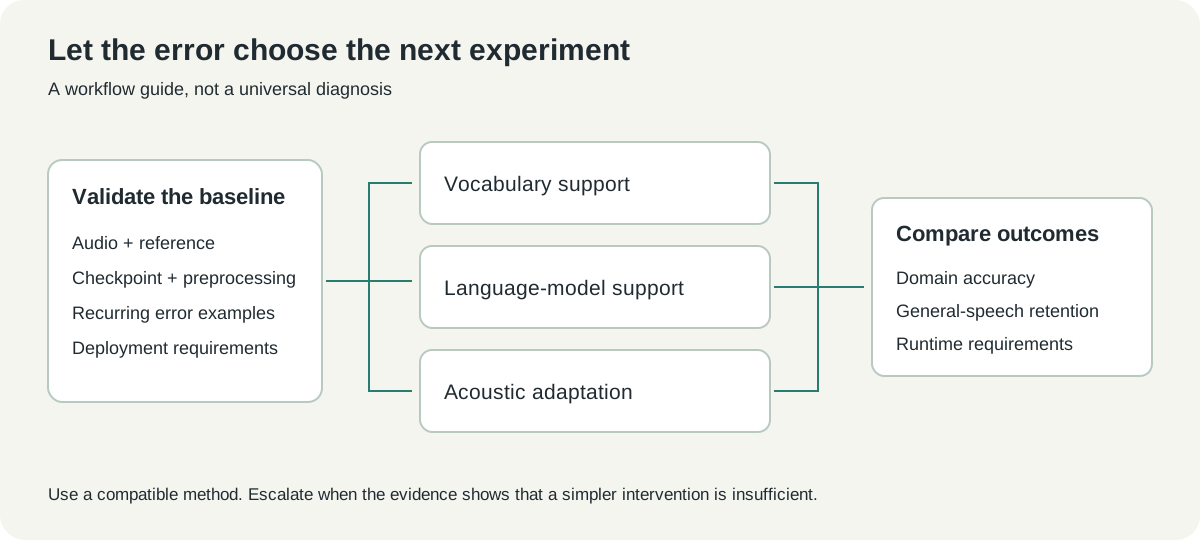 Diagrama de decisão original baseado no fluxo documentado. Introduz rotas possíveis, sem alegar que uma delas atende a todo reconhecedor.
A melhora relatada tem um denominador preciso
No estudo apresentado pela NVIDIA, o tutorial informa queda da taxa de erro por palavra do Nemotron de 77.00% para 22.46%, em um conjunto de teste ATCO2 de duas horas anotado por humanos, uma redução relativa de 70.8%. Também informa mudança da WER de inglês geral de 3.50% para 3.63%. São resultados do desenvolvedor nas condições daquele estudo. Tutorial de 13 de outubro
A taxa de erro por palavra conta substituições, exclusões e inserções em relação às palavras de referência. Não é o percentual de frases com ao menos um erro, e a redução relativa informada não é uma diferença em pontos percentuais. Separar essas quantidades permite comparar o resultado com honestidade.
O exemplo é útil por mostrar tanto o domínio-alvo quanto outro domínio. Um resultado especializado, sozinho, não revela se o reconhecedor preservou a habilidade de fala comum de que você ainda precisa. Mesmo uma pequena mudança no domínio geral merece aparecer ao lado da melhora, não ser omitida.
Outro microfone, idioma ou convenção de transcrição pode produzir um resultado muito diferente. A manchete deve motivar um método: medir uma referência, adaptar sob condições controladas e avaliar dados reservados. Não deve virar promessa de remover a mesma proporção de erros das chamadas de uma empresa.
Separe o material que ensina do material que avalia
Um conjunto de adaptação precisa de funções distintas. Os exemplos de treinamento alteram o modelo. Os de desenvolvimento orientam escolhas, como checkpoints e configurações de decodificação. Os de teste avaliam o sistema escolhido depois dessas decisões.
Dividir aleatoriamente segmentos curtos pode criar uma falsa independência. Dois clipes da mesma gravação podem compartilhar falante, canal, frase e ruído de fundo. Quando possível, faça as divisões pela unidade relevante para a implantação: gravações, falantes ou sessões de coleta.
Deixe explícita a convenção de referência. Decida como representar números, abreviações, pontuação e hesitações antes da avaliação. Se a saída escreve “twenty one” e a referência escreve “21”, a normalização escolhida pode alterar a pontuação sem mudar o que um ouvinte entendeu.
Para começar, prepare um pequeno inventário em vez de correr para coletar um corpus grande. Registre a origem do áudio, os usos permitidos, quem conferiu a transcrição e a função do item. Um inventário claro é mais fácil de revisar do que uma pasta em que os nomes dos arquivos são a única procedência.
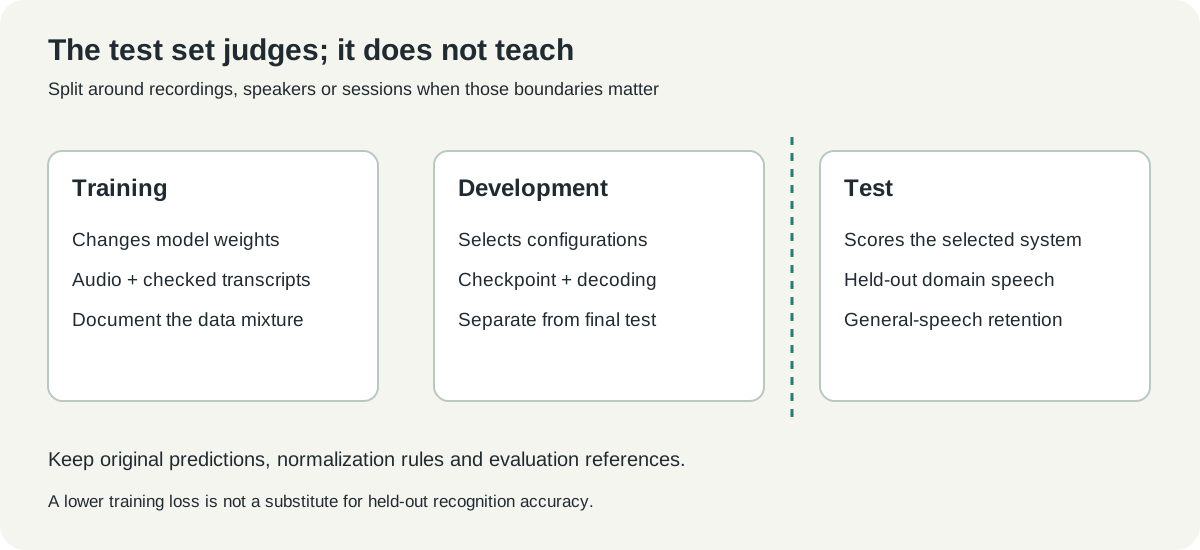 Diagrama explicativo original. Os testes ficam fora do treinamento e da seleção de checkpoints; a preservação da fala comum é avaliada junto à tarefa de domínio.
O primeiro pedido deve solicitar um plano e uma referência
A skill trabalha melhor quando o pedido contém um objetivo observável. “Ajude com nossas transcrições de inspeção” é um começo, mas deixa ambíguos o reconhecedor, o idioma, o modo de implantação e o custo dos erros. Acrescente esses detalhes e peça uma primeira etapa delimitada.
Por exemplo, um pedido proposto poderia ser:
Examine um pequeno conjunto licenciado de gravações de inspeção e transcrições de referência. Identifique confusões recorrentes de termos, valide o reconhecedor e o pré-processamento atuais e meça uma referência. Compare apoio de vocabulário com uma proposta de treinamento. Preserve um conjunto de teste reservado e informe precisão no domínio, preservação da fala comum e requisitos de recursos antes de uma execução longa.
O exemplo define as evidências que o agente deve retornar. Também deixa o método em aberto até que os dados apoiem uma escolha. Isso costuma ser mais produtivo do que começar ordenando ajustar um checkpoint específico por um número arbitrário de passos.
Um relatório inicial útil identifica o checkpoint exato, a configuração de execução, o conjunto de avaliação e os erros recorrentes. Também explica qual parte do processo limita o progresso. Uma transcrição ruim causada por amostragem incorreta exige uma solução diferente de outra causada por fala realmente desconhecida.
Instale conscientemente as instruções e as dependências de execução
O tutorial da NVIDIA documenta comandos separados para instalar as skills de orquestração e especialista. A segunda não é instalada automaticamente só porque a primeira a menciona. Os comandos abaixo reproduzem a seleção do tutorial; examine os repositórios e escolha o escopo desejado quando solicitado.
npx skills@latest add NVIDIA/skills --skill nemotron-asr-finetune
npx skills@latest add NVIDIA-NeMo/Speech --skill nemo-speech-asr-finetune
npx skills@latest list
Inicie uma nova sessão do agente após instalar e confirme que as skills esperadas estão disponíveis. Isso demonstra que o agente descobre as instruções. Ainda não diz se a máquina consegue carregar um checkpoint ou treinar.
Na configuração documentada, o tutorial usa um host Linux com GPU e um contêiner NeMo Speech fixado em 26.07.00. Verifique os requisitos de driver, GPU e framework da imagem atual antes de preparar o host. Uma skill instalada no notebook não substitui esse ambiente. Preparação do ambiente
Mantenha a primeira verificação restrita. Valide importações, visibilidade da GPU, carregamento do checkpoint e uma inferência curta antes de reservar recursos de treinamento. Registre as versões e a identidade do contêiner para relacionar o resultado ao software que o produziu.
Reconhecimento em streaming e offline exigem comparações separadas
Um reconhecedor em streaming precisa produzir saída enquanto o áudio chega. Um reconhecedor offline pode seguir outro padrão de execução depois que a gravação está disponível. Ambos transcrevem fala, mas latência, contexto e decodificação podem diferir o suficiente para que uma pontuação única não represente a comparação completa.
Em uma aplicação ao vivo, registre quando os resultados parciais aparecem, quando estabilizam e como o texto final é entregue. Uma transcrição mais precisa que chega tarde pode não atender a legendas ao vivo. Para um arquivo, um processo offline mais lento pode ser aceitável se gerar um registro final melhor.
Use o mesmo modo antes e depois da adaptação na comparação principal. Se mudar também divisão em blocos, decodificação, checkpoint e normalização, a melhora não revelará qual alteração importou. Crie outro experimento para comparar o fluxo alternativo completo.
A mesma disciplina ajuda na avaliação posterior. Identificação de falantes, marcações de tempo e palavras reconhecidas são saídas distintas. Uma transcrição pode ter boa WER e atribuir uma declaração importante à pessoa errada; avalie essas capacidades separadamente quando necessárias.
Um checkpoint avaliado vale mais do que um log de treinamento bem-sucedido
Uma perda de treinamento em queda mostra que a otimização está se ajustando ao objetivo. Não demonstra que um novo falante será reconhecido com mais precisão. O artefato útil é um checkpoint selecionado junto à configuração, previsões e resultados de avaliação.
Mantenha o modelo original disponível e avalie-o pelo mesmo protocolo. Inclua falhas representativas no relatório para que um especialista entenda a lacuna restante. Uma tabela de médias deve conduzir a exemplos, não escondê-los.
A implantação acrescenta perguntas. A máquina de destino carrega o artefato? O runtime de serviço aceita a arquitetura e o tokenizer? A saída preserva as convenções esperadas pelo software posterior? O ambiente de treinamento e o de aplicação podem divergir mesmo quando ambos oferecem “reconhecimento de fala”.
O tutorial distingue ferramentas lançadas de checkpoints refinados com Gold, descritos como futuros. Trate disponibilidade de código, resultados de exemplo e pesos adaptados para download como estados diferentes de lançamento. Um tutorial público permite começar o planejamento; não significa que todo artefato demonstrado já esteja empacotado para sua implantação.
Uma adaptação melhor começa com uma pergunta menor e mais clara
Na nossa visão, Speech Skills é especialmente útil para tornar examinável o trabalho com ASR especializado. Transforma um pedido aberto de mais precisão em decisões sobre erros, dados, métodos compatíveis e avaliação. Isso pode evitar um treinamento longo sem um critério de conclusão acordado.
Comece pelas palavras importantes e pelas gravações que demonstram o problema. Verifique se uma intervenção mais simples funciona e avance com evidências. O checkpoint tem valor quando melhora a transcrição nas condições realmente enfrentadas por seus leitores ou ouvintes.
Fontes e mídia
Conferido em 20 de outubro de 2026. Os números são atribuídos ao estudo da NVIDIA; não reproduzimos treinamento, inferência nem demonstração para este artigo. A captura mostra documentação pública da NVIDIA, registrada pelo autor, com atribuição CC BY 4.0. Os diagramas são originais. Consulte o registro de mídia.
- Tutorial da NVIDIA, 13 de outubro de 2026
- Skill de orquestração
- Skill especialista em NeMo
- Framework NeMo Speech
- Licenças da documentação e do código NVIDIA
Mantenha as evidências de áudio ao lado da revisão
Guarde referências, decisões de terminologia e notas de avaliação juntas para que o próximo experimento comece com um registro claro. O Telli.sh pode ajudar a organizar essa pesquisa. Crie uma conta no Telli.sh