NVIDIA Speech Skills: Ein ASR-Ablauf lernt, wo Fachbegriffe scheitern
Eine Einführung in NVIDIAs Skills zur Sprachanpassung: wie ein Programmieragent Fachwortschatz untersuchen, Daten vorbereiten, gezielt trainieren und Verbesserungen bewerten kann.
Das Transkript trifft den Satzbau und verfehlt den wichtigen Namen. Eine Fachperson erkennt die gemeinte Formulierung sofort, doch das Sprachmodell ersetzt sie durch ein gewöhnliches Wort. Die Verbesserung beginnt mit einer genaueren Frage als „Welches Modell ist das beste?“.
NVIDIAs Tutorial zu Speech Agent Skills vom 13. Oktober 2026 zeigt einen Ablauf, um automatische Spracherkennung, kurz ASR, an eine Domäne anzupassen. Ein übergeordneter Skill grenzt das Problem ein und koordiniert die Arbeit; ein NeMo-Spezialist übernimmt kompatibles Training und die Bewertung. Als durchgehendes Beispiel dient Flugfunk. NVIDIA-Tutorial
Diese Einführung erklärt den Beitrag der Skills, wann Training sinnvoll ist und wie sich ein erster Versuch planen lässt. Sie müssen nicht mit einem großen Trainingslauf beginnen. Ein nützliches erstes Ergebnis kann eine klare Darstellung sein, welche Wörter scheitern, warum sie wichtig sind und welcher Eingriff einen Test verdient.
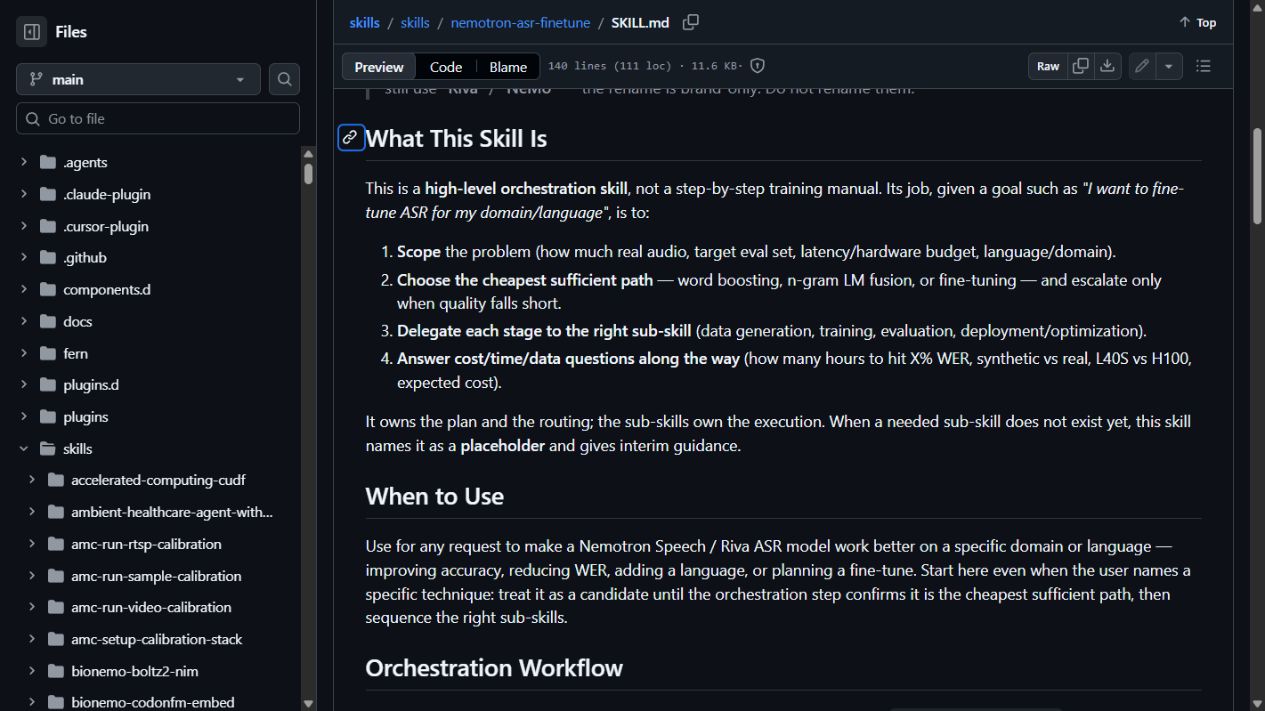 NVIDIAs öffentliche Skill-Dokumentation, aufgenommen am 20. Oktober 2026. Dokumentation © NVIDIA, mit Quellenangabe unter CC BY 4.0. Gezeigt werden die Anweisungen des Skills, kein Trainingslauf.
Ein Skill organisiert die Arbeit rund um ein Modell
Ein Modell enthält gelernte Parameter. Ein Trainingsframework stellt die Werkzeuge bereit, um diese Parameter zu aktualisieren. Ein Agenten-Skill liefert Anweisungen, die einem Programmierassistenten helfen, einen Ablauf auszuwählen und durchzuführen. Die Installation dieser Anweisungen installiert nicht jedes Framework, lädt nicht jeden Checkpoint herunter und belegt nicht, dass eine GPU den Versuch ausführen kann.
Im Tutorial trennt NVIDIA den koordinierenden Skill nemotron-asr-finetune vom Spezialisten nemo-speech-asr-finetune. Der erste formuliert das Ziel und leitet die Arbeit weiter. Der zweite übernimmt die NeMo-spezifische Ausführung, wenn Training oder Offline-Bewertung angemessen sind. Beschreibung des Ablaufs
Diese Arbeitsteilung ist nützlich, weil „Erkennung verbessern“ mehrere unterschiedliche Aufgaben umfasst. Ein Wortschatzproblem kann Unterstützung beim Decoding erfordern. Abweichende Sprechweisen oder Audiobedingungen können eine Anpassung rechtfertigen. Eine fehlerhafte Vorverarbeitung muss vielleicht zuerst korrigiert werden, bevor einer dieser Wege sinnvoll ist.
Betrachten Sie den Skill als Versuchskoordinator. Er kann helfen, Ziel, Eingaben und Vergleich aufeinander abzustimmen. Trotzdem muss ein Mensch definieren, was Erfolg bedeutet. Das Endergebnis sollte überprüfbare Belege liefern, nicht bloß die Aussage eines Assistenten, das Training sei abgeschlossen.
Beginnen Sie mit dem Fehler, der die Bedeutung verändert
Angenommen, ein Unternehmen schult Beschäftigte darin, bei Kontrollen eine kleine Menge von Produktcodes auszusprechen. Die Erkennung transkribiert normale Gespräche gut, verwechselt aber wiederholt zwei ähnliche Codes. Der erste nützliche Datensatz besteht aus diesen Verwechslungen zusammen mit Originalaudio und geprüftem Referenztranskript.
Ein zweiter Fall ist ein Interviewarchiv mit Namen und Fachterminologie. Hier kann die Schwierigkeit je nach Sprecher, Mikrofon und Thema variieren. Trennen Sie Schreibkonventionen von akustischen Fehlern: Zwei Schreibweisen derselben Abkürzung sollten nicht automatisch als unterschiedliche Erkennungsfehler gelten.
Ein dritter Fall sind Aufnahmen des technischen Supports über einen verrauschten Kanal. Eine Wortliste kann bei einigen Begriffen helfen, aber fehlende Silben nicht lösen. Eine Domänenanpassung wird nützlicher, wenn sie sprachliche Erwartungen vom tatsächlich für das Modell verfügbaren Ton unterscheidet.
Das sind vorgeschlagene Anwendungen des Ablaufs, keine berichteten Einsätze. Sie zeigen, warum die Eingabe Beispiele und nicht nur einen Zielsatz enthalten sollte. Ein Dutzend gut verstandener Fehler kann offenlegen, ob als Nächstes Datenbereinigung, Wortschatzunterstützung oder eine umfangreichere Anpassungsstudie sinnvoll ist.
Wählen Sie den einfachsten Eingriff, der das Problem adressiert
Der öffentliche Koordinations-Skill beschreibt eine Folge von Wortverstärkung über Sprachmodellunterstützung bis zum Fine-Tuning und wählt zunächst einen ausreichenden Weg, bevor er eskaliert. Das ist ein Planungsprinzip, keine Zusicherung identischer Regler für jedes Modell und jede Laufzeitumgebung. Skill-Dokumentation
| Beobachtetes Problem | Möglicher Eingriff | Was verglichen werden sollte |
|---|---|---|
| Ein bekannter Fachbegriff verliert gegen ein häufiges Wort | Unterstützter Wortschatz- oder Wortverstärkungsmechanismus | Genauigkeit der Zielbegriffe und unerwünschte Einfügungen |
| Typische Formulierungen der Domäne gelten konsequent als unwahrscheinlich | Kompatible Sprachmodell- oder Decoding-Unterstützung | Domänengenauigkeit neben gewöhnlicher Sprache |
| Das Modell hat Schwierigkeiten mit Sprache oder Kanal der Domäne | Anpassung des akustischen Modells | Zurückgehaltenes Domänenaudio und ein allgemeiner Sprachdatensatz |
| Die Genauigkeit bricht nach einer Konfigurationsänderung plötzlich ein | Kompatible Vorverarbeitung wiederherstellen und prüfen | Derselbe Checkpoint und dasselbe Audio unter beiden Konfigurationen |
Die Tabelle ist eine Entscheidungshilfe, keine Diagnose. Eine Wortschatzerweiterung kann neue Fehler erzeugen, wenn ähnliche Alltagswörter häufig vorkommen. Fine-Tuning kann eine Spezialaufgabe verbessern und eine andere Sprachart verschlechtern. Messen Sie den gewünschten Effekt und die zu vermeidenden Nebenwirkungen.
Trennen Sie außerdem Transkription von nachgelagerter Textbereinigung. Ein Sprachmodell kann eine unplausible Formulierung in etwas vernünftig Klingendes umschreiben. Das belegt aber nicht, dass es die gesprochenen Wörter wiedergewonnen hat. Bewahren Sie die ursprüngliche Erkennungsausgabe auf, damit die akustische Aufgabe separat bewertet werden kann.
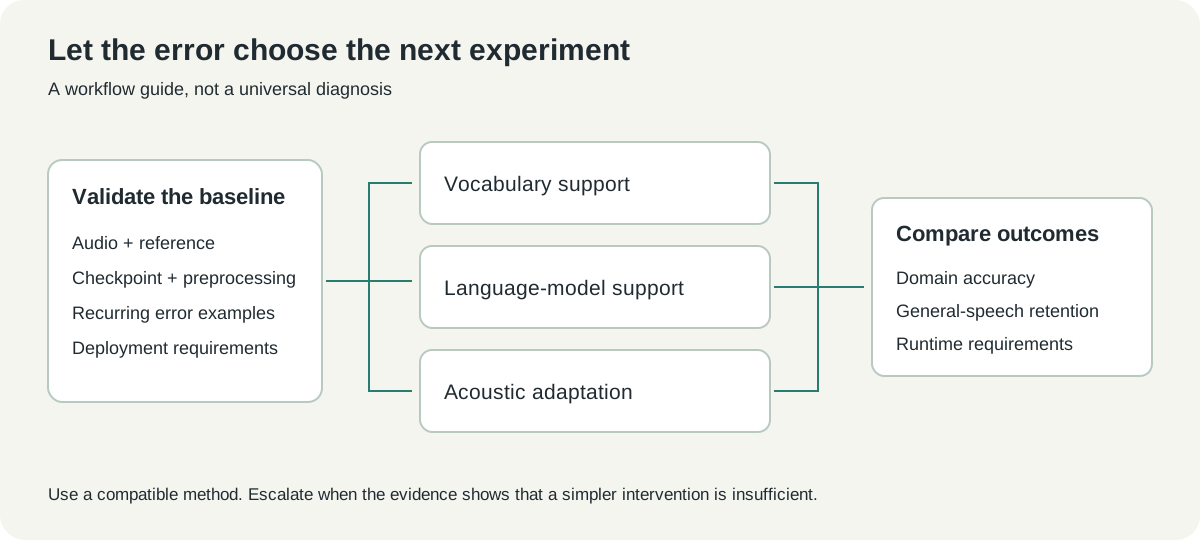 Eigenes Entscheidungsdiagramm auf Grundlage des dokumentierten Ablaufs. Es führt in mögliche Wege ein und behauptet nicht, dass ein Weg zu jeder Spracherkennung passt.
Die berichtete Verbesserung hat eine genaue Bezugsgröße
In NVIDIAs Beispielstudie sinkt Nemotrons Wortfehlerrate laut Tutorial von 77.00% auf 22.46% auf einem zweistündigen, von Menschen annotierten ATCO2-Testdatensatz. Das entspricht einer relativen Verringerung um 70.8%. Für allgemeines Englisch wird außerdem eine WER-Änderung von 3.50% auf 3.63% genannt. Das sind Ergebnisse des Herausgebers unter den Bedingungen dieser Studie. Tutorial vom 13. Oktober
Die Wortfehlerrate zählt Ersetzungen, Auslassungen und Einfügungen relativ zu den Referenzwörtern. Sie ist nicht der Anteil von Sätzen mit mindestens einem Fehler; die relative Verringerung ist auch keine Änderung in Prozentpunkten. Diese Größen getrennt zu halten, erleichtert einen ehrlichen Vergleich.
Das Beispiel ist nützlich, weil es sowohl die Zieldomäne als auch eine weitere Domäne zeigt. Ein Spezialergebnis allein verrät nicht, ob die Erkennung die weiterhin benötigten Fähigkeiten bei gewöhnlicher Sprache bewahrt hat. Selbst eine kleine Veränderung in der allgemeinen Domäne sollte neben der Verbesserung gelesen und nicht weggelassen werden.
Ein anderes Mikrofon, eine andere Sprache oder andere Transkriptionsregeln können ein völlig anderes Ergebnis erzeugen. Die Schlagzeile sollte deshalb eine Methode anregen: Ausgangswert messen, unter kontrollierten Bedingungen anpassen und einen zurückgehaltenen Datensatz bewerten. Sie sollte nicht zum Versprechen werden, dass ein Unternehmen denselben Fehleranteil aus seinen eigenen Anrufen entfernen kann.
Trennen Sie Lernmaterial von Bewertungsmaterial
Die Daten einer Anpassung brauchen verschiedene Rollen. Trainingsbeispiele verändern das Modell. Entwicklungsbeispiele steuern die Wahl von Checkpoints und Decoding-Einstellungen. Testbeispiele beurteilen das ausgewählte System, nachdem diese Entscheidungen getroffen wurden.
Eine zufällige Aufteilung kurzer Segmente kann irreführende Unabhängigkeit erzeugen. Zwei Ausschnitte derselben Aufnahme können Sprecher, Kanal, Formulierungen und Hintergrundgeräusche teilen. Richten Sie die Aufteilung nach Möglichkeit an der für den Einsatz entscheidenden Einheit aus, etwa Aufnahmen, Sprechern oder Erfassungssitzungen.
Legen Sie die Referenzkonvention ausdrücklich fest. Entscheiden Sie vor der Bewertung, wie Zahlen, Abkürzungen, Satzzeichen und Zögerlaute dargestellt werden. Schreibt eine Ausgabe „twenty one“ und die Referenz „21“, kann die Normalisierung den Score ändern, ohne das Verständnis eines Zuhörers zu verändern.
Bereiten Sie zum Einstieg eine kleine Bestandsliste vor, statt möglichst schnell ein großes Korpus zu sammeln. Halten Sie fest, woher das Audio stammt, welche Nutzung erlaubt ist, wer das Transkript geprüft hat und welche Rolle der Eintrag hat. Eine klare Bestandsliste lässt sich viel leichter prüfen als ein Ordner, dessen Dateinamen die einzige Herkunftsinformation sind.
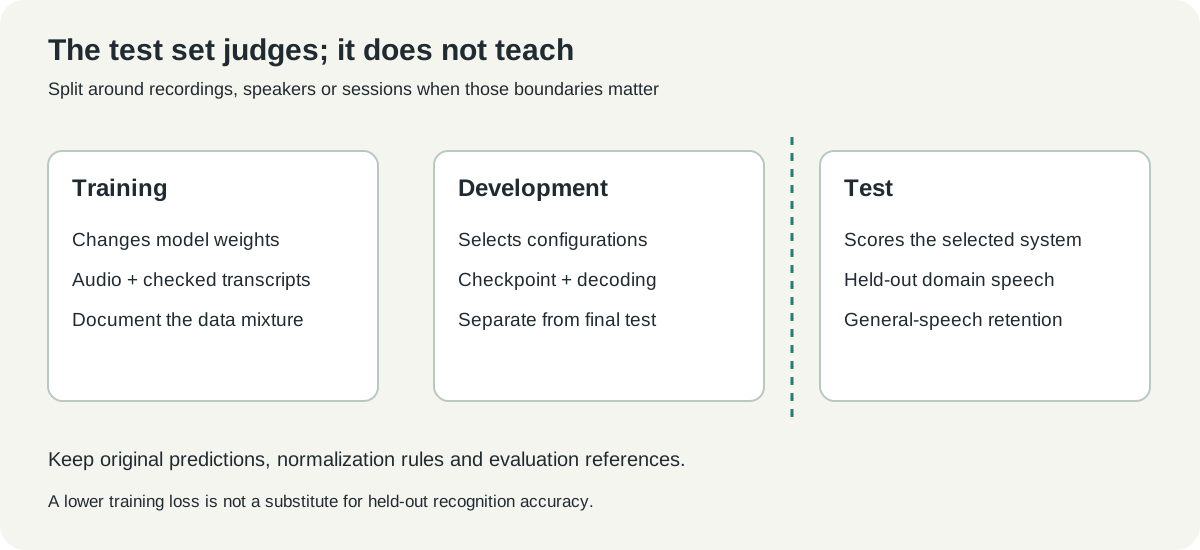 Eigene Erklärungsgrafik. Der Testpfad bleibt außerhalb von Training und Checkpoint-Auswahl; der Erhalt gewöhnlicher Spracherkennung wird neben der Domänenaufgabe bewertet.
Eine erste Anfrage sollte nach Plan und Ausgangsmessung fragen
Der Skill kann nützlichere Arbeit leisten, wenn die Anfrage ein beobachtbares Ziel enthält. „Unsere Inspektionstranskripte verbessern“ ist ein Anfang, lässt aber Erkennungssystem, Sprache, Betriebsmodus und Fehlerkosten offen. Ergänzen Sie diese Details und verlangen Sie eine begrenzte erste Phase.
Eine vorgeschlagene Anfrage könnte beispielsweise lauten:
Prüfe eine kleine, lizenzierte Sammlung unserer Inspektionsaufnahmen und Referenztranskripte. Identifiziere wiederholte Begriffsverwechslungen, validiere die aktuelle Erkennung und Vorverarbeitung und miss einen Ausgangswert. Vergleiche Wortschatzunterstützung mit einem Trainingsvorschlag. Bewahre einen zurückgehaltenen Testdatensatz und berichte vor einem längeren Lauf über Domänengenauigkeit, den Erhalt gewöhnlicher Spracherkennung und Ressourcenanforderungen.
Das Beispiel definiert die vom Agenten erwarteten Belege. Gleichzeitig bleibt die Methode offen, bis die Daten eine Wahl stützen. Das ist meist produktiver, als sofort das Fine-Tuning eines bestimmten Checkpoints für eine willkürliche Anzahl von Schritten anzuweisen.
Ein nützlicher Erstbericht benennt den exakten Checkpoint, die Laufzeitkonfiguration, den Bewertungsdatensatz und die wiederkehrenden Fehler. Er erklärt außerdem, welcher Teil des Prozesses den Fortschritt derzeit begrenzt. Ein schlechtes Transkript durch eine falsche Abtastkonfiguration braucht eine andere Reparatur als eines durch tatsächlich ungewohnte Sprache.
Installieren Sie Anweisungen und Ausführungsabhängigkeiten bewusst
NVIDIAs Tutorial dokumentiert getrennte Installationsbefehle für Koordinations- und Spezialisten-Skill. Der zweite wird nicht automatisch installiert, nur weil der erste auf ihn verweist. Die folgenden Befehle entsprechen dem Auswahlweg des Tutorials. Prüfen Sie die Repositories und wählen Sie bei der Abfrage den gewünschten Installationsumfang.
npx skills@latest add NVIDIA/skills --skill nemotron-asr-finetune
npx skills@latest add NVIDIA-NeMo/Speech --skill nemo-speech-asr-finetune
npx skills@latest list
Starten Sie nach der Installation eine neue Sitzung des Programmieragenten und prüfen Sie, ob die erwarteten Skills verfügbar sind. Damit ist nachgewiesen, dass der Agent die Anweisungen finden kann. Es sagt noch nichts darüber aus, ob der Rechner einen Checkpoint laden oder trainieren kann.
Das Tutorial verwendet für die dokumentierte Einrichtung einen Linux-GPU-Host und einen fixierten NeMo-Speech-Container, 26.07.00. Prüfen Sie vor der Hostvorbereitung die Treiber-, GPU- und Framework-Anforderungen des aktuellen Images. Ein auf dem Laptop installierter Skill ersetzt diese Ausführungsumgebung nicht. Vorbereitung der Umgebung
Halten Sie die erste Umgebungsprüfung eng begrenzt. Prüfen Sie Importe, GPU-Sichtbarkeit, Checkpoint-Laden und einen kurzen Inferenzdurchlauf, bevor Sie ein Trainingsbudget einplanen. Dokumentieren Sie Versionen und Containeridentität, damit ein späteres Ergebnis der erzeugenden Software zugeordnet werden kann.
Streaming- und Offline-Erkennung brauchen getrennte Vergleiche
Eine Streaming-Erkennung muss Ausgaben erzeugen, während Audio eintrifft. Eine Offline-Erkennung kann nach Vorliegen der Aufnahme einem anderen Ausführungsmuster folgen. Beide transkribieren Sprache, doch Latenz, Kontext und Decoding können sich so stark unterscheiden, dass ein einzelner Score keinen vollständigen Vergleich bietet.
Erfassen Sie für eine Live-Anwendung, wann Teilergebnisse erscheinen, wann sie stabil werden und wie der endgültige Text bereitsteht. Ein genaueres Transkript, das zu spät eintrifft, kann für Live-Untertitel ungeeignet sein. Für ein Archiv kann eine langsamere Offline-Verarbeitung akzeptabel sein, wenn sie einen besseren Endstand liefert.
Verwenden Sie für den Kernvergleich vor und nach der Anpassung denselben Modus. Ändern Sie gleichzeitig Segmentierung, Decoding, Checkpoint und Textnormalisierung, verrät ein besserer Score nicht, welche Änderung wichtig war. Vergleichen Sie den vollständigen alternativen Ablauf bei Bedarf in einem separaten Versuch.
Dieselbe Disziplin hilft bei der nachgelagerten Bewertung. Sprecherkennzeichnungen, Zeitstempel und erkannte Wörter sind getrennte Ausgaben. Ein Transkript kann eine gute WER haben und eine wichtige Aussage trotzdem der falschen Person zuordnen. Bewerten Sie diese Fähigkeiten separat, wenn die Anwendung sie braucht.
Ein bewerteter Checkpoint ist mehr als ein erfolgreiches Trainingsprotokoll
Ein sinkender Trainingsverlust zeigt, dass die Optimierung ihre Zielfunktion besser trifft. Er belegt nicht, dass ein neuer Sprecher genauer erkannt wird. Das nützliche Ergebnis ist ein ausgewählter Checkpoint zusammen mit Konfiguration, Vorhersagen und Bewertungsergebnissen.
Bewahren Sie das ursprüngliche Modell auf und bewerten Sie es nach demselben Verfahren. Nehmen Sie einige repräsentative Fehlbeispiele in den Bericht auf, damit eine Fachperson die verbleibende Lücke versteht. Eine Durchschnittstabelle sollte zu Beispielen führen, statt sie zu verbergen.
Der Betrieb bringt weitere Fragen mit. Kann der Zielrechner das Artefakt laden? Unterstützt die Serving-Laufzeit Architektur und Tokenizer? Behält die Ausgabe die von nachgelagerter Software erwarteten Konventionen bei? Trainingsumgebung und Anwendungslaufzeit können inkompatibel sein, obwohl beide „Spracherkennung“ unterstützen.
NVIDIAs Tutorial unterscheidet veröffentlichte Werkzeuge von dort als bevorstehend beschriebenen Gold-refined-Checkpoints. Behandeln Sie verfügbaren Code, Beispielergebnisse und herunterladbare angepasste Gewichte als getrennte Veröffentlichungsstände. Ein öffentliches Tutorial reicht, um die Planung zu beginnen; es bedeutet nicht, dass jedes gezeigte Artefakt bereits für Ihren Einsatz verpackt ist.
Bessere Anpassung beginnt mit einer kleineren, klareren Frage
Aus unserer Sicht ist Speech Skills besonders nützlich, um spezialisierte ASR-Arbeit überprüfbar zu machen. Es verwandelt den offenen Wunsch nach besserer Genauigkeit in Entscheidungen über Fehler, Daten, kompatible Methoden und Bewertung. Das kann verhindern, dass ein Versuch zu einem langen Trainingslauf ohne vereinbarte Ziellinie wird.
Beginnen Sie mit den wichtigen Wörtern und den Aufnahmen, die das Problem belegen. Prüfen Sie, ob ein einfacherer Eingriff funktioniert, und erweitern Sie den Aufwand erst mit Belegen. Der Checkpoint ist wertvoll, wenn er das Transkript unter den Bedingungen verbessert, denen Ihre Lesenden oder Zuhörenden tatsächlich begegnen.
Quellen und Medien
Geprüft am 20. Oktober 2026. Die numerischen Ergebnisse stammen aus NVIDIAs Studie; Training, Inferenz und Demoergebnisse wurden für diesen Artikel nicht reproduziert. Der Screenshot zeigt öffentliche NVIDIA-Dokumentation, aufgenommen vom Autor und mit Quellenangabe unter CC BY 4.0. Die Diagramme sind eigene Arbeiten. Siehe Mediennachweis.
- NVIDIA-Tutorial vom 13. Oktober 2026
- Koordinations-Skill
- NeMo-Spezialisten-Skill
- NeMo-Speech-Framework
- Lizenzen von NVIDIAs Dokumentation und Quellcode
Bewahren Sie Audiobelege und Bewertung gemeinsam auf
Halten Sie Quellenverweise, Terminologieentscheidungen und Bewertungsnotizen zusammen, damit der nächste Versuch auf einer klaren Dokumentation aufbaut. Telli.sh kann helfen, diese Recherche zu organisieren. Telli.sh-Konto erstellen