24GB 模型不等于 24GB 电脑:Nemotron Bolt 的内存预算
了解 Nemotron Bolt 的 74B 总参数和 9B 激活参数、原生 2-bit 权重,以及本地配置所需的上下文、视觉、草稿模型和运行时内存。
你的 GPU 有 24GB 内存。新模型的名字里也有“24GB”。这两个数字难道还不足以决定买不买?
对于完整的本地 AI 工作负载来说,不足以。NVIDIA 在 October 15 的公告中推出 Nemotron 3.5 Bolt 74B-A9B 24GB,这是一款使用原生 2-bit 量化、可本地部署的视觉语言模型。名字描述的是优化目标,并不保证每种上下文长度、图像请求和 agent 配置都能装进一张 24GB 显卡。NVIDIA 公告,2026年10月15日。
真正有用的问题是模型加载之后还剩下多少空间。本指南将区分已存储参数和激活计算,解释其他内存消耗,并依据实际模型卡配方,带你完成一个仅绑定 loopback 的设置。从所需工作负载出发,再判断机器能否持续运行。
主图:原创整套工作负载预算示意,不是官方截图或实测分配图。图中不表示各组成部分的大小。
激活参数较少,不代表它是 9B 下载
Bolt 总计有 74 billion 个参数,每个 token 大约激活 9 billion 个。它的 mixture-of-experts 路由器会选择已存储网络的一部分。它是从 120B-A12B Super VL 压缩而来的模型,不是稠密的 9B 模型。NVIDIA Bolt 研究概览,2026年10月15日。
要记住这个区别:激活参数有助于解释每个 token 需要执行多少工作;总参数则有助于解释需要存储多少内容。两者都无法单独决定应用速度。参数放置方式、内存带宽、kernel、输入长度以及周边应用都会影响结果。
审查代码的 agent 仍然需要访问前一个 token 没有选中的专家。在存储、系统内存和 GPU 内存之间移动数据,不等于所有数据都能随时在加速器上使用。因此,激活参数较少,并不意味着可以假装其余参数不存在来计算硬件需求。
这些系列名称也值得准确比较:
| 型号 | 名称所指 | October 16 的状态 |
|---|---|---|
| Nemotron 3.5 Super VL | 独立的 120B 模型 | 已发布 |
| Nemotron 3.5 Bolt 74B-A9B 24GB | 本文讨论的压缩本地模型选项 | 已发布 |
| Nemotron 3.5 Bolt E4B 4GB | 另一个更小的边缘/对话型产品 | 宣布 October 23 发布 |
这些发布状态来自 October 15 公告。在本文日期,E4B 仍是未来才会提供的产品,不是这些命令所演示的可用替代品。同样,也不应把 Super VL 的企业部署结果当成桌面 Bolt 的结果。
原生 2-bit 权重只解决预算的一部分
“原生 2-bit”很有意义,因为激进压缩是该模型开发的一部分,而不只是用户事后选择一个更小的导出版本。NVIDIA 使用量化感知蒸馏,在降低精度后恢复能力。其专家权重使用每个元素 2.0625 bits 的 IQ2_XXS,而其他组成部分保留不同格式。该网络采用混合精度,并非所有部分都统一为 2 bits。NVIDIA 压缩与量化说明,2026年10月15日。
用一个刻意简化、并不符合实际的算术检查来说明:如果 74 billion 个数值都恰好以 2 bits 存储,就会占用 18.5 billion bytes。这只是示意,不是 Bolt 文件大小或启动要求,因为它忽略了实际精度组合、元数据和运行状态。用标题中的参数量乘以标题中的位数,不能替代对具体检查点的检查。
GGUF 回答的是另一个问题。它是 llama.cpp 生态使用的模型文件格式,包含张量和相关信息。它并不是叠加在“2-bit”之上的第二项压缩保证;下载 GGUF 本身也不能证明特定运行时支持这个模型。llama.cpp GGUF 工具文档,查阅于 2026年10月16日。
NVIDIA 自己估算的内存拆分让区别更加具体:表 2 将权重列为 22.01GB,不含视觉时合计 23.83GB,视觉编码器和投影器还需要 1.68GB。这些是 NVIDIA 对报告所述配置的估算,不是本文测得的内存。该报告还描述了在 batch size one、128K context 下低于 24GB 的设计目标。Bolt 技术报告,表 2 和 2.3 节,链接于 2026年10月15日。
重点不是品牌名称暗中指的只有权重,而是部署目标有其假设。假设改变,内存需求也会改变。
为完整工作集预算,而不只是权重
可以把部署看作存储模型之上的 context tax:你要求系统保留和处理的工作也需要空间。规划时,应区分权重、序列状态、视觉处理、投机解码和运行时工作区。还要为桌面系统及你打算同时打开的应用留出额外余量。
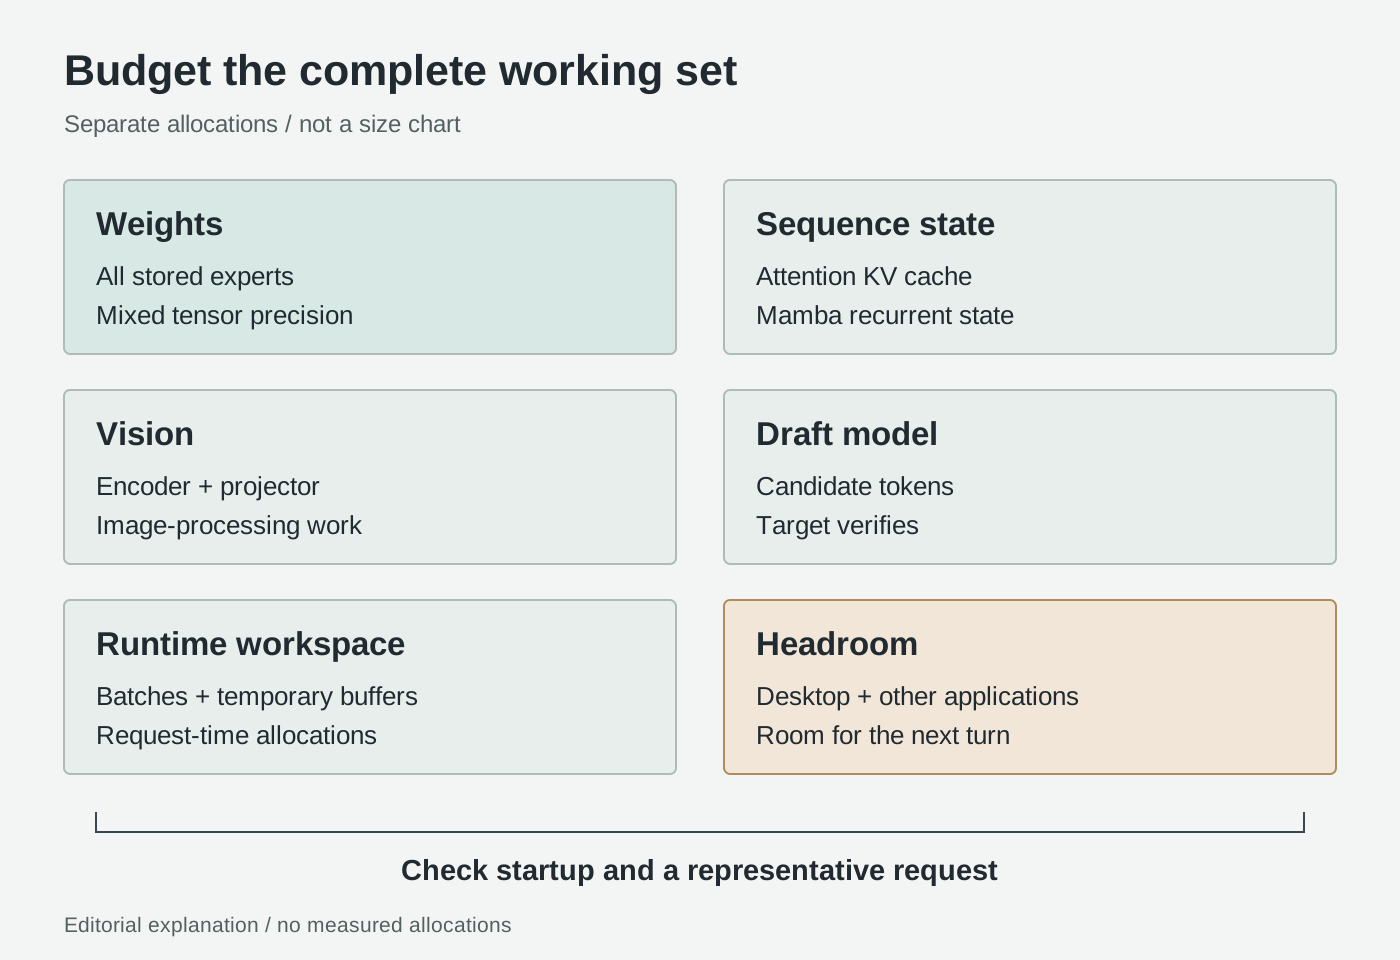
原创说明图,不表示实测比例。机制说明见:Hugging Face 缓存文档、llama.cpp 多模态指南和 NVIDIA Bolt 报告,查阅于 2026年10月16日。
序列状态不是权重的另一份副本。 自回归注意力模型会缓存此前 token 的 key 和 value,以便生成时重复利用。保留的序列越长,所需注意力缓存越多,具体细节取决于架构和缓存表示。Hugging Face,“How caching works”,查阅于 2026年10月16日。
Bolt 是采用 Mamba 和注意力层的混合架构,因此通用的全 Transformer 缓存估算并不能完整计算它的需求。循环状态和注意力缓存是不同的分配;应检查运行时实际创建了什么。架构区别记录在 Bolt 报告表 1,查阅于 2026年10月16日。
对 agent 来说,保留的上下文不止你输入的问题。系统指令、工具 schema、对话历史、检索段落和工具响应都会占用回答所需空间。重复罗列仓库内容的记录可能耗尽有用预算,却没增加有效证据。保留简洁的任务状态是一项工作流选择,不只是硬件权宜之计。
视觉会引入独立的处理路径。 llama.cpp 通过 --mmproj 将语言模型与多模态投影文件配对;文档称该组件默认会卸载到 GPU。llama.cpp 多模态指南,查阅于 2026年10月16日。因此,只加载语言模型文件,并不等同于完整的图像处理配置。
处理文档时,要区分读取抽取出的文本和理解渲染后的页面。纯文本段落并不包含列标题与单元格之间的视觉关系。反过来,如果页面布局并不重要,发送页面图像也会增加工作,却不一定改善回答。选择能保留问题所需证据的表示方式。
投机草稿器是另一个模型。 Bolt 的 LiLiCorr 草稿器会提出候选 token,再由目标模型验证。它的目的是加快解码,但额外检查点及其运行状态仍需要内存。NVIDIA 对 LiLiCorr 的说明,2026年10月15日。存在草稿器,不保证你的任务一定更快完成。
运行时工作区又是另一项开销。 prompt 处理 batch 和临时计算缓冲区都应与持久状态一起计入预算。服务器同时提供逻辑 batch size 和物理 microbatch size;这两者不能与并发对话数混为一谈。llama.cpp 服务器选项参考,查阅于 2026年10月16日。配置能够启动,并不代表它已经通过了代表性请求的测试。
官方硬件表比产品后缀更有参考价值
NVIDIA 发布的配置:
| 配方 | 硬件 | 上下文 | 序列数 |
|---|---|---|---|
| 28GB | RTX Spark 64GB 或独立 RTX 32GB+ | 65,536 | 1 |
| 32GB | RTX Spark 128GB 或独立 RTX 48GB+ | 262,144 | 1 |
来源:NVIDIA Quick Start,查阅于 2026年10月16日。
这些配置没有涵盖独立的 24GB GPU,也没有证明支持 Mac。主机 RAM 不能充当额外的独立 VRAM。
我们的看法是:选择可重复验证的配置,而不是一张成功加载的截图。如果购买决定取决于这个模型,就要求使用你的实际输入和日常后台应用进行演示。文档图像和长时间运行的 agent 尤其需要这样做,因为它们的第一个请求可能远小于之后的请求。
根据任务选择上下文,而不是一味追求最大值
下面是三个示例性起步任务,并非已报告的测试。
开发者提供错误信息、相关函数和一个相邻依赖,询问某项测试失败的原因。有用的输出应是对应具体代码行的诊断,以及建议的修改。在加入整个仓库前,先看看缺失的信息是否只是某个接口或另一段 stack frame。这样问题更容易检查,也更容易发现错误假设。
研究人员比较两页文档中的表格。这里要测试的是模型能否正确对应标题、单位、脚注和值。相关关系重要时,应使用页面图像,要求它提供逐页证据,并拿原件抽样核对单元格。即使摘要生成得很快,只要它把两列调换了,就是失败结果。
本地助手搜索经批准的文件夹并起草报告。随着检索材料和重复工具响应增加,它的内存压力也会增长。先给它一个只读任务,限制搜索范围,并要求它指出支持每项结论的文件。不要只为看看模型能否提出有用计划,就授予写入或 shell 权限。
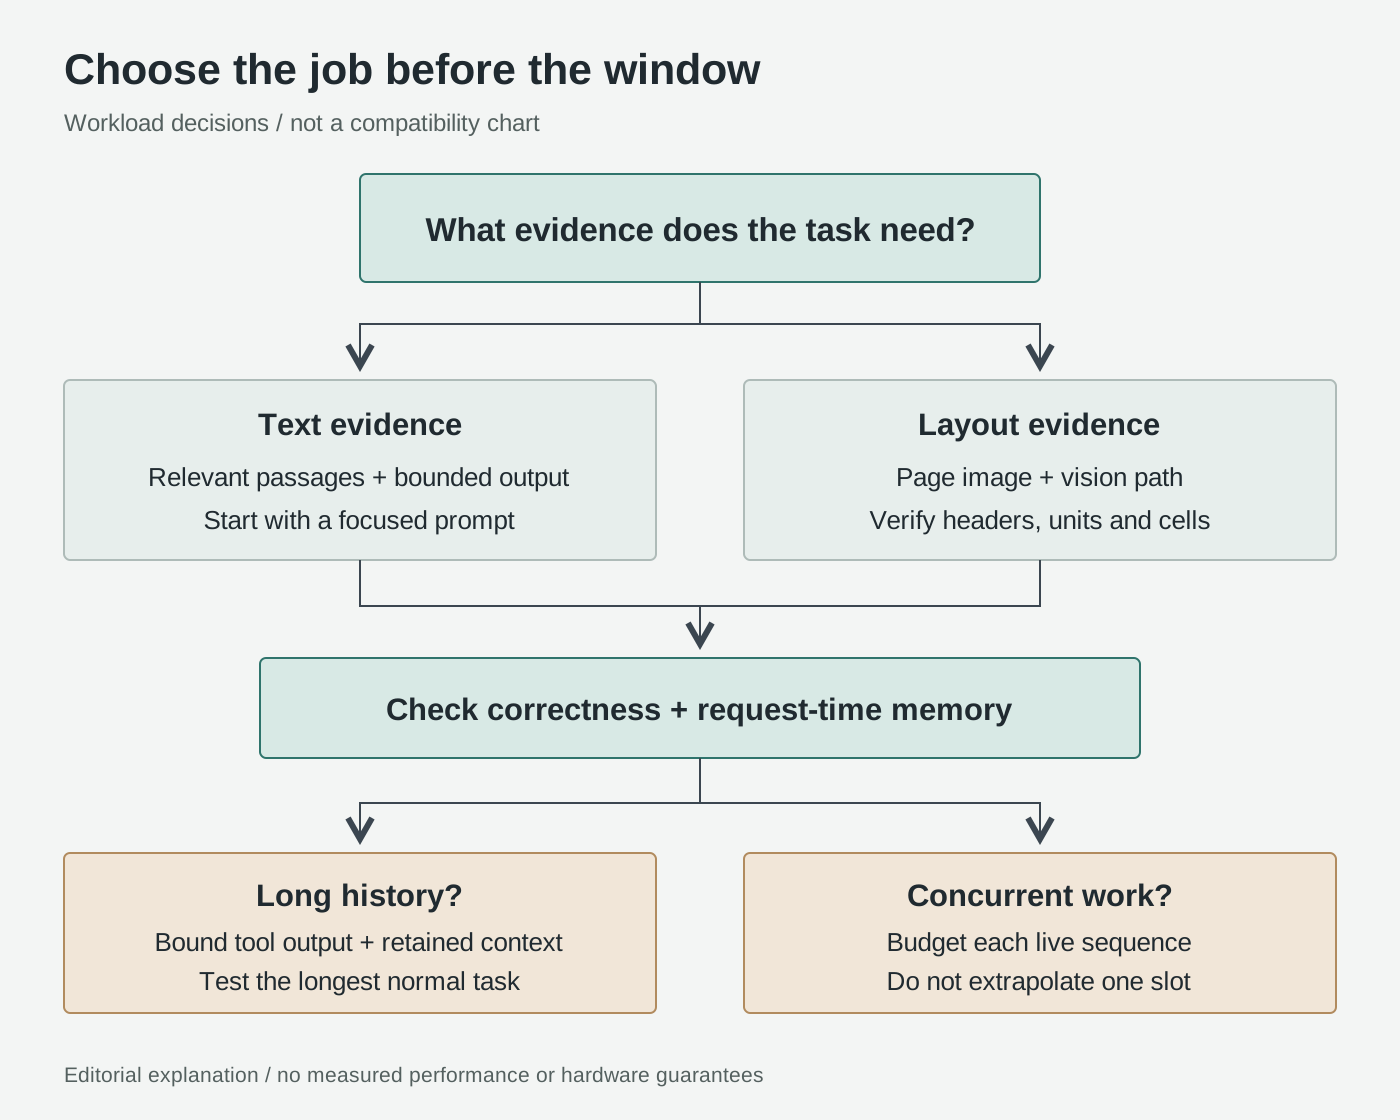
原创工作负载选择示意图,不是 benchmark 或兼容性表。另见 Hugging Face 缓存策略和 llama.cpp 多模态处理,查阅于 2026年10月16日。
量化缓存可以比高精度缓存减少存储;卸载则将压力转移至另一个内存层级,可能以吞吐量换取容量。这些是一般性取舍,并不能证明 Transformers 中每一种缓存策略都适用于此 GGUF 部署。Hugging Face 缓存策略,查阅于 2026年10月16日。
实际的优先事项是证据密度:只保留回答问题所需的材料,另外保存原件,并移除重复的结构信息。也要为回答预留空间。配置更大的窗口,不会让无关历史变得有用。
在本地启动,然后测试真正需要的工作负载
下面的 Linux Bash 示例面向受支持的 NVIDIA 独立 GPU 配置。它假设 Git、Python、CMake、C++ 工具链、兼容的 NVIDIA 驱动和 CUDA toolkit 已安装。这是供你在自己机器上执行的流程,不是已完成安装的报告。
- 构建所需运行时并检查选项。 使用源码构建流程,不要用通用模型页面的一行命令代替。按照 llama.cpp CUDA 构建指南,查阅于 2026年10月16日。将报告的 commit 和二进制版本与你的配置一起记录。
git clone https://github.com/ggml-org/llama.cpp.git
cd llama.cpp
git rev-parse HEAD
cmake -B build -DGGML_CUDA=ON -DGGML_NATIVE=ON
cmake --build build --config Release -j
./build/bin/llama-server --version
./build/bin/llama-server --help
检查帮助信息中是否包含 draft-dflash、--spec-draft-model、--spec-draft-n-max、--cache-type-k、--cache-type-v、--flash-attn 和 --jinja。仅有软件包版本标签,不能证明支持这些选项。如果你的二进制文件不接受这些选项,应先解决构建版本不匹配,再下载大型检查点;不要悄悄改用旧的投机解码参数。选项名称见当前服务器参考文档,查阅于 2026年10月16日。
- 下载 NVIDIA Quick Start,查阅于 2026年10月16日中的三个文件。 下载语法参照 Hugging Face CLI 指南,查阅于 2026年10月16日。先检查磁盘空间。
python3 -m venv .venv-hf
source .venv-hf/bin/activate
python -m pip install --upgrade huggingface_hub
MODEL_DIR="$PWD/models/nemotron-bolt"
hf download nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-GGUF \
  NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf \
  mmproj-NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf \
  --local-dir "$MODEL_DIR"
hf download nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-LiLiCorr-GGUF \
  NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-LiLiCorr.gguf \
  --local-dir "$MODEL_DIR"
MODEL="$MODEL_DIR/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf"
MMPROJ="$MODEL_DIR/mmproj-NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf"
DRAFT="$MODEL_DIR/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-LiLiCorr.gguf"
在把此设置用作比较基线前,记录仓库 revision 和本地文件 hash。之后更新文件或运行时应是有意变更,而不是两次运行之间无法解释的差异。
- 使用 NVIDIA 的 28GB 配方,并明确绑定 loopback。
./build/bin/llama-server \
  --model "$MODEL" --mmproj "$MMPROJ" \
  --batch-size 2048 --ubatch-size 512 \
  --ctx-size 65536 --parallel 1 -ngl 999 \
  --spec-type draft-dflash --spec-draft-n-max 6 \
  --spec-draft-model "$DRAFT" --spec-draft-ngl 999 \
  --cache-type-k q8_0 --cache-type-v q8_0 \
  --temp 1.0 --top-p 0.95 --flash-attn on --jinja \
  --host 127.0.0.1 --port 8080
如端口已占用,请使用空闲端口,并相应修改下方检查。首次运行时,不要创建路由器转发规则、公共 tunnel 或对外监听。Loopback 会限制网络可达范围,但不会让所连接 agent 的工具自动变得无害。
- 连接其他组件前检查就绪状态。 在另一个终端运行:
curl --fail http://127.0.0.1:8080/health
服务器文档区分加载中响应和就绪状态。就绪后,在本地打开 http://127.0.0.1:8080,先尝试简短的文本问题,再尝试图像请求。llama.cpp 服务器健康检查和 Web 界面文档,查阅于 2026年10月16日。基础回答正常之前,保持外部工具断开。
- 先测完整任务,再扩大规模。 在独立 GPU 系统上,启动前和处理代表性 prompt 时检查内存:
nvidia-smi --query-gpu=name,memory.total,memory.used,memory.free --format=csv
这些是设备读数,不等于完整的进程峰值,也不是统一内存的核算方式。NVIDIA 在 NVIDIA System Management Interface 参考文档中说明了依平台而异的内存报告方式。也要保留运行时分配日志,并单独检查主机内存。
比较短 prompt、你最长的常规 prompt,以及一张有代表性的文档图像。记录正确性、完成时间、内存读数和任何分配失败。打开平常使用的编辑器和浏览器后再重复。如果只有关闭其余工作环境才能运行,就没有满足最初要求。
如果失败,每次只改变一个因素,并命名新配置。减少 context、microbatch size 或工具历史量,回答的是不同问题;移除草稿器则是另一项实验,不是已发布配方。保留失败记录和触发失败的输入,避免之后一次短 prompt 成功就掩盖尚未解决的工作负载。
结论:按工作集购买
Bolt 的亮点,是一个大型、稀疏激活、为本地工作而压缩的模型。它的实际价值取决于模型之外还能容纳什么:完成任务所需的证据、视觉输入、序列状态和应用。
正确的验收问题不是“24GB 模型能否加载?”而是“这台具体机器能否可靠地完成我的日常工作负载,并为下一轮留出足够空间?”这才是值得购买的内存预算。
来源
发布信息日期为 2026年10月15日;链接中的模型卡和动态文档于 2026年10月16日 查阅。操作流程是改编后的说明,不是动手测试结果。原创图示用于解释概念,不是官方素材或性能图表。
- NVIDIA 发布公告,介绍三个模型名称和发布时间。
- NVIDIA Bolt 研究概览和技术报告,说明压缩、精度和估算的内存拆分。
- NVIDIA GGUF 模型卡,列出实际硬件表、检查点文件名和启动配方。
- llama.cpp 构建、服务器、多模态和 GGUF 工具文档,说明运行时行为。
- Hugging Face 缓存说明、缓存策略、CLI 指南以及 NVIDIA SMI 参考,说明具体机制和检查命令。
可选的 Telli.sh 推荐:保存决策背后的来源
比较 agent 时,最好把原始来源、笔记和自己的试用结果放在一起。创建 Telli.sh 账户,将这些材料整理成产品变化后仍可回看的参考资料。