Um modelo de 24GB não é um computador de 24GB: o orçamento de memória do Nemotron Bolt
Entenda os 74B parâmetros totais e 9B ativos do Nemotron Bolt, os pesos nativos de 2 bits e a memória exigida pelas receitas locais para contexto, visão, modelo draft e runtime.
Você tem uma GPU com 24GB de memória. Um novo modelo traz “24GB” no nome. Será que esses dois números bastam para decidir a compra?
Não quando se trata de uma carga completa de IA local. O anúncio da NVIDIA de 15 de outubro apresentou o Nemotron 3.5 Bolt 74B-A9B 24GB como um modelo de linguagem e visão implantável localmente que usa quantização nativa de 2 bits. O nome descreve uma meta de otimização, não uma promessa de que qualquer tamanho de contexto, solicitação com imagem e configuração de agente caiba em uma placa gráfica de 24GB. Anúncio da NVIDIA, 15 de outubro de 2026.
A pergunta útil é o que sobra depois que o modelo é carregado. Este guia separa parâmetros armazenados de computação ativa, explica os outros consumidores de memória e percorre uma configuração restrita ao loopback baseada na receita real do cartão do modelo. Comece pela carga de que você precisa e depois decida se a máquina consegue sustentá-la.
Hero: explicação editorial original de um orçamento para toda a carga de trabalho, não uma captura de tela oficial nem uma alocação medida. Os tamanhos dos componentes não estão representados.
A contagem ativa menor não transforma isto em um download de 9B
O Bolt tem 74 bilhões de parâmetros no total e cerca de 9 bilhões ativos por token. O roteador mixture-of-experts seleciona parte da rede armazenada. Ele é um descendente comprimido do Super VL 120B-A12B, não um modelo denso de 9B. Visão geral de pesquisa da NVIDIA sobre o Bolt, 15 de outubro de 2026.
Guarde esta distinção: parâmetros ativos ajudam a explicar o trabalho feito para um token; parâmetros totais ajudam a explicar o que precisa ser armazenado. Nenhum dos dois números, isoladamente, determina a velocidade do aplicativo. Posicionamento, largura de banda da memória, kernels, tamanho da entrada e o aplicativo ao redor afetam o resultado.
Um agente que revisa código ainda precisa acessar especialistas que não foram selecionados para o token anterior. Mover dados entre armazenamento, memória do sistema e memória da GPU não equivale a ter tudo disponível no acelerador. Portanto, uma contagem ativa menor não autoriza calcular o requisito de hardware como se os parâmetros restantes não existissem.
Os nomes da família também merecem uma comparação precisa:
| Modelo | A que o nome se refere | Situação em 16 de outubro |
|---|---|---|
| Nemotron 3.5 Super VL | O modelo separado de 120B | Lançado |
| Nemotron 3.5 Bolt 74B-A9B 24GB | A opção de modelo local comprimido discutida aqui | Lançado |
| Nemotron 3.5 Bolt E4B 4GB | Outra oferta menor para edge/conversação | Anunciada para 23 de outubro |
As situações de lançamento vêm do anúncio de 15 de outubro. Na data deste artigo, o E4B é uma disponibilidade futura, não um substituto já disponível demonstrado por estes comandos. Os resultados de implantação empresarial do Super VL também não devem ser interpretados como resultados do Bolt em desktop.
Pesos nativos de 2 bits resolvem apenas parte do orçamento
“Nativo de 2 bits” importa porque a compressão agressiva faz parte do desenvolvimento do modelo; não é apenas uma escolha posterior do usuário por uma exportação menor. A NVIDIA usa destilação com reconhecimento de quantização para recuperar capacidade após reduzir a precisão. Os pesos dos especialistas usam IQ2_XXS a 2.0625 bits por elemento, enquanto outros componentes mantêm formatos diferentes. A rede tem precisão mista, não dois bits uniformes em tudo. Explicação da NVIDIA sobre compressão e quantização, 15 de outubro de 2026.
Como uma conta propositalmente irrealista, 74 bilhões de valores armazenados exatamente a dois bits ocupariam 18.5 bilhões de bytes. Isso é uma ilustração, não o tamanho do arquivo nem o requisito de inicialização do Bolt: a conta ignora a mistura real de precisões, os metadados e o estado de execução. Multiplicar a contagem de parâmetros da manchete pela profundidade em bits da manchete não substitui a inspeção de um checkpoint específico.
GGUF responde a outra pergunta. É o formato de arquivo de modelo usado pelo ecossistema llama.cpp, com tensores e informações associadas. Não é uma segunda promessa de compressão somada aos “2 bits”, e baixar um GGUF não comprova, por si só, que determinado runtime entenda o modelo. Documentação das ferramentas GGUF do llama.cpp, consultada em 16 de outubro de 2026.
A estimativa de memória da própria NVIDIA torna a distinção concreta: a Tabela 2 lista 22.01GB para os pesos, 23.83GB no total sem visão e mais 1.68GB para o encoder e o projetor de visão. São estimativas do fornecedor para a configuração do relatório, não medições de memória feitas para este artigo. O mesmo relatório descreve uma meta de projeto abaixo de 24GB com batch size um e contexto 128K. Relatório técnico do Bolt, Tabela 2 e Seção 2.3, vinculado em 15 de outubro de 2026.
A conclusão não é que a marca esteja escondendo um número que considere apenas os pesos. É que uma meta de implantação pressupõe certas condições. Mude essas condições e o requisito de memória também muda.
Reserve espaço para todo o working set, não só para os pesos
Pense na implantação como um imposto de contexto sobre o modelo armazenado: o trabalho que você pede ao sistema para reter e processar também precisa de espaço. Para planejar, separe pesos, estado das sequências, processamento de visão, decodificação especulativa e área de trabalho do runtime. Deixe folga adicional para o desktop e os aplicativos que você pretende manter abertos.
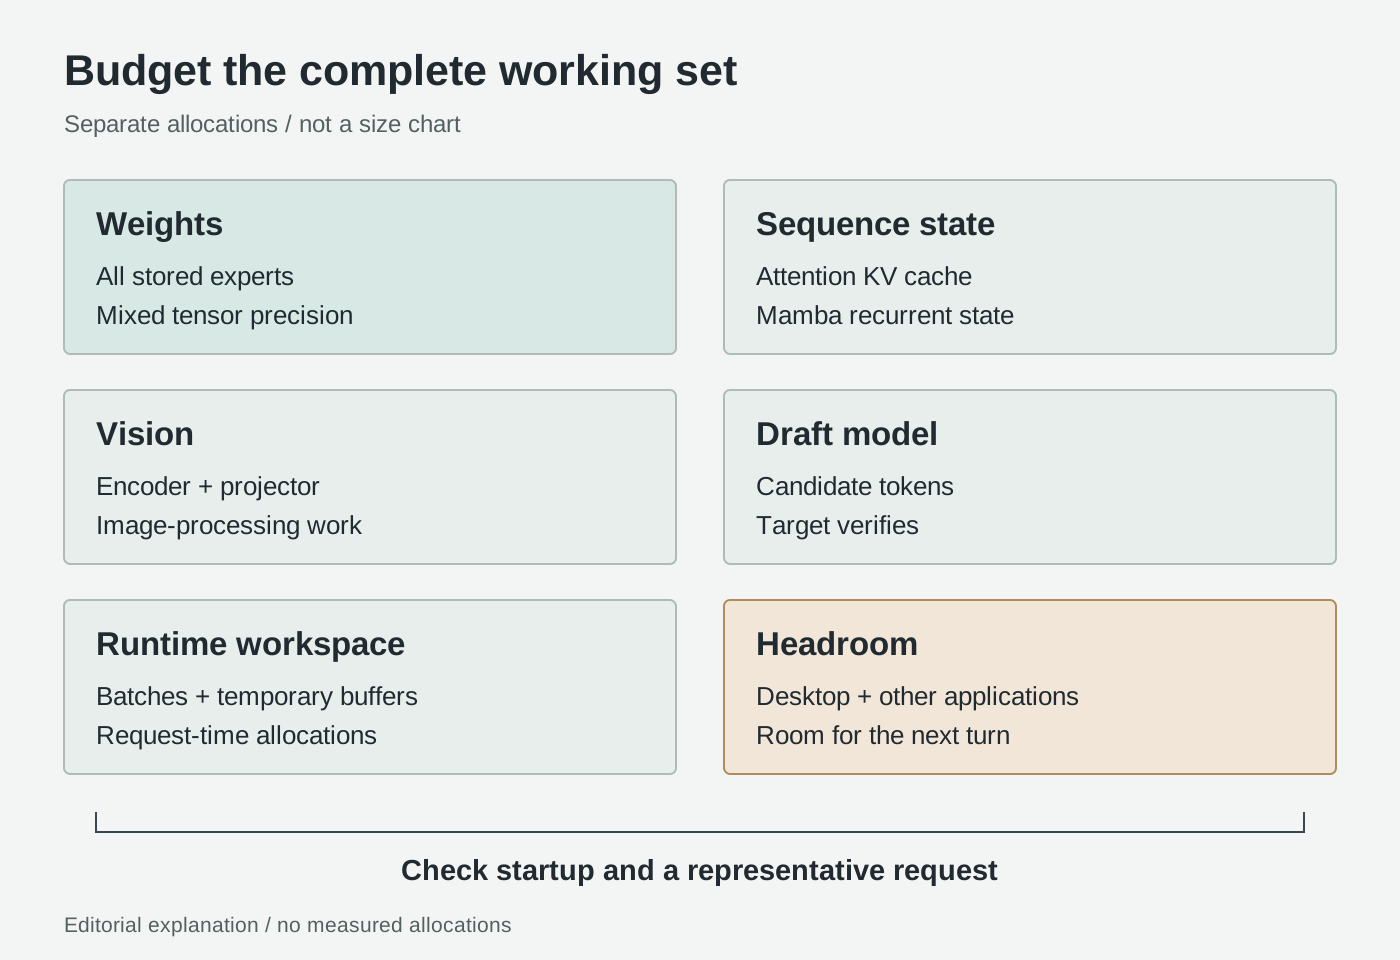
Explicação editorial original, sem proporções medidas. Mecanismos: documentação de cache da Hugging Face, guia multimodal do llama.cpp e relatório do Bolt da NVIDIA, consultados em 16 de outubro de 2026.
O estado das sequências não é outra cópia dos pesos. Um modelo autoregressivo com atenção armazena chaves e valores de tokens anteriores para reutilizá-los durante a geração. Sequências retidas mais longas exigem mais espaço para o cache de atenção, e os detalhes dependem da arquitetura e da representação do cache. Hugging Face, “Como funciona o cache”, consultado em 16 de outubro de 2026.
O Bolt é híbrido, com camadas Mamba e de atenção; por isso, uma estimativa genérica de cache para um modelo inteiramente Transformer não basta para calculá-lo. Estado recorrente e caches de atenção são alocações distintas: confira o que o runtime realmente cria. A distinção arquitetural está documentada na Tabela 1 do relatório do Bolt, consultada em 16 de outubro de 2026.
Para um agente, contexto retido é mais que a pergunta que você digitou. Instruções de sistema, esquemas das ferramentas, histórico da conversa, trechos recuperados e respostas das ferramentas competem pelo espaço que também precisa acomodar a resposta. Uma transcrição com listagens repetidas do repositório pode esgotar um orçamento útil sem acrescentar evidências relevantes. Manter conciso o estado da tarefa é uma decisão de fluxo de trabalho, não apenas uma solução alternativa de hardware.
A visão introduz um caminho de processamento separado. O llama.cpp associa o modelo de linguagem a um arquivo de projetor multimodal por meio de --mmproj; a documentação informa que esse componente é transferido para a GPU por padrão. Guia multimodal do llama.cpp, consultado em 16 de outubro de 2026. Carregar somente o arquivo do modelo de linguagem, portanto, não equivale a uma configuração completa com capacidade de imagem.
Em uma tarefa com documentos, diferencie ler o texto extraído de interpretar uma página renderizada. Um parágrafo em texto simples não contém a relação visual entre o cabeçalho de uma coluna e suas células. Por outro lado, enviar imagens de páginas cujo layout não importa acrescenta trabalho sem necessariamente melhorar a resposta. Decida qual representação preserva as evidências necessárias para sua pergunta.
Um modelo draft especulativo é um modelo adicional. O draft LiLiCorr do Bolt propõe tokens candidatos para o modelo-alvo verificar. Ele foi pensado para acelerar a decodificação, mas o checkpoint adicional e seu estado de execução também precisam de memória. Explicação da NVIDIA sobre o LiLiCorr, 15 de outubro de 2026. A presença de um draft não garante conclusão mais rápida das suas tarefas.
A área de trabalho do runtime é outro componente. Lotes de processamento de prompts e buffers temporários de computação entram no orçamento junto ao estado persistente. O servidor expõe tanto o tamanho lógico do batch quanto o tamanho físico do microbatch; eles não equivalem ao número de conversas simultâneas. Referência das opções do servidor llama.cpp, consultada em 16 de outubro de 2026. Mesmo uma configuração que inicia precisa ser testada durante uma solicitação representativa.
A tabela oficial de hardware é mais útil do que o sufixo do produto
Configurações publicadas pela NVIDIA:
| Receita | Hardware | Contexto | Sequências |
|---|---|---|---|
| 28GB | RTX Spark 64GB ou RTX discreta de 32GB+ | 65,536 | 1 |
| 32GB | RTX Spark 128GB ou RTX discreta de 48GB+ | 262,144 | 1 |
Fonte: Guia rápido da NVIDIA, consultado em 16 de outubro de 2026.
Essas linhas não cobrem uma GPU discreta de 24GB nem comprovam suporte a Mac. A RAM do host não é VRAM discreta adicional.
Nossa avaliação: escolha uma configuração reproduzível, não uma captura de tela de carregamento bem-sucedido. Se uma compra depende deste modelo, exija uma demonstração com suas entradas pretendidas e os aplicativos comuns em segundo plano. Isso é especialmente importante para imagens de documentos e agentes de longa duração, cujas primeiras solicitações podem ser bem menores que as seguintes.
Escolha o contexto conforme a tarefa, não o máximo
Considere três tarefas iniciais ilustrativas, não testes relatados.
Um desenvolvedor pede uma explicação para um teste com falha e fornece o erro, a função relevante e uma dependência próxima. Uma resposta útil é um diagnóstico associado a linhas específicas, seguido de uma alteração proposta. Antes de incluir o repositório inteiro, verifique se falta uma interface específica ou outro frame da stack. Isso mantém a pergunta inspecionável e facilita encontrar suposições incorretas.
Um pesquisador compara uma tabela em duas páginas de um documento. O teste é verificar se o modelo associa corretamente cabeçalhos, unidades, notas de rodapé e valores. Use as imagens reais das páginas quando essas relações forem importantes, peça evidências específicas por página e confira uma amostra das células no original. Um resumo fluente que troca duas colunas é um resultado ruim, mesmo que chegue rapidamente.
Um assistente local pesquisa uma pasta aprovada e prepara um rascunho de relatório. A pressão sobre a memória pode crescer com o material recuperado e as respostas repetidas das ferramentas. Dê a ele primeiro uma tarefa somente de leitura, limite a busca e peça que identifique os arquivos que sustentam cada conclusão. Não conceda permissões de escrita ou shell apenas para ver se o modelo consegue produzir um plano útil.
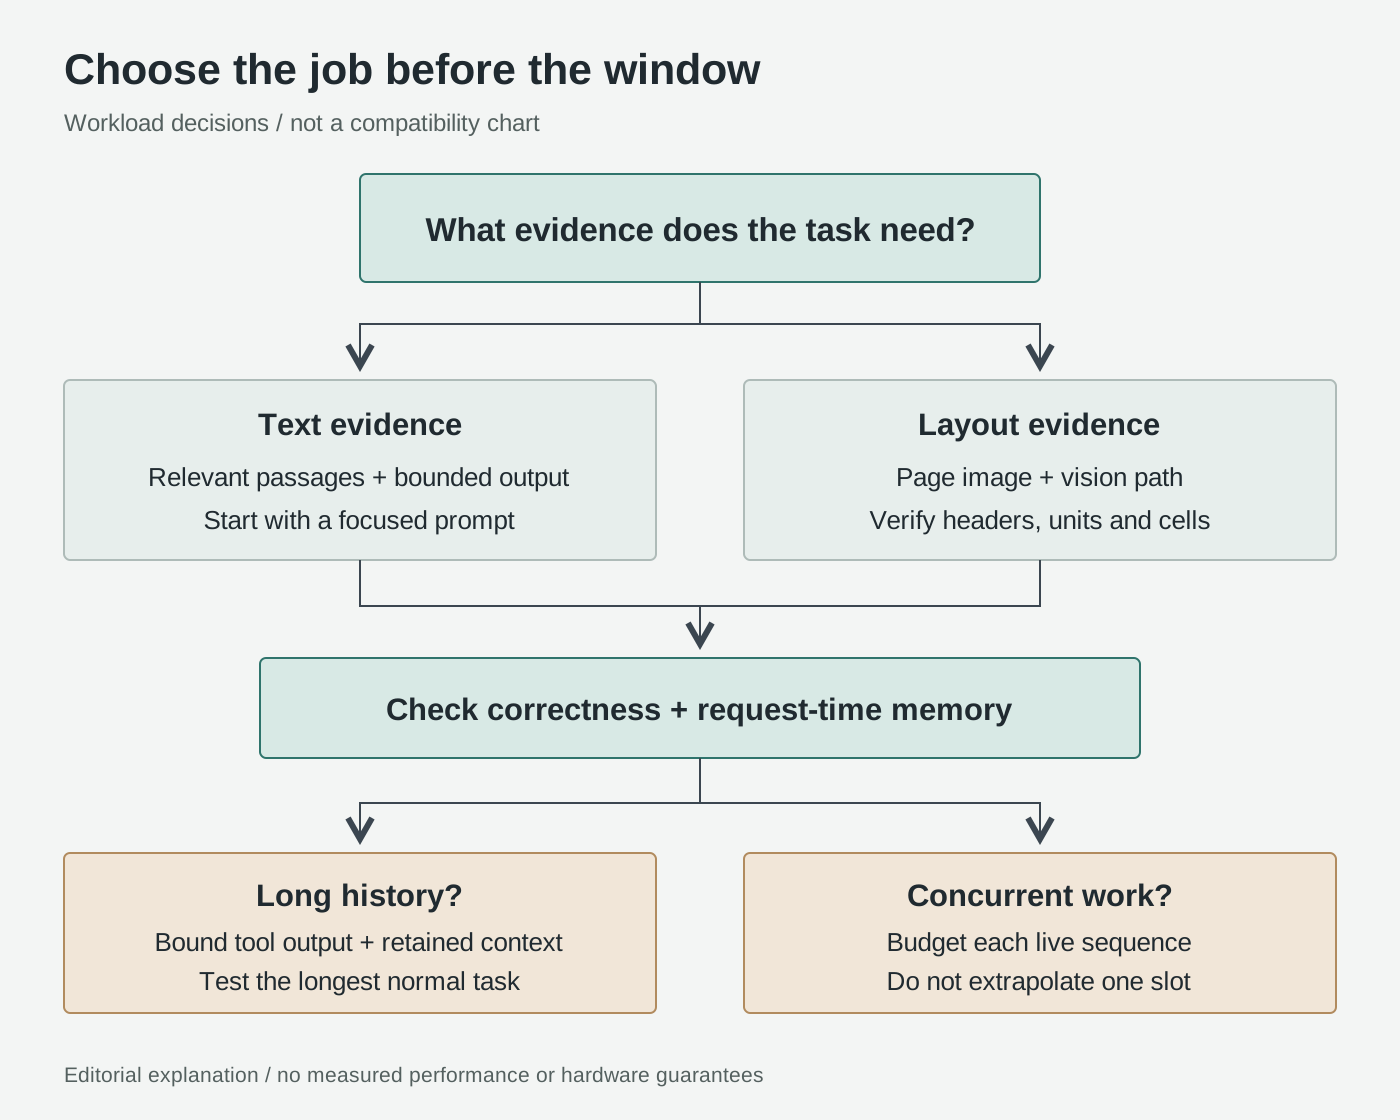
Explicação editorial original da escolha da carga, não um benchmark nem uma tabela de compatibilidade. Consulte as estratégias de cache da Hugging Face e o tratamento multimodal do llama.cpp, consultados em 16 de outubro de 2026.
Caches quantizados podem reduzir o armazenamento em relação a caches de maior precisão, enquanto o offloading desloca a pressão para outra camada de memória e pode trocar throughput por capacidade. São compromissos gerais, não evidência de que toda estratégia de cache do Transformers esteja disponível para esta implantação GGUF. Estratégias de cache da Hugging Face, consultadas em 16 de outubro de 2026.
A prioridade prática é a densidade de evidências: mantenha o material necessário para responder à pergunta, preserve os originais separadamente e remova elementos repetidos de estrutura. Reserve espaço também para a resposta. Uma janela configurada maior não torna útil um histórico irrelevante.
Comece localmente e teste a carga de que você realmente precisa
O exemplo de Bash para Linux a seguir destina-se a uma configuração compatível com GPU NVIDIA discreta. Ele pressupõe que Git, Python, CMake, uma toolchain de C++, um driver NVIDIA compatível e o toolkit CUDA já estejam instalados. É um procedimento para executar na sua máquina, não o relato de uma instalação concluída.
- Compile o runtime relevante e confira as opções. Use o caminho de compilação a partir do código-fonte, não uma linha genérica copiada da página do modelo. Siga o guia de compilação CUDA do llama.cpp, consultado em 16 de outubro de 2026. Guarde o commit informado e a versão do binário junto à configuração.
git clone https://github.com/ggml-org/llama.cpp.git
cd llama.cpp
git rev-parse HEAD
cmake -B build -DGGML_CUDA=ON -DGGML_NATIVE=ON
cmake --build build --config Release -j
./build/bin/llama-server --version
./build/bin/llama-server --help
Confira se a ajuda inclui draft-dflash, --spec-draft-model, --spec-draft-n-max, --cache-type-k, --cache-type-v, --flash-attn e --jinja. O rótulo da versão de um pacote, sozinho, não comprova o suporte. Se o binário rejeitar as opções, resolva a incompatibilidade da compilação antes de baixar checkpoints grandes; não substitua silenciosamente a receita por flags antigas de decodificação especulativa. Os nomes das opções estão documentados na referência atual do servidor, consultada em 16 de outubro de 2026.
- Baixe os três arquivos do Guia rápido da NVIDIA, consultado em 16 de outubro de 2026. A sintaxe de download segue o guia da CLI da Hugging Face, consultado em 16 de outubro de 2026. Confira o espaço em disco primeiro.
python3 -m venv .venv-hf
source .venv-hf/bin/activate
python -m pip install --upgrade huggingface_hub
MODEL_DIR="$PWD/models/nemotron-bolt"
hf download nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-GGUF \
  NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf \
  mmproj-NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf \
  --local-dir "$MODEL_DIR"
hf download nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-LiLiCorr-GGUF \
  NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-LiLiCorr.gguf \
  --local-dir "$MODEL_DIR"
MODEL="$MODEL_DIR/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf"
MMPROJ="$MODEL_DIR/mmproj-NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf"
DRAFT="$MODEL_DIR/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-LiLiCorr.gguf"
Registre as revisões dos repositórios e os hashes dos arquivos locais antes de usar esta configuração como referência de comparação. Uma atualização posterior do arquivo ou do runtime deve ser uma mudança deliberada, não uma diferença inexplicada entre duas execuções.
- Use a receita de 28GB da NVIDIA com binding explícito em loopback.
./build/bin/llama-server \
  --model "$MODEL" --mmproj "$MMPROJ" \
  --batch-size 2048 --ubatch-size 512 \
  --ctx-size 65536 --parallel 1 -ngl 999 \
  --spec-type draft-dflash --spec-draft-n-max 6 \
  --spec-draft-model "$DRAFT" --spec-draft-ngl 999 \
  --cache-type-k q8_0 --cache-type-v q8_0 \
  --temp 1.0 --top-p 0.95 --flash-attn on --jinja \
  --host 127.0.0.1 --port 8080
Se necessário, use uma porta livre e ajuste a verificação abaixo. Não crie uma regra de encaminhamento no roteador, túnel público ou listener vinculado externamente para esta primeira execução. O loopback limita o alcance pela rede; não torna inofensivas as ferramentas de um agente conectado.
- Confira se está pronto antes de conectar qualquer outra coisa. Em outro terminal, execute:
curl --fail http://127.0.0.1:8080/health
A documentação do servidor diferencia uma resposta de carregamento de uma resposta pronta. Quando estiver pronto, abra http://127.0.0.1:8080 localmente e teste uma pergunta curta de texto antes de uma solicitação com imagem. Documentação de saúde do servidor e interface web do llama.cpp, consultada em 16 de outubro de 2026. Mantenha as ferramentas externas desconectadas até as respostas básicas funcionarem.
- Meça a tarefa completa antes de ampliá-la. Em um sistema com GPU discreta, inspecione a memória antes da inicialização e durante prompts representativos:
nvidia-smi --query-gpu=name,memory.total,memory.used,memory.free --format=csv
Essas são observações do dispositivo, não o pico completo do processo nem um método de contabilização de memória unificada. A NVIDIA documenta a medição de memória dependente da plataforma na referência da NVIDIA System Management Interface, consultada em 16 de outubro de 2026. Guarde também os logs de alocação do runtime e inspecione separadamente a memória do host.
Compare um prompt curto, o prompt mais longo que você costuma usar e uma imagem representativa de documento. Registre correção, tempo de conclusão, observações de memória e eventuais falhas de alocação. Repita com o editor e o navegador normalmente abertos. Uma configuração que só funciona depois de fechar o restante do ambiente de trabalho não atende ao requisito original.
Se falhar, altere um fator de cada vez e identifique a nova configuração. Reduzir contexto, tamanho do microbatch ou volume do histórico de ferramentas responde a perguntas diferentes; remover o draft é outro experimento, não a receita publicada. Preserve a falha e a entrada que a provocou para que um prompt curto bem-sucedido depois não apague a carga ainda não resolvida.
Em resumo: compre para o working set
A proposta interessante do Bolt é um modelo grande, ativado esparsamente e comprimido para trabalho local. Seu valor prático depende do que cabe junto com ele: as evidências, as entradas visuais, o estado das sequências e os aplicativos necessários para concluir sua tarefa.
A pergunta certa de aceitação não é “O modelo de 24GB carregou?”. É “Esta máquina específica consegue concluir minha carga normal, com respostas confiáveis e espaço suficiente para o próximo turno?”. Esse é o orçamento de memória que vale a pena comprar.
Fontes
As informações de lançamento são de 15 de outubro de 2026; os cartões de modelo vinculados e a documentação em evolução foram consultados em 16 de outubro de 2026. Os procedimentos são instruções adaptadas, não resultados de testes práticos. Os diagramas originais são esquemas explicativos, não recursos oficiais nem gráficos de desempenho.
- Anúncio de lançamento da NVIDIA para os nomes dos três modelos e o cronograma de lançamento.
- Visão geral de pesquisa da NVIDIA sobre o Bolt e relatório técnico para compressão, precisão e detalhamento estimado da memória.
- Cartão GGUF do modelo da NVIDIA para a tabela de hardware real, nomes de arquivos dos checkpoints e receita de inicialização.
- Compilação do llama.cpp, servidor, multimodal e documentação das ferramentas GGUF para o comportamento do runtime.
- Explicação de cache da Hugging Face, estratégias de cache, guia da CLI e referência NVIDIA SMI para os mecanismos e comandos de inspeção específicos.
Reúna as fontes por trás das suas decisões
Comparar agentes fica mais fácil quando as fontes originais, suas notas e os resultados dos seus próprios testes ficam juntos. Crie uma conta Telli.sh para organizar esse material em uma referência à qual você pode voltar conforme os produtos mudam.