Ein 24GB-Modell ist kein 24GB-Computer: Nemotron Bolts Speicherbudget
Verstehen Sie Nemotron Bolts 74B Gesamt- und 9B aktive Parameter, native 2-Bit-Gewichte sowie den Speicherbedarf für Kontext, Vision, Draft-Modell und Laufzeit bei lokalen Rezepten.
Ihre GPU hat 24GB Speicher. Ein neues Modell trägt „24GB“ im Namen. Damit ist die Kaufentscheidung doch klar, oder?
Nicht für eine vollständige lokale KI-Arbeitslast. NVIDIA kündigte am October 15 Nemotron 3.5 Bolt 74B-A9B 24GB an: ein lokal einsetzbares Vision-Language-Modell mit nativer 2-Bit-Quantisierung. Der Name bezeichnet ein Optimierungsziel, keine Garantie, dass jede Kontextlänge, Bildanfrage und Agent-Konfiguration in eine Grafikkarte mit 24GB passt. NVIDIA-Ankündigung, 15. Oktober 2026.
Die entscheidende Frage ist, was nach dem Laden des Modells noch übrig bleibt. Dieser Leitfaden trennt gespeicherte Parameter von aktiver Berechnung, erläutert weitere Speicherverbraucher und führt durch eine ausschließlich an Loopback gebundene Einrichtung nach dem tatsächlichen Rezept der Modellkarte. Beginnen Sie mit Ihrer Arbeitslast und prüfen Sie dann, ob der Rechner sie dauerhaft bewältigen kann.
Titelbild: originale redaktionelle Erläuterung eines Budgets für die gesamte Arbeitslast, kein offizieller Screenshot und keine gemessene Speicherbelegung. Die Größen der Komponenten werden nicht dargestellt.
Die geringere Zahl aktiver Parameter macht daraus keinen 9B-Download
Bolt hat insgesamt 74 Milliarden Parameter und ungefähr 9 Milliarden pro Token aktive Parameter. Sein Mixture-of-Experts-Router wählt einen Teil des gespeicherten Netzwerks aus. Es ist ein komprimierter Nachfolger von 120B-A12B Super VL, kein dichtes 9B-Modell. NVIDIA-Bolt-Forschungsübersicht, 15. Oktober 2026.
Merken Sie sich den Unterschied: Aktive Parameter helfen zu erklären, welche Arbeit pro Token anfällt; die Gesamtzahl der Parameter hilft zu erklären, was gespeichert werden muss. Keine der Zahlen bestimmt allein die Anwendungsgeschwindigkeit. Platzierung, Speicherbandbreite, Kernels, Eingabelänge und die umgebende Anwendung beeinflussen das Ergebnis.
Ein Agent, der Code prüft, braucht weiterhin Zugriff auf Experten, die beim vorherigen Token nicht ausgewählt wurden. Daten zwischen Speicher, Systemspeicher und GPU-Speicher zu verschieben ist nicht dasselbe, wie alles auf dem Beschleuniger verfügbar zu haben. Eine geringere Zahl aktiver Parameter erlaubt daher nicht, den Hardwarebedarf so zu berechnen, als existierten die übrigen Parameter nicht.
Die Modellfamilie verdient einen präzisen Vergleich:
| Modell | Worauf sich der Name bezieht | Status am October 16 |
|---|---|---|
| Nemotron 3.5 Super VL | Das separate 120B-Modell | Veröffentlicht |
| Nemotron 3.5 Bolt 74B-A9B 24GB | Die hier besprochene komprimierte lokale Modelloption | Veröffentlicht |
| Nemotron 3.5 Bolt E4B 4GB | Ein separates, kleineres Edge-/Konversationsangebot | Ankündigung für October 23 |
Die Veröffentlichungsstände stammen aus der Ankündigung vom October 15. Zum Datum dieses Artikels ist E4B erst künftig verfügbar und kein durch diese Befehle demonstrierter Ersatz. Ebenso sind die Enterprise-Bereitstellungsergebnisse von Super VL nicht als Desktop-Ergebnis von Bolt zu verstehen.
Native 2-Bit-Gewichte lösen nur einen Teil des Budgets
„Native 2-Bit“ ist relevant, weil die aggressive Komprimierung Teil der Modellentwicklung ist und nicht nur eine nachträgliche Auswahl eines kleineren Exports durch den Nutzer. NVIDIA verwendet quantisierungsbewusste Destillation, um nach der Präzisionsreduktion Fähigkeiten zurückzugewinnen. Die Expert-Gewichte verwenden IQ2_XXS mit 2.0625 bits pro Element; andere Komponenten behalten andere Formate. Das Netzwerk arbeitet mit gemischter Präzision und nicht überall einheitlich mit zwei Bits. NVIDIAs Erläuterung zu Komprimierung und Quantisierung, 15. Oktober 2026.
Als bewusst unrealistische Überschlagsrechnung: 74 Milliarden Werte würden bei exakt zwei Bits pro Wert 18.5 Milliarden Bytes belegen. Das ist eine Veranschaulichung, weder Bolts Dateigröße noch seine Startanforderung; die tatsächliche Mischung der Präzisionen, Metadaten und Ausführungszustand bleiben unberücksichtigt. Eine prominente Parameterzahl mit einer prominenten Bitzahl zu multiplizieren ersetzt nicht die Prüfung eines konkreten Checkpoints.
GGUF beantwortet eine andere Frage. Es ist das Modell-Dateiformat des llama.cpp-Ökosystems und enthält Tensoren samt zugehörigen Informationen. Es ist keine zusätzliche Komprimierungszusage neben „2-Bit“; ein GGUF-Download belegt auch nicht, dass eine bestimmte Laufzeit das Modell unterstützt. Dokumentation der llama.cpp-GGUF-Werkzeuge, eingesehen am 16. Oktober 2026.
NVIDIAs eigene geschätzte Speicheraufteilung macht den Unterschied konkret: Tabelle 2 nennt 22.01GB für die Gewichte, insgesamt 23.83GB ohne Vision und weitere 1.68GB für Vision-Encoder und Projektor. Das sind Herstellerschätzungen für die Konfiguration des Berichts, keine Speichermessungen dieses Artikels. Derselbe Bericht beschreibt ein Designziel unter 24GB bei batch size one und 128K context. Bolt-Technikbericht, Tabelle 2 und Abschnitt 2.3, verlinkt am 15. Oktober 2026.
Die Erkenntnis ist nicht, dass die Produktbezeichnung insgeheim nur die Gewichte meint. Entscheidend ist, dass ein Bereitstellungsziel Annahmen enthält. Ändern sich diese, ändert sich auch der Speicherbedarf.
Planen Sie für den gesamten Arbeitssatz, nicht nur für die Gewichte
Betrachten Sie die Bereitstellung als Kontextsteuer zusätzlich zum gespeicherten Modell: Auch die Arbeit, die das System behalten und verarbeiten soll, braucht Platz. Für die Planung sollten Sie Gewichte, Sequenzzustand, Bildverarbeitung, spekulatives Decoding und Laufzeit-Arbeitsbereich getrennt betrachten. Lassen Sie außerdem Reserve für den Desktop und die Anwendungen, die Sie tatsächlich geöffnet halten wollen.
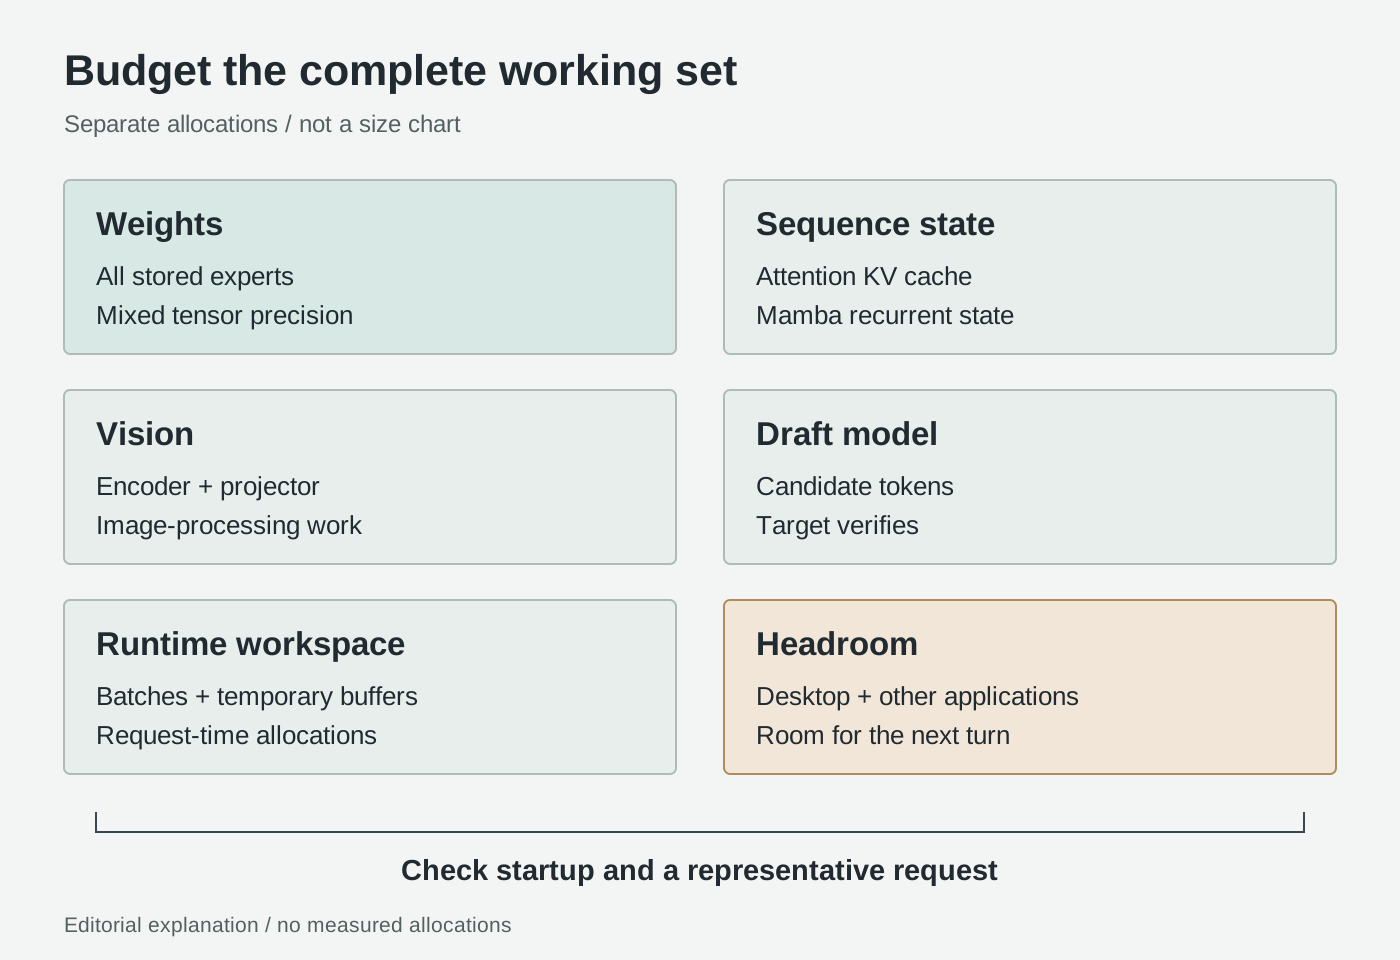
Originale redaktionelle Erläuterung, keine gemessenen Größenverhältnisse. Mechanismen: Hugging-Face-Dokumentation zum Caching, llama.cpp-Multimodal-Leitfaden und NVIDIA-Bolt-Bericht, eingesehen am 16. Oktober 2026.
Sequenzzustand ist keine weitere Kopie der Gewichte. Ein autoregressives Attention-Modell speichert Keys und Values früherer Tokens im Cache, um sie bei der Generierung wiederzuverwenden. Längere gespeicherte Sequenzen benötigen mehr Attention-Cache-Speicher; die Details hängen von Architektur und Cache-Darstellung ab. Hugging Face, „How caching works“, eingesehen am 16. Oktober 2026.
Bolt kombiniert Mamba- und Attention-Layer; deshalb ist eine allgemeine Cache-Schätzung für reine Transformer kein vollständiger Rechner dafür. Rekurrenter Zustand und Attention-Caches sind getrennte Belegungen. Prüfen Sie, was die Laufzeit tatsächlich anlegt. Der Architekturunterschied ist in Tabelle 1 des Bolt-Berichts dokumentiert, eingesehen am 16. Oktober 2026.
Bei einem Agent umfasst der gespeicherte Kontext mehr als die eingegebene Frage. Systemanweisungen, Tool-Schemas, Gesprächsverlauf, abgerufene Passagen und Tool-Antworten konkurrieren um Platz, der auch für die Antwort benötigt wird. Ein Transkript mit wiederholten Repository-Auflistungen kann ein brauchbares Budget erschöpfen, ohne nützliche Belege hinzuzufügen. Einen knappen Aufgabenstand zu erhalten ist eine Workflow-Entscheidung und nicht nur ein Hardware-Kniff.
Vision bringt einen eigenen Verarbeitungspfad mit. llama.cpp koppelt über --mmproj das Sprachmodell mit einer multimodalen Projektordatei; laut Dokumentation wird diese Komponente standardmäßig auf die GPU ausgelagert. llama.cpp-Multimodal-Leitfaden, eingesehen am 16. Oktober 2026. Nur die Sprachmodelldatei zu laden, entspricht somit nicht einer vollständigen bildfähigen Einrichtung.
Bei einer Dokumentaufgabe sollten Sie das Lesen extrahierten Textes vom Interpretieren einer gerenderten Seite unterscheiden. Ein reiner Textabsatz enthält nicht die visuelle Beziehung zwischen Spaltenüberschrift und Zellen. Umgekehrt verursachen Bilder von Seiten, deren Layout keine Rolle spielt, zusätzliche Arbeit, ohne die Antwort zwingend zu verbessern. Entscheiden Sie, welche Darstellung die für Ihre Frage nötigen Belege erhält.
Ein spekulativer Draft-Generator ist ein zusätzliches Modell. Bolts LiLiCorr-Draft-Generator schlägt mögliche Tokens vor, die das Zielmodell anschließend überprüft. Er soll das Decoding beschleunigen, aber auch der zusätzliche Checkpoint und sein Ausführungszustand benötigen Speicher. NVIDIAs Erläuterung zu LiLiCorr, 15. Oktober 2026. Ein Draft-Generator garantiert keine schnellere Erledigung Ihrer Aufgaben.
Der Laufzeit-Arbeitsbereich kommt noch hinzu. Prompt-Verarbeitungs-Batches und temporäre Rechenpuffer gehören neben dem dauerhaften Zustand ins Budget. Der Server legt sowohl eine logische Batch-Größe als auch eine physische Microbatch-Größe fest; diese sind nicht mit der Zahl gleichzeitiger Gespräche austauschbar. Referenz der llama.cpp-Serveroptionen, eingesehen am 16. Oktober 2026. Eine Konfiguration, die startet, muss während einer repräsentativen Anfrage weiterhin getestet werden.
Die offizielle Hardwaretabelle ist nützlicher als der Produktzusatz
NVIDIAs veröffentlichte Konfigurationen:
| Rezept | Hardware | Kontext | Sequenzen |
|---|---|---|---|
| 28GB | RTX Spark 64GB oder dedizierte RTX 32GB+ | 65,536 | 1 |
| 32GB | RTX Spark 128GB oder dedizierte RTX 48GB+ | 262,144 | 1 |
Quelle: NVIDIA Quick Start, eingesehen am 16. Oktober 2026.
Diese Zeilen umfassen weder eine dedizierte 24GB-GPU noch belegen sie Mac-Unterstützung. Host-RAM ist kein zusätzliches dediziertes VRAM.
Unsere Einschätzung: Wählen Sie eine reproduzierbare Konfiguration statt eines erfolgreichen Lade-Screenshots. Wenn ein Kauf von diesem Modell abhängt, verlangen Sie eine Demonstration mit Ihren vorgesehenen Eingaben und den üblichen Hintergrundanwendungen. Besonders wichtig ist das bei Dokumentbildern und lang laufenden Agents, deren erste Anfrage viel kleiner sein kann als spätere.
Wählen Sie den Kontext nach der Aufgabe, nicht nach dem Maximum
Betrachten Sie drei beispielhafte Einstiegsaufgaben, keine berichteten Versuche.
Ein Entwickler fragt nach der Ursache eines fehlgeschlagenen Tests und liefert den Fehler, die relevante Funktion und eine benachbarte Abhängigkeit. Nützlich ist eine Diagnose mit konkreten Zeilenangaben und anschließend einem Änderungsvorschlag. Bevor Sie das ganze Repository hinzufügen, prüfen Sie, ob nur eine bestimmte Schnittstelle oder ein weiterer Stack-Frame fehlt. So bleibt die Frage überprüfbar und falsche Annahmen fallen leichter auf.
Eine Forscherin vergleicht eine Tabelle auf zwei Dokumentseiten. Dabei ist entscheidend, ob das Modell Überschriften, Einheiten, Fußnoten und Werte korrekt einander zuordnet. Verwenden Sie die tatsächlichen Seitenbilder, wenn diese Beziehungen wichtig sind, verlangen Sie seitenbezogene Belege und gleichen Sie eine Stichprobe der Zellen mit dem Original ab. Eine flüssige Zusammenfassung, die zwei Spalten vertauscht, ist ein Fehler – selbst wenn sie schnell eintrifft.
Ein lokaler Assistent durchsucht einen freigegebenen Ordner und erstellt einen Berichtsentwurf. Durch abgerufene Inhalte und wiederholte Tool-Antworten kann der Speicherbedarf wachsen. Geben Sie zunächst eine schreibgeschützte Aufgabe, begrenzen Sie die Suche und verlangen Sie, dass die unterstützenden Dateien genannt werden. Gewähren Sie weder Schreib- noch Shell-Rechte, nur um zu prüfen, ob das Modell einen brauchbaren Plan formuliert.
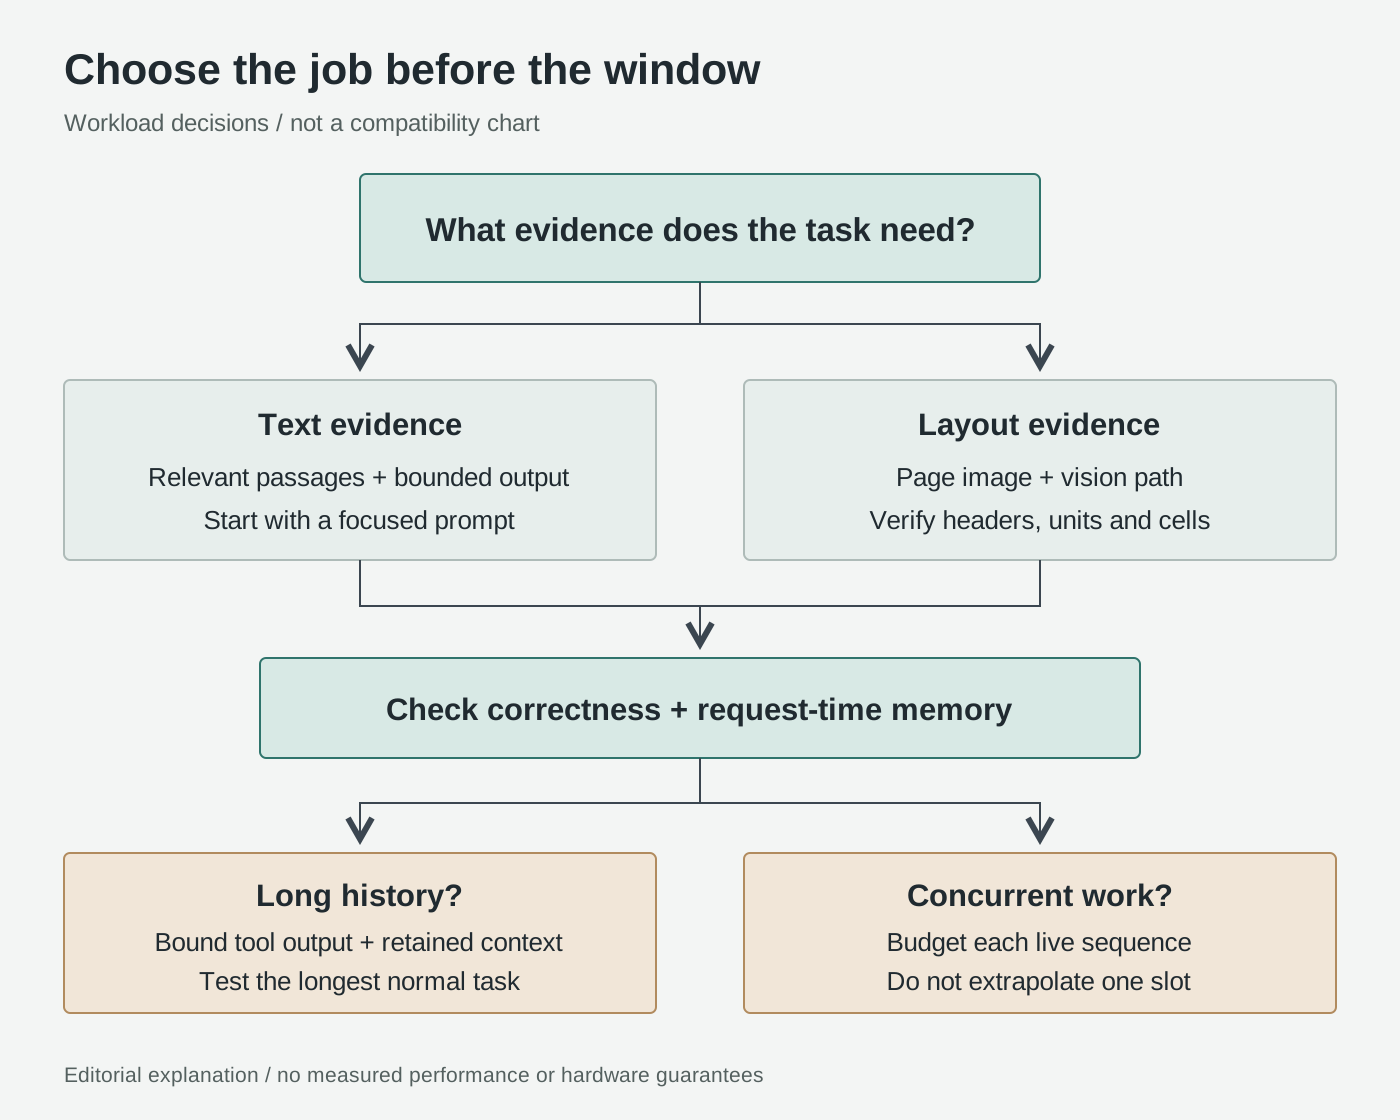
Originale redaktionelle Erläuterung zur Arbeitslastwahl, kein Benchmark und keine Kompatibilitätstabelle. Siehe Hugging-Face-Cache-Strategien und Multimodalverarbeitung in llama.cpp, eingesehen am 16. Oktober 2026.
Quantisierte Caches können gegenüber höherpräzisen Caches Speicher sparen; Offloading verlagert den Druck auf eine andere Speicherebene und kann Durchsatz gegen Kapazität eintauschen. Das sind allgemeine Zielkonflikte und kein Beleg dafür, dass jede Cache-Strategie in Transformers bei dieser GGUF-Bereitstellung verfügbar ist. Hugging-Face-Cache-Strategien, eingesehen am 16. Oktober 2026.
Die praktische Priorität ist die Belegdichte: Bewahren Sie das Material, das zur Beantwortung nötig ist, halten Sie die Originale separat vor und entfernen Sie wiederholtes Beiwerk. Lassen Sie auch Platz für die Antwort. Ein größer konfiguriertes Fenster macht irrelevanten Verlauf nicht nützlich.
Lokal starten und dann die tatsächlich benötigte Arbeitslast testen
Das folgende Linux-Bash-Beispiel zielt auf eine unterstützte Konfiguration mit dedizierter NVIDIA-GPU. Es setzt voraus, dass Git, Python, CMake, eine C++-Toolchain, ein kompatibler NVIDIA-Treiber und CUDA toolkit bereits installiert sind. Dies ist eine Anleitung für Ihren Rechner, kein Bericht über eine durchgeführte Installation.
- Bauen Sie die passende Laufzeit und prüfen Sie ihre Optionen. Verwenden Sie den Build aus dem Quellcode statt eines allgemeinen Einzeilers von einer Modellseite. Folgen Sie dem llama.cpp-CUDA-Build-Leitfaden, eingesehen am 16. Oktober 2026. Halten Sie den gemeldeten Commit und die Binärversion zusammen mit Ihrer Konfiguration fest.
git clone https://github.com/ggml-org/llama.cpp.git
cd llama.cpp
git rev-parse HEAD
cmake -B build -DGGML_CUDA=ON -DGGML_NATIVE=ON
cmake --build build --config Release -j
./build/bin/llama-server --version
./build/bin/llama-server --help
Prüfen Sie, ob die Hilfe draft-dflash, --spec-draft-model, --spec-draft-n-max, --cache-type-k, --cache-type-v, --flash-attn und --jinja aufführt. Eine Paketversionsbezeichnung allein belegt keine Unterstützung. Weist Ihre Binärdatei die Optionen zurück, beheben Sie zunächst die Abweichung beim Build, bevor Sie große Checkpoints herunterladen. Ersetzen Sie das Rezept nicht stillschweigend durch veraltete Optionen für spekulatives Decoding. Die Optionsnamen stehen in der aktuellen Serverreferenz, eingesehen am 16. Oktober 2026.
- Laden Sie die drei Dateien aus NVIDIAs Quick Start, eingesehen am 16. Oktober 2026 herunter. Die Download-Syntax folgt dem Hugging-Face-CLI-Leitfaden, eingesehen am 16. Oktober 2026. Prüfen Sie zuerst den freien Speicherplatz.
python3 -m venv .venv-hf
source .venv-hf/bin/activate
python -m pip install --upgrade huggingface_hub
MODEL_DIR="$PWD/models/nemotron-bolt"
hf download nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-GGUF \
  NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf \
  mmproj-NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf \
  --local-dir "$MODEL_DIR"
hf download nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-LiLiCorr-GGUF \
  NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-LiLiCorr.gguf \
  --local-dir "$MODEL_DIR"
MODEL="$MODEL_DIR/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf"
MMPROJ="$MODEL_DIR/mmproj-NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf"
DRAFT="$MODEL_DIR/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-LiLiCorr.gguf"
Bevor Sie diese Einrichtung als Vergleichsbasis verwenden, notieren Sie Repository-Revisionen und lokale Dateihashes. Ein späteres Datei- oder Laufzeit-Update sollte eine bewusste Änderung sein und kein unerklärter Unterschied zwischen zwei Durchläufen.
- Verwenden Sie NVIDIAs 28GB-Rezept mit expliziter Loopback-Bindung.
./build/bin/llama-server \
  --model "$MODEL" --mmproj "$MMPROJ" \
  --batch-size 2048 --ubatch-size 512 \
  --ctx-size 65536 --parallel 1 -ngl 999 \
  --spec-type draft-dflash --spec-draft-n-max 6 \
  --spec-draft-model "$DRAFT" --spec-draft-ngl 999 \
  --cache-type-k q8_0 --cache-type-v q8_0 \
  --temp 1.0 --top-p 0.95 --flash-attn on --jinja \
  --host 127.0.0.1 --port 8080
Verwenden Sie bei Bedarf einen freien Port und passen Sie die folgende Prüfung entsprechend an. Richten Sie für diesen ersten Lauf keine Router-Weiterleitung, keinen öffentlichen Tunnel und keinen extern erreichbaren Listener ein. Loopback begrenzt die Netzwerkerreichbarkeit, macht die Tools eines angebundenen Agents aber nicht harmlos.
- Prüfen Sie die Bereitschaft, bevor Sie etwas anderes verbinden. Führen Sie in einem zweiten Terminal Folgendes aus:
curl --fail http://127.0.0.1:8080/health
Die Serverdokumentation unterscheidet eine Ladeantwort vom Bereitschaftszustand. Sobald der Server bereit ist, öffnen Sie lokal http://127.0.0.1:8080 und stellen zunächst eine kurze Textfrage, bevor Sie ein Bild senden. Dokumentation zu Server-Health und Weboberfläche von llama.cpp, eingesehen am 16. Oktober 2026. Lassen Sie externe Tools getrennt, bis einfache Antworten funktionieren.
- Messen Sie die vollständige Aufgabe, bevor Sie sie erweitern. Prüfen Sie bei einem System mit dedizierter GPU den Speicher vor dem Start und während repräsentativer Prompts:
nvidia-smi --query-gpu=name,memory.total,memory.used,memory.free --format=csv
Das sind Gerätebeobachtungen, weder eine vollständige Prozess-Spitzenauslastung noch eine Abrechnung von Unified Memory. NVIDIA dokumentiert plattformabhängige Speicherberichte in der Referenz zum NVIDIA System Management Interface. Bewahren Sie auch die Zuteilungsprotokolle der Laufzeit auf und prüfen Sie den Host-Speicher separat.
Vergleichen Sie einen kurzen Prompt, Ihren längsten üblichen Prompt und ein repräsentatives Dokumentbild. Erfassen Sie Richtigkeit, Abschlusszeit, Speicherbeobachtungen und mögliche Zuteilungsfehler. Wiederholen Sie den Test mit geöffnetem, normalerweise genutztem Editor und Browser. Eine Einrichtung, die nur funktioniert, wenn Sie Ihre übrige Arbeitsumgebung schließen, erfüllt die ursprüngliche Anforderung nicht.
Falls es fehlschlägt, ändern Sie jeweils einen Faktor und benennen Sie die neue Konfiguration. Kontext, Microbatch-Größe oder Umfang des Tool-Verlaufs zu reduzieren beantwortet jeweils andere Fragen; den Draft-Generator zu entfernen ist ein weiteres Experiment und nicht das veröffentlichte Rezept. Bewahren Sie den Fehler und die auslösende Eingabe auf, damit ein späterer kurzer, erfolgreicher Prompt die ungelöste Arbeitslast nicht verdeckt.
Das Fazit: Kaufen Sie für den Arbeitssatz
Bolts interessantes Angebot ist ein großes, spärlich aktiviertes und für lokale Arbeit komprimiertes Modell. Sein praktischer Wert hängt davon ab, was zusätzlich hineinpasst: die Belege, visuellen Eingaben, der Sequenzzustand und die Anwendungen, die für den Abschluss Ihrer Aufgabe nötig sind.
Die richtige Abnahmefrage lautet nicht „Wurde das 24GB-Modell geladen?“, sondern „Kann genau dieser Rechner meine übliche Arbeitslast mit zuverlässigen Antworten und genügend Platz für den nächsten Schritt bewältigen?“ Dieses Speicherbudget lohnt sich.
Quellen
Die Veröffentlichungsinformationen stammen vom 15. Oktober 2026; die verlinkten Modellkarten und laufend aktualisierten Dokumentationen wurden am 16. Oktober 2026 geprüft. Die Abläufe sind angepasste Anleitungen und keine Ergebnisse praktischer Tests. Die Originaldiagramme erläutern Konzepte, sie sind weder offizielle Assets noch Leistungsdiagramme.
- NVIDIA-Veröffentlichungsankündigung zu den drei Modellnamen und dem Veröffentlichungszeitpunkt.
- NVIDIA-Bolt-Forschungsübersicht und Technikbericht zu Komprimierung, Präzision und der geschätzten Speicheraufteilung.
- NVIDIA-GGUF-Modellkarte mit tatsächlicher Hardwaretabelle, Checkpoint-Dateinamen und Startrezept.
- Dokumentation zum llama.cpp-Build, Server, Multimodalbetrieb und zu GGUF-Werkzeugen für das Laufzeitverhalten.
- Hugging-Face-Erklärung zum Cache, Cache-Strategien, CLI-Leitfaden und NVIDIA-SMI-Referenz zu den jeweiligen Mechanismen und Prüfbefehlen.
Optionale Empfehlung für Telli.sh: Bewahren Sie die Quellen hinter Ihren Entscheidungen auf
Beim Vergleich von Agents ist es hilfreich, Originalquellen, eigene Notizen und Ergebnisse eigener Versuche zusammenzuhalten. Telli.sh-Konto erstellen, um dieses Material als Referenz zu ordnen, auf die Sie bei Produktänderungen zurückgreifen können.